Android Bench 2.0: تجاوز الحدود باستخدام مهام طويلة الأمد وصعبة
مدّة القراءة: 3 دقائق
عندما أطلقنا Android Bench لأول مرة، وضعنا أساسًا صارمًا لتقييم كيفية مساعدة النماذج اللغوية الكبيرة المطوّرين في مهام Android الواقعية. مع التطور السريع لنماذج الذكاء الاصطناعي والوكلاء، عملنا على تعديل منهجيتنا، مثل مواءمة إطار عمل قياس الأداء مع إطار عمل Harbor. نحن بصدد إطلاق المجموعة الأولى من المهام الطويلة الأمد (LHT)، وهي مهام معقّدة للغاية يستغرق إكمالها عدة أيام أو حتى أسبوع. نقدّم أيضًا التقييم المستند إلى الوكلاء، بدءًا بالوكلاء من مقدّمي النماذج المعنيين. يُطلق على هذه الإضافة اسم Android Bench 2.0، وهي عبارة عن ترقية كبيرة مصمَّمة لتقييم نماذج الذكاء الاصطناعي والوكلاء وفقًا لمستوى التعقيد والغموض وحل المشاكل المعقّدة المتعدّدة الخطوات التي تواجهها كل يوم.
من الإصلاحات التدريجية إلى المهام الطويلة الأمد
ركّزت النسخة الأولى من Android Bench، بالإضافة إلى مقاييس الأداء المشابهة المبكرة للترميز المستند إلى الذكاء الاصطناعي، على التغييرات التدريجية في المستودعات الحالية، والتي كانت في كثير من الحالات تقتصر على إصلاح الأخطاء أو طلبات الميزات الأصغر. كان ذلك يعكس إمكانات المساعدة المستندة إلى الذكاء الاصطناعي في ذلك الوقت، بالإضافة إلى طريقة استخدامك لها.
لمواصلة مساعدتك في العثور على النماذج ووكلاء الترميز الأنسب لسير عمل التطوير، رفعنا مستوى تقييماتنا ليتناسب مع المهام التي تفوّضها إلى الذكاء الاصطناعي. تعكس أداة Android Bench 2.0 هذه التحديات الطموحة من خلال مهام LHT التي تتضمّن ترقية التبعيات أو إضافة ميزات جديدة أو إنشاء تطبيقات من البداية أو تحويل تطبيق متوافق مع عدة منصات إلى Android.
تتطلّب المهام المعقّدة تقييمًا وتسجيلاً أكثر دقة
في المهام الهندسية التي تستغرق عدة أيام، لا يقدّم التقييم الثنائي (ناجح أو غير ناجح) الصورة الكاملة.
على سبيل المثال، قد يعيد أحد المطوّرين تصميم 40 شاشة باستخدام Jetpack Compose، ويُعدّ جداول قاعدة البيانات، ويستوفي% 90 من المتطلبات، ولكنّه يفشل في تأكيد حالة استخدام واحدة. تُقيّم معدّلات التسجيل الثنائي عملية التشغيل هذه بنسبة %0، ما يحجب إمكانات بنية النموذج. نحن بصدد الانتقال إلى نظام التسجيل المستمر لتقديم إشارة أكثر أهمية، سواء لتطوير النماذج أو لفهم كيفية مساعدة الذكاء الاصطناعي لك.
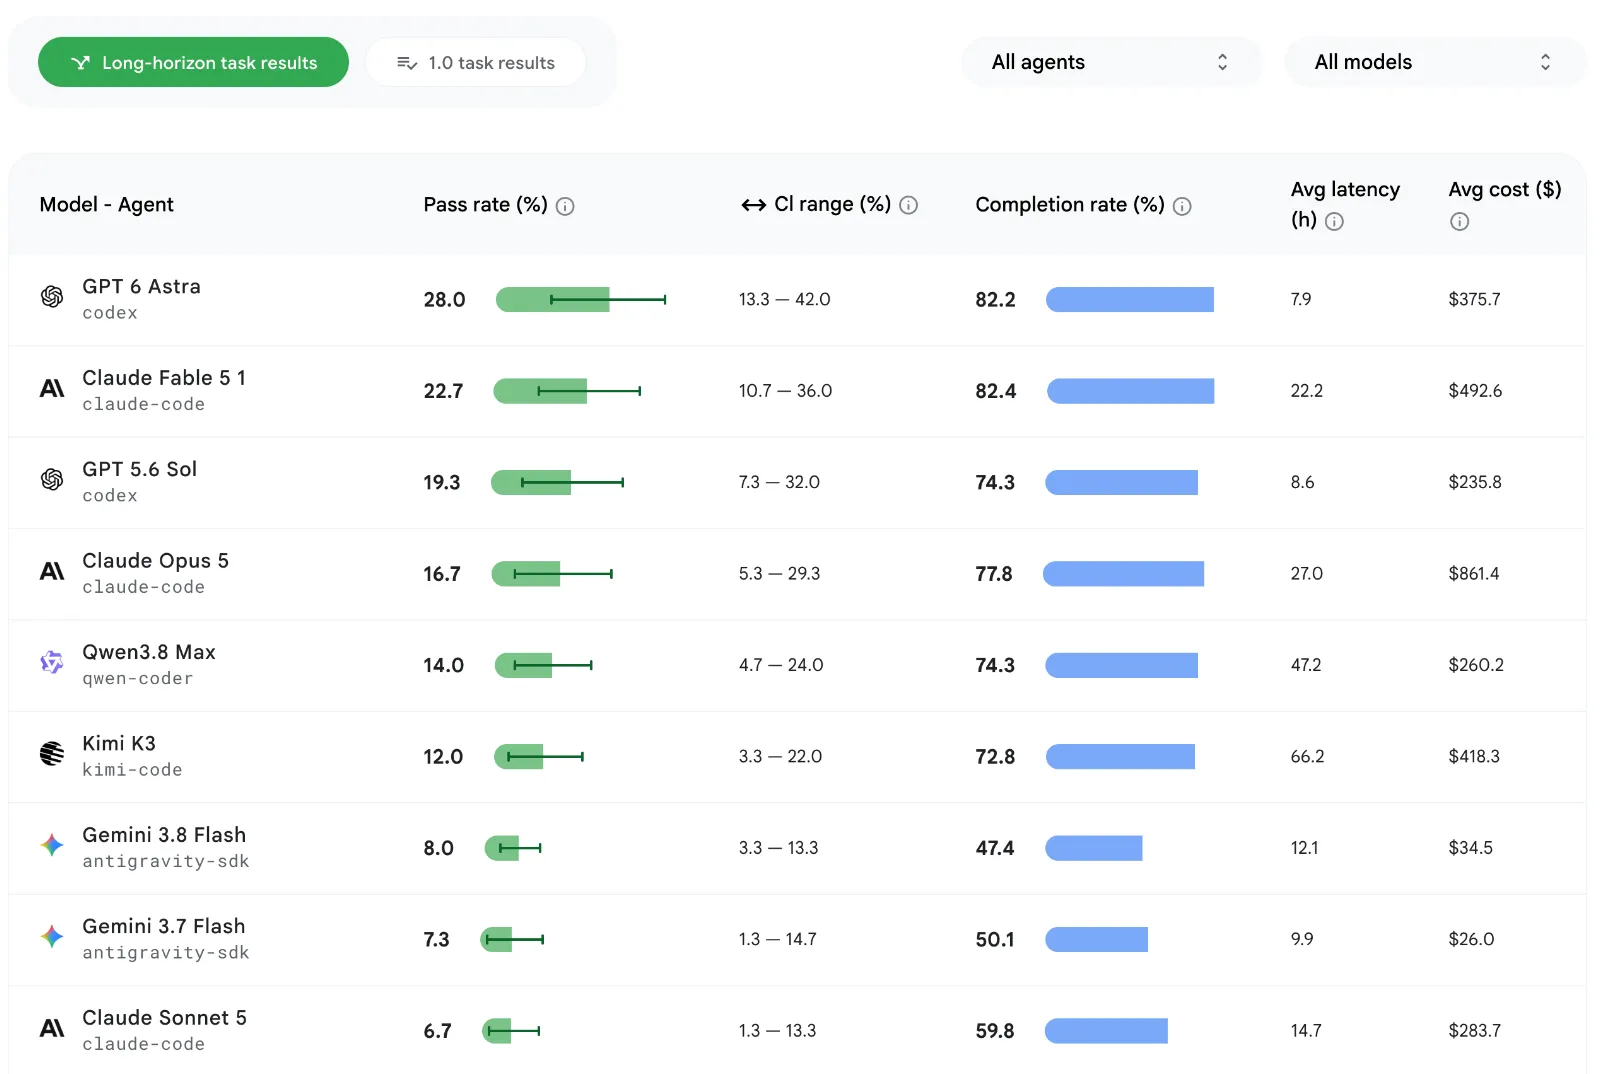
نحتسب معدّل الإكمال هذا من خلال مجموعة من العوامل، مثل الوظائف والدقة المرئية وتجنُّب حالات التراجع. نفرض أيضًا عقوبات على التقييم الموضوعي في حال حدوث انحرافات عن تعليمات التقييم أو القيود البنيوية. اطّلِع على قائمة الصدارة المعدَّلة وانقر على عرض البطاقة لكل نموذج للاطّلاع على عناصر إضافية، مثل نسبة النجاح ونسبة الإكمال ومتوسّط التكاليف لكل نموذج ولكل مهمة.
أعلى نسبة نجاح في اختبارات LHT تبلغ%28 تقريبًا، وهي أقل بكثير من نسبة% 91 تقريبًا التي حققتها المهام الأصلية في مقياس الأداء.
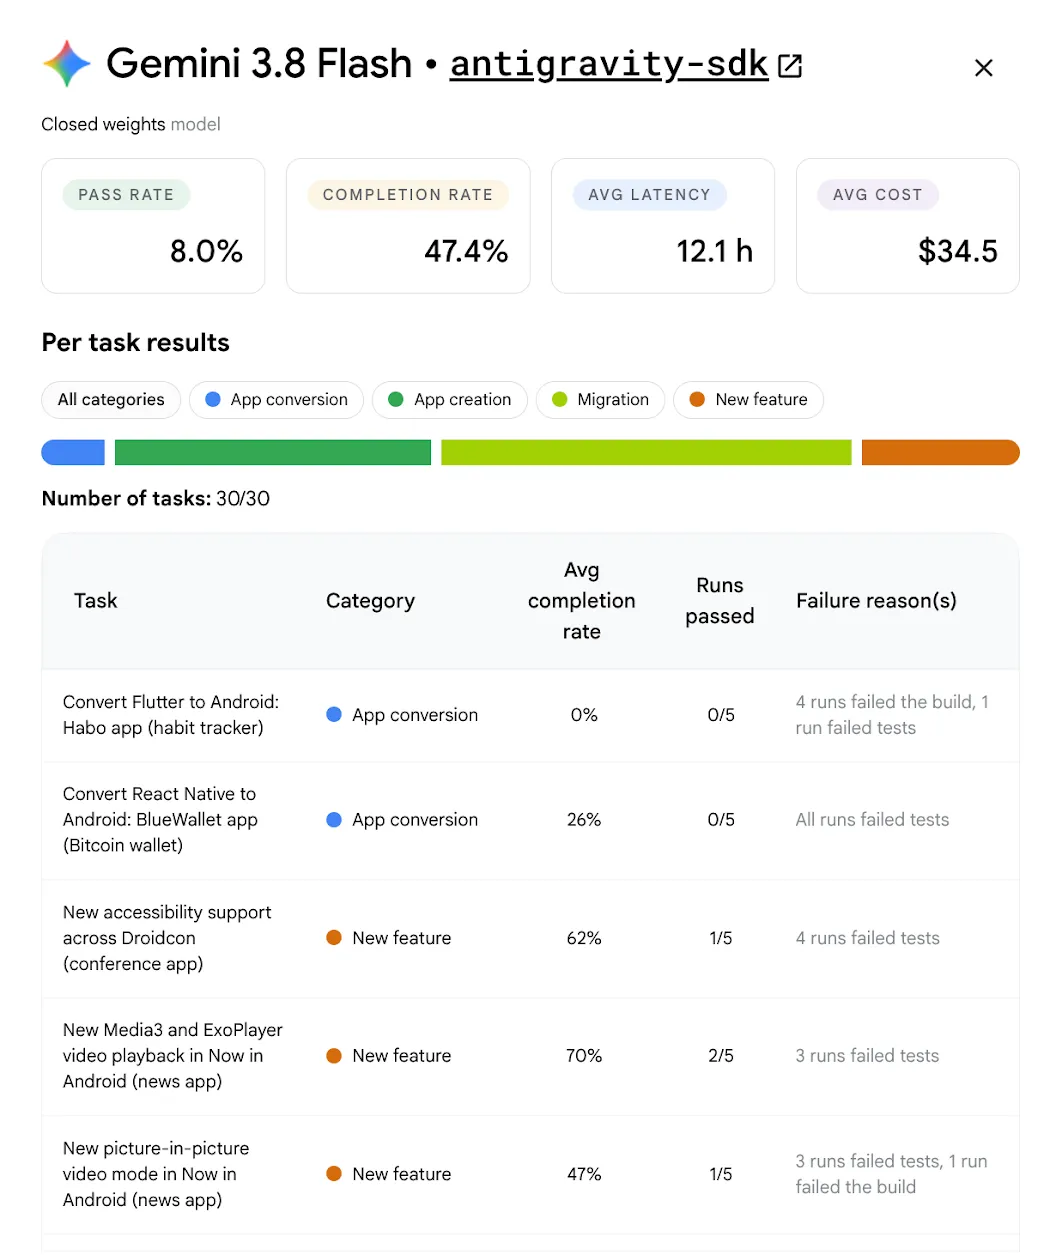
تساعد المهام الطويلة الأمد في الكشف عن إحصاءات مفيدة للحصول على مساعدة من الذكاء الاصطناعي
بالإضافة إلى قياس مدى جودة أداء الذكاء الاصطناعي في المهام الطويلة الأمد، تساعدنا مجموعة بيانات LHT في معرفة المزيد عن نقاط القوة والضعف في النماذج التي يتم اختبارها، كما نقدّم لك إرشادات أكثر عملية.
في جميع فئات النماذج، يؤدي الذكاء الاصطناعي وظيفة أفضل في كتابة رموز برمجية جديدة بدلاً من إعادة تصميم الرموز البرمجية الحالية. تصبح عمليات إعادة البناء والنقل أكثر صعوبة لأنّ النجاح يعتمد على درجة تعقيد البنية بدلاً من حجم الرمز.
تُظهر النماذج إمكانات قوية في عمليات التحويل المحدّدة والمثبتة، مثل تحويل Java إلى Kotlin أو استبدال Retrofit بـ Ktor أو إضافة طبقة ViewModel. ويطبّقون هذه الأنماط باستمرار، حتى على مستوى أكثر من 125 ملفًا وأكثر من 8,000 سطر من الرموز البرمجية.
ومع ذلك، تواجه النماذج صعوبة عندما تتطلّب المهام التحقّق من صحة وقت التشغيل (مثل الرسومات الناقصة لإدخال التبعية)، أو تتضمّن تغييرات في إطار العمل، أو تواجه ثغرات معرفية في المكتبات التي لم يتم إصدارها. لا يزال تكييف التطبيقات من عدّة منصات مع Android يمثّل تحديًا مفتوحًا، إذ لا يحقّق أي نموذج معدّل نجاح بنسبة% 100، وتصل النماذج المتقدّمة إلى معدّل إكمال يبلغ% 80 كحد أقصى.
تقديم تقييمات الوكلاء
لمساعدتك في الحصول على فكرة أفضل عن أداء النماذج عند دمجها في سير عملك المستند إلى الذكاء الاصطناعي الوكيل، نضيف وكلاء شائعي الاستخدام إلى عملية التقييم. سنبدأ بتشغيل نماذج جديدة على "أدوات اختبار الأداء الخفيف" باستخدام وكلاء من مقدّم النموذج المعنيّ. على سبيل المثال، شغّلنا GPT 5.6 Sol على Codex، وGemini 3.8 Flash على Google Antigravity. يوضّح هذا الاقتران كيف يؤثر تصميم واجهة برمجة التطبيقات بشكل إيجابي في نتائج المطوّرين، إذ لاحظنا أنّ تخزين الطلبات مؤقتًا وتصغير نوافذ الأدوات يمكن أن يؤدي إلى تقليل عدد الرموز المميزة.
سنوسّع نطاق هذه الميزة في المستقبل من خلال تسليط الضوء أيضًا على النتائج التي تم الحصول عليها من خلال مجموعات مختلفة من النماذج والوكلاء، وذلك لمساعدتك في معرفة المجموعات التي تناسبك وتناسب فريقك بشكل أفضل.
نستثمر في هذا القياس لأنّه من المهم أن تتمكّن من استخدام الوكيل والنموذج الذي تختاره لتطوير تطبيقات Android، وسنشاركك المزيد من المعلومات في الأسابيع المقبلة.
تمّت إضافة نماذج جديدة
بالإضافة إلى ذلك، نواصل توسيع قائمة الصدارة لضمان حصولك على أحدث البيانات لاتّخاذ قرارات التطوير. أضفنا Gemini 3.8 Flash وGemini 3.7 Flash وGPT-6 من OpenAI وFable 5.1 من Anthropic وKimi K3 وQwen 3.8 Max، مع GPT-6 Astra من OpenAI في الصدارة بنسبة نجاح بلغت% 28.
في المستقبل
يوفر Android Bench 2.0 بيئة قوية لقياس أداء الذكاء الاصطناعي في تطوير تطبيقات Android. من خلال الجمع بين المهام الطويلة الأمد والتقييم المتعدّد الوسائط والوكلاء والتسجيل المستمر، نأمل أن نساعد فِرق أبحاث الذكاء الاصطناعي في إنشاء شركاء أكثر كفاءة وموثوقية في مجال الترميز باستخدام الذكاء الاصطناعي، كما نأمل أن نقدّم لك المزيد من الشفافية بشأن خياراتك لتطوير الذكاء الاصطناعي.
يمكنك الاطّلاع على قائمة الصدارة المعدَّلة بالإضافة إلى المنهجية المعدَّلة. تؤثر ملاحظاتك بشكل مباشر في طريقة تطويرنا لأداة Android Bench، لذا يُرجى مواصلة مشاركة ملاحظاتك معنا على GitHub، بالإضافة إلى قنواتنا على وسائل التواصل الاجتماعي، مثل X وLinkedIn.
-
 أخبار المنتجات
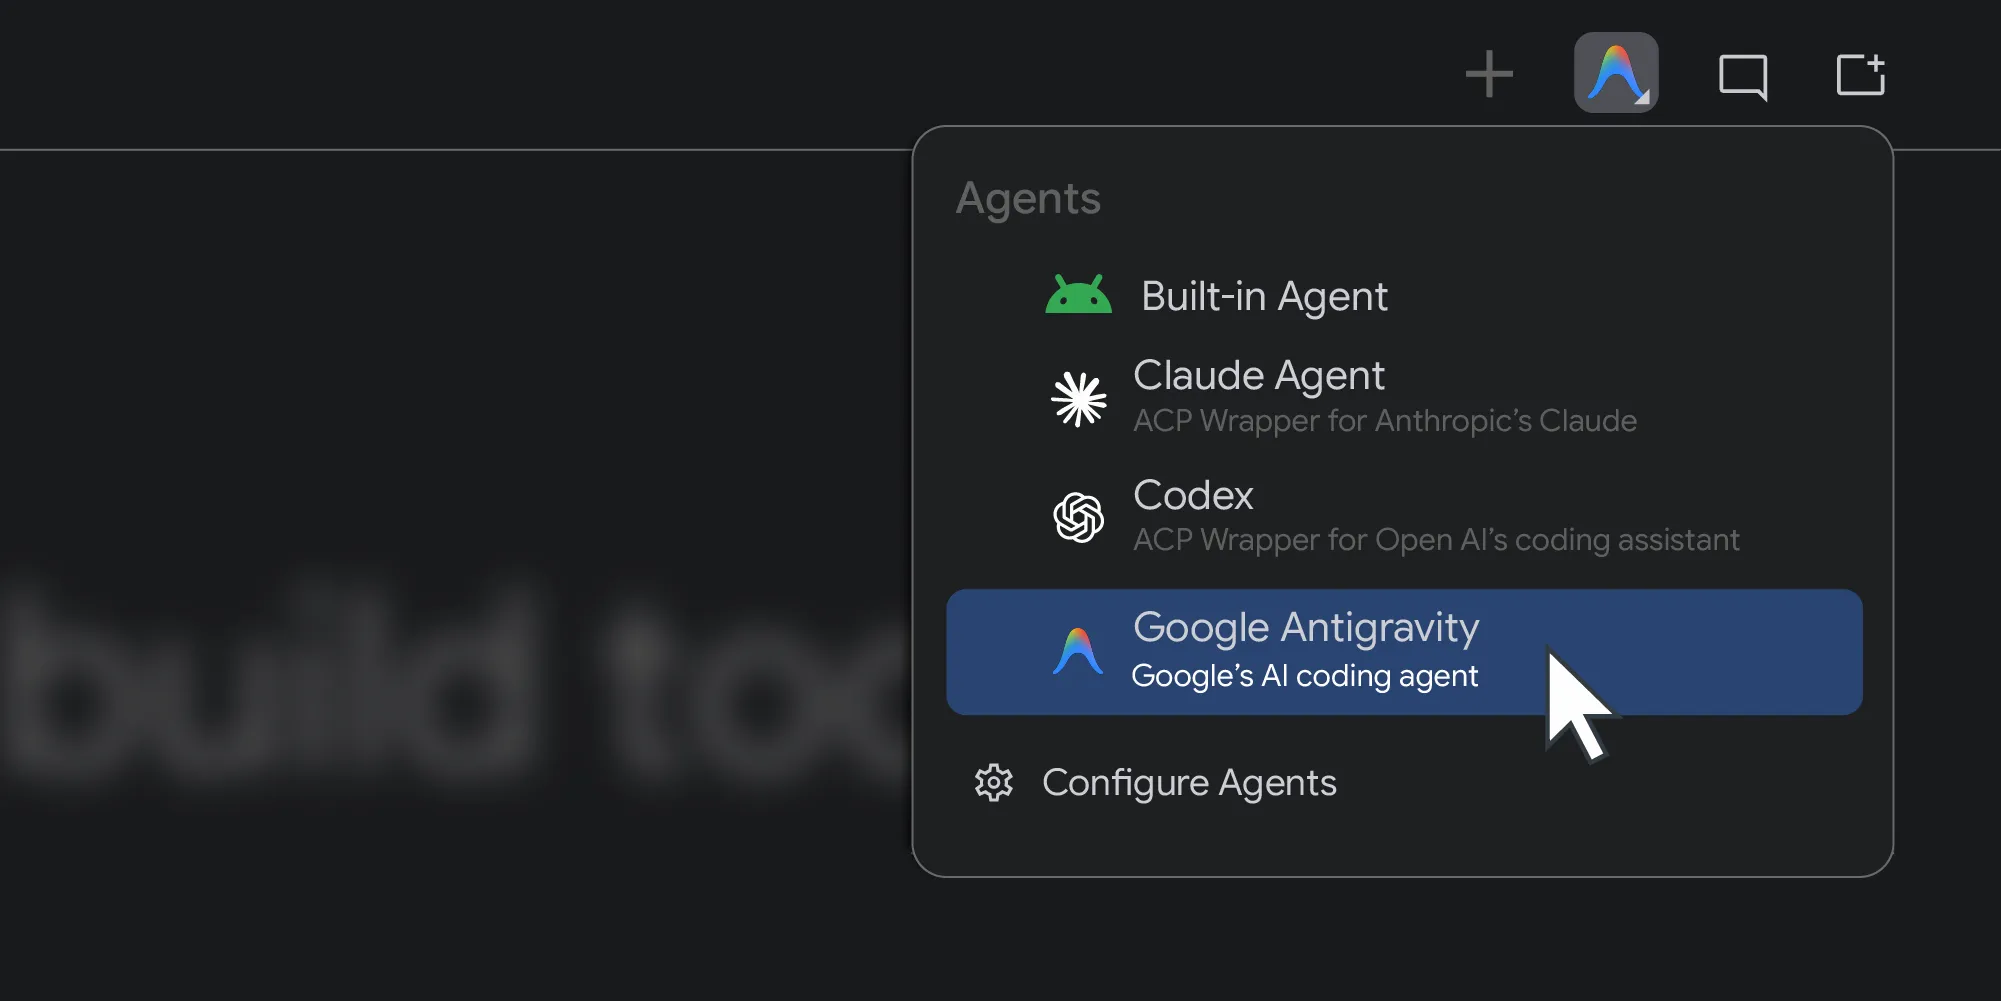
في العام الماضي، أصبح بإمكان "استوديو Android" استخدام أي نموذج للذكاء الاصطناعي. واليوم، نتّخذ الخطوة التالية من خلال توفير إمكانية اختيار وكلاء الترميز.
Matthew Warner • مدّة القراءة: 3 دقائق -
 أخبار المنتجات
في آذار (مارس)، قدّمنا Android Bench، وهي لوحة الصدارة الخاصة بالنماذج اللغوية الكبيرة والمخصّصة لمهام تطوير تطبيقات Android في العالم الحقيقي. ومنذ ذلك الحين، حسّنّا معيار الأداء استنادًا إلى ملاحظاتك، بما في ذلك تقييم نماذج الوزن المفتوح وإضافة سمات التكلفة والكفاءة إلى قائمة الصدارة.
Zoe Lopez-Latorre • مدّة القراءة: 3 دقائق -
 أخبار المنتجات
نطرح اليوم نظام التشغيل Android 17 وسنوفّره على معظم أجهزة Pixel المتوافقة. ترقَّب طرح أجهزة جديدة تعمل بالإصدار 17 من نظام التشغيل Android خلال الأشهر المقبلة.
Matthew McCullough • 13 دقيقة للقراءة
يمكنك تلقّي أحدث الإحصاءات حول تطوير تطبيقات Android في بريدك الوارد أسبوعيًا.