Android Bench 2.0: लंबे समय तक चलने वाले मुश्किल टास्क के साथ, नई सीमाएं तय करना
पढ़ने में 3 मिनट लगेंगे
जब हमने पहली बार Android Bench लॉन्च किया था, तब हमने यह आकलन करने के लिए एक मज़बूत फ़्रेमवर्क तैयार किया था कि लार्ज लैंग्वेज मॉडल (एलएलएम), डेवलपर को असल दुनिया से जुड़े Android के टास्क पूरे करने में कैसे मदद करते हैं. एआई मॉडल और एजेंट में तेज़ी से बदलाव हो रहे हैं. इसलिए, हम अपनी मैथडोलॉजी को अपडेट करते रहते हैं. जैसे, हमने अपने बेंचमार्क फ़्रेमवर्क को Harbor फ़्रेमवर्क के साथ अलाइन किया है. आज हम लंबे समय तक चलने वाले टास्क (एलएचटी) का पहला सेट रिलीज़ कर रहे हैं. ये ऐसे टास्क होते हैं जिन्हें पूरा करने में इंजीनियर को कई दिन या एक हफ़्ता भी लग सकता है. हम एजेंटिक इवैल्यूएशन की सुविधा भी लॉन्च कर रहे हैं. इसकी शुरुआत, मॉडल उपलब्ध कराने वाली कंपनियों के एजेंट से की जाएगी. इस अपडेट के बाद, हम Android Bench 2.0 पर पहुंच गए हैं. यह एक बड़ा अपग्रेड है. इसे एआई मॉडल और एजेंटों का आकलन करने के लिए डिज़ाइन किया गया है. यह आकलन, हर दिन हल की जाने वाली समस्याओं के आधार पर किया जाता है. इन समस्याओं में, अलग-अलग तरह की समस्याएं, अस्पष्ट समस्याएं, और कई चरणों वाली मुश्किल समस्याएं शामिल हैं.
इंक्रीमेंटल फ़िक्स से लेकर लंबे समय तक चलने वाले टास्क तक
Android Bench के पहले वर्शन के साथ-साथ, एआई कोडिंग के शुरुआती बेंचमार्क में, मौजूदा रिपॉज़िटरी में छोटे-छोटे बदलावों पर फ़ोकस किया गया था. कई मामलों में, ये बदलाव सिर्फ़ गड़बड़ियों को ठीक करने या छोटी-छोटी सुविधाओं के अनुरोधों तक सीमित थे. यह उस समय एआई की मदद से काम करने वाली सुविधाओं और आपके इस्तेमाल करने के तरीके के बारे में बताता है.
हम आपको ऐसे मॉडल और कोडिंग एजेंट ढूंढने में मदद करते रहेंगे जो आपके डेवलपमेंट वर्कफ़्लो के लिए सबसे सही हों. इसके लिए, हमने अपने आकलन के स्टैंडर्ड को बेहतर बनाया है, ताकि एआई को सौंपे गए काम के हिसाब से आपको बेहतर सुझाव मिल सकें. Android Bench 2.0, इन मुश्किल चुनौतियों को LHT के साथ दिखाता है. इनमें डिपेंडेंसी अपग्रेड करना, नई सुविधाएं जोड़ना, ऐप्लिकेशन को शुरू से बनाना या क्रॉस-प्लैटफ़ॉर्म ऐप्लिकेशन को Android में बदलना शामिल है.
मुश्किल टास्क के लिए, ज़्यादा बारीकी से आकलन और स्कोरिंग की ज़रूरत होती है
कई दिनों तक चलने वाले इंजीनियरिंग टास्क के लिए, पास या फ़ेल के आधार पर ग्रेडिंग करने से पूरी जानकारी नहीं मिलती.
उदाहरण के लिए, कोई एजेंट 40 स्क्रीन को Jetpack Compose में बदल सकता है, डेटाबेस टेबल सेट अप कर सकता है, और 90% ज़रूरी शर्तें पूरी कर सकता है. हालांकि, ऐसा हो सकता है कि वह किसी एक एज-केस के दावे को पूरा न कर पाए. बाइनरी स्कोरिंग से, इस रन को 0% के तौर पर रेट किया जाता है. इससे मॉडल की आर्किटेक्चरल क्षमताओं का पता नहीं चलता. हम लगातार स्कोरिंग की सुविधा पर स्विच कर रहे हैं, ताकि मॉडल डेवलपमेंट और एआई से जुड़ी आपकी समझ को बेहतर बनाया जा सके.
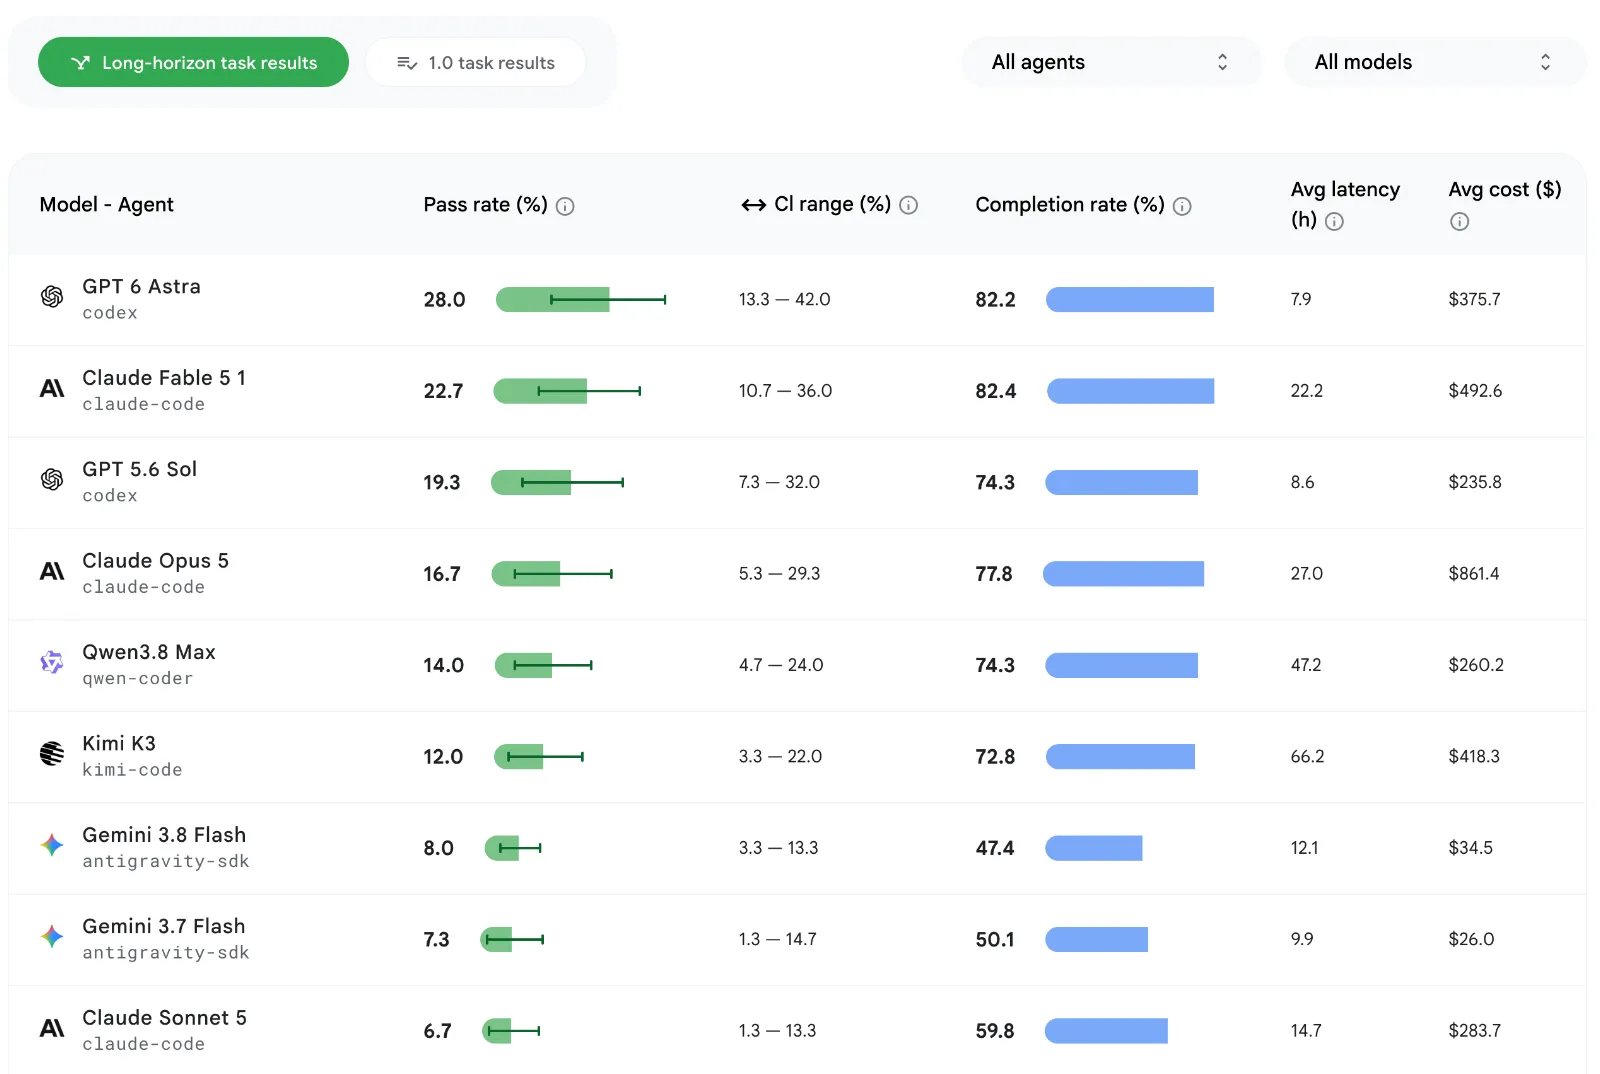
हम इस दर का हिसाब लगाने के लिए, कई बातों को ध्यान में रखते हैं. जैसे, फ़ंक्शनैलिटी, विज़ुअल फ़िडेलिटी, और रिग्रेशन से बचना. हम आकलन के निर्देशों या स्ट्रक्चरल कंस्ट्रेंट से अलग होने पर, ऑब्जेक्टिव स्कोरिंग के लिए पेनल्टी भी लगाते हैं. अपडेट किया गया लीडरबोर्ड देखें. साथ ही, हर मॉडल के कार्ड व्यू पर क्लिक करके, पास रेट, पूरा होने की दर, और हर मॉडल और हर टास्क की औसत लागत जैसे अन्य एलिमेंट देखें.
एलएचटी के लिए पास होने की सबसे ज़्यादा दर करीब 28%है. यह बेंचमार्क में शामिल ओरिजनल टास्क के लिए, ~91% से काफ़ी कम है.
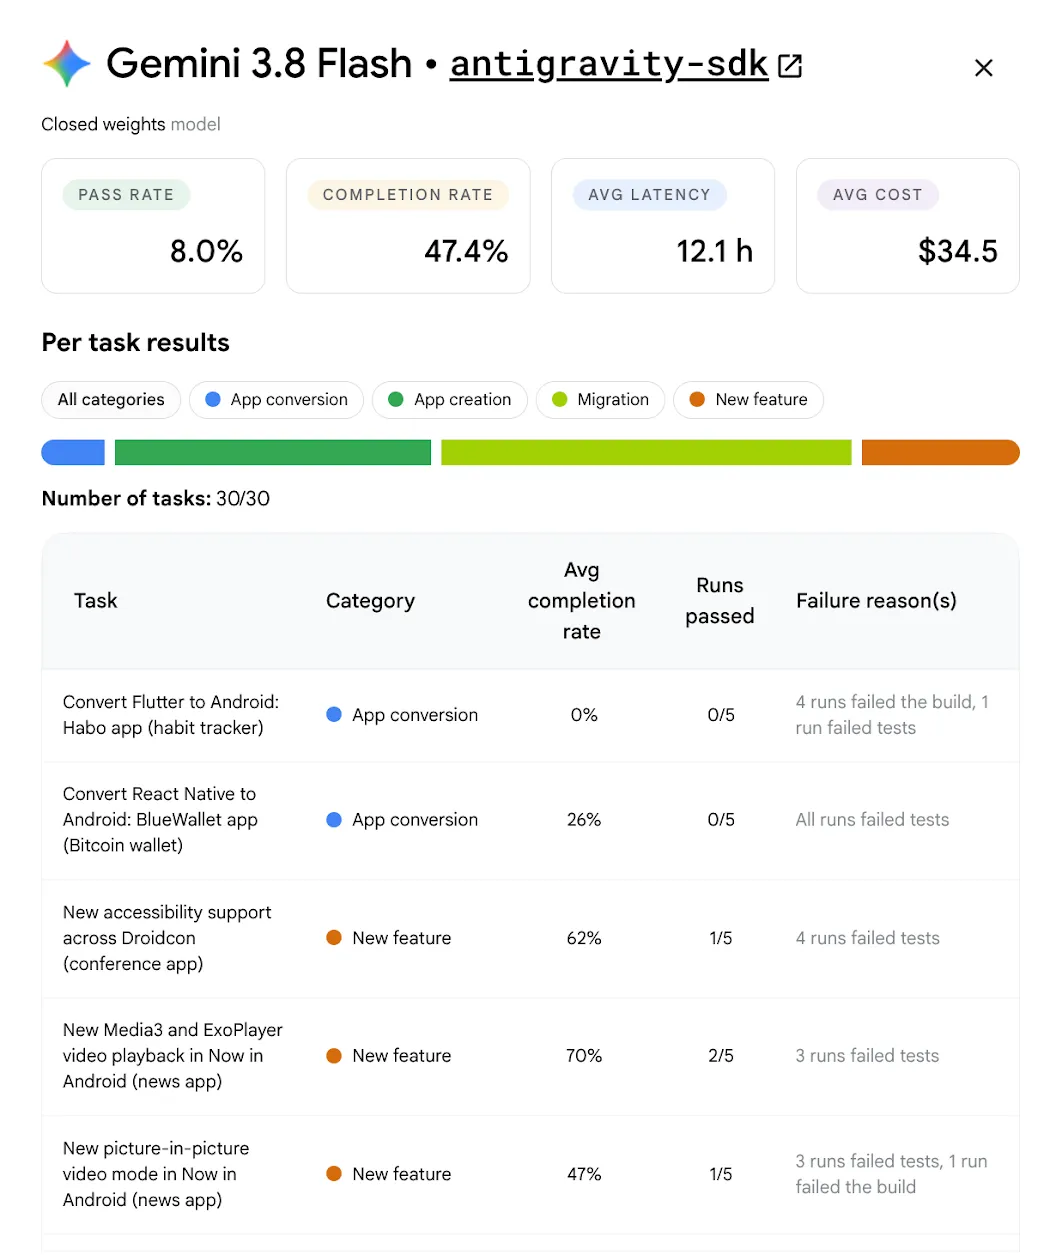
लंबे समय तक चलने वाले टास्क से, एआई असिस्टेंट के लिए काम की अहम जानकारी मिलती है
LHT डेटासेट से, हमें यह पता चलता है कि एआई लंबे समय तक चलने वाले कामों को कितनी अच्छी तरह से मैनेज करता है. साथ ही, इससे हमें टेस्ट किए गए मॉडल की खूबियों और कमियों के बारे में ज़्यादा जानकारी मिलती है. इससे हम आपको ज़्यादा व्यावहारिक दिशा-निर्देश दे पाते हैं.
मॉडल के सभी टियर में, एआई मौजूदा कोड को फिर से लिखने के बजाय, नया कोड बेहतर तरीके से लिखता है. रीफ़ैक्टर और माइग्रेशन ज़्यादा मुश्किल हो जाते हैं, क्योंकि सफलता कोड वॉल्यूम के बजाय आर्किटेक्चर की जटिलता पर निर्भर करती है.
मॉडल, अच्छी तरह से स्थापित और तय किए गए ट्रांसफ़ॉर्मेशन में बेहतर परफ़ॉर्म करते हैं. जैसे, Java को Kotlin में बदलना, Retrofit को Ktor से बदलना या ViewModel लेयर जोड़ना. ये इन पैटर्न को लगातार लागू करते हैं. भले ही, 125 से ज़्यादा फ़ाइलें और 8,000 से ज़्यादा लाइनों का कोड हो.
हालांकि, मॉडल को इन कामों को करने में मुश्किल होती है: रनटाइम पुष्टि करना (जैसे, डिपेंडेंसी इंजेक्शन ग्राफ़ मौजूद न होना), फ़्रेमवर्क में बदलाव करना या रिलीज़ न की गई लाइब्रेरी के बारे में जानकारी न होना. क्रॉस-प्लैटफ़ॉर्म ऐप्लिकेशन को Android पर पोर्ट करना अब भी एक चुनौती है. कोई भी मॉडल, 100% पास रेट तक नहीं पहुंच पाया है. साथ ही, फ़्रंटियर मॉडल ज़्यादा से ज़्यादा 80% तक काम कर पाते हैं.
पेश है एजेंट के परफ़ॉर्मेंस का आकलन करने की सुविधा
एजेंटिक वर्कफ़्लो में इंटिग्रेट किए जाने पर मॉडल कैसा परफ़ॉर्म करते हैं, इस बारे में आपको बेहतर जानकारी देने के लिए, हम अपने आकलन में आम तौर पर इस्तेमाल किए जाने वाले एजेंट जोड़ रहे हैं. हम एलएचटी के ख़िलाफ़ नए मॉडल चलाकर इसकी शुरुआत कर रहे हैं. इसके लिए, हम मॉडल उपलब्ध कराने वाली कंपनी के एजेंटों का इस्तेमाल करेंगे. उदाहरण के लिए, हमने Codex पर GPT 5.6 Sol और Google Antigravity पर Gemini 3.8 Flash को चलाया. इस पेयरिंग से पता चलता है कि हार्नेस डिज़ाइन, डेवलपर के नतीजों पर कैसे सकारात्मक असर डालता है. हमने देखा है कि प्रॉम्प्ट कैश मेमोरी और कॉम्पैक्ट टूल विंडो से टोकन की संख्या कम हो सकती है.
हम आने वाले समय में, इस सुविधा को और बेहतर बनाएंगे. इसके तहत, हम अलग-अलग मॉडल और एजेंट के कॉम्बिनेशन के हिसाब से भी नतीजे दिखाएंगे. इससे आपको यह पता लगाने में मदद मिलेगी कि आपके और आपकी टीम के लिए, कौनसे कॉम्बिनेशन सबसे सही हैं.
हम इस मेज़रमेंट में इसलिए निवेश कर रहे हैं, क्योंकि Android ऐप्लिकेशन डेवलप करने के लिए, आपको अपनी पसंद के एजेंट और मॉडल का इस्तेमाल करने की सुविधा मिलनी चाहिए. हम आने वाले हफ़्तों में, आपके साथ ज़्यादा जानकारी शेयर करेंगे.
नए मॉडल जोड़े गए
इसके अलावा, हम लीडरबोर्ड को लगातार बड़ा कर रहे हैं, ताकि आपको डेवलपमेंट से जुड़े फ़ैसले लेने के लिए सबसे अप-टू-डेट डेटा मिल सके. हमने Gemini 3.8 Flash, Gemini 3.7 Flash, OpenAI का GPT-6, Anthropic का Fable 5.1, Kimi K3, और Qwen 3.8 Max को शामिल किया है. OpenAI का GPT-6 Astra, 28% पास रेट के साथ सबसे ऊपर है.
आगे की योजनाएं
Android Bench 2.0, Android डेवलपमेंट के लिए एआई को मेज़र करने के लिए एक मज़बूत एनवायरमेंट उपलब्ध कराता है. हमारा मानना है कि लंबी अवधि के टास्क, मल्टीमॉडल इवैल्यूएशन, एजेंट, और लगातार स्कोरिंग को एक साथ इस्तेमाल करके, एआई रिसर्च टीमों को ज़्यादा भरोसेमंद और बेहतर एआई कोडिंग पार्टनर बनाने में मदद मिलेगी. साथ ही, हम आपको एआई डेवलपमेंट के विकल्पों के बारे में ज़्यादा पारदर्शिता से जानकारी दे पाएंगे.
अपडेट किया गया लीडरबोर्ड और अपडेट की गई मैथडोलॉजी देखें. आपके सुझाव/राय से हमें Android Bench को बेहतर बनाने में मदद मिलती है. इसलिए, कृपया GitHub के साथ-साथ हमारे सोशल मीडिया चैनलों, जैसे कि X और LinkedIn पर अपने सुझाव/राय शेयर करते रहें.
-
 प्रॉडक्ट से जुड़ी खबरें
हमने मार्च में, Android Bench लॉन्च किया था. यह असल दुनिया के Android डेवलपमेंट टास्क के लिए, एलएलएम लीडरबोर्ड है. इसके बाद से, हमने आपके सुझाव, शिकायत या राय के आधार पर बेंचमार्क को बेहतर बनाया है. इसमें ओपन-वेट मॉडल का आकलन करना और लीडरबोर्ड में लागत और परफ़ॉर्मेंस के डाइमेंशन जोड़ना शामिल है.
Zoe Lopez-Latorre • तीन मिनट में पढ़ा जा सकता है -
 प्रॉडक्ट से जुड़ी खबरें
आज हम Android 17 को रिलीज़ कर रहे हैं. यह सुविधा, Android 17 के साथ काम करने वाले ज़्यादातर Pixel डिवाइसों पर उपलब्ध होगी. आने वाले महीनों में, Android 17 पर काम करने वाले नए डिवाइसों के बारे में जानें.
Matthew McCullough • पढ़ने में 13 मिनट लगेंगे -
 प्रॉडक्ट से जुड़ी खबरें
Google I/O '26 में, Android डेवलपर के लिए 17 अहम घोषणाएं की गई हैं. इनमें एजेंट की मदद से काम करने की क्षमता, यूज़र इंटरफ़ेस (यूआई) के स्टैंडर्ड के तौर पर Compose First, और बढ़ते हुए इकोसिस्टम के लिए हाई-परफ़ॉर्मेंस मीडिया और अडैप्टिव डेवलपमेंट पर फ़ोकस किया गया है.
Matthew McCullough • 8 मिनट में पढ़ें
Android डेवलपमेंट से जुड़ी नई अहम जानकारी, हर हफ़्ते अपने इनबॉक्स में पाएं.