Android Bench 2.0: Ampliamos los límites con tareas desafiantes de largo horizonte
Lectura de 3 min
Cuando lanzamos Android Bench, creamos una base rigurosa para evaluar cómo los modelos de lenguaje grandes (LLM) ayudan a los desarrolladores con tareas de Android del mundo real. A medida que los modelos y agentes de IA evolucionan con rapidez, actualizamos nuestra metodología, por ejemplo, alineando nuestro marco de referencia con el marco de Harbor. Hoy lanzamos el primer conjunto de tareas de largo horizonte (LHT), que son tareas de gran complejidad que a un ingeniero le lleva varios días o incluso una semana completar. También presentamos la evaluación de agentes, que comienza con los agentes de los proveedores de modelos correspondientes. Esta incorporación nos lleva a Android Bench 2.0, una actualización importante diseñada para evaluar modelos y agentes de IA en función de la escala, la ambigüedad y la resolución de problemas complejos de varios pasos que abordas todos los días.
De correcciones incrementales a tareas de largo horizonte
La primera iteración de Android Bench, junto con comparativas de programación de IA tempranas similares, se centró en cambios incrementales en los repositorios existentes, en muchos casos limitados a correcciones de errores o solicitudes de funciones más pequeñas. Esto reflejaba las capacidades de la asistencia de IA en ese momento, así como la forma en que la usabas.
Para seguir ayudándote a encontrar los modelos y los agentes de programación que mejor se adapten a tu flujo de trabajo de desarrollo, elevamos el nivel de nuestras evaluaciones para que coincidan con el trabajo que delegas a la IA. Android Bench 2.0 refleja estos desafíos ambiciosos con LHT que incluyen actualizar dependencias, agregar funciones nuevas, compilar apps desde cero o convertir una app multiplataforma a Android.
Las tareas complejas requieren una evaluación y una puntuación más detalladas
En las tareas de ingeniería de varios días, la calificación binaria de aprobado o reprobado no captura el panorama completo.
Por ejemplo, un agente podría refactorizar 40 pantallas a Jetpack Compose, configurar tablas de bases de datos y cumplir con el 90% de los requisitos, pero fallar en una sola aserción de caso límite. La puntuación binaria califica esta ejecución como 0%, lo que oculta las capacidades arquitectónicas del modelo. Estamos cambiando a la puntuación continua para proporcionar un indicador más significativo, tanto para el desarrollo de modelos como para que comprendas cómo la IA puede ayudarte.
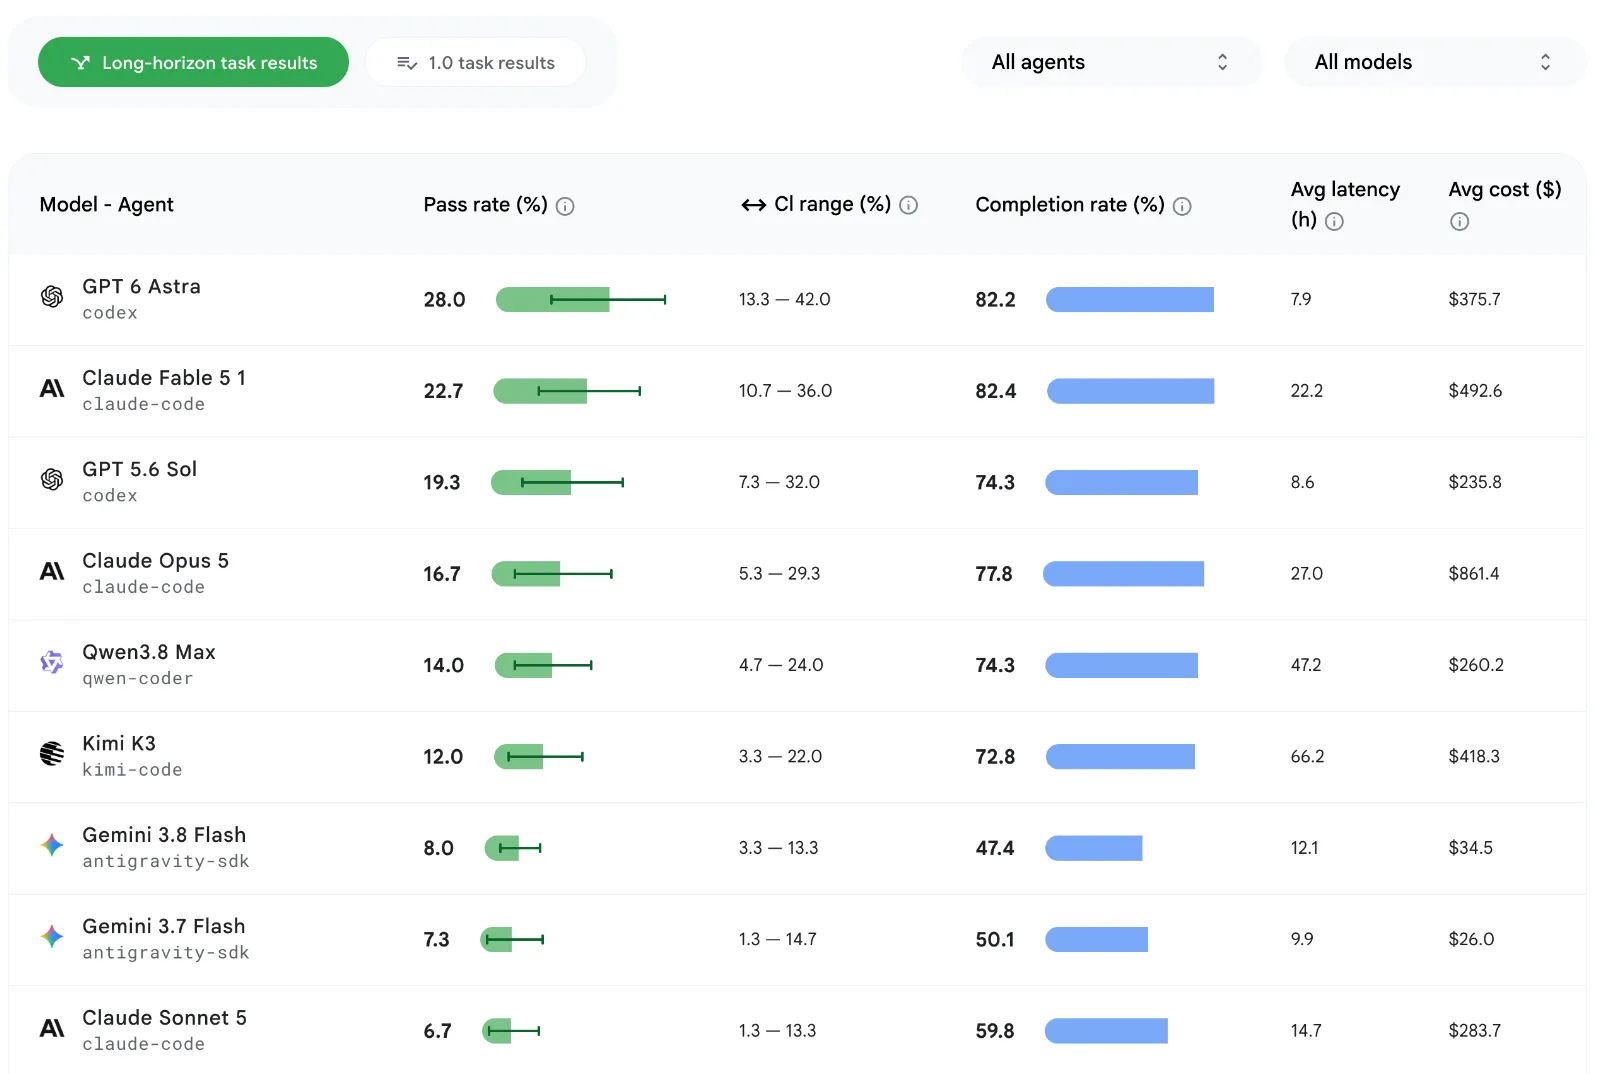
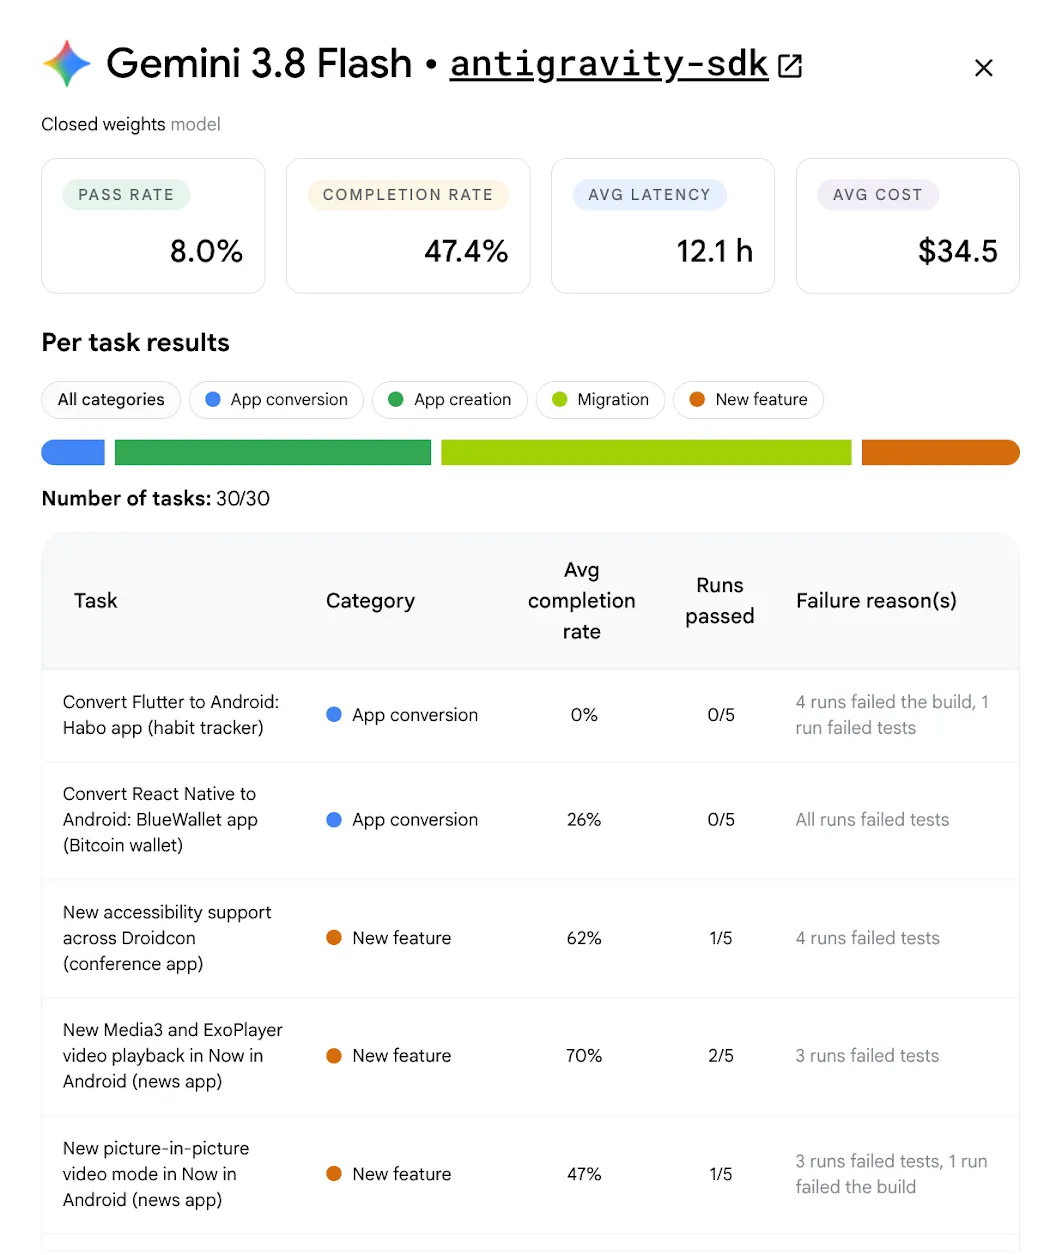
Calculamos este porcentaje de respuesta a través de una combinación de factores, como la funcionalidad, la fidelidad visual y la prevención de regresiones. También aplicamos penalizaciones de puntuación objetivas por desviaciones de las instrucciones de evaluación o las restricciones estructurales. Consulta la tabla de clasificación actualizada y haz clic en la vista de tarjetas de cada modelo para ver elementos adicionales, como la tasa de aprobación, el porcentaje de respuesta y los costos promedio por modelo y por tarea.
La tasa de aprobación más alta para las LHT es de alrededor del 28%, mucho más baja que el ~91% de las tareas originales en la comparativa.
Las tareas de largo horizonte revelan estadísticas útiles para la asistencia de IA
Más allá de medir qué tan bien la IA maneja las tareas de larga duración, el conjunto de datos de LHT nos ayuda a obtener más información sobre las fortalezas y debilidades de los modelos probados, y te ofrecemos orientación más práctica.
En todos los niveles de modelos, la IA escribe mejor código nuevo que refactorizar el código existente. Las refactorizaciones y las migraciones se vuelven más complejas porque el éxito depende de la complejidad de la arquitectura y no del volumen de código.
Los modelos muestran capacidades sólidas en transformaciones determinísticas bien establecidas, como convertir Java en Kotlin, intercambiar Retrofit por Ktor o introducir una capa de ViewModel. Aplican estos patrones de manera coherente, incluso en más de 125 archivos y más de 8,000 líneas de código.
Sin embargo, los modelos tienen dificultades cuando las tareas requieren validación en el entorno de ejecución (como gráficos de inyección de dependencias faltantes), implican cambios rotundos en el framework o se encuentran con lagunas de conocimiento con bibliotecas no publicadas. La portabilidad de apps multiplataforma a Android sigue siendo un desafío abierto: ningún modelo alcanza una tasa de aprobación del 100% y los modelos de frontera alcanzan, como máximo, una tasa de finalización del 80%.
Presentamos las evaluaciones de agentes
Para ayudarte a comprender mejor el rendimiento de los modelos cuando se integran en tus flujos de trabajo de agentes, agregamos agentes de uso común a nuestra evaluación. Para comenzar, ejecutaremos modelos nuevos en comparación con los LHT con agentes del proveedor de modelos correspondiente. Por ejemplo, ejecutamos GPT 5.6 Sol en Codex y Gemini 3.8 Flash en Google Antigravity. Esta vinculación muestra cómo el diseño del harness afecta de forma positiva los resultados de los desarrolladores, ya que vimos que el almacenamiento en caché de instrucciones y la ventana de herramientas compacta pueden generar reducciones de tokens.
En el futuro, ampliaremos esta función destacando también los resultados de varias combinaciones de modelos y agentes, para ayudarte a descubrir qué combinaciones funcionan mejor para ti y tu equipo.
Invertimos en esta medición porque es importante que puedas usar el agente y el modelo que elijas para el desarrollo de Android, y tendremos más novedades para compartir contigo en las próximas semanas.
Se agregaron modelos nuevos
Además, seguimos expandiendo nuestra tabla de clasificación para garantizar que tengas los datos más actualizados para tus decisiones de desarrollo. Agregamos Gemini 3.8 Flash, Gemini 3.7 Flash, GPT-6 de OpenAI, Fable 5.1 de Anthropic, Kimi K3 y Qwen 3.8 Max, con GPT-6 Astra de OpenAI en la cima con una tasa de aprobación del 28%.
Con la mirada puesta en el futuro
Android Bench 2.0 ofrece un entorno sólido para medir la IA en el desarrollo de Android. Combinando tareas de largo horizonte, evaluación multimodal, agentes y puntuación continua, esperamos empoderar a los equipos de investigación de IA para que creen asistentes de programación de IA más capaces y confiables, y esperamos brindarte más transparencia sobre tus opciones para el desarrollo de IA.
Consulta la tabla de clasificación actualizada junto con la metodología actualizada. Tus comentarios influyen directamente en la evolución de Android Bench, así que sigue compartiéndolos con nosotros en GitHub, así como en nuestros canales de redes sociales, como X y LinkedIn.
-
 Novedades de productos
Hoy, en Android Dev Summit, anunciamos la amplia disponibilidad de muchas herramientas y APIs diseñadas para eliminar las dificultades cotidianas y brindarte más flexibilidad para crear apps para Android increíbles.
Matthew McCullough • Lectura de 4 min -
 Novedades de productos
A medida que se acelera el desarrollo de agentes, la ingeniería de Android alcanza una nueva y emocionante frontera: pasar de la finalización de código asistida a agentes que ejecutan tareas de extremo a extremo bajo tu dirección. Tienes total libertad y flexibilidad para elegir los modelos y agentes que usas.
Jason Buchel • Lectura de 3 min -
 Novedades de productos
Como desarrollador de Android, tienes muchas opciones en lo que respecta a los agentes, los LLM, las herramientas y las interfaces de línea de comandos (CLI) que usas para el desarrollo de apps. Nuestro objetivo es ayudarte a crear apps para Android atractivas y de alta calidad, sin importar cómo elijas crearlas.
Simona Milanovic • Lectura de 4 min
Recibe la información más reciente sobre el desarrollo de Android en tu bandeja de entrada todas las semanas.