Anúncio do Gemma 4 na prévia para desenvolvedores do AICore
Leitura de 3 min
No Google, temos o compromisso de levar os modelos de IA mais avançados diretamente para os dispositivos Android no seu bolso. Hoje, temos o prazer de anunciar o lançamento do nosso mais novo modelo aberto de última geração: o Gemma 4.
Esses modelos são a base para a próxima geração do Gemini Nano. Portanto, o código que você escreve hoje para o Gemma 4 vai funcionar automaticamente em dispositivos com o Gemini Nano 4, que serão lançados ainda este ano. Com o Gemini Nano 4, você vai aproveitar nossas otimizações de desempenho adicionais para lançar na produção em todo o ecossistema Android com a inferência no dispositivo mais eficiente.
Você pode ter acesso antecipado a esse modelo hoje mesmo com a prévia para desenvolvedores do AICore.
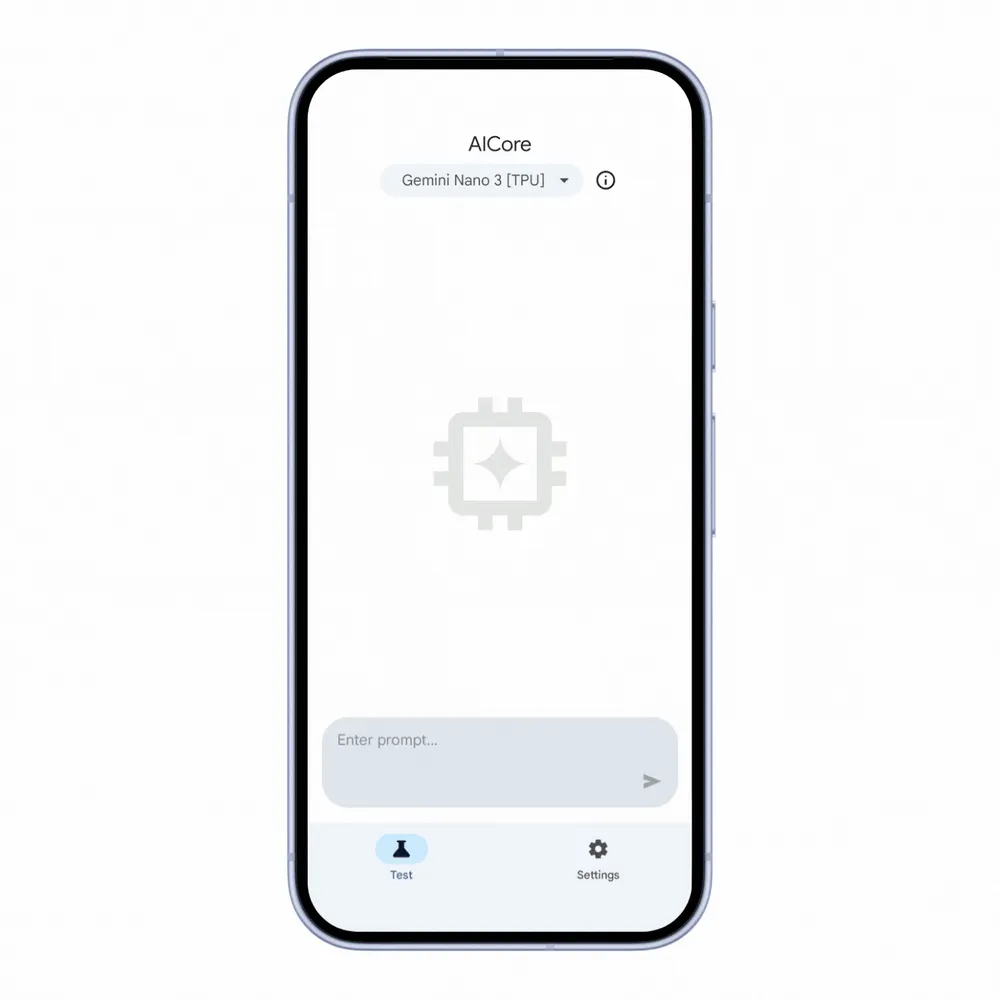
Selecione o modelo Gemini Nano 4 Fast na interface da prévia para desenvolvedores para conferir a velocidade de inferência ultrarrápida em ação antes de escrever qualquer código
Como o Gemma 4 é compatível com mais de 140 idiomas, você pode esperar experiências localizadas e multilíngues aprimoradas para seu público global. Além disso, o Gemma 4 oferece desempenho líder do setor com compreensão multimodal, permitindo que seus apps entendam e processem texto, imagens e áudio. Para oferecer o melhor equilíbrio entre desempenho e eficiência, o Gemma 4 no Android está disponível em dois tamanhos:
- E4B: projetado para tarefas complexas e que exigem maior capacidade de raciocínio.
- E2B: otimizado para velocidade máxima (3 vezes mais rápido que o modelo E4B!) e menor latência.
O novo modelo é até 4 vezes mais rápido que as versões anteriores e usa até 60% menos bateria. A partir de hoje, você pode testar recursos aprimorados, incluindo:
- Motivo: agora, os comandos de linha de raciocínio e as instruções condicionais devem retornar resultados de maior qualidade. Por exemplo: "Determine se o comentário a seguir para uma conversa segue as diretrizes da comunidade. O comentário não passará nas diretrizes da comunidade se contiver um ou mais destes reason_for_flag: linguagem obscena, derogatory language, discurso de ódio”. Se a avaliação for aprovada, retorne {true}. Caso contrário, retorne {false, reason_for_flag}.”
- Matemática: com habilidades matemáticas aprimoradas, o modelo agora pode responder a perguntas com mais precisão. Por exemplo: "Se eu receber 26 pagamentos por ano, quanto devo contribuir em cada um para atingir minha meta de economia de US $10.000 ao longo de um ano?"
- Compreensão de tempo: o modelo agora é mais capaz de raciocinar sobre o tempo, o que o torna mais preciso para casos de uso que envolvem agendas, lembretes e alarmes. Por exemplo: "O evento é às 18h em 18 de agosto, e um lembrete deve ser enviado 10 horas antes do evento. Retorne a hora e a data em que o lembrete deve ser enviado."
- Compreensão de imagens: os casos de uso que envolvem OCR (reconhecimento óptico de caracteres), como compreensão de gráficos, extração de dados visuais e reconhecimento de escrita à mão, agora vão retornar resultados mais precisos.
Participe da prévia para desenvolvedores hoje mesmo para baixar esses modelos em pré-lançamento e começar a criar recursos de última geração imediatamente.
Começar a testar o modelo
Para testar o modelo sem código, siga o guia da prévia para desenvolvedores. Se você quiser integrar esses modelos ao seu fluxo de trabalho atual, facilitamos o processo. Acesse o Android Studio para refinar seu comando e criar com a API Prompt do Kit de ML. Introduzimos uma nova capacidade de especificar um modelo, permitindo que você segmente as variantes E2B (rápida) ou E4B (completa) para testes.
// Define the configuration with a specific track and preference
val previewFullConfig = generationConfig {
    modelConfig = ModelConfig {
        releaseTrack = ModelReleaseTrack.PREVIEW
        preference = ModelPreference.FULL
    }
}

// Initialize the GenerativeModel with the configuration
val previewModel = GenerativeModel.getClient(previewFullConfig)

// Verify that the specific preview model is available
val previewModelStatus = previewModel.checkStatus()
if (previewModelStatus == FeatureStatus.AVAILABLE) {
    // Proceed with inference
    val response = previewModel.generateContent("If I get 26 paychecks per year, how much I should contribute each paycheck to reach my savings goal of $10k over the course of a year? Return only the amount.")

} else {
    // Handle the case where the preview model is not available
    // (e.g., print out log statements)
}
O que esperar durante a prévia para desenvolvedores
O objetivo desta prévia para desenvolvedores é ajudar você a refinar a precisão dos comandos e explorar novos casos de uso para seus apps específicos.
Vamos fazer várias atualizações durante o período de pré-lançamento, incluindo suporte para chamada de ferramenta, saída estruturada, comandos do sistema e modo de pensamento na API Prompt, facilitando o aproveitamento total dos novos recursos do Gemma 4, além de otimizações significativas de desempenho.
Os modelos de pré-lançamento estão disponíveis para teste em dispositivos com AICore. Esses modelos vão ser executados na última geração de aceleradores de IA especializados do Google, da MediaTek e da Qualcomm Technologies. Em outros dispositivos, os modelos serão executados inicialmente em uma implementação de CPU que não representa o desempenho final de produção. Se o dispositivo não tiver o AICore, você também poderá testar esses modelos no app AI Edge Gallery. No futuro, vamos oferecer suporte para mais dispositivos.
Primeiros passos
Quer saber o que o Gemma 4 pode fazer pelos seus usuários?
- Ativação: inscreva-se na prévia para desenvolvedores do AICore.
- Download: depois de ativar, você pode baixar os modelos mais recentes do Gemma 4 diretamente no seu dispositivo de teste compatível.
- Criar: atualize sua implementação do Kit de ML para segmentar os novos modelos e comece a criar no Android Studio.
-
 Notícias sobre produtos
Para ajudar a colocar em produção seus casos de uso da API Prompt do Kit de ML, temos o prazer de anunciar a Otimização Automática de Comandos (APO, na sigla em inglês) para modelos no dispositivo na Vertex AI. A Otimização Automática de Comandos é uma ferramenta que ajuda você a encontrar automaticamente o comando ideal para seus casos de uso.
Chetan Tekur, Chao Zhao, Paul Zhou, Caren Chang • Leitura de 3 min -
 Notícias sobre produtos
A IA está facilitando a criação de experiências personalizadas em apps que transformam o conteúdo no formato certo para os usuários. Anteriormente, permitimos que os desenvolvedores fizessem a integração com o Gemini Nano usando as APIs GenAI do Kit de ML, que são personalizadas para casos de uso específicos, como resumos e descrições de imagens.
Caren Chang, Chengji Yan, Penny Li • Leitura de 2 min -
 Notícias sobre produtos
Após mais de um ano de preparação conjunta com líderes do setor, parceiros regionais, App Distribution e comunidades do Android, nossas proteções ao usuário entraram em vigor em 30 de setembro para as lojas participantes no Brasil, na Indonésia, em Singapura e na Tailândia.
Matthew Forsythe • Leitura de 2 min
Receba os insights mais recentes sobre o desenvolvimento para Android na sua caixa de entrada toda semana.