Meningkatkan pengembangan Android yang dibantu AI dan meningkatkan kualitas LLM dengan Android Bench
Waktu baca: 2 menit
Kami ingin mempermudah dan mempercepat Anda dalam membangun aplikasi Android berkualitas tinggi, dan salah satu cara kami membantu Anda menjadi lebih produktif adalah dengan menghadirkan AI di ujung jari Anda. Kami tahu Anda menginginkan AI yang benar-benar memahami nuansa platform Android, itulah sebabnya kami mengukur performa LLM dalam tugas pengembangan Android. Hari ini kami merilis versi pertama Android Bench, papan peringkat LLM resmi kami untuk pengembangan Android.
Tujuan kami adalah menyediakan tolok ukur bagi pembuat model untuk mengevaluasi kemampuan LLM dalam pengembangan Android. Dengan menetapkan tolok ukur yang jelas dan andal untuk seperti apa pengembangan Android berkualitas tinggi, kami membantu pembuat model mengidentifikasi kesenjangan dan mempercepat peningkatan—yang memungkinkan developer bekerja lebih efisien dengan berbagai model bermanfaat yang dapat dipilih untuk bantuan AI—yang pada akhirnya akan menghasilkan aplikasi berkualitas lebih tinggi di seluruh ekosistem Android.
Dirancang dengan tugas pengembangan Android dunia nyata
Kami membuat tolok ukur dengan menyusun serangkaian tugas yang mencakup berbagai area pengembangan Android umum. Terdiri dari tantangan nyata dengan tingkat kesulitan yang bervariasi, yang bersumber dari repositori Android GitHub publik. Skenarionya mencakup mengatasi perubahan yang menyebabkan gangguan di seluruh rilis Android, tugas khusus domain seperti jaringan di perangkat wearable, dan bermigrasi ke Jetpack Compose versi terbaru, dan masih banyak lagi.
Setiap evaluasi berupaya membuat LLM memperbaiki masalah yang dilaporkan dalam tugas, yang kemudian kami verifikasi menggunakan pengujian unit atau instrumentasi. Pendekatan yang tidak bergantung model ini memungkinkan kami mengukur kemampuan model dalam menavigasi codebase yang kompleks, memahami dependensi, dan memecahkan jenis masalah yang Anda temui setiap hari.
Kami memvalidasi metodologi ini dengan beberapa pembuat LLM, termasuk JetBrains.
“Mengukur dampak AI pada Android adalah tantangan besar, jadi sangat bagus melihat framework yang begitu solid dan realistis ini. Meskipun kami aktif melakukan tolok ukur sendiri, Android Bench adalah tambahan yang unik dan disambut baik. Metodologi ini adalah jenis evaluasi ketat yang dibutuhkan developer Android saat ini.”
- Kirill Smelov, Head of AI Integrations di JetBrains.
Hasil Android Bench pertama
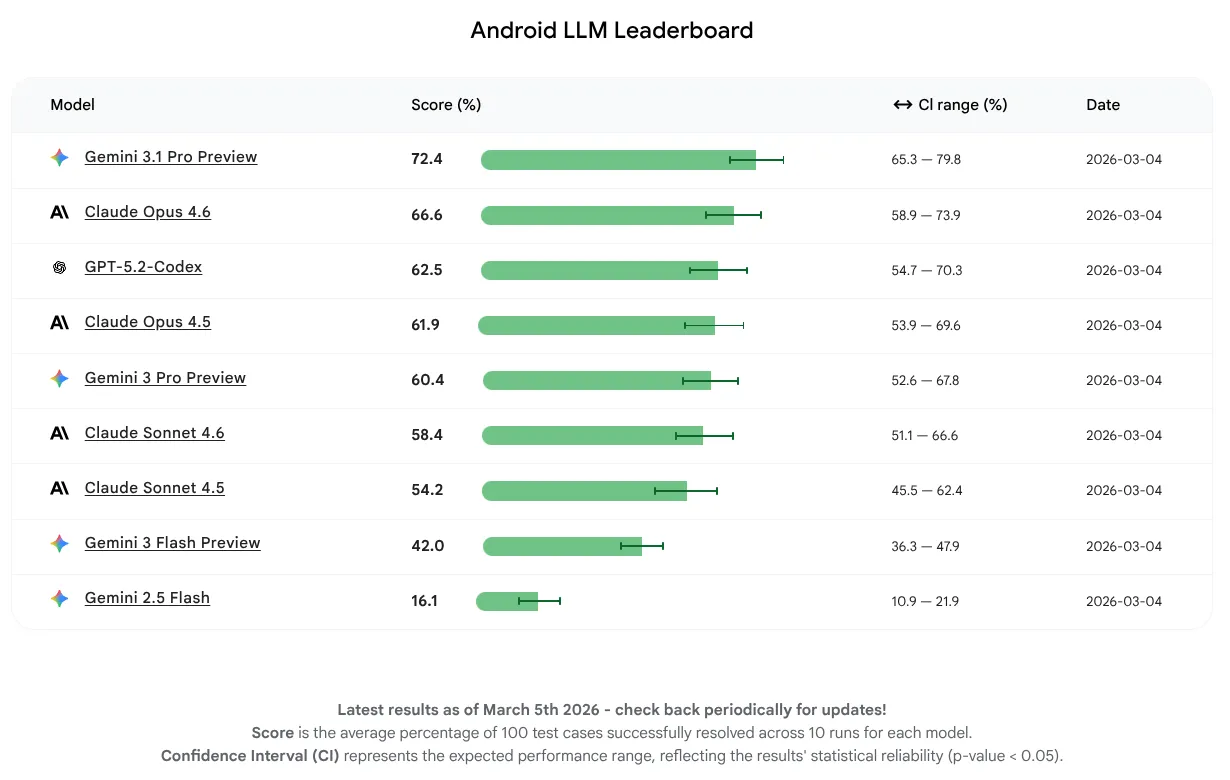
Untuk rilis awal ini, kami ingin mengukur performa model secara murni dan tidak berfokus pada penggunaan alat atau agen. Model berhasil menyelesaikan 16-72% tugas. Rentang ini menunjukkan bahwa beberapa LLM sudah memiliki dasar yang kuat untuk pengetahuan Android, sementara yang lain masih perlu ditingkatkan. Terlepas dari kondisi model saat ini, kami mengantisipasi peningkatan berkelanjutan karena kami mendorong pembuat LLM untuk meningkatkan kualitas model mereka untuk pengembangan Android.
LLM dengan skor rata-rata tertinggi untuk rilis pertama ini adalah Gemini 3.1 Pro, diikuti oleh Claude Opus 4.6. Anda dapat mencoba semua model yang kami evaluasi untuk bantuan AI bagi project Android Anda dengan menggunakan kunci API di versi stabil terbaru Android Studio.
Memberikan transparansi kepada developer dan pembuat LLM
Kami menghargai pendekatan yang terbuka dan transparan, jadi kami membuat metodologi, set data, dan test harness tersedia secara publik di GitHub.
Salah satu tantangan untuk tolok ukur publik adalah risiko kontaminasi data, di mana model mungkin telah melihat tugas evaluasi selama proses pelatihannya. Kami telah mengambil langkah-langkah untuk memastikan hasil kami mencerminkan penalaran yang sebenarnya, bukan hafalan atau tebakan, termasuk peninjauan manual menyeluruh terhadap lintasan agen, atau integrasi string uji untuk mencegah pelatihan.
Ke depannya, kami akan terus mengembangkan metodologi kami untuk menjaga integritas set data, sekaligus melakukan peningkatan untuk rilis tolok ukur mendatang—misalnya, meningkatkan kuantitas dan kompleksitas tugas.
Kami menantikan bagaimana Android Bench dapat meningkatkan kualitas bantuan AI dalam jangka panjang. Visi kami adalah memperkecil kesenjangan antara konsep dan kode berkualitas. Kami sedang membangun fondasi untuk masa depan di mana apa pun yang Anda bayangkan, Anda dapat membuatnya di Android.
-
 Berita Produk
Hari ini kami merilis kumpulan pertama tugas jangka panjang (LHT), yaitu tugas yang sangat kompleks yang membutuhkan waktu beberapa hari atau bahkan seminggu bagi seorang engineer untuk menyelesaikannya. Kami juga memperkenalkan evaluasi berbasis agen, yang dimulai dengan agen dari penyedia model yang sesuai.
Matthew McCullough • Waktu baca: 3 menit -
 Berita Produk
Hari ini kami merilis Android 17 dan menyediakannya di sebagian besar perangkat Pixel yang didukung. Cari perangkat baru yang menjalankan Android 17 dalam beberapa bulan mendatang.
Matthew McCullough • Waktu baca: 13 menit -
 Berita Produk
Google I/O '26 menampilkan 17 pengumuman penting untuk developer Android yang berfokus pada produktivitas yang didukung agen, Compose First sebagai standar UI kami, serta media berperforma tinggi dan pengembangan adaptif untuk ekosistem yang terus berkembang.
Matthew McCullough • Waktu baca: 8 menit
Dapatkan insight pengembangan Android terbaru yang dikirim ke kotak masuk Anda setiap minggu.