تطوير طريقة قياس أداء النماذج اللغوية الكبيرة على Android: الجيل التالي من Android Bench
يستغرق الاطِّلاع على المقال 3 دقائق
في آذار (مارس) الماضي، قدّمنا Android Bench، وهي لوحة الصدارة الخاصة بالنماذج اللغوية الكبيرة والمخصّصة لمهام تطوير تطبيقات Android في العالم الحقيقي. كان هدفنا توفير الشفافية بشأن إمكانات النماذج في تطوير تطبيقات Android وتشجيع تحسين النماذج، وذلك لتزويدك بخيارات أكثر فائدة مستندة إلى الذكاء الاصطناعي في سير عملك اليومي. منذ ذلك الحين، حسّنّا معيار الأداء استنادًا إلى ملاحظاتكم، بما في ذلك تقييم نماذج الوزن المفتوح وإضافة سمات التكلفة والكفاءة إلى قائمة الصدارة.
ومع ذلك، تتطوّر إمكانات الذكاء الاصطناعي باستمرار، ويجب أن يواكب القياس هذا التطور. في إطار إصدارنا لشهر يوليو، اعتمدنا إطار عمل Harbor، الذي يتضمّن نسخة معدَّلة من أداة قياس الأداء المستخدَمة لتقييم النماذج.
بالإضافة إلى هذا التغيير في عملية التقييم، سنضيف في إصدار يوليو 8 نماذج جديدة (Claude Fable 5 وClaude Sonnet 5 وClaude Opus 4.8 وGLM 5.2 وKimi K2.7 Code وMiniMax M3 وQwen 3.7 Plus وQwen 3.7 Max) إلى قائمة الصدارة. نشارك أيضًا فرصًا تتيح لك، أي مجتمع مطوّري Android، المساهمة في معيار الأداء.
تحسين منهجيتنا باستخدام إطار عمل Harbor
عندما صمّمنا Android Bench، استندنا في منهجيتنا إلى المعايير الرائدة في المجال والمتوفّرة في ذلك الوقت. استخدمنا الإصدار 1 من mini-swe-agent، وهو وكيل قياس أداء للأغراض العامة، وعدّلناه ليتناسب مع الفروق الدقيقة في تطوير تطبيقات Android من أجل توفير قياس أساسي لقدرات النماذج في مهام تطوير تطبيقات Android الشائعة.
لمواصلة تقديم تقييمات متطوّرة لك تقيس بدقة أحدث إمكانات النماذج في تطوير تطبيقات Android، نعمل على مواءمة معاييرنا مع إطار عمل Harbor. تحدّد Harbor المعايير وعمليات الدمج التي تسهّل على أي شخص إجراء قياس الأداء أو تقييم الإعداد المفضّل أو مشاركة النتائج، ما يوفّر لك المزيد من الشفافية وإمكانية الاطّلاع على البيانات.
يتيح لنا هذا التحسين تقييم النماذج وقدراتها بشكل أكثر دقة، وأعدنا إجراء اختبار الأداء على جميع النماذج لتحديد خط أساس محدّث. وهذا يعني حدوث تغيير طفيف في نظام التسجيل، ولكن سيظل بإمكانك الاطّلاع على النتائج السابقة ضمن الأرشيف على موقعنا الإلكتروني.
نريد التأكّد من أنّ أداة Android Bench مفيدة لك، لذا سنواصل تعديلها مع تطوّر تقييماتنا والمجال.
توسيع قائمة أفضل النماذج لتشمل 8 نماذج جديدة
في إطار التزامنا بإبقاء لوحة الصدارة محدّثة، أضفنا Claude Fable 5 وClaude Sonnet 5 وClaude Opus 4.8 وGLM 5.2 وKimi K2.7 Code وMiniMax M3 وQwen 3.7 Plus وQwen 3.7 Max إلى لوحة الصدارة في Android Bench.
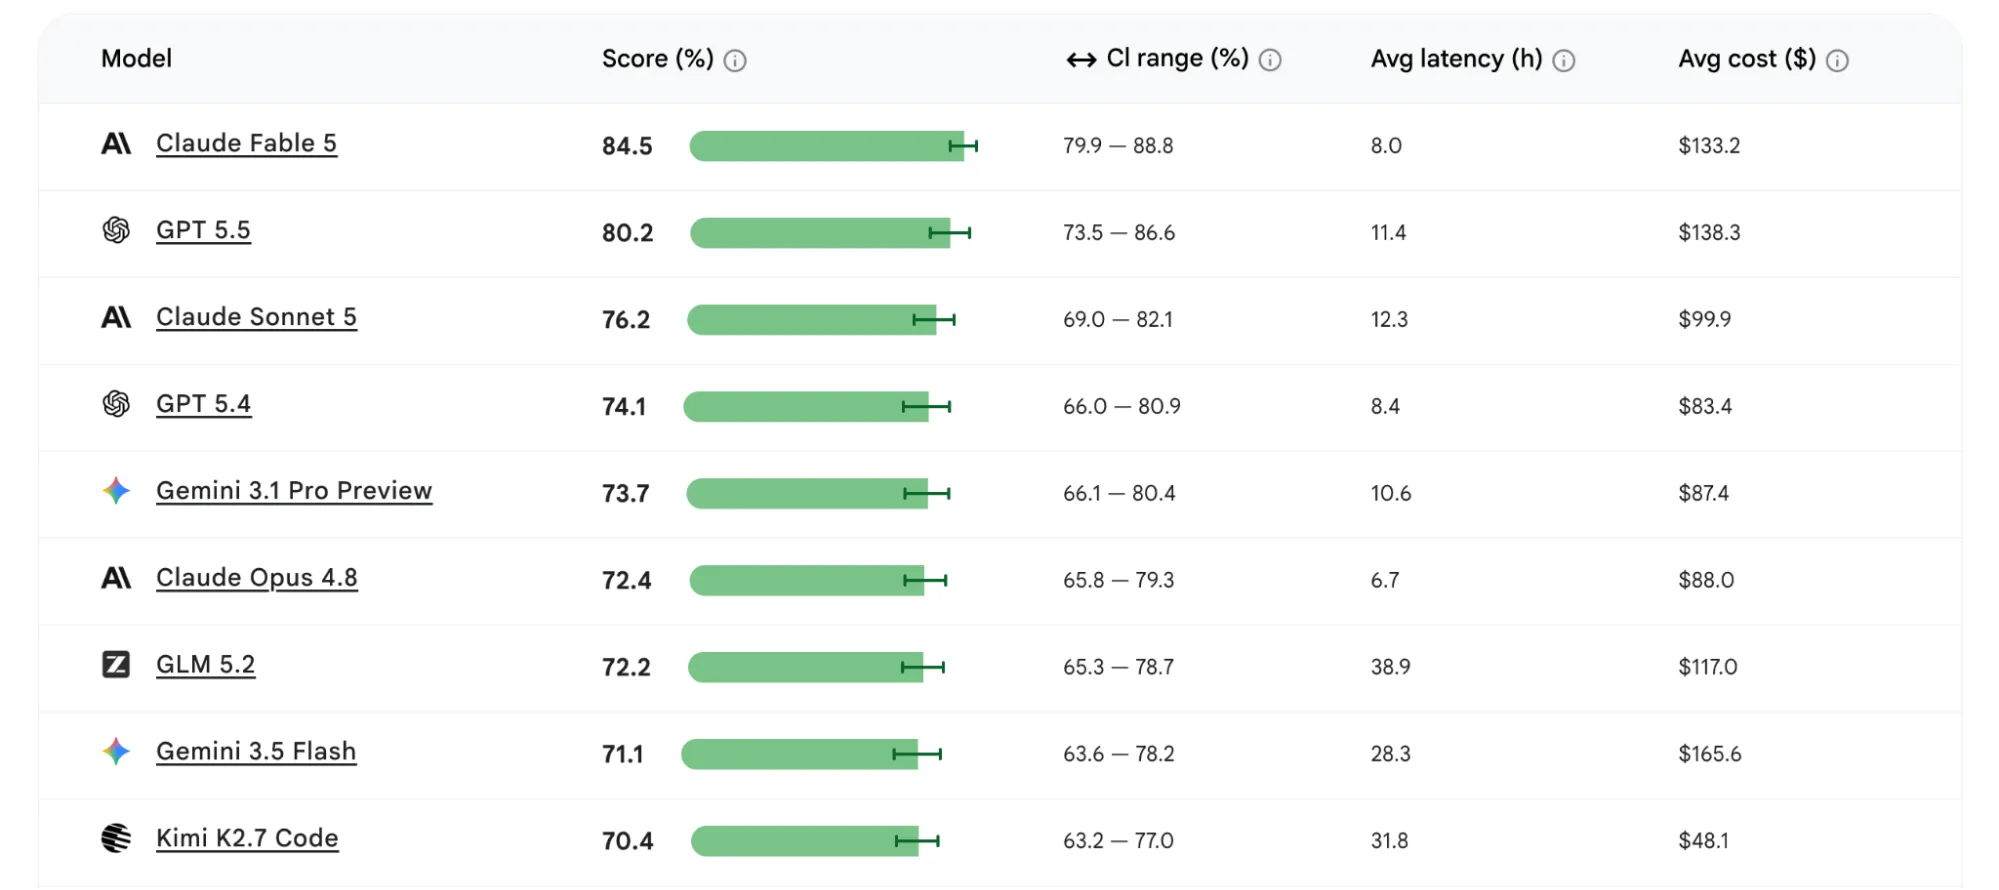
يمكنك ملاحظة أنّ Claude Fable 5 يتصدّر قائمة أفضل الأداء بنتيجة 84.5، يليه GPT 5.5 بنتيجة 80.2، ثم Claude Sonnet 5 في المركز الثالث بنتيجة 76.2.
عند مقارنة نماذج Open-weight فقط، يتصدّر GLM 5.2 القائمة بنتيجة 72.2، يليه Kimi K2.7 Code بنتيجة 70.4.
يمكنك الاطّلاع على مقاييس أداء النماذج وكفاءتها في قائمة الصدارة المعدَّلة لمعرفة كيفية تعامل هذه النماذج الجديدة والسابقة مع التحديات الخاصة بنظام Android، مثل عمليات نقل Jetpack Compose، والشبكات القابلة للارتداء، وتحديثات واجهة برمجة التطبيقات للنظام الأساسي.
إتاحة مساهمات المنتدى في Android Bench
منذ البداية، حرصنا على اتّباع نهج مفتوح وشفّاف، ولهذا السبب أتحنا للجميع الوصول إلى منهجيتنا الأصلية وأدوات الاختبار على GitHub. لقد طلبتم توفير طريقة لتقديم ملاحظات حول مجموعة البيانات، لذا سنعزّز الآن التعاون من خلال منحكم، أي مجتمع مطوّري تطبيقات Android، فرصة للمساهمة في تطوير Android Bench.
اعتبارًا من اليوم، يمكنك المساهمة في Android Bench بطريقتَين:
- يمكنك تصميم مهام تطوير تطبيقات Android وإرسالها لتقييم كيفية تعامل النماذج مع السيناريوهات التي تهمّك.
- إجراء تقييمات الأداء ومشاركتها مباشرةً، واختبار النماذج المفضّلة لديك باستخدام مجموعة البيانات الخاصة بنا أو مهامك المخصّصة
سنراجع المهام المُرسَلة وسنقيّم ما إذا كانت ستتم إضافتها إلى مقياس الأداء. نأمل أن نضع معيارًا يعكس بشكل حقيقي التحديات اليومية المتنوّعة التي يواجهها منتدى مطوّري Android العالمي.
التطلّع إلى المستقبل
مع توفّر المزيد من الخيارات للتطوير المستند إلى الذكاء الاصطناعي الوكيل، يضمن الحفاظ على معيار متطوّر أن تظل المساعدة المستندة إلى الذكاء الاصطناعي التي تعتمد عليها أكثر ذكاءً وفائدةً وفعاليةً. يمكنك الانتقال إلى مستودع GitHub للاطّلاع على المهام. ندعوك إلى إرسال مهمة إلى فريقنا لمراجعتها، ويمكنك الاطّلاع على Harbor Hub لاستكشاف مجموعة البيانات أو إرسال تقييمات.
يمكنك دائمًا الاطّلاع على قائمة الصدارة المعدَّلة أو قراءة المنهجية على موقعنا الإلكتروني.
-
 أخبار المنتجات
أصبحت ميزة تصحيح الأخطاء لاسلكيًا على Android أسرع وأكثر موثوقية وأسهل في الإعداد من أي وقت مضى. في الإصدار 2.0 من ميزة "تصحيح الأخطاء عبر Wi-Fi باستخدام ADB"، طرحنا حزمة خادم جديدة وطريقة أكثر ذكاءً للتعامل مع الشبكة بهدف معالجة ملاحظات المطوّرين حول المشاكل المتعلّقة بسهولة الاستخدام.
Steven Jenkins, Sherif Eid, Fabien Sanglard • يستغرق الاطّلاع على المقال دقيقة واحدة -
 أخبار المنتجات
هذا هو الإصدار الثابت النهائي من Android Studio Quail. تتيح لك الميزات الجديدة في Android Studio إنشاء تطبيقات مميّزة باستخدام الذكاء الاصطناعي بكفاءة وفعالية.
Amman Asfaw • يستغرق الاطِّلاع على المقال 5 دقائق -
 أخبار المنتجات
الحفاظ على منظومة Android المتكاملة الصحية هو التزام مشترك يضطلع فيه كل تطبيق ولعبة بدور مهم.
Raghavendra Hareesh Pottamsetty • مدة القراءة: 4 دقائق
يمكنك تلقّي أحدث الإحصاءات حول تطوير تطبيقات Android في بريدك الوارد أسبوعيًا.