Android 运行时 (ART) 团队在不影响已编译代码或任何峰值内存回归的情况下,将编译时间缩短了 18%。这项改进是我们 2025 年计划的一部分,旨在缩短编译时间,同时不牺牲内存用量或编译代码的质量。
优化编译时速度对 ART 至关重要。例如,在即时 (JIT) 编译时,它会直接影响应用的效率和设备的整体性能。更快的编译速度可缩短优化生效前的时间,从而提供更流畅、更灵敏的用户体验。此外,无论是 JIT 还是 AOT,编译速度的提升都意味着编译过程中的资源消耗减少,从而有利于延长电池续航时间并降低设备温度,尤其是在低端设备上。
其中一些编译时速度改进已在 2025 年 6 月的 Android 版本中发布,其余改进将在年底发布的 Android 版本中提供。此外,所有使用 Android 12 及更高版本的用户都可以通过 Mainline 更新获得这些改进。
优化优化编译器
优化编译器始终是一个权衡取舍的过程。速度不是凭空提升的,您必须做出一些牺牲。我们为自己设定了一个非常明确且具有挑战性的目标:提高编译器速度,但不能引入内存回归,更重要的是,不能降低其生成的代码质量。如果编译器速度更快,但应用运行速度更慢,那么我们就失败了。
我们愿意投入的唯一资源就是自己的开发时间,以便深入挖掘、调查并找到符合这些严格标准的巧妙解决方案。让我们来详细了解一下,我们如何努力寻找有待改进的方面,以及如何针对各种问题找到合适的解决方案。
寻找值得尝试的优化方案
在开始优化指标之前,您必须能够衡量该指标。否则,您永远无法确定自己是否有所改进。幸运的是,只要您采取一些预防措施,例如在更改前后使用同一设备进行测量,并确保设备不会进入过热保护,编译时间速度就会相当一致。除此之外,我们还提供确定性测量(例如编译器统计信息),帮助我们了解底层运行情况。
由于我们为这些改进而牺牲的资源是开发时间,因此我们希望能够尽可能快地进行迭代。这意味着,我们选取了一些具有代表性的应用(包括第一方应用、第三方应用和 Android 操作系统本身)来设计原型解决方案。后来,我们通过广泛的手动和自动化测试,验证了最终实现方案的价值。
有了这组精心挑选的 APK,我们就可以在本地触发手动编译,获取编译的配置文件,并使用 pprof 直观地了解时间花在了哪里。
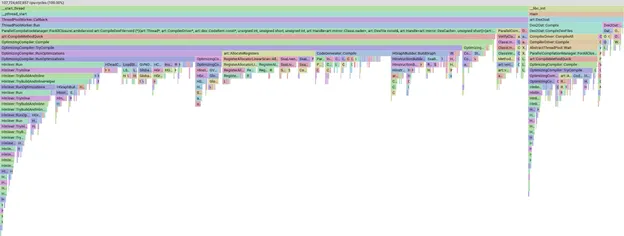
pprof 中的性能剖析火焰图示例
pprof 工具非常强大,可让我们对数据进行切片、过滤和排序,以便查看哪些编译器阶段或方法占用了大部分时间。我们不会详细介绍 pprof 本身;只需知道,如果条形图更大,则意味着编译花费了更多时间。
其中一个视图是“自下而上”视图,您可以在其中查看哪些方法占用了大部分时间。在下图中,我们可以看到一个名为 Kill 的方法,它占用了超过 1% 的编译时间。本文稍后还会讨论其他一些主要方法。
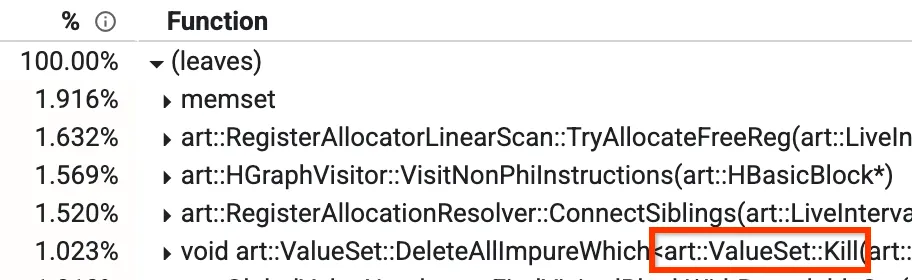
配置文件的自下而上视图
在我们的优化编译器中,有一个阶段称为全局值编号 (GVN)。您不必担心它的整体功能,但相关部分是知道它有一个名为“Kill”的方法,该方法会根据过滤器删除一些节点。这非常耗时,因为它必须遍历所有节点并逐个检查。我们注意到,在某些情况下,无论当时有哪些节点处于活跃状态,我们都会提前知道检查结果为 false。在这种情况下,我们可以完全跳过迭代,将其从 1.023% 降至约 0.3%,并将 GVN 的运行时缩短约 15%。
实施有价值的优化
我们介绍了如何衡量和检测时间花在何处,但这仅仅是个开始。下一步是了解如何优化编译所花费的时间。
通常,在上述“Kill”等情况下,我们会查看如何遍历节点,并通过并行执行操作或改进算法本身等方式来加快遍历速度。事实上,我们一开始就是这么尝试的,直到我们发现无计可施时,才恍然大悟,意识到解决方案是(在某些情况下)根本不进行迭代!在进行此类优化时,很容易只见树木不见森林。
在其他情况下,我们使用了几种不同的技术,包括:
- 使用启发法来确定优化是否无法产生有价值的结果,从而可以跳过
- 使用额外的数据结构来缓存计算出的数据
- 更改当前数据结构以提高速度
- 在某些情况下延迟计算结果以避免循环
- 使用正确的抽象 - 不必要的功能可能会降低代码速度
- 避免通过多次加载来追踪常用指针
我们如何知道这些优化是否值得追求?
这就是它的妙处,您不需要。在检测到某个区域耗费了大量编译时间,并投入开发时间尝试改进后,有时您可能无法找到解决方案。也许什么都不用做,也许实施起来耗时太长,也许会使另一个指标显著下降,也许会增加代码库的复杂性,等等。您在这篇博文中看到的每一次成功优化,背后都有无数次没有结果的尝试。
如果您也遇到类似情况,请尝试以尽可能少的工作量来估算您将对指标做出多大改进。这意味着,按顺序:
- 根据您已收集的指标进行估算,或仅凭直觉
- 使用快速粗略的原型进行估算
- 实施解决方案。
别忘了考虑评估解决方案的缺点。例如,如果您要依赖额外的数据结构,您愿意使用多少内存?
深入了解
言归正传,我们来看看已经实施的一些变更。
我们实施了一项优化更改,以优化名为 FindReferenceInfoOf 的方法。此方法对向量执行线性搜索以查找条目。我们更新了该数据结构,以便通过指令的 ID 进行索引,从而使 FindReferenceInfoOf 的时间复杂度为 O(1) 而不是 O(n)。此外,我们还预先分配了向量,以避免调整大小。我们稍微增加了内存,因为我们必须添加一个额外的字段来统计我们在向量中插入了多少个条目,但这是一个很小的牺牲,因为峰值内存并没有增加。这使我们的 LoadStoreAnalysis 阶段速度提高了 34-66%,从而使编译时间缩短了约 0.5-1.8%。
我们有一个自定义的 HashSet 实现,并在多个地方使用。创建此数据结构需要花费大量时间,我们找到了原因。许多年前,这种数据结构仅在少数使用非常大的 HashSet 的地方使用,并针对这种情况进行了优化。不过,现在它被反向使用,只有少数条目,且生命周期很短。这意味着,我们创建了这个庞大的 HashSet,但只用它来存储几个条目,然后就将其舍弃,这会浪费周期。通过这项更改,我们将编译时间缩短了大约 1.3-2%。此外,由于我们没有使用像以前那样大的数据结构,内存用量减少了约 0.5-1%。
我们通过按引用将数据结构传递给 lambda 来避免复制数据结构,从而将编译时间缩短了约 0.5-1%。这是我们在最初审核时遗漏的问题,在我们的代码库中存在了多年。正是因为查看了 pprof 中的性能剖析,我们才注意到这些方法会创建和销毁大量数据结构,从而促使我们对其进行调查和优化。
我们通过缓存计算值加快了写入编译输出的阶段,从而将总编译时间缩短了约 1.3-2.8%。遗憾的是,额外的簿记工作量太大,我们的自动化测试提醒我们出现了内存回归。后来,我们再次查看了相同的代码,并实现了一个新版本,该版本不仅解决了内存回归问题,还进一步缩短了大约 0.5-1.8% 的编译时间!在第二项更改中,我们必须重构并重新构想此阶段的工作方式,以便摆脱这两种数据结构中的一种。
我们的优化编译器有一个阶段会内联函数调用,以提高性能。为了选择要内联的方法,我们在执行任何计算之前会使用这两种启发法,并在执行工作之后、最终确定内联之前进行最终检查。如果其中任何一个检测到内联不值得(例如,会添加太多新指令),那么我们就不会内联方法调用。
我们将两项检查从“最终检查”类别移至“启发式”类别,以便在执行任何耗时的计算之前,先估算内联是否会成功。由于这只是一个估算值,因此并不完美,但我们已验证,新的启发式算法涵盖了之前内联内容的 99.9%,且不会影响性能。其中一个新启发法与所需的 DEX 寄存器有关(提升约 0.2-1.3%),另一个与指令数量有关(提升约 2%)。
我们有一个自定义的 BitVector 实现,并在多个位置使用。我们针对某些固定大小的位向量,将可调整大小的 BitVector 类替换为更简单的 BitVectorView。这样可以消除一些间接寻址和运行时范围检查,并加快位向量对象的构建速度。
此外,BitVectorView 类在底层存储类型上进行了模板化(而不是始终使用 uint32_t 作为旧 BitVector)。这样一来,某些操作(例如 Union())在 64 位平台上可以同时处理两倍的位数。在编译 Android OS 时,受影响函数的样本总数减少了 1% 以上。这是通过多项更改 [1、2、3、4、5、6] 实现的
如果我们要详细讨论所有优化措施,那可能需要一整天的时间!如果您对更多优化措施感兴趣,请查看我们实施的其他一些更改:
- 添加了簿记,可将编译时间缩短约 0.6-1.6%。
- 尽可能延迟计算数据,以避免循环。
- 重构代码,以便在不使用预计算工作时跳过该工作。
- 当分配器可以轻松从其他位置获取时,避免使用一些依赖加载链。
- 另一种情况是添加检查以避免不必要的工作。
- 避免在寄存器分配器中频繁分支寄存器类型(核心/FP)。
- 确保在编译时初始化某些数组。不要依赖 clang 来执行此操作。
- 清理一些循环。使用 clang 可以更好地优化的范围循环,因为 clang 不需要由于循环副作用而重新加载容器的内部指针。避免在循环中通过内联的 `InputAt(.)` 为每个输入调用虚函数 `HInstruction::GetInputRecords()`。
- 通过利用编译器优化,避免对访问者模式使用 Accept() 函数。
总结
我们致力于提高 ART 的编译时速度,并取得了显著成效,这不仅让 Android 运行更流畅、更高效,还有助于延长电池续航时间并改善设备散热。通过不懈地发现和实施优化措施,我们证明了在不影响内存用量或代码质量的情况下,可以大幅缩短编译时间。
我们的历程包括使用 pprof 等工具进行性能分析、愿意迭代,有时甚至放弃成效不佳的途径。ART 团队的共同努力不仅显著缩短了编译时间,还为未来的改进奠定了基础。
所有这些改进都将在 2025 年底的 Android 更新中提供,并会通过 Mainline 更新提供给 Android 12 及更高版本。希望这次对优化流程的深入探究能让您对编译器工程的复杂性和回报有更深入的了解!
-
 产品资讯
随着智能体开发不断加速,Android 工程领域正迈向一个令人振奋的新境界:从辅助性代码补全,跃升至智能体在您的指挥下执行端到端任务。您可以完全自主、灵活地选择要使用的模型和智能体。
Jason Buchel • 阅读用时:3 分钟 -
 产品资讯
今天,我们分享了如何将“不只是商店”的愿景推进到下一个阶段。从月活跃用户数超过 2.5 亿的“我”标签页,到连接超过 7 亿玩家资料的统一游戏平台,Google Play 始终致力于满足用户的各种需求。
Paul Feng • 阅读用时:3 分钟 -
 产品资讯
我们很高兴能通过 Googlebook 帮助用户表达自我,并让他们能够使用这些工具。
Cyrus Stoller • 阅读用时:2 分钟
每周通过电子邮件接收最新的 Android 开发洞见。