ทีม Android Runtime (ART) ได้ลดเวลาคอมไพล์ลง 18% โดยไม่ส่งผลกระทบต่อโค้ดที่คอมไพล์หรือการถดถอยของหน่วยความจำสูงสุด การปรับปรุงนี้เป็นส่วนหนึ่งของโครงการริเริ่มในปี 2025 ของเราเพื่อปรับปรุงเวลาคอมไพล์โดยไม่ลดทอนการใช้งานหน่วยความจำหรือคุณภาพของโค้ดที่คอมไพล์
การเพิ่มประสิทธิภาพความเร็วเวลาคอมไพล์เป็นสิ่งสำคัญสำหรับ ART ตัวอย่างเช่น เมื่อคอมไพล์แบบ Just-In-Time (JIT) จะส่งผลโดยตรงต่อประสิทธิภาพของแอปพลิเคชันและประสิทธิภาพโดยรวมของอุปกรณ์ การคอมไพล์ที่เร็วขึ้นจะช่วยลดเวลาก่อนที่การเพิ่มประสิทธิภาพจะเริ่มทำงาน ซึ่งจะทำให้ผู้ใช้ได้รับประสบการณ์การใช้งานที่ราบรื่นและตอบสนองได้ดียิ่งขึ้น นอกจากนี้ ทั้ง JIT และ Ahead-of-Time (AOT) การปรับปรุงความเร็วเวลาคอมไพล์จะช่วยลดการใช้ทรัพยากรในระหว่างกระบวนการคอมไพล์ ซึ่งส่งผลดีต่อระยะเวลาการใช้งานแบตเตอรี่และอุณหภูมิของอุปกรณ์ โดยเฉพาะในอุปกรณ์ระดับล่าง
การปรับปรุงความเร็วเวลาคอมไพล์บางส่วนเหล่านี้เปิดตัวใน Android รุ่นเดือนมิถุนายน 2025 และส่วนที่เหลือจะพร้อมใช้งานใน Android รุ่นปลายปี นอกจากนี้ ผู้ใช้ Android ทุกคนในเวอร์ชัน 12 ขึ้นไปจะมีสิทธิ์รับการปรับปรุงเหล่านี้ผ่านการอัปเดต Mainline
การเพิ่มประสิทธิภาพคอมไพเลอร์ที่เพิ่มประสิทธิภาพ
การเพิ่มประสิทธิภาพคอมไพเลอร์เป็นเรื่องของการแลกเปลี่ยนเสมอ คุณไม่สามารถเพิ่มความเร็วได้ฟรีๆ แต่ต้องแลกกับบางอย่าง เราตั้งเป้าหมายที่ชัดเจนและท้าทายมากสำหรับตัวเอง นั่นคือทำให้คอมไพเลอร์ทำงานเร็วขึ้น แต่ต้องทำโดยไม่ทำให้เกิดการถดถอยของหน่วยความจำ และที่สำคัญคือต้องไม่ลดคุณภาพของโค้ดที่สร้างขึ้น หากคอมไพเลอร์ทำงานเร็วขึ้นแต่แอปทำงานช้าลง แสดงว่าเราล้มเหลว
ทรัพยากรเดียวที่เรายินดีใช้คือเวลาในการพัฒนาของเราเองเพื่อเจาะลึก ตรวจสอบ และค้นหาโซลูชันอันชาญฉลาดที่ตรงตามเกณฑ์ที่เข้มงวดเหล่านี้ มาดูรายละเอียดเพิ่มเติมเกี่ยวกับวิธีที่เราทำงานเพื่อค้นหาจุดที่ควรปรับปรุง รวมถึงการค้นหาโซลูชันที่เหมาะสมสำหรับปัญหาต่างๆ กัน
การค้นหาการเพิ่มประสิทธิภาพที่เป็นไปได้และคุ้มค่า
ก่อนที่จะเริ่มเพิ่มประสิทธิภาพเมตริก คุณต้องวัดเมตริกนั้นได้ มิฉะนั้น คุณจะไม่มีทางรู้เลยว่าได้ปรับปรุงประสิทธิภาพหรือไม่ โชคดีที่ความเร็วของเวลาคอมไพล์ค่อนข้างคงที่ ตราบใดที่คุณใช้มาตรการป้องกันบางอย่าง เช่น การใช้อุปกรณ์เดียวกันกับที่ใช้ในการวัดก่อนและหลังการเปลี่ยนแปลง และตรวจสอบว่าคุณไม่ได้จำกัดความเร็วของอุปกรณ์เนื่องจากความร้อน นอกจากนี้ เรายังมีการวัดผลเชิงกำหนด เช่น สถิติของคอมไพเลอร์ที่ช่วยให้เราเข้าใจสิ่งที่เกิดขึ้นเบื้องหลัง
เนื่องจากทรัพยากรที่เราต้องเสียไปเพื่อการปรับปรุงเหล่านี้คือเวลาในการพัฒนา เราจึงต้องการทำซ้ำให้เร็วที่สุดเท่าที่จะทำได้ ซึ่งหมายความว่าเราได้เลือกแอปตัวแทนจำนวนหนึ่ง (ซึ่งประกอบด้วยแอปของบุคคลที่หนึ่ง แอปของบุคคลที่สาม และระบบปฏิบัติการ Android เอง) เพื่อสร้างต้นแบบโซลูชัน ต่อมา เราได้ยืนยันว่าการใช้งานขั้นสุดท้ายนั้นคุ้มค่าด้วยการทดสอบทั้งแบบแมนนวลและแบบอัตโนมัติในวงกว้าง
เมื่อได้ APK ที่คัดสรรมาแล้ว เราจะทริกเกอร์การคอมไพล์ด้วยตนเองในเครื่อง รับโปรไฟล์ของการคอมไพล์ และใช้ pprof เพื่อแสดงภาพว่าเราใช้เวลาไปกับส่วนใด
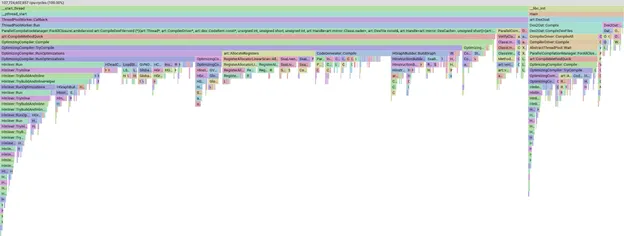
ตัวอย่างกราฟ Flame ของโปรไฟล์ใน pprof
เครื่องมือ pprof มีประสิทธิภาพมากและช่วยให้เราแบ่งส่วน กรอง และจัดเรียงข้อมูลเพื่อดูได้ เช่น ระยะหรือวิธีการของคอมไพเลอร์ที่ใช้เวลามากที่สุด เราจะไม่ลงรายละเอียดเกี่ยวกับ pprof เอง เพียงแค่ทราบว่าหากแถบมีขนาดใหญ่ขึ้น แสดงว่าใช้เวลาในการคอมไพล์นานขึ้น
มุมมองหนึ่งคือมุมมอง "จากล่างขึ้นบน" ซึ่งคุณจะเห็นว่าเมธอดใดใช้เวลามากที่สุด ในรูปภาพด้านล่าง เราจะเห็นเมธอดที่ชื่อว่า Kill ซึ่งใช้เวลาคอมไพล์มากกว่า 1% นอกจากนี้ เราจะพูดถึงวิธีการยอดนิยมอื่นๆ ในช่วงท้ายของบล็อกโพสต์ด้วย
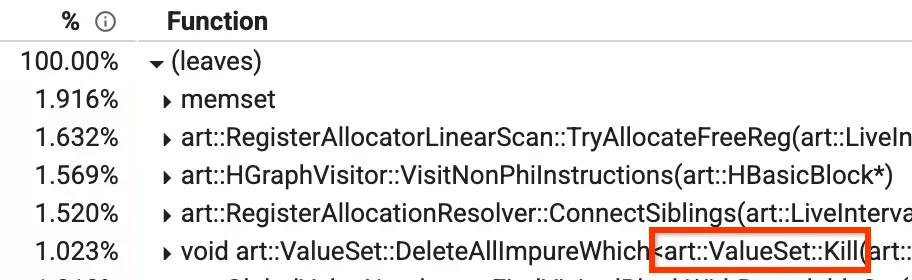
มุมมองด้านล่างของโปรไฟล์
ในคอมไพเลอร์เพิ่มประสิทธิภาพของเรา มีเฟสที่เรียกว่า Global Value Numbering (GVN) คุณไม่ต้องกังวลเกี่ยวกับสิ่งที่ทำโดยรวม แต่ส่วนที่เกี่ยวข้องคือการรู้ว่ามีเมธอดที่เรียกว่า `Kill` ซึ่งจะลบโหนดบางโหนดตามตัวกรอง ซึ่งจะใช้เวลานานเนื่องจากต้องทำซ้ำผ่านโหนดทั้งหมดและตรวจสอบทีละโหนด เราพบว่ามีบางกรณีที่เราทราบล่วงหน้าว่าการตรวจสอบจะเป็นเท็จ ไม่ว่าโหนดที่เรามีจะทำงานอยู่ ณ จุดนั้นหรือไม่ก็ตาม ในกรณีเช่นนี้ เราสามารถข้ามการทำซ้ำทั้งหมด ซึ่งจะลดจาก 1.023% เหลือประมาณ 0.3% และปรับปรุงรันไทม์ของ GVN ได้ประมาณ 15%
การเพิ่มประสิทธิภาพที่คุ้มค่า
เราได้พูดถึงวิธีวัดและวิธีตรวจจับว่าใช้เวลาไปกับอะไรบ้าง แต่นี่เป็นเพียงจุดเริ่มต้นเท่านั้น ขั้นตอนถัดไปคือวิธีเพิ่มประสิทธิภาพเวลาที่ใช้ในการคอมไพล์
โดยปกติแล้ว ในกรณีอย่างเช่น "Kill" ข้างต้น เราจะดูวิธีทำซ้ำผ่านโหนดและทำให้เร็วขึ้น เช่น ทำสิ่งต่างๆ พร้อมกันหรือปรับปรุงอัลกอริทึมเอง อันที่จริงแล้ว นั่นคือสิ่งที่เราพยายามทำในตอนแรก และเมื่อไม่พบสิ่งใดที่ทำได้ เราก็มีช่วงเวลา "เดี๋ยวก่อน…" และเห็นว่าวิธีแก้ปัญหาคือ (ในบางกรณี) ไม่ต้องทำซ้ำเลย เมื่อทำการเพิ่มประสิทธิภาพประเภทนี้ คุณอาจมองข้ามภาพรวมไปได้ง่ายๆ
ในกรณีอื่นๆ เราใช้เทคนิคที่แตกต่างกันหลายอย่าง ได้แก่
- ใช้การวิเคราะห์พฤติกรรมเพื่อตัดสินว่าการเพิ่มประสิทธิภาพจะไม่ให้ผลลัพธ์ที่คุ้มค่าหรือไม่ จึงข้ามได้
- การใช้โครงสร้างข้อมูลเพิ่มเติมเพื่อแคชข้อมูลที่คำนวณแล้ว
- การเปลี่ยนโครงสร้างข้อมูลปัจจุบันเพื่อเพิ่มความเร็ว
- การคำนวณผลลัพธ์แบบ Lazy เพื่อหลีกเลี่ยงวงจรในบางกรณี
- ใช้การแยกส่วนที่เหมาะสม - ฟีเจอร์ที่ไม่จำเป็นอาจทำให้โค้ดทำงานช้าลง
- หลีกเลี่ยงการไล่ตามตัวชี้ที่ใช้บ่อยผ่านการโหลดหลายครั้ง
เราจะทราบได้อย่างไรว่าการเพิ่มประสิทธิภาพนั้นคุ้มค่าที่จะดำเนินการต่อหรือไม่
ข้อดีคือคุณไม่ต้องทำอะไรเลย หลังจากตรวจพบว่าส่วนใดส่วนหนึ่งใช้เวลาคอมไพล์นานมาก และหลังจากทุ่มเทเวลาในการพัฒนาเพื่อพยายามปรับปรุงแล้ว บางครั้งคุณก็อาจไม่พบวิธีแก้ปัญหา อาจไม่มีอะไรให้ทำ ใช้เวลานานเกินไปในการนำไปใช้ จะทำให้เมตริกอื่นถดถอยลงอย่างมาก เพิ่มความซับซ้อนของฐานของโค้ด ฯลฯ สำหรับการเพิ่มประสิทธิภาพที่ประสบความสำเร็จทุกครั้งที่คุณเห็นในบล็อกโพสต์นี้ โปรดทราบว่ายังมีอีกนับไม่ถ้วนที่ไม่ประสบความสำเร็จ
หากคุณอยู่ในสถานการณ์ที่คล้ายกัน ให้ลองประเมินว่าคุณจะปรับปรุงเมตริกได้มากเพียงใดโดยทำงานให้น้อยที่สุดเท่าที่จะทำได้ ซึ่งหมายความว่าตามลำดับดังนี้
- การประมาณด้วยเมตริกที่คุณรวบรวมไว้แล้ว หรือแค่ใช้สัญชาตญาณ
- การประมาณด้วยต้นแบบที่สร้างขึ้นอย่างรวดเร็วและไม่สมบูรณ์
- ใช้โซลูชัน
อย่าลืมพิจารณาประเมินข้อเสียของโซลูชันด้วย เช่น หากคุณจะใช้โครงสร้างข้อมูลเพิ่มเติม คุณยินดีที่จะใช้หน่วยความจำมากน้อยเพียงใด
ทำความเข้าใจเชิงลึกยิ่งขึ้น
มาดูการเปลี่ยนแปลงบางอย่างที่เราได้ดำเนินการกันเลย
เราได้เปลี่ยนแปลงเพื่อเพิ่มประสิทธิภาพเมธอดที่ชื่อ FindReferenceInfoOf เมธอดนี้ทำการค้นหาเวกเตอร์เชิงเส้นเพื่อค้นหารายการ เราได้อัปเดตโครงสร้างข้อมูลดังกล่าวให้จัดทำดัชนีตามรหัสของคำสั่ง เพื่อให้ FindReferenceInfoOf เป็น O(1) แทนที่จะเป็น O(n) นอกจากนี้ เรายังจัดสรรเวกเตอร์ไว้ล่วงหน้าเพื่อหลีกเลี่ยงการปรับขนาด เราเพิ่มหน่วยความจำเล็กน้อยเนื่องจากต้องเพิ่มฟิลด์พิเศษที่นับจำนวนรายการที่เราแทรกลงในเวกเตอร์ แต่ก็เป็นการแลกเปลี่ยนเล็กน้อยเนื่องจากหน่วยความจำสูงสุดไม่ได้เพิ่มขึ้น ซึ่งช่วยเร่งระยะ LoadStoreAnalysis ได้ 34-66% ซึ่งจะช่วยปรับปรุงเวลาคอมไพล์ได้ประมาณ 0.5-1.8%
เรามีการใช้งาน HashSet ที่กำหนดเองซึ่งเราใช้ในหลายๆ ที่ การสร้างโครงสร้างข้อมูลนี้ใช้เวลานานมาก และเราพบสาเหตุแล้ว เมื่อหลายปีก่อน โครงสร้างข้อมูลนี้ใช้ในไม่กี่แห่งที่ใช้ HashSet ขนาดใหญ่มาก และได้รับการปรับแต่งให้เหมาะสมกับโครงสร้างดังกล่าว อย่างไรก็ตาม ปัจจุบันมีการใช้ในทิศทางตรงกันข้ามโดยมีรายการเพียงไม่กี่รายการและมีอายุการใช้งานสั้น ซึ่งหมายความว่าเราเสียรอบการทำงานไปกับการสร้าง HashSet ขนาดใหญ่นี้ แต่เราใช้ HashSet ดังกล่าวเพียงไม่กี่รายการก่อนที่จะทิ้งไป การเปลี่ยนแปลงนี้ช่วยให้เราปรับปรุงเวลาคอมไพล์ได้ประมาณ 1.3-2% นอกจากนี้ การใช้งานหน่วยความจำยังลดลงประมาณ 0.5-1% เนื่องจากเราไม่ได้ใช้โครงสร้างข้อมูลขนาดใหญ่เหมือนเมื่อก่อน
เราปรับปรุงเวลาคอมไพล์ได้ประมาณ 0.5-1% โดยส่งโครงสร้างข้อมูลตามการอ้างอิงไปยัง Lambda เพื่อหลีกเลี่ยงการคัดลอกไปมา ซึ่งเป็นสิ่งที่เราพลาดไปในการตรวจสอบครั้งแรกและอยู่ในฐานของโค้ดมานานหลายปี การดูโปรไฟล์ใน pprof ทำให้เราสังเกตเห็นว่าเมธอดเหล่านี้สร้างและทำลายโครงสร้างข้อมูลจำนวนมาก ซึ่งทำให้เราต้องตรวจสอบและเพิ่มประสิทธิภาพ
เราเร่งความเร็วของระยะที่เขียนเอาต์พุตที่คอมไพล์แล้วโดยแคชค่าที่คำนวณแล้ว ซึ่งช่วยปรับปรุงเวลาคอมไพล์ทั้งหมดได้ประมาณ 1.3-2.8% น่าเสียดายที่การทำบัญชีเพิ่มเติมนั้นมากเกินไป และการทดสอบอัตโนมัติของเราได้แจ้งเตือนเราเกี่ยวกับการถดถอยของหน่วยความจำ ต่อมา เราได้ตรวจสอบโค้ดเดียวกันอีกครั้งและใช้เวอร์ชันใหม่ ซึ่งไม่เพียงแต่จัดการกับการถดถอยของหน่วยความจำเท่านั้น แต่ยังปรับปรุงเวลาคอมไพล์ได้อีกประมาณ 0.5-1.8% ด้วย ในการเปลี่ยนแปลงครั้งที่ 2 นี้ เราต้องเปลี่ยนโครงสร้างภายในโค้ดและปรับเปลี่ยนวิธีการทำงานของระยะนี้ เพื่อกำจัดโครงสร้างข้อมูล 1 ใน 2 รายการออก
เรามีขั้นตอนในคอมไพเลอร์เพิ่มประสิทธิภาพซึ่งจะแทรกการเรียกใช้ฟังก์ชันในบรรทัดเพื่อให้ได้ประสิทธิภาพที่ดีขึ้น ในการเลือกเมธอดที่จะแทรกในบรรทัด เราจะใช้ทั้งการวิเคราะห์พฤติกรรมก่อนทำการคำนวณ และการตรวจสอบขั้นสุดท้ายหลังจากทำงานเสร็จ แต่ก่อนที่เราจะสรุปการแทรกในบรรทัด หากการตรวจสอบใดๆ พบว่าการแทรกในบรรทัดไม่คุ้มค่า (เช่น มีการเพิ่มวิธีการใหม่มากเกินไป) เราจะไม่แทรกการเรียกใช้เมธอดในบรรทัด
เราได้ย้ายการตรวจสอบ 2 รายการจากหมวดหมู่ "การตรวจสอบขั้นสุดท้าย" ไปยังหมวดหมู่ "การเรียนรู้จากประสบการณ์" เพื่อประเมินว่าการแทรกในบรรทัดจะสำเร็จหรือไม่ก่อนที่จะทำการคำนวณที่ใช้เวลานาน เนื่องจากนี่เป็นค่าประมาณจึงอาจไม่สมบูรณ์แบบ แต่เราได้ยืนยันแล้วว่าการวิเคราะห์พฤติกรรมใหม่ของเราครอบคลุม 99.9% ของสิ่งที่แทรกในบรรทัดก่อนหน้านี้โดยไม่ส่งผลต่อประสิทธิภาพ หนึ่งในวิธีการเรียนรู้ใหม่เหล่านี้เกี่ยวกับรีจิสเตอร์ DEX ที่จำเป็น (ปรับปรุงประมาณ 0.2-1.3%) และอีกวิธีหนึ่งเกี่ยวกับจำนวนคำสั่ง (ปรับปรุงประมาณ 2%)
เรามีการใช้งาน BitVector ที่กำหนดเองซึ่งเราใช้ในหลายๆ ที่ เราได้แทนที่คลาส BitVector ที่ปรับขนาดได้ด้วย BitVectorView ที่เรียบง่ายกว่าสำหรับเวกเตอร์บิตขนาดคงที่บางรายการ ซึ่งจะช่วยลดการอ้างอิงทางอ้อมและการตรวจสอบช่วงรันไทม์บางอย่าง รวมถึงเพิ่มความเร็วในการสร้างออบเจ็กต์เวกเตอร์บิต
นอกจากนี้ คลาส BitVectorView ยังได้รับการกำหนดเทมเพลตในประเภทพื้นที่เก็บข้อมูลที่สำคัญ (แทนที่จะใช้ uint32_t เป็น BitVector เดิมเสมอ) ซึ่งช่วยให้การดำเนินการบางอย่าง เช่น Union() ประมวลผลบิตพร้อมกันได้มากขึ้น 2 เท่าในแพลตฟอร์ม 64 บิต ตัวอย่างของฟังก์ชันที่ได้รับผลกระทบลดลงมากกว่า 1% โดยรวมเมื่อคอมไพล์ระบบปฏิบัติการ Android ซึ่งดำเนินการผ่านการเปลี่ยนแปลงหลายรายการ [1, 2, 3, 4, 5, 6]
หากเราพูดถึงรายละเอียดเกี่ยวกับการเพิ่มประสิทธิภาพทั้งหมด เราคงต้องใช้เวลาทั้งวัน หากสนใจการเพิ่มประสิทธิภาพอื่นๆ โปรดดูการเปลี่ยนแปลงอื่นๆ ที่เราดำเนินการดังนี้
- เพิ่มการทำบัญชีเพื่อปรับปรุงเวลาคอมไพล์ประมาณ 0.6-1.6%
- คำนวณข้อมูลแบบ Lazy เพื่อหลีกเลี่ยงวงจร หากเป็นไปได้
- เปลี่ยนโครงสร้างภายในโค้ดเพื่อข้ามการคำนวณล่วงหน้าเมื่อไม่ได้ใช้งาน
- หลีกเลี่ยงเชนการโหลดที่ขึ้นต่อกันเมื่อสามารถรับ Allocator จากที่อื่นได้โดยง่าย
- อีกกรณีหนึ่งของการเพิ่มการตรวจสอบเพื่อหลีกเลี่ยงการทำงานที่ไม่จำเป็น
- หลีกเลี่ยงการแยกสาขาบ่อยๆ ในประเภทรีจิสเตอร์ (Core/FP) ในตัวจัดสรรรีจิสเตอร์
- ตรวจสอบว่ามีการเริ่มต้นอาร์เรย์บางรายการในเวลาคอมไพล์ อย่าพึ่งพา clang ในการดำเนินการนี้
- ล้างลูปบางรายการ ใช้ลูปช่วงที่ Clang สามารถเพิ่มประสิทธิภาพได้ดีกว่าเนื่องจากไม่จำเป็นต้องโหลดพอยเตอร์ภายในของคอนเทนเนอร์ซ้ำเนื่องจากผลข้างเคียงของลูป หลีกเลี่ยงการเรียกใช้ฟังก์ชันเสมือน `HInstruction::GetInputRecords()` ในลูปผ่าน `InputAt(.)` ที่ฝังในบรรทัดสำหรับอินพุตแต่ละรายการ
- หลีกเลี่ยงฟังก์ชัน Accept() สำหรับรูปแบบผู้เข้าชมโดยใช้ประโยชน์จากการเพิ่มประสิทธิภาพคอมไพเลอร์
บทสรุป
ความทุ่มเทของเราในการปรับปรุงความเร็วเวลาคอมไพล์ของ ART ส่งผลให้เกิดการปรับปรุงที่สำคัญ ซึ่งทำให้ Android ทำงานได้ราบรื่นและมีประสิทธิภาพมากขึ้น ทั้งยังช่วยยืดอายุการใช้งานแบตเตอรี่และลดอุณหภูมิของอุปกรณ์ด้วย การระบุและใช้การเพิ่มประสิทธิภาพอย่างขยันขันแข็งแสดงให้เห็นว่าเราสามารถเพิ่มเวลาคอมไพล์ได้อย่างมากโดยไม่ส่งผลกระทบต่อการใช้งานหน่วยความจำหรือคุณภาพของโค้ด
การเดินทางของเราเกี่ยวข้องกับการทำโปรไฟล์ด้วยเครื่องมืออย่าง pprof, ความเต็มใจที่จะทำซ้ำ และบางครั้งก็ละทิ้งแนวทางที่ได้ผลน้อยกว่า ความพยายามร่วมกันของทีม ART ไม่เพียงแต่ลดเวลาคอมไพล์ลงได้เป็นเปอร์เซ็นต์ที่น่าทึ่ง แต่ยังวางรากฐานสำหรับความก้าวหน้าในอนาคตด้วย
การปรับปรุงทั้งหมดนี้พร้อมใช้งานในการอัปเดต Android ช่วงสิ้นปี 2025 และสำหรับ Android 12 ขึ้นไปผ่านการอัปเดต Mainline เราหวังว่าข้อมูลเจาะลึกเกี่ยวกับกระบวนการเพิ่มประสิทธิภาพนี้จะให้ข้อมูลเชิงลึกที่มีคุณค่าเกี่ยวกับความซับซ้อนและรางวัลของวิศวกรรมคอมไพเลอร์
-
 ข่าวสารเกี่ยวกับผลิตภัณฑ์
ดูวิธีที่เครื่องมือขยายช่องทางของ Google Play ใน Play Console ช่วยเพิ่มการเข้าถึงผู้ซื้อใน Store, เว็บ และแพลตฟอร์มภายนอก พร้อมทั้งปกป้องมาร์จิน
Phalene Gowling, Rejane França • ใช้เวลาอ่าน 4 นาที -
 ข่าวสารเกี่ยวกับผลิตภัณฑ์
Unity ขับเคลื่อนเกมบนอุปกรณ์เคลื่อนที่มากกว่าครึ่งหนึ่งทั่วโลก ดังนั้นความประทับใจแรกจึงเป็นสิ่งสำคัญ สำหรับนักพัฒนาเกม ประสบการณ์การเตรียมความพร้อมผู้ใช้งานใหม่ที่ราบรื่นและเชื่อถือได้เป็นสิ่งสำคัญในการกระตุ้นการคงผู้ใช้ไว้ตั้งแต่วันแรกและความผูกพันในระยะยาว
Michelle Martin • ใช้เวลาอ่าน 1 นาที -
 ข่าวสารเกี่ยวกับผลิตภัณฑ์
ตั้งแต่การดื่มด่ำอย่างเต็มรูปแบบที่บ้านไปจนถึงประสบการณ์ที่เข้าถึงได้ง่ายในระหว่างเดินทาง การสร้างแอปบน Android XR ช่วยให้คุณเข้าถึงผู้ใช้ได้ทุกที่ทุกเวลาในแอปพลิเคชันเชิงพื้นที่ทุกประเภท ที่งาน Android Developer Summit เราได้ประกาศความสำเร็จที่น่าตื่นเต้นด้วยการเปิดตัว XREAL AURA
Amy Zeppenfeld, Vinny DaSilva • ใช้เวลาอ่าน 3 นาที
รับข้อมูลเชิงลึกล่าสุดเกี่ยวกับการพัฒนา Android ที่ส่งไปยังกล่องจดหมายของคุณทุกสัปดาห์