איך R8 שיפר את המהירות של שגרות המשך (coroutines) ב-Kotlin ב-Android פי 2
משך הקריאה: 7 דקות
החל מ-AGP 9.2.0, R8 מבצע אופטימיזציה לרוב הקריאות של Atomic*FieldUpdater לגרסאות Unsafe שמניבות ביצועים טובים יותר פי 2 עד פי 4 בפעולות נפוצות. השינוי הזה משפיע במיוחד על הספרייה kotlinx.atomicfu שמטמיעה פעולות אטומיות עבור kotlinx.coroutines, וכך מאפשר להפעיל ולבטל קורוטינות עד פי 2 יותר מהר. כדי ליהנות מההטבות, צריך לעדכן את AGP לגרסה 9.2.0 ואילך.
רוב האפליקציות ל-Android משתמשות ב-Kotlin כשפה העיקרית שלהן, ולכן kotlinx.coroutines הפכה לסטנדרט בפועל לתכנות אסינכרוני. הספרייה מציעה דרך מובנית ב-Kotlin לניהול זרימות מקבילות, שהיא מעוצבת ומובנית היטב. גם Jetpack Compose לא יוצא מן הכלל, והוא משתמש בקורוטינות לניהול אירועי הצבעה, אנימציות ואינטראקציות אחרות. בזמן כתיבת המאמר הזה, רוב ממשקי ה-API המקבילים ב-Compose קוראים לפונקציות suspend מתחת לפני השטח, ומפעילים או מבטלים קורוטינות כדי לטפל בעדכונים.
כשהצוות של Compose התחיל לבדוק את הביצועים, הוא גילה שקורוטינות הן צוואר בקבוק עבור הרבה פעולות שמתבצעות מחוץ לקומפוזיציה. לדוגמה, 80% מהזמן שהושקע ביצירה ובעדכון של Modifier.clickable נוצל להפעלת קורוטינות פנימיות ולביטול שלהן, שטיפלו בעדכונים של InteractionSource. על סמך התצפיות האלה, רוב העבודה על שיפור הביצועים בשלב מוקדם התמקדה בהסרת קורוטינות מנתיב ברירת המחדל ובהשהיית האתחול עד שנדרש.
העלות של שגרת המשך (coroutine)
הדרך הקלה ביותר לנתח את ההתנהגות הפנימית של פונקציה ב-Android היא ללכוד מעקב אחר שיטת Android Runtime (ART). תיעוד method ב-ART הוא כלי שמתעד את זרימת ההרצה של אפליקציה, ומראה בדיוק אילו שיטות מופעלות, מה הסדר שלהן וכמה זמן מושקע בכל אחת מהן. כך המפתחים יכולים לזהות צווארי בקבוק בביצועים. אם LaunchedEffect { } ריק, הוא ייראה בערך כך:
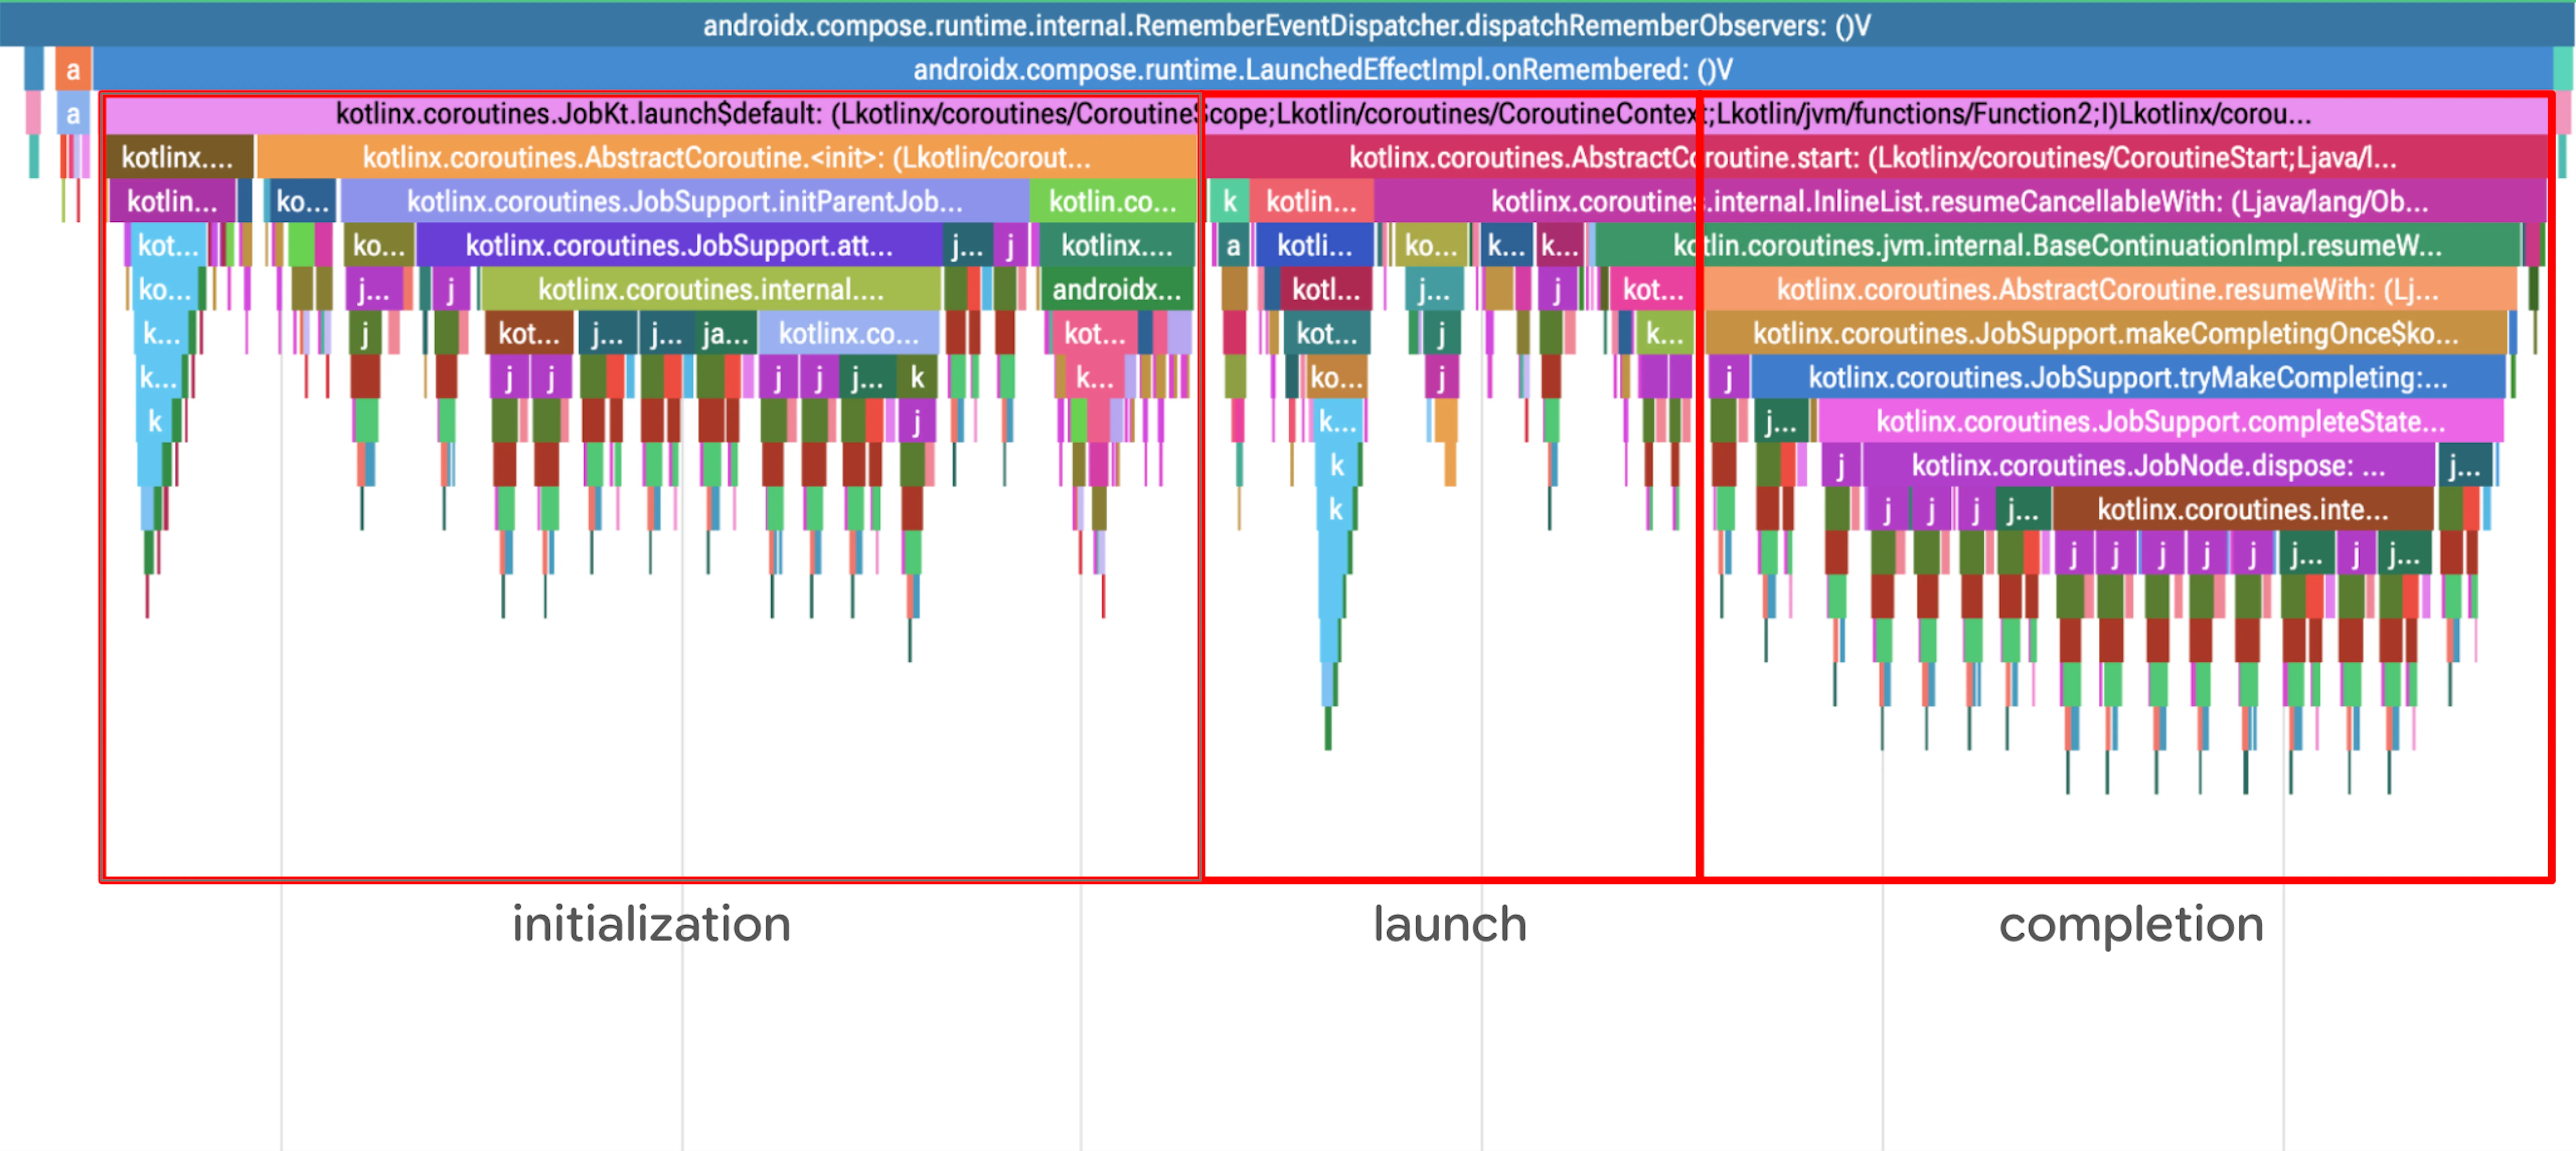
אפשר לחלק את מעקב השיטה שלמעלה לשלושה חלקים:
- הפעלה של שגרת המשך (coroutine) חדשה
- הפעלת קורוטינה
- השלמת קורוטינה (כי היא יוצאת מיד)
ביטול LaunchedEffect דומה להשלמה רגילה, אבל הוא גם יוצר CancellationException.
בפרופיל שלמעלה, דבר אחד שמעורר חשד באופן מיידי הוא שיחות תכופות אל java.util.concurrent.AtomicReferenceFieldUpdater (תיבות סגולות או ירוקות עם תוויות j…). כל קריאה היא יחסית מהירה, אבל התדירות שלה מדאיגה. כל תקורה משמעותית שמתפרסת על פני כמה הפעלות יכולה להצטבר לרגרסיה מורגשת. אם מתמקדים בשיחה, אפשר לראות שרוב הזמן מוקדש ל... בדיקות של השתקפויות?
קורוטינות מטמיעות מבנה עץ ללא נעילה לקשרים של הורה/צאצא, שמאפשר במקביל ריבוי משימות מובנה. מסתבר שבספרייה kotlinx.atomicfu מיושמות פעולות אטומיות ללא נעילה באמצעות פרימיטיב JVM מוכר, AtomicReferenceFieldUpdater. הכלי לעדכון משתמש בהפניה למחלקה ובשם שדה כדי לבצע פעולות אטומיות בזמן הריצה, והוא צריך להריץ כמה בדיקות בטיחות רפלקטיביות כדי לוודא שהשדה קיים ושיש אליו גישה. כל פעולה ב-coroutines (התחלה, השהיה, ביטול, השלמה) קוראת לפחות פעולה אטומית אחת, ולכן אם היא איטית, הביצועים של ה-coroutines לא יהיו טובים.
בדיקת AtomicReferenceFieldUpdater
אבל בואו לא נקדים את המאוחר. AtomicReferenceFieldUpdater עבר אופטימיזציה טובה ב-JVM במשך יותר מ-10 שנים, ועקבות של שיטות עשויות לתעד תקורה שמוסרת לחלוטין על ידי אופטימיזציה ברמת המכונה הווירטואלית: קימפולים של just-in-time (JIT) או ahead-of-time (AOT). כדי לבדוק את הביצועים, נכתוב כמה מדדים להשוואה כדי למדוד את ההבדל בין הפניות אטומיות מ-kotlinx.atomicfu לבין java.util.concurrent.atomic.
@RunWith(AndroidJUnit4::class)
class AtomicReferenceBenchmark {
    @get:Rule
    val benchmarkRule = BenchmarkRule()

    private val atomicReference = java.util.concurrent.atomic.AtomicReference(false)
    private val atomicRef = kotlinx.atomicfu.atomic<Boolean>(false)

    @Test
    fun atomicReference_compareAndSet() {
        benchmarkRule.measureRepeated {
            atomicReference.compareAndSet(true, false)
            atomicReference.compareAndSet(false, true)
        }
    }

     @Test
    fun atomicRef_compareAndSet() {
        benchmarkRule.measureRepeated {
            atomicRef.compareAndSet(true, false)
            atomicRef.compareAndSet(false, true)
        }
    }

    /* measuring other methods from the method traces above */
}
הפעלת מדד הביצועים הזה ב-Pixel 5 (תוך הקפדה על הידור JIT של AtomicReferenceFieldUpdater#compareAndSet במהלך החימום) מניבה את התוצאות הבאות ב-Pixel 5 (API 33):
 50.7 ns  atomicReference_compareAndSet
135   ns  atomicRef_compareAndSet
הנתונים מאשרים את הפער, kotlinx.atomicfu כשהגרסה איטית בערך פי 2.7. הבדיקה הזו מאשרת ש-ART לא מבצע אופטימיזציה נסתרת, ובדיקות גישה רפלקטיביות מוסיפות תקורה אמיתית במהלך זמן הריצה.
אם נסתכל שוב על מעקב השיטה המקורית, נראה שהעבודה המשמעותית היחידה שמתבצעת על ידי AtomicReferenceFieldUpdater היא הקריאה הפנימית אל Unsafe.getObjectVolatile שמבצעת בפועל את הפעולה האטומית הבסיסית. ברוב המקרים, מאתחל העדכון הוא סטטי, ואפשר להוכיח שהוא תמיד נכון על סמך המבנה של המחלקה שמסביב. לכן, אפשר לנתח באופן סטטי את רוב השימושים ב-AtomicReferenceFieldUpdater ולהחליף אותם בווריאציה פנימית של Unsafe במהלך הקומפילציה. במקרה, ל-Android build toolchain יש מהדר אופטימיזציה משלו שיכול לעשות בדיוק את זה.
אופטימיזציה באמצעות R8
מחלקות Atomic*FieldUpdater תומכות בשימוש מתוחכם, דינמי ומבוסס-השתקפות, אבל לרוב הן משמשות בתבניות ברורות סטטיות. ההסבר הזה מתייחס גם לביצועים הבסיסיים הנמוכים וגם לצורך באופטימיזציה. R8 הוא קומפיילר אופטימיזציה של תוכנה מלאה, והוא מתאים לזיהוי דפוסים פשוטים יותר כדי להפחית את התקורה של בדיקות בטיחות רפלקטיביות. R8 מקבל bytecode של JVM אחרי קומפיילר Java או Kotlin, אבל כדי להקל על הקריאה, הדוגמאות האלה מוצגות בתחביר של Java. לכן אין ארגומנטים של סוגים בפונקציה AtomicReferenceFieldUpdater.
class Example {
    volatile String data = "";
    static final AtomicReferenceFieldUpdater updater =
        AtomicReferenceFieldUpdater.newUpdater(Example.class, String.class, "data");

    void example() {
        // ...
        updater.compareAndSet(this, "", "new");
        // ...
    }
}
בדוגמה הבסיסית נוצר מעדכן סטטי סופי שמקבל גישה לשדה תנודתי עם ארגומנטים קבועים פשוטים עבור המחזיק, הסוג והשם של השדה. ההשתקפות שבה נעשה שימוש שקופה לחלוטין. ברור שהעדכון הזה מפנה לשדה תקין, ולאתר שבו נוצר העדכון יש גישה תקינה לשדה.
במהות שלה, Atomic*FieldUpdater היא עטיפה מסביב להיסט של שדה ולקריאות אל Unsafe. התרחיש הכי טוב לאופטימיזציה הוא להחליף את שדה העדכון בשדה היסט ולהחליף את הקריאות לעדכון בקריאות ל-Unsafe.
אופטימיזציה של Atomic*FieldUpdater
האופטימיזציה מיושמת בשלושה חלקים: הטמעה, החלפה וניקוי.
אינסטרומנטציה
השלב הראשון הוא להוסיף שדות של היסט לצד שדה העדכון כדי לאפשר גישה ישירה דרך Unsafe הקריאה.
static final long updater$offset =
    SyntheticUnsafe.UNSAFE.objectFieldOffset(Example.class.getDeclaredField("data"))
הגישה לשדה מתבצעת באמצעות רפלקציה, והפונקציה Unsafe משמשת לחילוץ ההיסט של השדה במחלקה. הקוד הזה מייצג את הפנימיות של Atomic*FieldUpdater אם מתעלמים מאימות ההשתקפות. במקום זאת, סוג המחזיק של הפונקציה לעדכון וסוג השדה של השדה הדינמי מתועדים באופן סטטי בקומפיילר.
שימו לב שהשדה המקורי וההגדרה שלו נשארים כמו שהם. תהליך האופטימיזציה מאפשר שימוש אופטימלי בשדה, ואחר כך מנקה אותו. זוהי גישה פשוטה להטמעה, אבל היא מאפשרת גם אופטימיזציה חלקית של שדות העדכון, שבה חלק מהשימושים נשארים כמו שהם ואחרים עוברים אופטימיזציה.
החלפה
בשלב הזה של הקומפיילר, אחרי נקודת הצטרפות מתאימה של בו-זמניות, יש לנו רשימה של שדות מעדכנים עם אינסטרומנטציה. כלומר, אנחנו יכולים לבצע אופטימיזציה לכל אתר שמוגדר כאתר שניתן להתקשר אליו בנפרד, על סמך כמה תנאים. דוגמה לשיחה:
updater.compareAndSet(holder, expectedValue, newValue);
התנאים שנדרשים על ידי Atomic*FieldUpdater הם:
- האם
updaterמגיע משדה עם כלי מדידה? כלומר, האם ניתוח סטטי יכול לעקוב אחרי הערך של האובייקט עד לקריאת שדה של כלי לעדכון עם מכשור? - האם
holderהוא מאותו סוג או מסוג משנה של סוג המחזיק שהוגדר במקור? - האם
newValueהוא אותה מחלקה או מחלקת משנה של סוג השדה שהוגדר במקור?
אם כל התנאים מתקיימים, השיחה מוחלפת בשיחה אל Unsafe בלי בדיקות ההשתקפות.
SyntheticUnsafe.UNSAFE.compareAndSwapObject(holder, Example.updater$offset, expectedValue, newValue)
הקריאה החדשה מהירה ופשוטה יותר, אבל היא שונה מהקריאה המקורית מבחינת הטיפול שלה בערכי null ב-updater וב-holder. אלא אם נשללה האפשרות באופן סטטי, בדיקות של ערכי null מוכנסות לשניהם.
ניקוי תלונות
בשלב הזה, למחלקת ההמתנה יש את שדה העדכון המקורי ואת שדה ההיסט החדש, לצד אתרי קריאה שעשויים להשתמש באחד משני השדות. אם אף אחד מהאתרים שבהם מתבצעת השיחה לא עבר אופטימיזציה, צריך להסיר את שדה ההיסט. אם כל האתרים שבהם מתבצעת השיחה עברו אופטימיזציה, צריך להסיר את שדה העדכון. בשני המקרים, צריך למחוק גם את קריאת האתחול. המחיקה של שדות שלא נמצאים בשימוש וההסרה של קוד לא פעיל כבר מתבצעות בקומפיילר, אבל כדי להסיר את קוד האתחול כאן צריך להשתמש בעוד כמה טריקים.
יכול להיות שגם לקריאה ל-newUpdater וגם ל-getDeclaredField יהיו תופעות לוואי, כי הן יכולות להחזיר חריגים (וגם ההטמעה שלהן לא ידועה כי היא תלויה בגרסת ה-API). כלומר, אי אפשר להסיר אותם בבטחה באמצעות אופטימיזציה כללית. לכן, כדי לבצע את הניקוי הזה, היה צריך להתייחס במפורש לשדות עם המיכשור, כי ידוע שהם לא מכילים חריגים.
בסופו של דבר, הדוגמה הפשוטה של כלי העדכון שמוצגת למעלה נראית כך אחרי האופטימיזציה:
תוצאות
אחרי האופטימיזציות האלה, kotlinx.atomicfu ורוב השימושים המפורשים ב-AtomicInt/Long/ReferenceFieldUpdater תואמים עכשיו לביצועים של AtomicReference עם R8. למעשה, הוא אפילו מהיר יותר בחלק מהבדיקות. ל-kotlinx.atomicfu יש תוסף קומפיילר שיכול להוסיף מקרים של atomic לשדות, וכך לצמצם את ההקצאות שנדרשות ליצירת שדה שעובר עדכון אטומי.
הטכנולוגיה שהכי נהנתה מהעבודה הזו היא Jetpack Compose. ל-Compose runtime יש מספר מיקרו-בנצ'מרקים שעוקבים אחרי הביצועים של קורוטינות באופן מדויק מאוד, כדי לזהות רגרסיות בביצועים בשלב מוקדם. כשעדכנו את המדדים לגרסה חדשה של R8, שמנו לב לשיפור של פי 2 בהפעלה וביטול של קורוטינות ב-LaunchedEffect!
בנוסף, צוות ART מיישם את האופטימיזציות האלה באופן מקורי ברמת המכונה הווירטואלית. אם האפליקציה שלך מטרגטת API 36 ופועלת בגרסה עדכנית של Android, יכול להיות שהמכשיר שלך כבר מבצע אופטימיזציה של קורוטינות בצורה דומה. במדדי הביצועים של שגרות המשך (coroutine) שצוינו למעלה נרשם שיפור של כ-15% בביצועים אחרי עדכוני JIT בגרסאות האחרונות של ART.
האופטימיזציה הזו תופעל באפליקציה שלכם כברירת מחדל אם תשדרגו ל-AGP 9.2.0 או אם תשתמשו ישירות ב-R8 9.2.0. מידע נוסף זמין במאמר בנושא D8 dexer ו-R8 shrinker.
-
 מקרים לדוגמה
ירידות בביצועים קשות מאוד לשחזור, ולכן הן מהוות צוואר בקבוק משמעותי למפתחים של אפליקציות לנייד.
Alice Yuan, Arti Arutiunov, Nikita Ogorodnikov • משך הקריאה: 4 דקות -

 מקרים לדוגמה
לאחרונה, אפליקציית FotMob חוותה את העלייה הגדולה ביותר שלה ביום אחד ב-Wear OS בקרב הקהל שהתקין אותה ב-5 השנים האחרונות, פי 2-3 מהממוצע היומי. הסוד? תהליך התקנה פשוט בין מכשירים שעוזר למשתמשים לגלות את האפליקציה שלהם ל-Wear OS ישירות מהטלפון.
Garan Jenkin • משך הקריאה: 3 דקות -


 מקרים לדוגמה
אפליקציית המיינדפולנס Gratitude מעודדת עקביות באמצעות יומן יומי קצר, הצהרות חיוביות ולוחות חזון. האפליקציה הורדה יותר מ-6 מיליון פעמים, קיבלה 150 אלף דירוגים של 5 כוכבים ונרשמו בה 100 מיליון רשומות ביומן.
Amrit Sanjeev, Ash Nohe • משך הקריאה: 3 דקות
רוצים לקבל טיפים עדכניים לפיתוח Android ישירות לאימייל כל שבוע?