Como o R8 tornou as corrotinas do Kotlin no Android duas vezes mais rápidas
Leitura de 7 minutos
A partir do AGP 9.2.0, o R8 otimiza a maioria das chamadas Atomic*FieldUpdater em variantes Unsafe que têm uma performance 2 a 4 vezes melhor em operações comuns. Isso tem um impacto particularmente grande na biblioteca kotlinx.atomicfu, que implementa operações atômicas para kotlinx.coroutines, tornando o lançamento e o cancelamento de corrotinas até duas vezes mais rápidos. Para aproveitar os benefícios, atualize o AGP para a versão 9.2.0 ou mais recente.
Com a maioria dos apps Android adotando o Kotlin como linguagem principal, kotlinx.coroutines se tornou um padrão de fato para programação assíncrona. A biblioteca oferece uma maneira bem projetada e estruturada de gerenciar fluxos simultâneos nativos do Kotlin. O Jetpack Compose não foi exceção, adotando corrotinas para gerenciar eventos de ponteiro, animações e outras interações. No momento da redação deste artigo, a maioria das APIs simultâneas no Compose chama funções suspend nos bastidores e inicia e/ou cancela corrotinas para processar atualizações.
Quando a equipe do Compose começou a investigar o desempenho, descobriu que as corrotinas eram um gargalo para muitas operações que acontecem fora da composição. Por exemplo, 80% do tempo gasto na criação e atualização de Modifier.clickable foi consumido pelo lançamento e cancelamento de corrotinas internas que processavam atualizações de InteractionSource. Com base nessas observações, grande parte do trabalho inicial de desempenho se concentrou em remover corrotinas do caminho padrão e adiar a inicialização até que fosse necessário.
O custo de uma corrotina
A maneira mais fácil de analisar o comportamento interno de uma função no Android é capturar um rastreamento de método do Android Runtime (ART). Um rastreamento de método do ART é uma ferramenta que registra o fluxo de execução de um app, mostrando exatamente quais métodos são chamados, a ordem deles e quanto tempo é gasto em cada um, permitindo que os desenvolvedores identifiquem gargalos de desempenho. Para uma chamada LaunchedEffect { } vazia, ela ficaria assim:
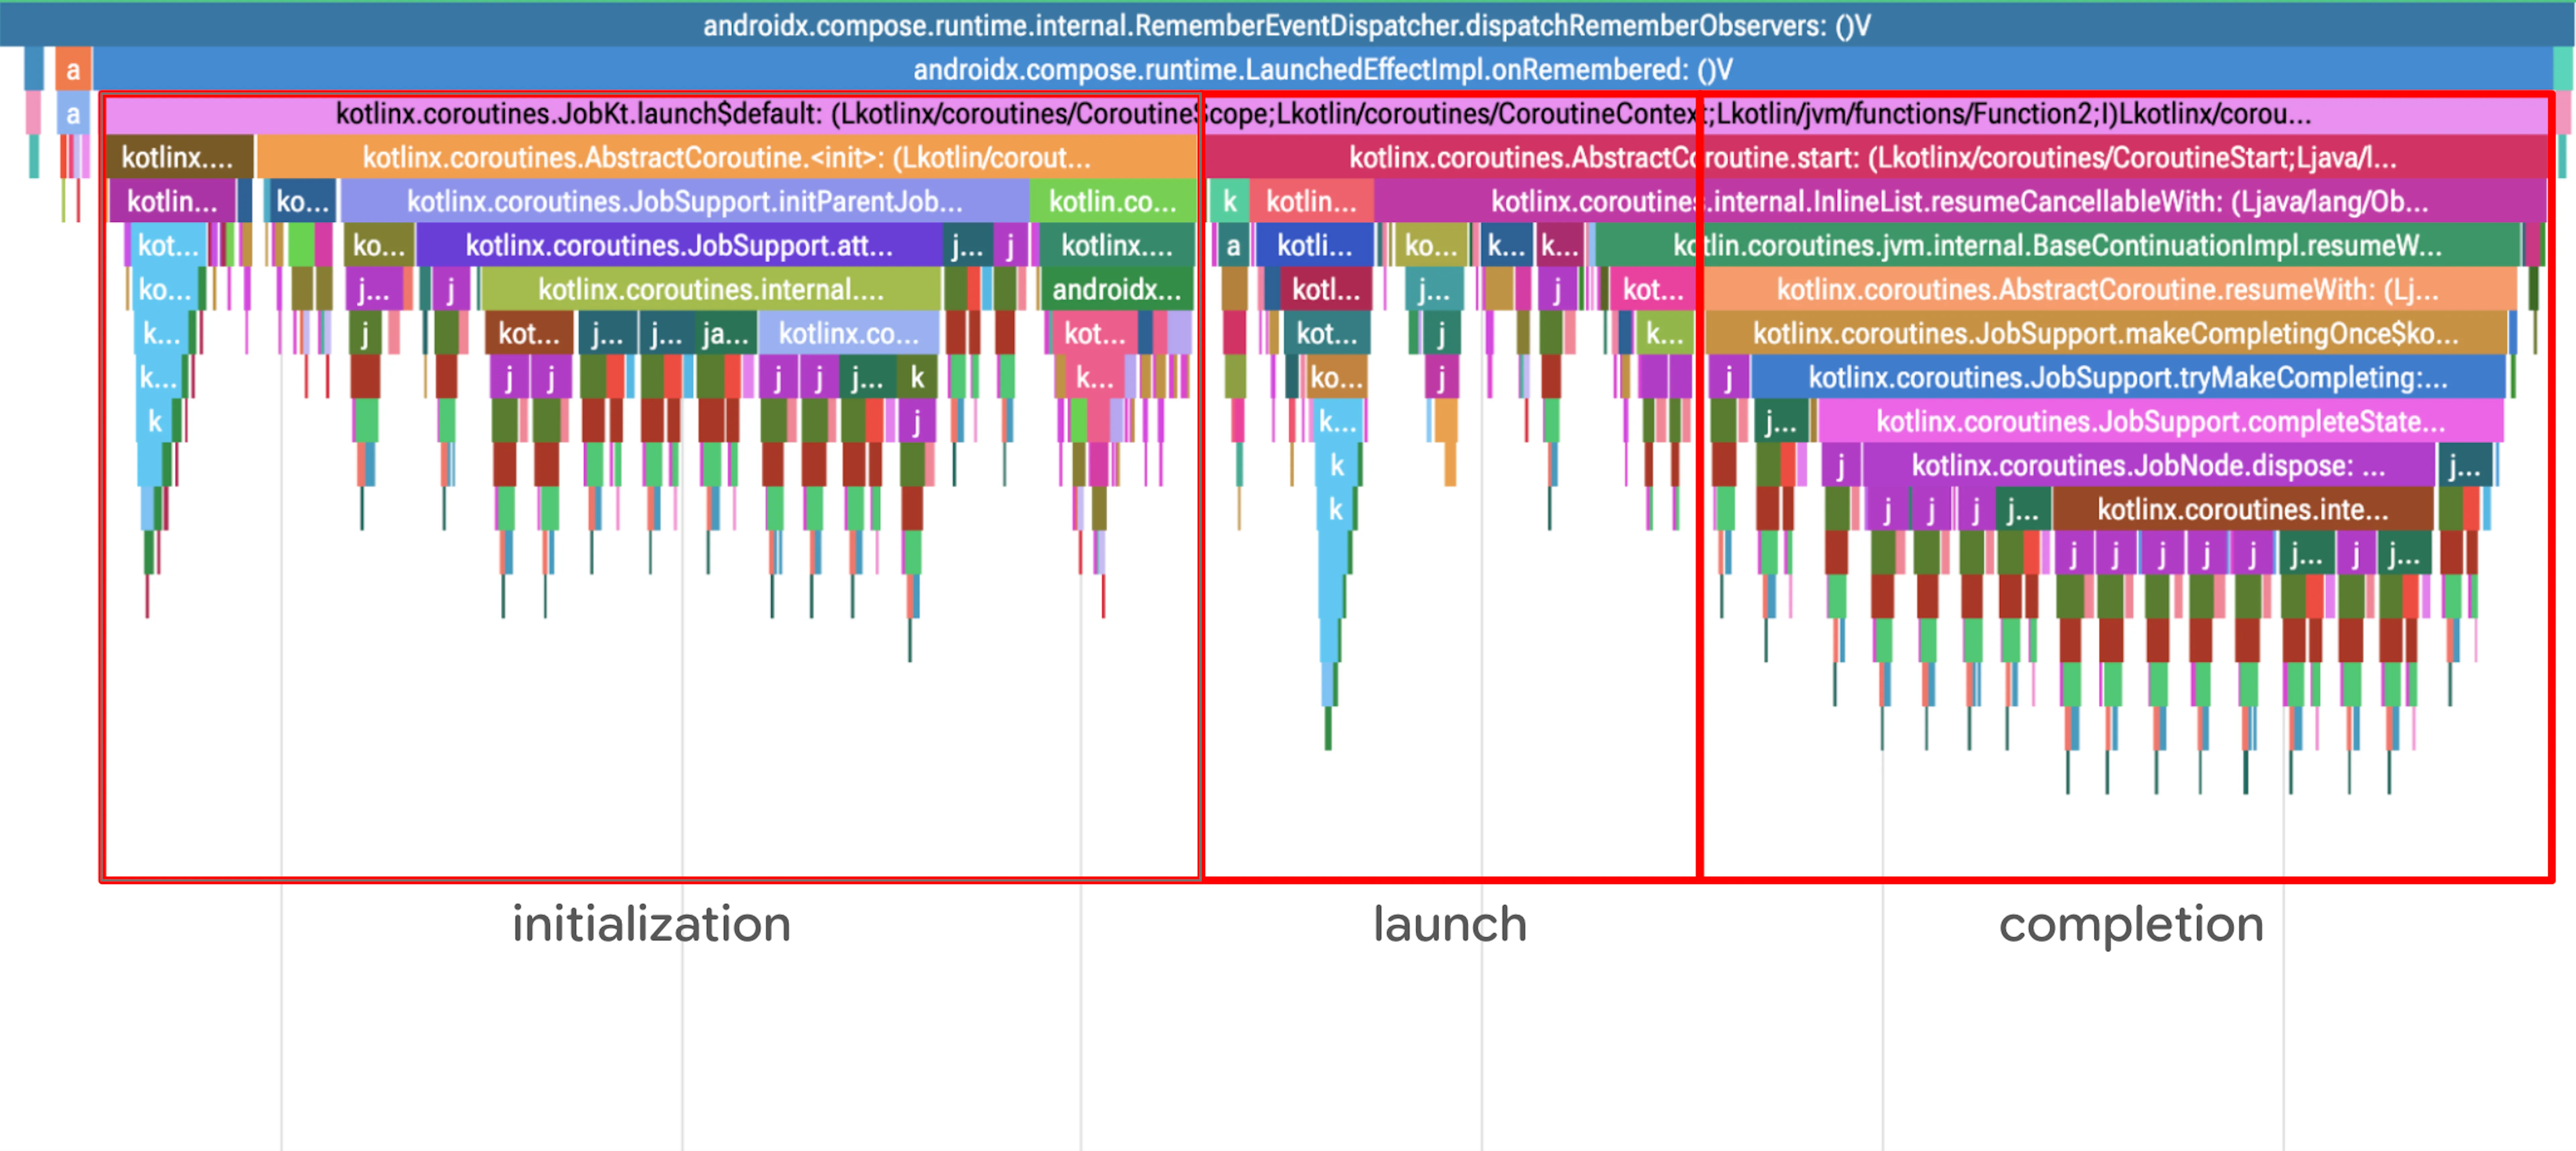
O rastreamento de método acima pode ser dividido em três partes:
- Inicializar uma nova corrotina
- Iniciando corrotina
- Conclusão da corrotina (porque ela é encerrada imediatamente)
O cancelamento de LaunchedEffect é semelhante à conclusão normal, mas também cria um CancellationException.
No perfil acima, uma coisa que é imediatamente suspeita são as chamadas frequentes para java.util.concurrent.AtomicReferenceFieldUpdater (caixas roxas ou verdes com rótulos j…). Embora cada chamada seja relativamente rápida, a frequência é preocupante. Qualquer sobrecarga não insignificante que seja distribuída por várias invocações pode resultar em uma regressão perceptível. Ao ampliar uma chamada, percebemos que a maior parte do tempo é gasta em... verificações de reflexão?
As corrotinas implementam uma estrutura de árvore sem bloqueio para relações pai-filho que torna possível a simultaneidade estruturada. Acontece que a biblioteca kotlinx.atomicfu implementa operações atômicas sem bloqueio usando uma primitiva JVM conhecida, AtomicReferenceFieldUpdater. O atualizador usa uma referência de classe e um nome de campo para realizar operações atômicas em tempo de execução, e precisa executar várias verificações de segurança reflexivas para garantir que o campo exista e esteja acessível. Cada operação em corrotinas (início, suspensão, cancelamento, conclusão) chama pelo menos uma operação atômica. Portanto, se ela for lenta, as corrotinas não terão um bom desempenho.
Investigando AtomicReferenceFieldUpdater
Mas não vamos nos adiantar. O AtomicReferenceFieldUpdater é bem otimizado na JVM há mais de 10 anos, e os rastreamentos de métodos podem capturar a sobrecarga que é completamente removida por uma otimização no nível da VM: compilações just-in-time (JIT) ou ahead-of-time (AOT). Para verificar a performance, vamos escrever algumas comparativas para medir a diferença entre referências atômicas de kotlinx.atomicfu e java.util.concurrent.atomic.
@RunWith(AndroidJUnit4::class)
class AtomicReferenceBenchmark {
    @get:Rule
    val benchmarkRule = BenchmarkRule()

    private val atomicReference = java.util.concurrent.atomic.AtomicReference(false)
    private val atomicRef = kotlinx.atomicfu.atomic<Boolean>(false)

    @Test
    fun atomicReference_compareAndSet() {
        benchmarkRule.measureRepeated {
            atomicReference.compareAndSet(true, false)
            atomicReference.compareAndSet(false, true)
        }
    }

     @Test
    fun atomicRef_compareAndSet() {
        benchmarkRule.measureRepeated {
            atomicRef.compareAndSet(true, false)
            atomicRef.compareAndSet(false, true)
        }
    }

    /* measuring other methods from the method traces above */
}
Executar esse comparativo em um Pixel 5 (garantindo que AtomicReferenceFieldUpdater#compareAndSet seja compilado JIT durante o aquecimento) gera os seguintes resultados no Pixel 5 (API 33):
 50.7 ns  atomicReference_compareAndSet
135   ns  atomicRef_compareAndSet
As medições confirmam a diferença, com a versão kotlinx.atomicfu sendo aproximadamente 2,7 vezes mais lenta. Isso confirma que o ART não realiza nenhuma otimização oculta e que as verificações de acesso reflexivo adicionam sobrecarga real durante a execução.
Voltando ao rastreamento de método original, o único trabalho significativo realizado pelo AtomicReferenceFieldUpdater é a chamada interna para Unsafe.getObjectVolatile, que executa a operação atômica subjacente. Na maioria dos casos, o inicializador do atualizador é estático e pode ser comprovado como sempre correto com base na estrutura da classe ao redor. Assim, é possível analisar estaticamente a maioria dos usos de AtomicReferenceFieldUpdater e substituí-los por uma variante Unsafe interna durante a compilação. Acontece que o conjunto de ferramentas de build do Android tem um compilador de otimização próprio que pode fazer exatamente isso.
Otimização com o R8
As classes Atomic*FieldUpdater oferecem suporte a uso sutil, dinâmico e baseado em reflexão, mas geralmente são usadas em padrões estaticamente óbvios. Isso explica a lentidão da performance de referência e a necessidade de otimização. O R8 é um compilador de otimização de programa completo e é adequado para identificar os padrões mais simples e reduzir a sobrecarga das verificações de segurança reflexivas. O R8 recebe bytecode da JVM após o compilador Java ou Kotlin, mas para facilitar a leitura, estes exemplos são apresentados na sintaxe Java. Por isso, não há argumentos de tipo para AtomicReferenceFieldUpdater.
class Example {
    volatile String data = "";
    static final AtomicReferenceFieldUpdater updater =
        AtomicReferenceFieldUpdater.newUpdater(Example.class, String.class, "data");

    void example() {
        // ...
        updater.compareAndSet(this, "", "new");
        // ...
    }
}
O exemplo básico cria um atualizador final estático que acessa um campo volátil com argumentos constantes simples para o titular, o tipo e o nome do campo. A reflexão usada é totalmente transparente. É claro que esse atualizador faz referência a um campo válido e que o site da criação do atualizador tem acesso válido ao campo.
Basicamente, Atomic*FieldUpdater é um wrapper em torno de um deslocamento de campo e chamadas para Unsafe. O melhor cenário para a otimização é substituir o campo do atualizador por um campo de deslocamento e substituir as chamadas do atualizador por chamadas para Unsafe.
Otimização de Atomic*FieldUpdater
A otimização é implementada em três partes: instrumentação, substituição e limpeza.
Instrumentação
A primeira etapa é introduzir campos de ajuste junto com o campo de atualização para facilitar o acesso direto pela chamada Unsafe .
static final long updater$offset =
    SyntheticUnsafe.UNSAFE.objectFieldOffset(Example.class.getDeclaredField("data"))
O campo é acessado por reflexão, e Unsafe é usado para extrair o deslocamento do campo na classe. Esse código representa os internos de Atomic*FieldUpdater se você ignorar a validação de reflexão. Em vez disso, o tipo de holder do atualizador e o tipo de campo do campo volátil são rastreados de forma estática no compilador.
O campo original e a inicialização dele permanecem inalterados. O processo de otimização facilita e otimiza o uso de forma otimista e, depois, faz uma limpeza. Essa é uma abordagem simples para a implementação, mas também permite a otimização parcial dos campos do atualizador, em que alguns usos são deixados como estavam, enquanto outros são otimizados.
Substituição
Neste ponto do compilador, depois de um ponto de junção de simultaneidade adequado, temos uma lista de campos de atualização instrumentados. Isso significa que podemos otimizar cada site de chamada individualmente com base em algumas condições. Considere um exemplo de chamada:
updater.compareAndSet(holder, expectedValue, newValue);
As condições exigidas pelo Atomic*FieldUpdater são estas:
- O
updatervem de um campo instrumentado? Ou seja, a análise estática pode rastrear o valor do objeto até uma leitura de campo de um atualizador instrumentado? holderé a mesma classe ou uma subclasse do tipo de suporte definido originalmente?newValueé a mesma classe ou uma subclasse do tipo de campo definido originalmente?
Se todas as condições forem atendidas, a chamada será substituída por uma chamada para Unsafe sem nenhuma das verificações de reflexão.
SyntheticUnsafe.UNSAFE.compareAndSwapObject(holder, Example.updater$offset, expectedValue, newValue)
Essa nova chamada é mais rápida e simples, mas difere da original em relação ao tratamento de valores nulos em updater e holder. A menos que sejam descartadas de forma estática, as verificações de nulo são inseridas para ambas.
Limpeza
Nesse ponto, a classe de retenção tem o campo de atualização original e o novo campo de deslocamento, além de sites de chamada que podem usar um dos dois. Se nenhum dos locais de chamada foi otimizado, o campo de deslocamento precisa ser removido. Se todos os locais de chamada foram otimizados, o campo de atualização precisa ser removido. Em ambos os casos, a chamada de inicialização também precisa ser excluída. A exclusão de campos não usados e a remoção de código inativo já são feitas no compilador, mas remover o código de inicialização aqui exige mais alguns truques.
A chamada para newUpdater e getDeclaredField pode ter efeitos colaterais, já que elas podem gerar exceções. Além disso, a implementação delas é desconhecida, já que depende da versão da API. Isso significa que, por otimização genérica, eles não podem ser removidos com segurança. Portanto, essa limpeza exigiu uma consideração explícita dos campos instrumentados, já que eles são conhecidos estaticamente como livres de exceções.
No final, o exemplo de atualização simples mostrado acima fica assim após a otimização:
Resultados
Após essas otimizações, kotlinx.atomicfu e a maioria dos usos explícitos de AtomicInt/Long/ReferenceFieldUpdater agora correspondem à performance de AtomicReference com o R8 aplicado. Na verdade, ele é ainda mais rápido em alguns comparativos. O kotlinx.atomicfu tem um plug-in de compilador que pode inserir instâncias atomic em campos, reduzindo as alocações necessárias para criar um campo atualizado atomicamente.
O Jetpack Compose foi o principal beneficiário desse trabalho. O ambiente de execução do Compose tem vários microbenchmarks que rastreiam a performance da corrotina de perto para detectar regressões de performance no início. Quando os comparativos foram atualizados para uma nova versão do R8, notamos uma melhoria de 2x ao iniciar e cancelar corrotinas em LaunchedEffect.
Além disso, a equipe do ART está implementando essas otimizações de forma nativa no nível da VM. Se o app estiver segmentando a API 36 e sendo executado em uma versão recente do Android, é possível que o dispositivo já esteja otimizando as corrotinas de maneira semelhante. Os comparativos de corrotinas acima observaram uma melhoria de cerca de 15% na performance após atualizações do JIT nas versões recentes do ART.
Seu app vai receber essa otimização por padrão ao fazer upgrade para o AGP 9.2.0 ou usar o R8 9.2.0 diretamente. Para mais informações, consulte D8 dexer e R8 shrinker.
-
 Estudos de caso
O WhatsApp é a maior plataforma de mensagens do mundo, atendendo a bilhões de usuários em todo o mundo. É a ferramenta de comunicação padrão para pessoas em várias regiões, conectando usuários por mensagens privadas, confiáveis e seguras.
Niharika Arora, Tracy Agyemang, Mayank Jain • Leitura de 8 minutos -
 Estudos de caso
O Tinder tem como missão impulsionar e inspirar conexões reais, facilitando e tornando divertido o encontro de solteiros de todas as gerações.
Ajesh Pai, Ulises Uriel Verduzco Díaz , Tracy Agyemang • Leitura de 4 minutos -
 Estudos de caso
As regressões de desempenho são notoriamente difíceis de reproduzir, o que as torna um grande gargalo para desenvolvedores de dispositivos móveis.
Alice Yuan, Arti Arutiunov, Nikita Ogorodnikov • Leitura de 4 minutos
Receba os insights mais recentes sobre desenvolvimento Android na sua caixa de entrada semanalmente.