Comment R8 a permis de doubler la vitesse des coroutines Kotlin sur Android
Temps de lecture : 7 min
À partir d'AGP 9.2.0, R8 optimise la plupart des appels Atomic*FieldUpdater en variantes Unsafe qui sont deux à quatre fois plus performantes pour les opérations courantes. Cela a un impact particulièrement important sur la bibliothèque kotlinx.atomicfu qui implémente les atomiques pour kotlinx.coroutines, ce qui permet de lancer et d'annuler des coroutines jusqu'à deux fois plus rapidement. Pour en profiter, passez à la version 9.2.0 ou ultérieure d'AGP.
La majorité des applications Android adoptant Kotlin comme langage principal, kotlinx.coroutines est devenu une norme de fait pour la programmation asynchrone. La bibliothèque offre un moyen bien conçu et structuré de gérer les flux simultanés, natif de Kotlin. Jetpack Compose ne fait pas exception, car il adopte les coroutines pour gérer les événements de pointeur, les animations et d'autres interactions. À l'heure où nous écrivons ces lignes, la plupart des API simultanées de Compose appellent des fonctions suspend en arrière-plan, et lancent et/ou annulent des coroutines pour gérer les mises à jour.
Lorsque l'équipe Compose a commencé à étudier les performances, elle a découvert que les coroutines constituaient un goulot d'étranglement pour de nombreuses opérations qui se produisent en dehors de la composition. Par exemple, 80% du temps consacré à la création et à la mise à jour de Modifier.clickable était consommé par le lancement et l'annulation de coroutines internes qui géraient les mises à jour de InteractionSource. Sur la base de ces observations, une grande partie des premiers travaux d'optimisation des performances a consisté à supprimer les coroutines du chemin par défaut et à retarder l'initialisation jusqu'à ce qu'elle soit nécessaire.
Le coût d'une coroutine
Le moyen le plus simple d'analyser le comportement interne d'une fonction sur Android consiste à capturer une trace de méthode Android Runtime (ART). Une trace de méthode ART est un outil qui enregistre le flux d'exécution d'une application. Elle indique précisément les méthodes appelées, leur ordre et le temps passé dans chacune d'elles, ce qui permet aux développeurs d'identifier les goulots d'étranglement affectant les performances. Pour un appel LaunchedEffect { } vide, cela ressemblerait à ceci :
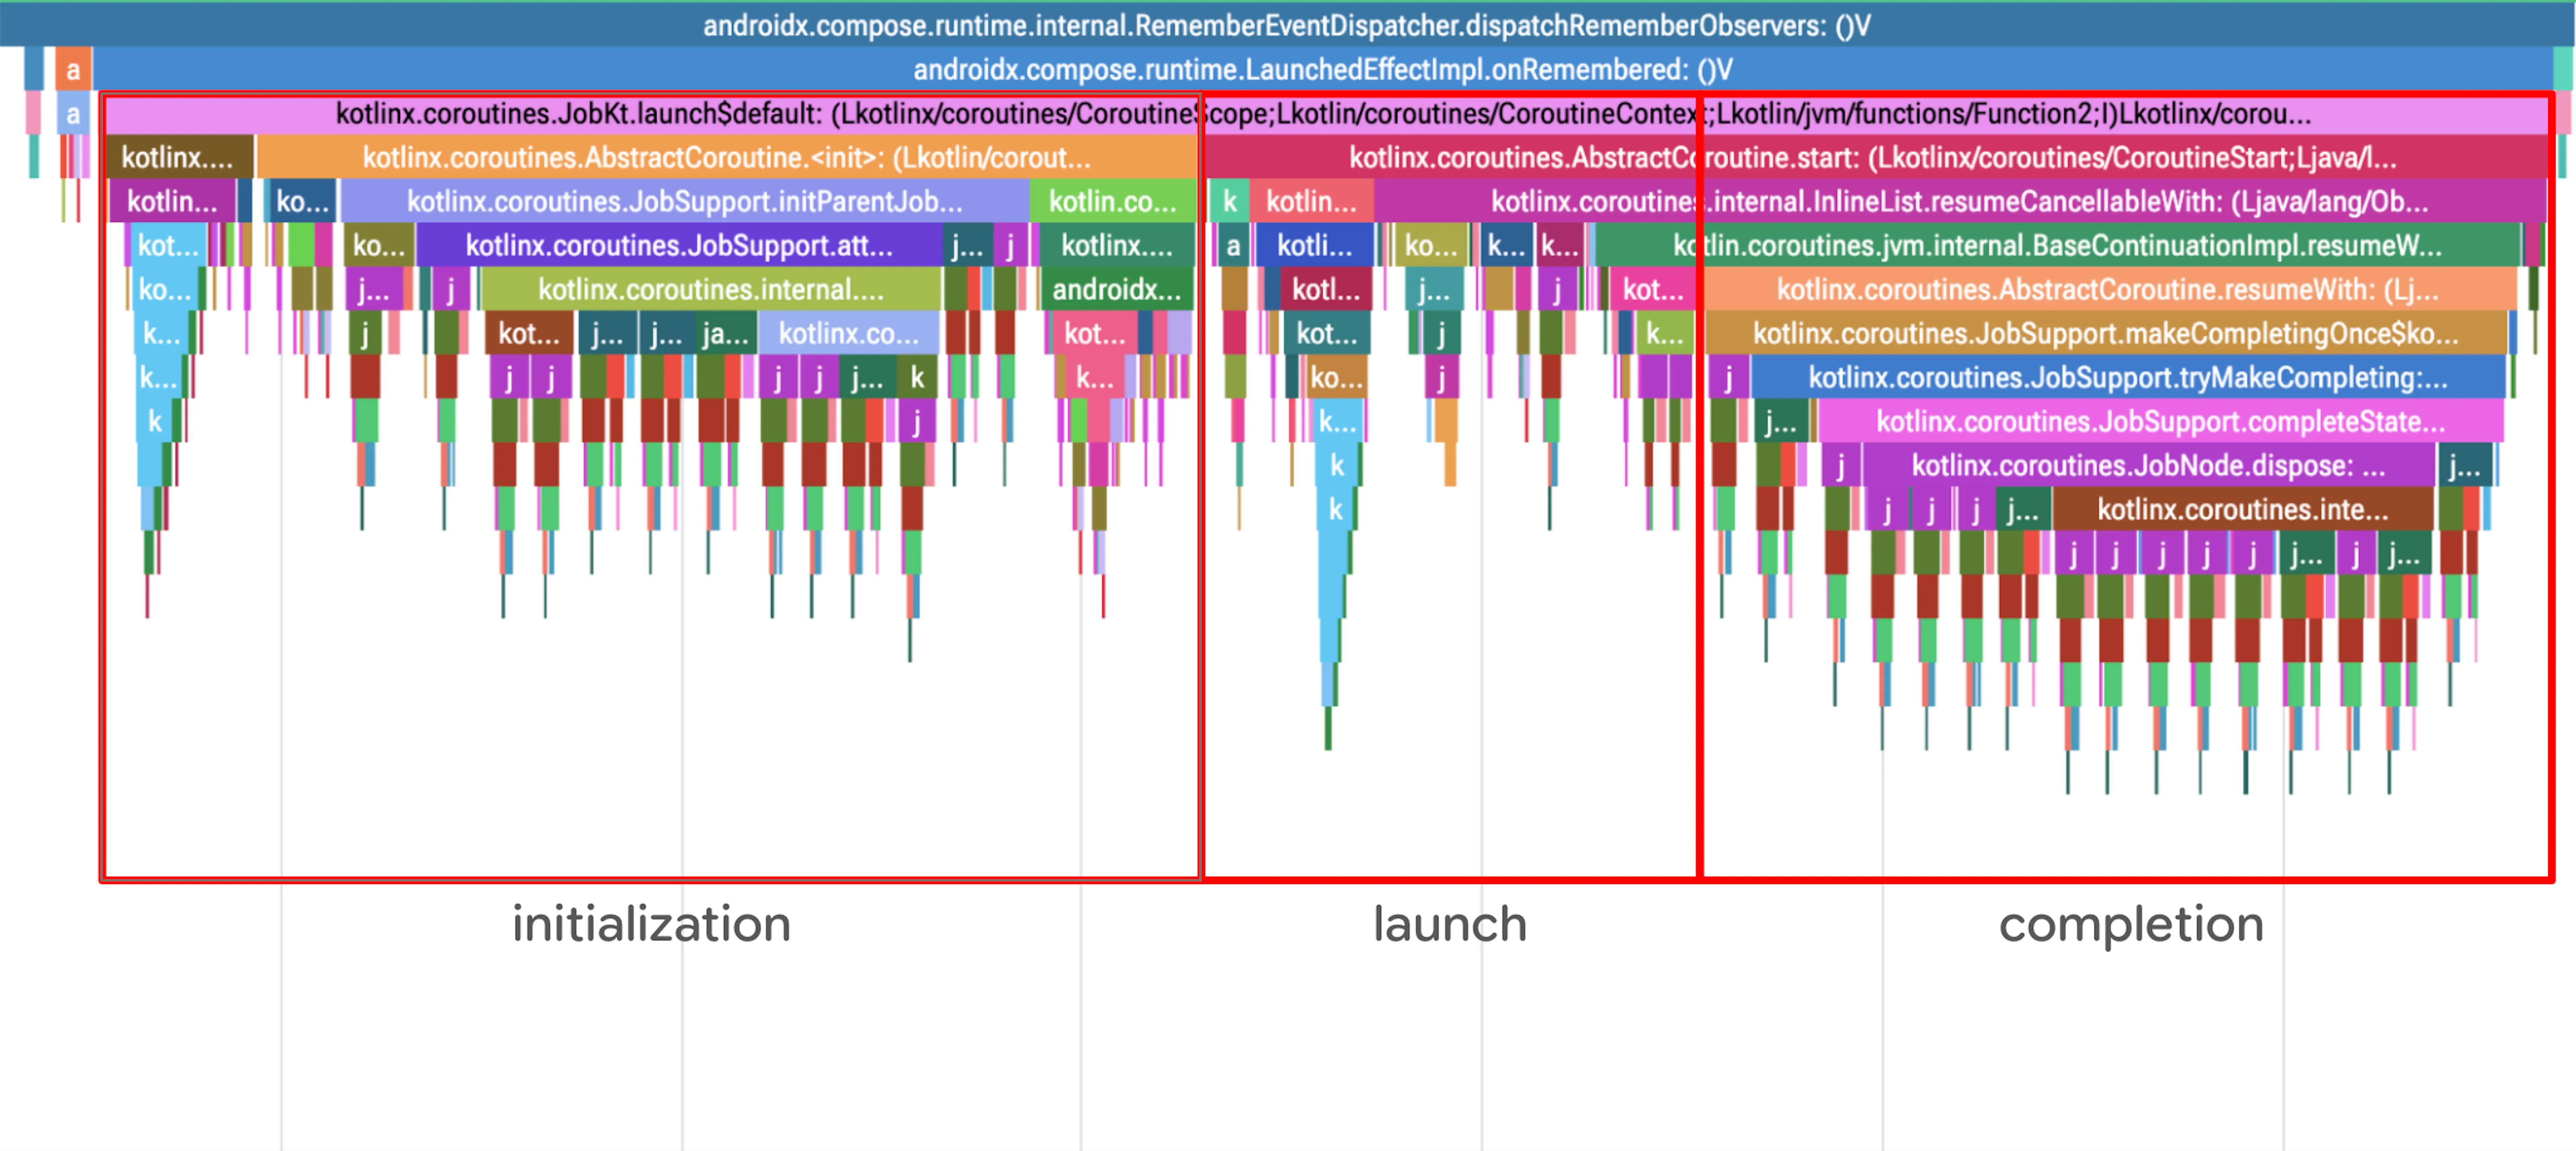
La trace de méthode ci-dessus peut être divisée en trois parties :
- Initialiser une nouvelle coroutine
- Démarrage de la coroutine
- Coroutine terminée (car elle se ferme immédiatement)
L'annulation de LaunchedEffect est semblable à l'achèvement normal, sauf qu'elle crée également un CancellationException.
Dans le profil ci-dessus, un élément immédiatement suspect est l'appel fréquent à java.util.concurrent.AtomicReferenceFieldUpdater (cases violettes ou vertes avec des libellés j…). Bien que chaque appel soit relativement rapide, la fréquence est préoccupante. Toute surcharge non négligeable répartie sur plusieurs appels peut s'ajouter à une régression notable. En zoomant sur un appel, on constate que la majeure partie du temps est consacrée à des vérifications de réflexion.
Les coroutines implémentent une structure arborescente sans verrou pour les relations parent-enfant, ce qui permet une simultanéité structurée. Il s'avère que la bibliothèque kotlinx.atomicfu implémente des opérations atomiques sans verrouillage à l'aide d'une primitive JVM bien connue, AtomicReferenceFieldUpdater. L'outil de mise à jour utilise une référence de classe et un nom de champ pour effectuer des opérations atomiques au moment de l'exécution. Il doit exécuter plusieurs vérifications de sécurité réfléchissantes pour s'assurer que le champ existe et est accessible. Chaque opération dans les coroutines (démarrage, suspension, annulation, exécution) appelle au moins une opération atomique. Par conséquent, si elle est lente, les coroutines ne seront pas performantes.
Examiner AtomicReferenceFieldUpdater
Mais ne brûlons pas les étapes. AtomicReferenceFieldUpdater est en fait bien optimisé sur la JVM depuis plus de 10 ans, et les traces de méthode peuvent capturer une surcharge qui est complètement supprimée par une optimisation au niveau de la VM : compilations juste-à-temps (JIT) ou anticipées (AOT). Pour vérifier les performances, écrivons quelques benchmarks afin de mesurer la différence entre les références atomiques de kotlinx.atomicfu et java.util.concurrent.atomic.
@RunWith(AndroidJUnit4::class)
class AtomicReferenceBenchmark {
    @get:Rule
    val benchmarkRule = BenchmarkRule()

    private val atomicReference = java.util.concurrent.atomic.AtomicReference(false)
    private val atomicRef = kotlinx.atomicfu.atomic<Boolean>(false)

    @Test
    fun atomicReference_compareAndSet() {
        benchmarkRule.measureRepeated {
            atomicReference.compareAndSet(true, false)
            atomicReference.compareAndSet(false, true)
        }
    }

     @Test
    fun atomicRef_compareAndSet() {
        benchmarkRule.measureRepeated {
            atomicRef.compareAndSet(true, false)
            atomicRef.compareAndSet(false, true)
        }
    }

    /* measuring other methods from the method traces above */
}
L'exécution de ce benchmark sur un Pixel 5 (en s'assurant que AtomicReferenceFieldUpdater#compareAndSet est compilé par JIT pendant le préchauffage) donne les résultats suivants sur un Pixel 5 (API 33) :
 50.7 ns  atomicReference_compareAndSet
135   ns  atomicRef_compareAndSet
Les mesures confirment l'écart, la version kotlinx.atomicfu étant clairement environ 2,7 fois plus lente. Cela confirme qu'ART n'effectue aucune optimisation cachée et que les vérifications d'accès par réflexion ajoutent une surcharge réelle lors de l'exécution.
Si l'on revient à la trace de méthode d'origine, la seule tâche significative effectuée par AtomicReferenceFieldUpdater est l'appel interne à Unsafe.getObjectVolatile qui exécute l'opération atomique sous-jacente. Dans la plupart des cas, l'initialiseur de l'outil de mise à jour est statique et peut être considéré comme toujours correct en fonction de la structure de la classe environnante. Ainsi, il est possible d'analyser de manière statique la plupart des utilisations de AtomicReferenceFieldUpdater et de les remplacer par une variante Unsafe interne lors de la compilation. Il se trouve que la chaîne d'outils de compilation Android dispose de son propre compilateur d'optimisation qui peut faire exactement cela.
Optimisation avec R8
Les classes Atomic*FieldUpdater sont compatibles avec une utilisation subtile, dynamique et basée sur la réflexion, mais elles sont souvent utilisées dans des modèles statiquement évidents. Cela explique à la fois les performances de référence lentes et le besoin d'optimisation. R8 est un compilateur d'optimisation de programme complet. Il est bien adapté pour voir à travers les modèles plus simples afin de réduire la surcharge des contrôles de sécurité par réflexion. R8 reçoit le bytecode JVM après le compilateur Java ou Kotlin, mais pour faciliter la lisibilité, ces exemples sont présentés dans la syntaxe Java. C'est pourquoi il n'y a pas d'arguments de type pour AtomicReferenceFieldUpdater.
class Example {
    volatile String data = "";
    static final AtomicReferenceFieldUpdater updater =
        AtomicReferenceFieldUpdater.newUpdater(Example.class, String.class, "data");

    void example() {
        // ...
        updater.compareAndSet(this, "", "new");
        // ...
    }
}
L'exemple de base crée un outil de mise à jour final statique qui accède à un champ volatile avec des arguments constants simples pour le conteneur, le type et le nom du champ. La réflexion utilisée est totalement transparente. Il est clair que cet updater fait référence à un champ valide et que le site de création de l'updater dispose d'un accès valide au champ.
En substance, Atomic*FieldUpdater est un wrapper autour d'un décalage de champ et d'appels à Unsafe. Dans le meilleur des cas, l'optimisation consiste à remplacer le champ de mise à jour par un champ de décalage et à remplacer les appels de mise à jour par des appels à Unsafe.
Optimisation d'Atomic*FieldUpdater
L'optimisation est mise en œuvre en trois parties : instrumentation, remplacement et nettoyage.
Instrumentation
La première étape consiste à introduire des champs de décalage à côté du champ de mise à jour afin de faciliter l'accès direct via l'appel Unsafe .
static final long updater$offset =
    SyntheticUnsafe.UNSAFE.objectFieldOffset(Example.class.getDeclaredField("data"))
Le champ est accessible via la réflexion, et Unsafe est utilisé pour extraire le décalage du champ sur la classe. Ce code représente les éléments internes de Atomic*FieldUpdater si vous ne tenez pas compte de la validation de la réflexion. À la place, le type de conteneur de l'outil de mise à jour et le type de champ du champ volatile sont suivis de manière statique dans le compilateur.
Notez que le champ d'origine et son initialisation sont laissés tels quels. Le processus d'optimisation facilite et optimise les utilisations de manière optimiste, puis effectue un nettoyage ultérieurement. Il s'agit d'une approche simple de l'implémentation, mais elle permet également une optimisation partielle des champs de mise à jour, où certaines utilisations sont laissées telles quelles, tandis que d'autres sont optimisées.
Remplacement
À ce stade du compilateur, après un point de jointure de simultanéité approprié, nous disposons d'une liste de champs de mise à jour instrumentés. Cela signifie que nous pouvons optimiser chaque site d'appel individuellement en fonction de quelques conditions. Prenons l'exemple d'un appel :
updater.compareAndSet(holder, expectedValue, newValue);
Les conditions requises par Atomic*FieldUpdater sont les suivantes :
- Est-ce que
updaterprovient d'un champ instrumenté ? En d'autres termes, l'analyse statique peut-elle remonter la valeur de l'objet jusqu'à la lecture d'un champ d'un updater instrumenté ? holderest-il la même classe ou une sous-classe du type de conteneur défini à l'origine ?newValueest-il de la même classe ou d'une sous-classe du type de champ défini à l'origine ?
Si toutes les conditions sont remplies, l'appel est remplacé par un appel à Unsafe sans aucune vérification de réflexion.
SyntheticUnsafe.UNSAFE.compareAndSwapObject(holder, Example.updater$offset, expectedValue, newValue)
Ce nouvel appel est plus rapide et plus simple, mais il diffère de l'appel d'origine en ce qui concerne la gestion des valeurs nulles dans updater et holder. Sauf exclusion statique, des vérifications de valeurs nulles sont insérées pour les deux.
Effectuer un nettoyage
À ce stade, la classe de stockage comporte le champ de mise à jour d'origine et le nouveau champ de décalage, ainsi que des sites d'appel qui peuvent utiliser l'un ou l'autre. Si aucun des sites d'appel n'a été optimisé, le champ "offset" doit être supprimé. Si tous les sites d'appel ont été optimisés, le champ "updater" doit être supprimé. Dans les deux cas, l'appel d'initialisation doit également être supprimé. La suppression des champs inutilisés et du code mort est déjà effectuée dans le compilateur, mais la suppression du code d'initialisation nécessite quelques astuces supplémentaires.
Les appels à newUpdater et getDeclaredField peuvent avoir des effets secondaires, car ils peuvent générer des exceptions (et leur implémentation est également inconnue, car elle dépend de la version de l'API). Cela signifie qu'ils ne peuvent pas être supprimés de manière sécurisée par optimisation générique. Ce nettoyage a donc nécessité une prise en compte explicite des champs instrumentés, car on sait de manière statique qu'ils ne contiennent pas d'exceptions.
Au final, l'exemple de l'outil de mise à jour simple présenté ci-dessus ressemble à ceci après optimisation :
Résultats
Après ces optimisations, kotlinx.atomicfu et la plupart des utilisations explicites de AtomicInt/Long/ReferenceFieldUpdater correspondent désormais aux performances de AtomicReference avec R8 appliqué. En fait, il est même plus rapide dans certains benchmarks ; kotlinx.atomicfu dispose d'un plug-in de compilateur qui peut intégrer des instances atomic dans des champs, ce qui réduit les allocations requises pour créer un champ mis à jour de manière atomique.
Jetpack Compose a été le principal bénéficiaire de ce travail. L'environnement d'exécution Compose comporte un certain nombre de micro-benchmarks qui suivent de très près les performances des coroutines afin de détecter rapidement les régressions de performances. Lorsque les benchmarks ont été mis à jour vers une nouvelle version de R8, nous avons constaté une amélioration de 2x lors du lancement et de l'annulation de coroutines dans LaunchedEffect.
En outre, l'équipe ART implémente ces optimisations de manière native au niveau de la VM. Si votre application cible l'API 36 et s'exécute sur une version récente d'Android, il est possible que votre appareil optimise déjà les coroutines de la même manière. Les benchmarks de coroutines ci-dessus ont observé une amélioration des performances d'environ 15% après les mises à jour JIT dans les versions récentes d'ART.
Votre application bénéficiera de cette optimisation par défaut lors de la mise à niveau vers AGP 9.2.0 ou en utilisant directement R8 9.2.0. Pour en savoir plus, consultez Dexer D8 et outil de réduction R8.
-
 Études de cas
Grab est la super-application leader en Asie du Sud-Est. Elle propose des services de livraison, de mobilité et des services financiers à des millions d'utilisateurs dans huit pays via une seule application.
Ajesh Pai, Nguyen Van Minh, Tracy Agyemang • Temps de lecture : 5 min -
 Études de cas
L'équipe a créé un codebase d'UI basé sur l'IA 50% plus petit que l'implémentation d'origine, tout en réduisant de 35% le temps d'exécution de l'agent IA, de 32% les échanges entre l'ingénieur et l'agent, et de 33% le coût des jetons.
Pavlo Stavytskyi, Rebecca Franks • Temps de lecture : 11 min -
 Études de cas
WhatsApp est la plus grande plate-forme de messagerie au monde, avec des milliards d'utilisateurs dans le monde entier. C'est l'outil de communication par défaut pour les personnes de différentes régions, qui connecte les utilisateurs via une messagerie privée, fiable et sécurisée.
Niharika Arora, Tracy Agyemang, Mayank Jain • Temps de lecture : 8 min
Recevez chaque semaine les dernières informations sur le développement Android dans votre boîte de réception.