AGP 9.2.0부터 R8은 대부분의 Atomic*FieldUpdater 호출을 일반적인 작업에서 2~4배 더 나은 성능을 발휘하는 Unsafe 변형으로 최적화합니다. 이는 kotlinx.coroutines의 원자성을 구현하는 kotlinx.atomicfu 라이브러리에 특히 큰 영향을 미치며, 코루틴을 최대 2배 더 빠르게 실행하고 취소할 수 있습니다. 이러한 이점을 누리려면 AGP를 9.2.0 이상으로 업데이트하세요.
대부분의 Android 앱이 Kotlin을 기본 언어로 채택함에 따라 kotlinx.coroutines은 비동기 프로그래밍의 사실상 표준이 되었습니다. 이 라이브러리는 Kotlin에 기본 제공되는 동시 흐름을 관리하는 잘 설계되고 구조화된 방식을 제공합니다. Jetpack Compose도 예외는 아니어서 포인터 이벤트, 애니메이션, 기타 상호작용을 관리하는 데 코루틴을 채택했습니다. 이 글을 작성하는 시점에서 Compose의 대부분의 동시 실행 API는 내부적으로 suspend 함수를 호출하고 업데이트를 처리하기 위해 코루틴을 실행하거나 취소합니다.
Compose팀에서 성능을 조사하기 시작하면서 코루틴이 컴포지션 외부에서 발생하는 많은 작업의 병목 현상으로 발견되었습니다. 예를 들어 Modifier.clickable를 만들고 업데이트하는 데 소요된 시간의 80% 는 InteractionSource 업데이트를 처리하는 내부 코루틴을 실행하고 취소하는 데 사용되었습니다. 이러한 관찰을 바탕으로 초기 성능 작업의 대부분은 기본 경로에서 코루틴을 삭제하고 필요할 때까지 초기화를 지연하는 데 중점을 두었습니다.
코루틴 비용
Android에서 함수의 내부 동작을 분석하는 가장 쉬운 방법은 Android 런타임(ART) 메서드 트레이스를 캡처하는 것입니다. ART 메서드 트레이스는 앱의 실행 흐름을 기록하는 도구로, 호출되는 메서드, 순서, 각 메서드에 소요되는 시간을 정확하게 보여주므로 개발자가 성능 병목 현상을 식별할 수 있습니다. 빈 LaunchedEffect { } 호출의 경우 다음과 같이 표시됩니다.
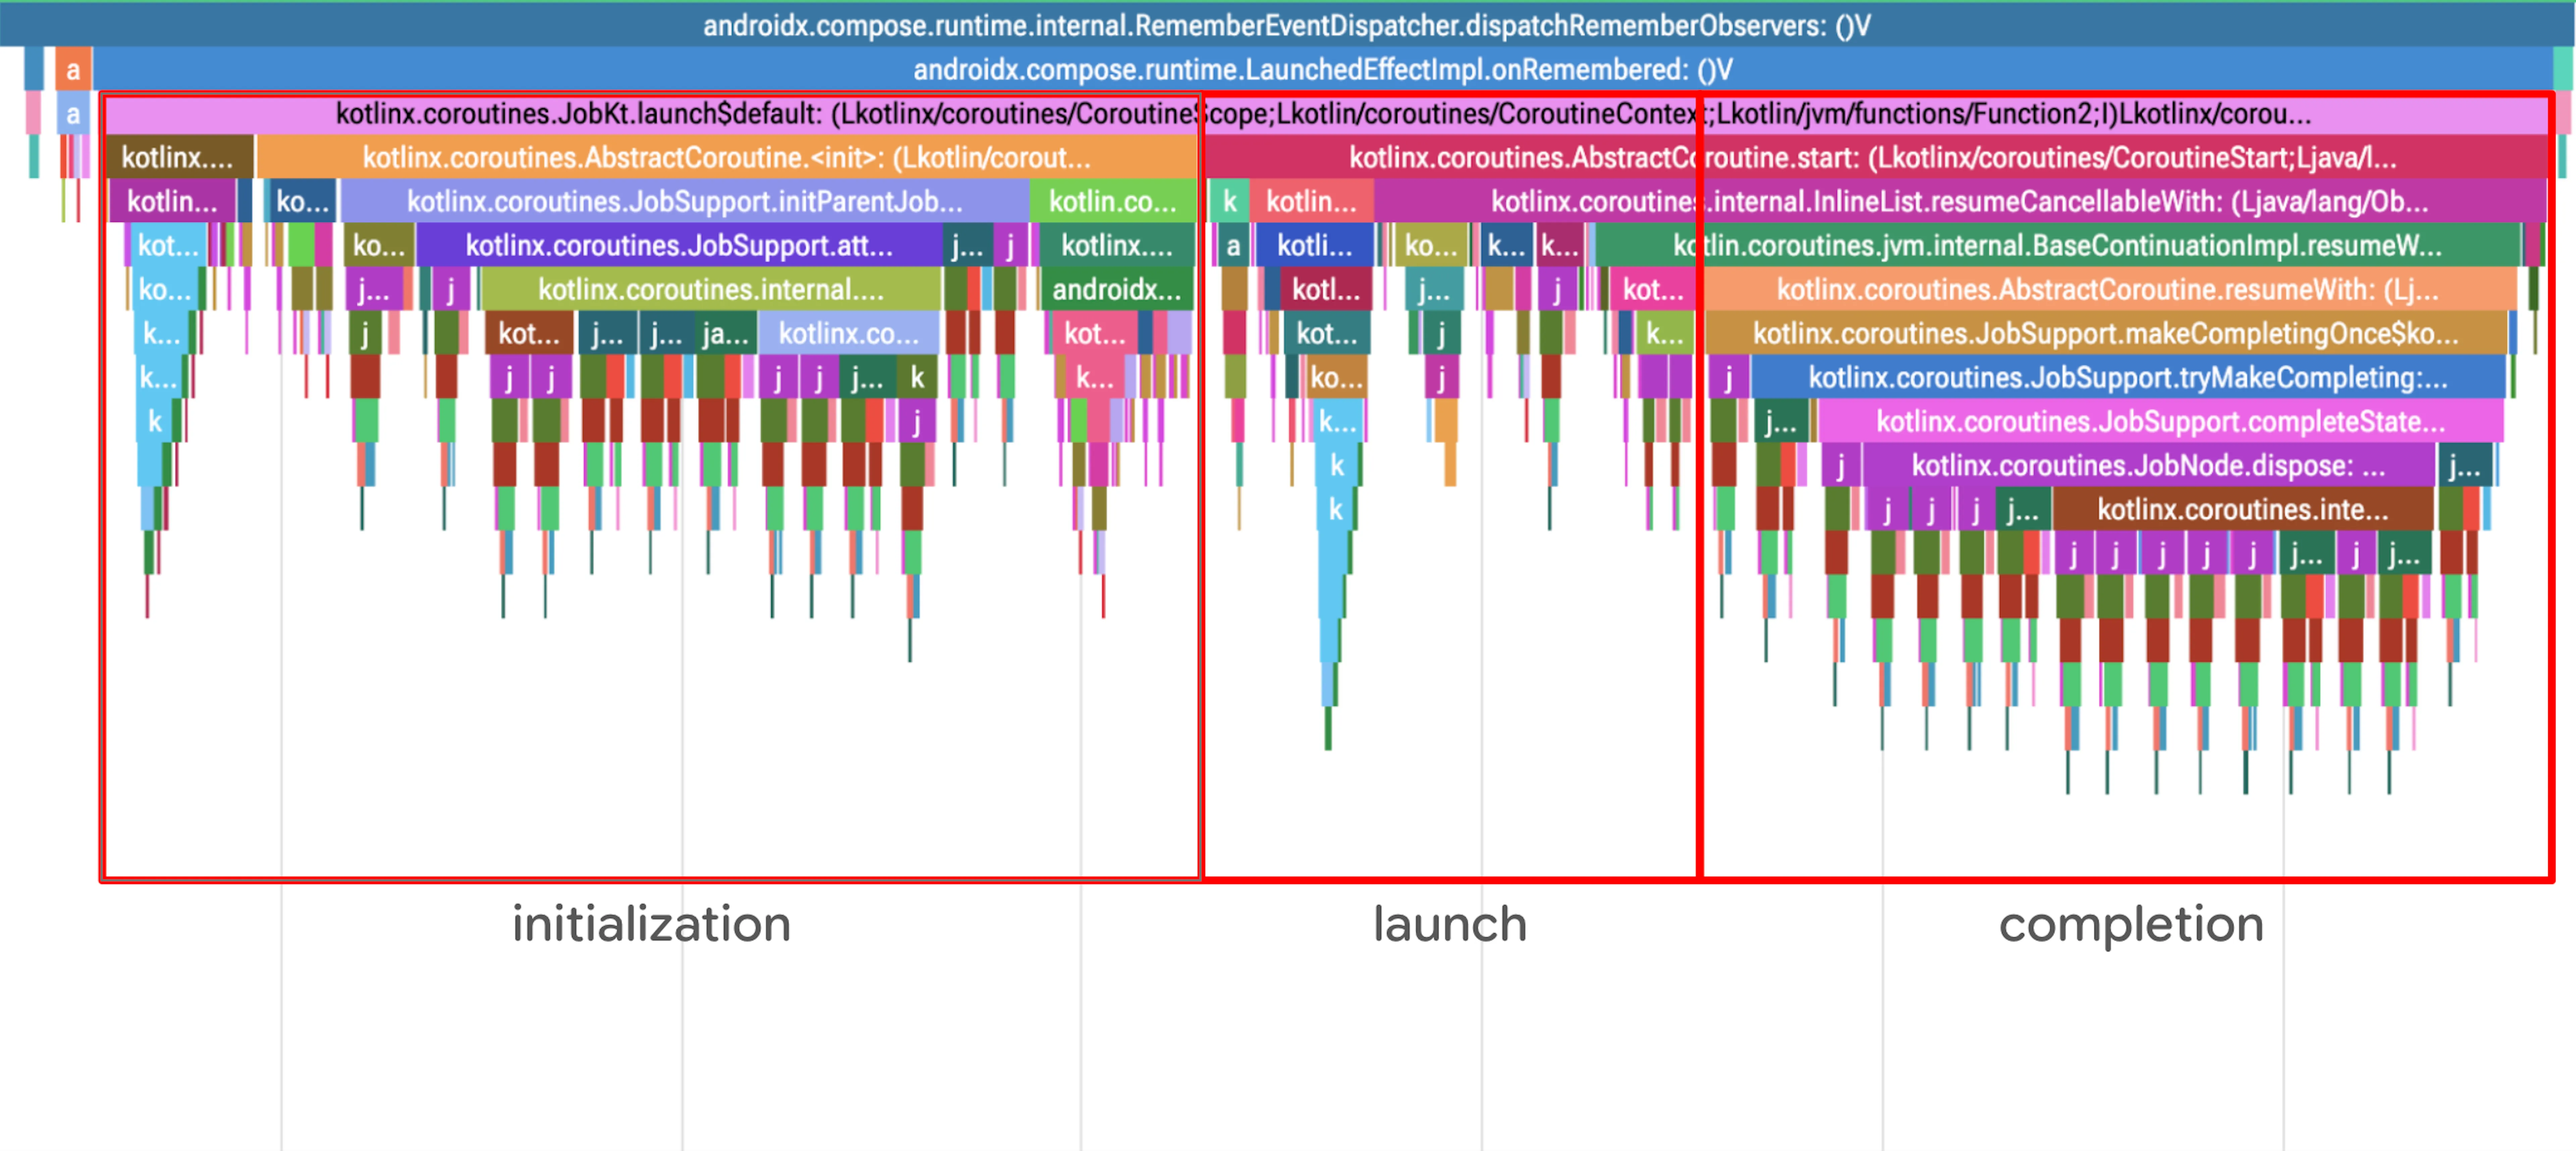
위의 메서드 트레이스는 세 부분으로 나눌 수 있습니다.
- 새 코루틴 초기화
- 코루틴 시작
- 코루틴 완료(즉시 종료되기 때문)
LaunchedEffect 취소는 정상적인 완료와 비슷하지만 CancellationException도 생성됩니다.
위 프로필에서 즉시 의심스러운 점은 java.util.concurrent.AtomicReferenceFieldUpdater(j… 라벨이 있는 보라색 또는 녹색 상자)에 대한 빈번한 호출입니다. 각 호출은 비교적 빠르지만 빈도가 우려됩니다. 여러 호출에 분산된 무시할 수 없는 오버헤드가 합쳐져 눈에 띄는 회귀가 발생할 수 있습니다. 호출을 확대하면 대부분의 시간이 리플렉션 검사에 소요되는 것을 알 수 있습니다.
코루틴은 구조화된 동시 실행을 가능하게 하는 상위-하위 관계를 위해 잠금 없는 트리 구조를 구현합니다. kotlinx.atomicfu 라이브러리는 잘 알려진 JVM 프리미티브인 AtomicReferenceFieldUpdater를 사용하여 잠금 없는 원자적 작업을 구현합니다. 업데이터는 클래스 참조와 필드 이름을 사용하여 런타임에 원자적 작업을 실행하며, 필드가 존재하고 액세스 가능한지 확인하기 위해 여러 리플렉션 안전 검사를 실행해야 합니다. 코루틴의 각 작업(시작, 정지, 취소, 완료)은 하나 이상의 원자적 작업을 호출하므로 속도가 느리면 코루틴이 제대로 작동하지 않습니다.
AtomicReferenceFieldUpdater 조사
하지만 너무 앞서가지는 않겠습니다. AtomicReferenceFieldUpdater는 실제로 10년 넘게 JVM에서 잘 최적화되어 있으며 메서드 트레이스는 VM 수준 최적화(JIT(Just-In-Time) 또는 AOT(Ahead-Of-Time) 컴파일)로 완전히 삭제된 오버헤드를 캡처할 수 있습니다. 성능을 확인하기 위해 kotlinx.atomicfu와 java.util.concurrent.atomic의 원자 참조 간의 차이를 측정하는 몇 가지 벤치마크를 작성해 보겠습니다.
@RunWith(AndroidJUnit4::class)
class AtomicReferenceBenchmark {
    @get:Rule
    val benchmarkRule = BenchmarkRule()

    private val atomicReference = java.util.concurrent.atomic.AtomicReference(false)
    private val atomicRef = kotlinx.atomicfu.atomic<Boolean>(false)

    @Test
    fun atomicReference_compareAndSet() {
        benchmarkRule.measureRepeated {
            atomicReference.compareAndSet(true, false)
            atomicReference.compareAndSet(false, true)
        }
    }

     @Test
    fun atomicRef_compareAndSet() {
        benchmarkRule.measureRepeated {
            atomicRef.compareAndSet(true, false)
            atomicRef.compareAndSet(false, true)
        }
    }

    /* measuring other methods from the method traces above */
}
Pixel 5에서 이 벤치마크를 실행하면(준비 중에 AtomicReferenceFieldUpdater#compareAndSet가 JIT 컴파일되도록 함) Pixel 5(API 33)에서 다음과 같은 결과가 생성됩니다.
 50.7 ns  atomicReference_compareAndSet
135   ns  atomicRef_compareAndSet
측정 결과, kotlinx.atomicfu 버전이 약 2.7배 느린 것으로 나타났습니다. 이는 ART가 숨겨진 최적화를 실행하지 않으며 리플렉션 액세스 검사가 런타임 중에 실제 오버헤드를 추가한다는 것을 확인해 줍니다.
원래 메서드 트레이스를 다시 살펴보면 AtomicReferenceFieldUpdater에서 수행하는 유일한 의미 있는 작업은 실제로 기본 원자성 작업을 실행하는 Unsafe.getObjectVolatile에 대한 내부 호출입니다. 대부분의 경우 업데이트 프로그램 이니셜라이저는 정적이며 주변 클래스의 구조에 따라 항상 올바른 것으로 입증될 수 있습니다. 따라서 대부분의 AtomicReferenceFieldUpdater 사용을 정적으로 분석하고 컴파일 중에 내부 Unsafe 변형으로 대체할 수 있습니다. Android 빌드 도구 모음에는 바로 이 작업을 수행할 수 있는 자체 최적화 컴파일러가 있습니다.
R8을 사용한 최적화
Atomic*FieldUpdater 클래스는 미묘하고 동적이며 리플렉션 기반의 사용을 지원하지만 정적으로 명확한 패턴에서 사용되는 경우가 많습니다. 이는 기준 성능이 느린 이유와 최적화가 필요한 이유를 모두 설명합니다. R8은 전체 프로그램을 최적화하는 컴파일러로, 더 간단한 패턴을 통해 리플렉션 안전 검사의 오버헤드를 줄이는 데 적합합니다. R8은 자바 또는 Kotlin 컴파일러 이후에 JVM 바이트 코드를 수신하지만 가독성을 높이기 위해 이러한 예는 자바 문법으로 표시됩니다. 따라서 AtomicReferenceFieldUpdater에는 유형 인수가 없습니다.
class Example {
    volatile String data = "";
    static final AtomicReferenceFieldUpdater updater =
        AtomicReferenceFieldUpdater.newUpdater(Example.class, String.class, "data");

    void example() {
        // ...
        updater.compareAndSet(this, "", "new");
        // ...
    }
}
기본 예시에서는 홀더, 유형, 필드 이름에 대한 간단한 상수 인수를 사용하여 휘발성 필드에 액세스하는 정적 최종 업데이터를 만듭니다. 사용된 반사는 완전히 투명합니다. 이 업데이트 도구는 유효한 필드를 참조하며 업데이트 도구 생성 사이트에서 필드에 유효하게 액세스할 수 있습니다.
기본적으로 Atomic*FieldUpdater는 필드 오프셋과 Unsafe 호출을 둘러싼 래퍼입니다. 최적화를 위한 가장 좋은 시나리오는 updater 필드를 offset 필드로 바꾸고 updater 호출을 Unsafe 호출로 바꾸는 것입니다.
Atomic*FieldUpdater 최적화
최적화는 계측, 교체, 정리의 세 부분으로 구현됩니다.
계측
첫 번째 단계는 Unsafe 호출을 통해 직접 액세스할 수 있도록 업데이트 도구 필드와 함께 오프셋 필드를 도입하는 것입니다.
static final long updater$offset =
    SyntheticUnsafe.UNSAFE.objectFieldOffset(Example.class.getDeclaredField("data"))
필드는 리플렉션을 통해 액세스되며 Unsafe는 클래스의 필드 오프셋을 추출하는 데 사용됩니다. 이 코드는 리플렉션 유효성 검사를 무시하는 경우 Atomic*FieldUpdater 의 내부를 나타냅니다. 대신 업데이트 도구의 홀더 유형과 휘발성 필드의 필드 유형이 컴파일러에서 정적으로 추적됩니다.
원래 필드와 초기화는 그대로 유지됩니다. 최적화 프로세스는 사용을 낙관적으로 촉진하고 최적화한 다음 나중에 정리합니다. 이는 구현에 대한 간단한 접근 방식이지만, 일부 사용은 그대로 두고 다른 사용은 최적화하는 등 업데이트 도구 필드의 부분적인 최적화도 가능합니다.
대체
컴파일러의 이 시점에서 적절한 동시 실행 조인 지점 이후에 계측된 업데이터 필드 목록이 있습니다. 즉, 몇 가지 조건에 따라 각 호출 사이트를 개별적으로 최적화할 수 있습니다. 다음 호출 예시를 살펴보세요.
updater.compareAndSet(holder, expectedValue, newValue);
Atomic*FieldUpdater에 필요한 조건은 다음과 같습니다.
updater이 계측된 필드에서 가져온 것인가요? 즉, 정적 분석이 객체의 값을 계측된 업데이터의 필드 읽기로 다시 추적할 수 있나요?holder가 원래 정의된 홀더 유형과 동일한 클래스 또는 서브클래스인가요?newValue가 원래 정의된 필드 유형과 동일한 클래스 또는 서브클래스인가요?
모든 조건이 충족되면 호출이 리플렉션 검사 없이 Unsafe 호출로 대체됩니다.
SyntheticUnsafe.UNSAFE.compareAndSwapObject(holder, Example.updater$offset, expectedValue, newValue)
이 새로운 호출은 더 빠르고 간단하지만 updater 및 holder의 null 값 처리와 관련하여 원래 호출과 다릅니다. 정적으로 제외되지 않는 한 두 경우 모두 null 검사가 삽입됩니다.
삭제
이 시점에서 홀딩 클래스에는 원래 업데이트 도구 필드와 새 오프셋 필드가 있으며, 둘 중 하나를 사용할 수 있는 호출 사이트도 있습니다. 최적화된 호출 사이트가 없으면 오프셋 필드를 삭제해야 하고, 모든 호출 사이트가 최적화된 경우에는 업데이트 도구 필드를 삭제해야 합니다. 두 경우 모두 초기화 호출도 삭제해야 합니다. 사용되지 않는 필드와 불량 코드 삭제는 이미 컴파일러에서 완료되었지만 여기에서 초기화 코드를 삭제하려면 몇 가지 트릭이 더 필요합니다.
newUpdater 및 getDeclaredField 호출은 모두 예외를 발생시킬 수 있으므로 부작용이 있을 수 있습니다(API 버전에 따라 구현도 알 수 없음). 즉, 일반적인 최적화로는 안전하게 삭제할 수 없습니다. 따라서 이 정리 작업에서는 계측된 필드가 예외가 없는 것으로 정적으로 알려져 있으므로 이를 명시적으로 고려해야 했습니다.
결국 위에 표시된 간단한 업데이트 도구 예시는 최적화 후 다음과 같이 표시됩니다.
결과
이러한 최적화 후 kotlinx.atomicfu 및 대부분의 명시적 AtomicInt/Long/ReferenceFieldUpdater 사용은 이제 R8이 적용된 AtomicReference 성능과 일치합니다. 실제로 일부 벤치마크에서는 더 빠릅니다. kotlinx.atomicfu에는 atomic 인스턴스를 필드에 인라인하여 원자적으로 업데이트된 필드를 만드는 데 필요한 할당을 줄일 수 있는 컴파일러 플러그인이 있습니다.
이 작업의 주요 수혜자는 Jetpack Compose였습니다. Compose 런타임에는 코루틴 성능을 매우 면밀하게 추적하여 성능 저하를 조기에 포착하는 여러 마이크로벤치마크가 있습니다. 벤치마크가 새로운 버전의 R8로 업데이트되었을 때 LaunchedEffect에서 코루틴을 실행하고 취소하는 속도가 2배 향상되었습니다.
그 외에도 ART팀은 VM 수준에서 이러한 최적화를 기본적으로 구현하고 있습니다. 앱이 API 36을 타겟팅하고 최신 버전의 Android에서 실행되는 경우 기기에서 이미 비슷한 방식으로 코루틴을 최적화하고 있을 수 있습니다. 위의 코루틴 벤치마크에서는 최근 ART 버전의 JIT 업데이트 후 성능이 약 15% 개선된 것으로 나타났습니다.
AGP 9.2.0으로 업그레이드하거나 R8 9.2.0을 직접 사용하면 앱에 이 최적화가 기본적으로 적용됩니다. 자세한 내용은 D8 dexer 및 R8 축소 도구를 참고하세요.
-
 우수사례
금융 및 SIM 등록을 위한 본인 인증 앱은 스푸핑과 딥페이크를 감지하기 위해 선명한 고해상도 얼굴 캡처가 필요합니다. 메모리가 부족한 기기를 다운시키지 않으면서 생체 인식 및 스푸핑 방지 검사에 충분히 선명한 프레임을 캡처하는 것은 Android 카메라 개발자에게 일반적인 과제입니다.
Donovan McMurray • 읽는 데 4분 소요 -
 우수사례
Grab은 동남아시아의 선도적인 슈퍼 앱으로, 하나의 앱을 통해 8개 국가의 수백만 명의 사용자에게 배송, 모빌리티, 금융 서비스를 제공합니다.
Ajesh Pai, Nguyen Van Minh, Tracy Agyemang • 읽는 데 5분 소요 -
 우수사례
이 팀은 원래 구현보다 50% 작은 AI 기반 UI 코드베이스를 구축하는 동시에 AI 에이전트 실행 시간을 35% 단축하고, 엔지니어와 에이전트 간의 상호작용을 32% 줄이고, 토큰 비용을 33% 절감했습니다.
Pavlo Stavytskyi, Rebecca Franks • 읽는 데 11분 소요
Android 개발 관련 최신 정보를 이메일로 받아 보세요.