Начиная с AGP 9.2.0, R8 оптимизирует большинство вызовов Atomic*FieldUpdater в варианты Unsafe, которые в 2–4 раза эффективнее выполняют распространенные операции. Это особенно заметно в библиотеке kotlinx.atomicfu, которая реализует атомарные операции для kotlinx.coroutines. Запуск и отмена сопрограмм теперь выполняются в два раза быстрее. Чтобы воспользоваться преимуществами, обновите AGP до версии 9.2.0 или более поздней.
Поскольку Kotlin стал основным языком для большинства приложений Android, kotlinx.coroutines стала стандартом де-факто для асинхронного программирования. Библиотека предлагает хорошо продуманный и структурированный способ управления параллельными потоками, который является нативным для Kotlin. Jetpack Compose не стал исключением: в нем сопрограммы используются для управления событиями указателя, анимацией и другими взаимодействиями. На момент написания статьи большинство параллельных API в Compose вызывают функции suspend и запускают и/или отменяют сопрограммы для обработки обновлений.
Когда команда Compose начала исследовать производительность, сопрограммы были обнаружены как узкое место для многих операций, происходящих вне композиции. Например, 80% времени, затраченного на создание и обновление Modifier.clickable, уходило на запуск и отмену внутренних сопрограмм, которые обрабатывали обновления InteractionSource. Основываясь на этих наблюдениях, большая часть ранней работы по повышению производительности была сосредоточена на удалении сопрограмм из пути по умолчанию и задержке инициализации до тех пор, пока это не станет необходимым.
Стоимость сопрограммы
Самый простой способ проанализировать внутреннее поведение функции на Android – записать трассировку метода Android Runtime (ART). Трассировка метода ART – это инструмент, который записывает процесс выполнения приложения, показывая, какие именно методы вызываются, в каком порядке и сколько времени занимает каждый из них. Это позволяет разработчикам выявлять узкие места в производительности. Для пустого вызова LaunchedEffect { } это будет выглядеть примерно так:
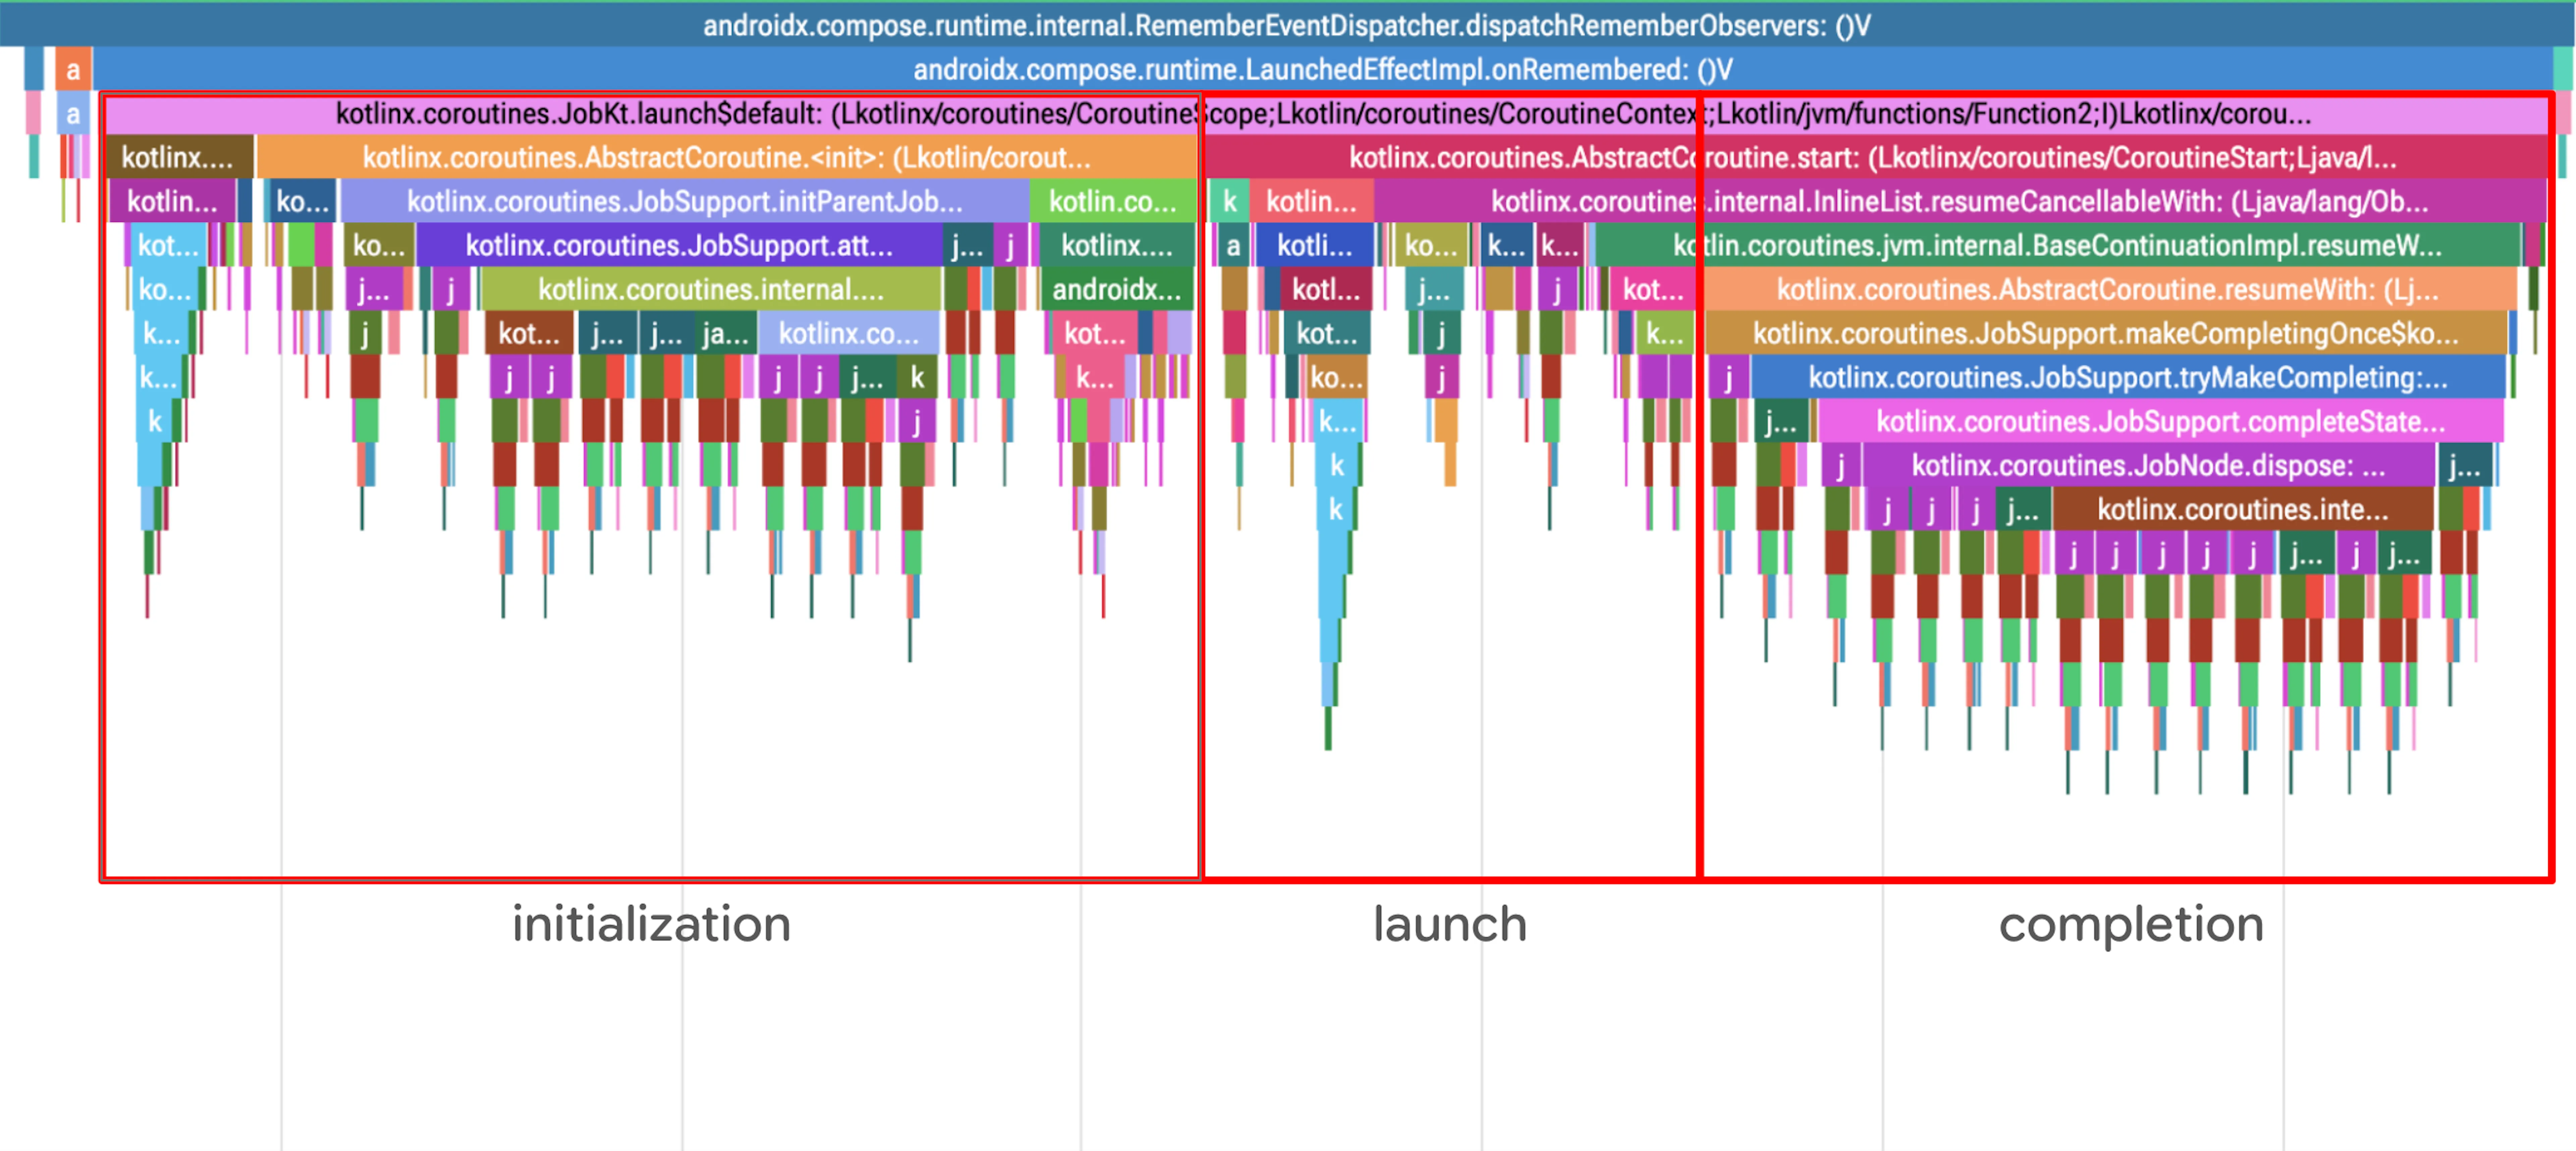
Трассировку метода выше можно разделить на три части:
- Инициализация новой сопрограммы
- Запуск сопрограммы
- Завершение сопрограммы (поскольку она сразу же завершается)
Отмена LaunchedEffect похожа на обычное завершение, но при этом также создается CancellationException.
В профиле выше сразу же вызывают подозрение частые вызовы java.util.concurrent.AtomicReferenceFieldUpdater (фиолетовые или зеленые поля с метками j…). Хотя каждый вызов происходит относительно быстро, частота вызовов вызывает беспокойство. Любые нетривиальные накладные расходы, распределенные по нескольким вызовам, могут привести к заметному регрессу. Приблизив вызов, мы видим, что большая часть времени уходит на… проверку отражений?
Сопрограммы реализуют древовидную структуру без блокировок для отношений родитель-потомок, что делает возможным структурированный параллелизм. Оказалось, что библиотека kotlinx.atomicfu реализует неблокирующие атомарные операции с помощью хорошо известного примитива JVM – AtomicReferenceFieldUpdater. Для выполнения атомарных операций во время выполнения программа обновления использует ссылку на класс и имя поля. Чтобы убедиться, что поле существует и доступно, она должна выполнить несколько проверок безопасности. Каждая операция в сопрограммах (запуск, приостановка, отмена, завершение) вызывает по крайней мере одну атомарную операцию, поэтому, если она выполняется медленно, сопрограммы не будут работать хорошо.
Investigating AtomicReferenceFieldUpdater
Но не будем забегать вперед. AtomicReferenceFieldUpdater хорошо оптимизирован для JVM уже более 10 лет, а трассировка метода может зафиксировать накладные расходы, которые полностью устраняются оптимизацией на уровне виртуальной машины: JIT- или AOT-компиляцией. Чтобы проверить производительность, давайте напишем несколько тестов для измерения разницы между атомарными ссылками из kotlinx.atomicfu и java.util.concurrent.atomic.
@RunWith(AndroidJUnit4::class)
class AtomicReferenceBenchmark {
    @get:Rule
    val benchmarkRule = BenchmarkRule()

    private val atomicReference = java.util.concurrent.atomic.AtomicReference(false)
    private val atomicRef = kotlinx.atomicfu.atomic<Boolean>(false)

    @Test
    fun atomicReference_compareAndSet() {
        benchmarkRule.measureRepeated {
            atomicReference.compareAndSet(true, false)
            atomicReference.compareAndSet(false, true)
        }
    }

     @Test
    fun atomicRef_compareAndSet() {
        benchmarkRule.measureRepeated {
            atomicRef.compareAndSet(true, false)
            atomicRef.compareAndSet(false, true)
        }
    }

    /* measuring other methods from the method traces above */
}
При запуске этого теста на Pixel 5 (с JIT-компиляцией AtomicReferenceFieldUpdater#compareAndSet во время прогрева) на Pixel 5 (API 33) получаются следующие результаты:
 50.7 ns  atomicReference_compareAndSet
135   ns  atomicRef_compareAndSet
Измерения подтверждают разрыв: версия kotlinx.atomicfu примерно в 2, 7 раза медленнее. Это подтверждает, что ART не выполняет скрытую оптимизацию и что проверки доступа к рефлексии действительно создают дополнительную нагрузку во время выполнения.
Если вернуться к исходной трассировке метода, то единственная значимая работа, выполняемая AtomicReferenceFieldUpdater, – это внутренний вызов Unsafe.getObjectVolatile, который фактически выполняет базовую атомарную операцию. В большинстве случаев инициализатор обновления является статическим и может быть доказан как всегда правильный на основе структуры окружающего класса. Таким образом, можно было бы статически проанализировать большинство случаев использования AtomicReferenceFieldUpdater и заменить их внутренним вариантом Unsafe во время компиляции. В тулчейне сборки Android есть оптимизирующий компилятор, который может это сделать.
Оптимизация с помощью R8
Классы Atomic*FieldUpdater поддерживают тонкое, динамическое и основанное на рефлексии использование, но часто используются в статически очевидных шаблонах. Это объясняет как низкую производительность базовой версии, так и необходимость оптимизации. R8 – это оптимизирующий компилятор, который может распознавать простые шаблоны и снижать нагрузку на систему при проверках безопасности. R8 получает байт-код JVM после компилятора Java или Kotlin, но для удобства чтения эти примеры представлены в синтаксисе Java. Поэтому у AtomicReferenceFieldUpdater нет аргументов типа.
class Example {
    volatile String data = "";
    static final AtomicReferenceFieldUpdater updater =
        AtomicReferenceFieldUpdater.newUpdater(Example.class, String.class, "data");

    void example() {
        // ...
        updater.compareAndSet(this, "", "new");
        // ...
    }
}
В базовом примере создается статический финальный объект обновления, который обращается к переменному полю с простыми постоянными аргументами для держателя, типа и имени поля. Отражение полностью прозрачно. Очевидно, что этот метод обновления ссылается на допустимое поле и что сайт, на котором он создан, имеет допустимый доступ к полю.
По сути, Atomic*FieldUpdater – это оболочка для смещения поля и вызовов Unsafe. В лучшем случае оптимизация заключается в замене поля updater полем offset и замене вызовов updater вызовами Unsafe.
Оптимизация Atomic*FieldUpdater
Оптимизация выполняется в три этапа: инструментирование, замена и очистка.
На базе Instrumentation
Сначала нужно добавить поля смещения рядом с полем обновления, чтобы упростить прямой доступ через Unsafe call.
static final long updater$offset =
    SyntheticUnsafe.UNSAFE.objectFieldOffset(Example.class.getDeclaredField("data"))
Доступ к полю осуществляется через рефлексию, а Unsafe используется для извлечения смещения поля в классе. Этот код представляет внутренние компоненты Atomic*FieldUpdater , если не учитывать проверку отражения. Вместо этого тип держателя средства обновления и тип поля volatile отслеживаются статически в компиляторе.
Обратите внимание, что исходное поле и его инициализация остаются без изменений. Процесс оптимизации оптимистично облегчает и оптимизирует использование, а затем выполняет очистку. Это простой подход к реализации, который также позволяет частично оптимизировать поля обновления, когда некоторые варианты использования остаются без изменений, а другие оптимизируются.
Замена
На этом этапе компиляции, после подходящей точки соединения параллельных процессов, у нас есть список полей обновлений, в которые добавлены инструменты. Это означает, что мы можем оптимизировать каждый сайт вызова отдельно на основе нескольких условий. Рассмотрим пример вызова:
updater.compareAndSet(holder, expectedValue, newValue);
Для работы Atomic*FieldUpdater должны выполняться следующие условия:
- Поступает ли
updaterиз поля, в котором ведется сбор данных? То есть может ли статический анализ отследить значение объекта до чтения поля инструментированного средства обновления? - Является ли
holderтем же классом или подклассом исходно заданного типа держателя? - Является ли
newValueтем же классом или подклассом изначально определенного типа поля?
Если все условия выполнены, вызов заменяется вызовом Unsafe без проверок отражения.
SyntheticUnsafe.UNSAFE.compareAndSwapObject(holder, Example.updater$offset, expectedValue, newValue)
Новый вызов быстрее и проще, но он отличается от исходного тем, как обрабатывает нулевые значения в updater и holder. Если не исключено статически, проверки на null вставляются для обоих.
Удаление некорректных заявок
На этом этапе в классе-контейнере есть исходное поле updater и новое поле offset, а также места вызова, в которых может использоваться любое из этих полей. Если ни один из сайтов вызова не был оптимизирован, то поле offset должно быть удалено, а если все сайты вызова были оптимизированы, то должно быть удалено поле updater. В обоих случаях вызов инициализации также должен быть удален. Удаление неиспользуемых полей и неработающего кода уже выполнено в компиляторе, но удаление кода инициализации здесь требует ещё нескольких ухищрений.
Вызовы newUpdater и getDeclaredField могут иметь побочные эффекты, поскольку они могут вызывать исключения (их реализация также неизвестна, поскольку зависит от версии API). Это означает, что их нельзя безопасно удалить с помощью общей оптимизации. Поэтому при очистке требовалось явное рассмотрение инструментированных полей, поскольку статически известно, что они не содержат исключений.
В итоге простой пример обновления, показанный выше, после оптимизации выглядит следующим образом:
Результаты
После этих оптимизаций kotlinx.atomicfu и большинство явных использований AtomicInt/Long/ReferenceFieldUpdater теперь соответствуют производительности AtomicReference с примененным R8. В некоторых тестах он даже быстрее. В kotlinx.atomicfu есть плагин компилятора, который может встраивать экземпляры atomic в поля, сокращая количество выделений, необходимых для создания атомарно обновляемого поля.
Главным бенефициаром этой работы стал Jetpack Compose. В среде выполнения Compose есть несколько микротестов, которые тщательно отслеживают производительность сопрограмм, чтобы выявлять регрессии на ранних этапах. Когда мы обновили тесты до новой версии R8, то заметили, что запуск и отмена сопрограмм в LaunchedEffect стали выполняться в два раза быстрее.
Кроме того, команда ART реализует эти оптимизации на уровне виртуальной машины. Если ваше приложение предназначено для API 36 и работает на одной из последних версий Android, возможно, ваше устройство уже оптимизирует сопрограммы аналогичным образом. Тесты сопрограмм, описанные выше, показали улучшение производительности примерно на 15% после обновления JIT в последних версиях ART.
Ваше приложение будет оптимизировано по умолчанию при обновлении до AGP 9.2.0 или при использовании R8 9.2.0 напрямую. Подробнее о компиляторе D8 и инструменте R8…
-
 Истории успеха
Grab – ведущее суперприложение в Юго-Восточной Азии, которое предлагает услуги доставки, мобильности и финансовые услуги миллионам пользователей в восьми странах.
Ajesh Pai, Nguyen Van Minh, Tracy Agyemang • Время на чтение: 5 минут -
 Истории успеха
Команда создала базу кода для ИИ-интерфейса, которая на 50% меньше исходной реализации. При этом время выполнения ИИ-агента сократилось на 35 %, количество обменов между инженером и агентом – на 32 %, а стоимость токенов – на 33 %.
Pavlo Stavytskyi, Rebecca Franks • Время на чтение: 11 минут -
 Истории успеха
WhatsApp – крупнейшая в мире платформа для обмена сообщениями, которой пользуются миллиарды людей по всему миру. Это стандартный инструмент для общения людей в разных регионах, который позволяет обмениваться сообщениями конфиденциально, надежно и безопасно.
Niharika Arora, Tracy Agyemang, Mayank Jain • Чтение займет 8 минут
Получайте еженедельную рассылку с последними новостями о разработке для Android.