ตั้งแต่ AGP 9.2.0 เป็นต้นไป R8 จะเพิ่มประสิทธิภาพการเรียก Atomic*FieldUpdater ส่วนใหญ่ให้เป็นตัวแปร Unsafe ซึ่งทำงานได้ดีขึ้น 2-4 เท่าในการดำเนินการทั่วไป ซึ่งส่งผลอย่างมากต่อไลบรารี kotlinx.atomicfu ที่ใช้ Atomics สำหรับ kotlinx.coroutines ทำให้การเปิดและยกเลิก Coroutine เร็วขึ้นสูงสุด 2 เท่า หากต้องการรับสิทธิประโยชน์ ให้อัปเดต AGP เป็น 9.2.0 ขึ้นไป
เนื่องจากแอป Android ส่วนใหญ่ใช้ Kotlin เป็นภาษาหลัก kotlinx.coroutines จึงกลายเป็นมาตรฐานโดยพฤตินัยสำหรับการเขียนโปรแกรมแบบอะซิงโครนัส ไลบรารีนี้มีวิธีจัดการโฟลว์ที่เกิดขึ้นพร้อมกันซึ่งออกแบบมาอย่างดีและมีโครงสร้างที่เหมาะกับ Kotlin Jetpack Compose ก็ไม่มีข้อยกเว้น โดยใช้โครูทีนเพื่อจัดการเหตุการณ์ตัวชี้ ภาพเคลื่อนไหว และการโต้ตอบอื่นๆ ในขณะที่เขียน API ที่เกิดขึ้นพร้อมกันส่วนใหญ่ใน Compose จะเรียกใช้ฟังก์ชัน suspend เบื้องหลัง และกำลังเปิดและ/หรือยกเลิกโครูทีนเพื่อจัดการการอัปเดต
เมื่อทีม Compose เริ่มตรวจสอบประสิทธิภาพ ก็พบว่า Coroutine เป็นจุดคอขวดสำหรับการดำเนินการหลายอย่างที่เกิดขึ้นนอก Composition ตัวอย่างเช่น 80% ของเวลาที่ใช้ในการสร้างและอัปเดต Modifier.clickable ถูกใช้ไปกับการเปิดและยกเลิก Coroutine ภายในที่จัดการการอัปเดต InteractionSource จากการสังเกตการณ์เหล่านั้น งานด้านประสิทธิภาพในช่วงแรกๆ ส่วนใหญ่จึงมุ่งเน้นไปที่การนำโครูทีนออกจากเส้นทางเริ่มต้นและเลื่อนการเริ่มต้นออกไปจนกว่าจะจำเป็น
ต้นทุนของโครูทีน
วิธีที่ง่ายที่สุดในการวิเคราะห์ลักษณะการทำงานภายในของฟังก์ชันใน Android คือการบันทึกร่องรอยเมธอด Android Runtime (ART) ร่องรอยเมธอด ART เป็นเครื่องมือที่บันทึกขั้นตอนการดำเนินการของแอป โดยแสดงเมธอดที่เรียกใช้ ลำดับ และเวลาที่ใช้ในแต่ละเมธอดอย่างชัดเจน ซึ่งช่วยให้นักพัฒนาแอปสามารถระบุจุดคอขวดด้านประสิทธิภาพได้ สำหรับการเรียก LaunchedEffect { } ที่ว่างเปล่า จะมีลักษณะดังนี้
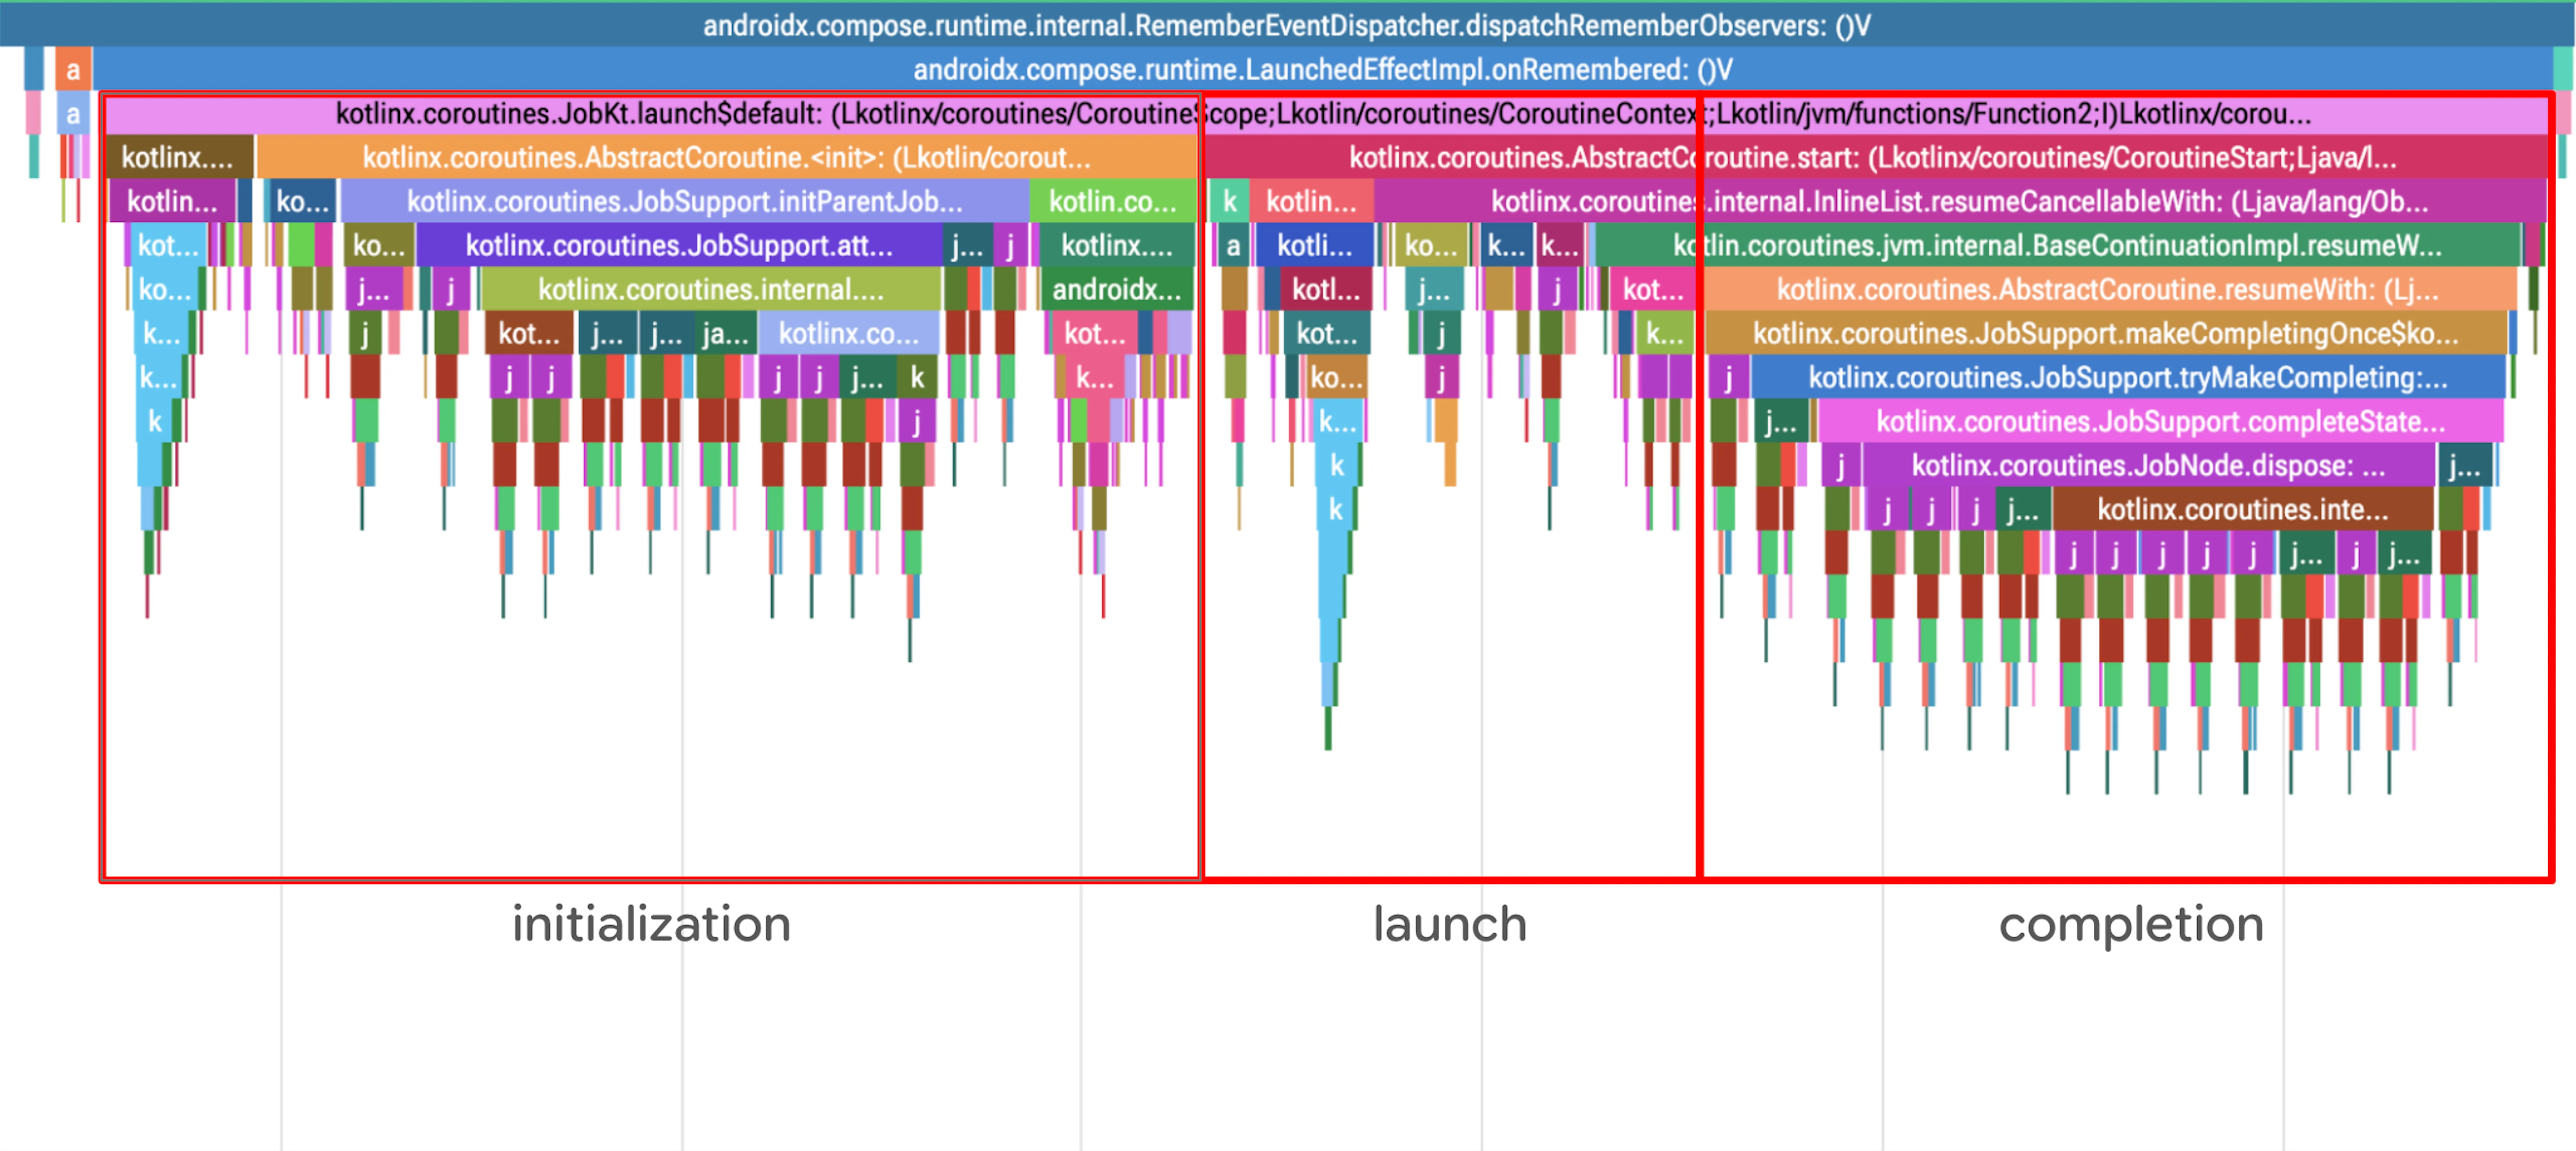
ร่องรอยเมธอดด้านบนแบ่งออกเป็น 3 ส่วนได้ดังนี้
- กำลังเริ่มต้น Coroutine ใหม่
- กำลังเริ่ม Coroutine
- กำลังดำเนินการ Coroutine ให้เสร็จสมบูรณ์ (เนื่องจากจะออกทันที)
การยกเลิก LaunchedEffect คล้ายกับการดำเนินการเสร็จสมบูรณ์ตามปกติ ยกเว้นว่าจะสร้าง CancellationException ด้วย
จากโปรไฟล์ด้านบน สิ่งหนึ่งที่น่าสงสัยทันทีคือการโทรเข้า java.util.concurrent.AtomicReferenceFieldUpdater บ่อยครั้ง (กล่องสีม่วงหรือสีเขียวที่มีป้ายกำกับ j…) แม้ว่าการเรียกแต่ละครั้งจะค่อนข้างเร็ว แต่ความถี่ก็น่ากังวล เนื่องจากค่าใช้จ่ายเพิ่มเติมที่ไม่สามารถละเลยได้ซึ่งกระจายอยู่ในการเรียกใช้หลายครั้งอาจรวมกันเป็นความถดถอยที่สังเกตเห็นได้ เมื่อซูมเข้าไปดูการโทรจะเห็นว่าเวลาส่วนใหญ่ใช้ไปกับการ... ตรวจสอบการสะท้อนแสง
โครูทีนใช้โครงสร้างต้นไม้แบบไม่มีการล็อกสำหรับความสัมพันธ์หลัก-ย่อย ซึ่งทำให้เกิดการทำงานพร้อมกันแบบมีโครงสร้าง ปรากฏว่าไลบรารี kotlinx.atomicfu ใช้การดำเนินการแบบอะตอมที่ไม่มีการล็อกโดยใช้ AtomicReferenceFieldUpdater ซึ่งเป็น JVM พื้นฐานที่รู้จักกันดี ตัวอัปเดตจะใช้การอ้างอิงคลาสและชื่อฟิลด์เพื่อดำเนินการแบบอะตอมมิกที่รันไทม์ และต้องเรียกใช้การตรวจสอบความปลอดภัยแบบสะท้อนหลายครั้งเพื่อให้แน่ใจว่าฟิลด์มีอยู่และเข้าถึงได้ การดำเนินการแต่ละอย่างในโครูทีน (การเริ่มต้น การระงับ การยกเลิก การทำให้เสร็จสมบูรณ์) จะเรียกใช้การดำเนินการแบบอะตอมอย่างน้อย 1 รายการ ดังนั้นหากการดำเนินการแบบอะตอมช้า โครูทีนจะทำงานได้ไม่ดี
การตรวจสอบ AtomicReferenceFieldUpdater
แต่เราอย่าเพิ่งคิดไปไกล จริงๆ แล้ว AtomicReferenceFieldUpdater ได้รับการเพิ่มประสิทธิภาพอย่างดีใน JVM มานานกว่า 10 ปีแล้ว และร่องรอยเมธอดอาจบันทึกโอเวอร์เฮดที่ถูกนำออกโดยสมบูรณ์ด้วยการเพิ่มประสิทธิภาพระดับ VM ซึ่งก็คือการคอมไพล์แบบ Just-In-Time (JIT) หรือ Ahead-Of-Time (AOT) หากต้องการยืนยันประสิทธิภาพ เรามาเขียนการเปรียบเทียบเพื่อวัดความแตกต่างระหว่างการอ้างอิงแบบอะตอมจาก kotlinx.atomicfu และ java.util.concurrent.atomic กัน
@RunWith(AndroidJUnit4::class)
class AtomicReferenceBenchmark {
    @get:Rule
    val benchmarkRule = BenchmarkRule()

    private val atomicReference = java.util.concurrent.atomic.AtomicReference(false)
    private val atomicRef = kotlinx.atomicfu.atomic<Boolean>(false)

    @Test
    fun atomicReference_compareAndSet() {
        benchmarkRule.measureRepeated {
            atomicReference.compareAndSet(true, false)
            atomicReference.compareAndSet(false, true)
        }
    }

     @Test
    fun atomicRef_compareAndSet() {
        benchmarkRule.measureRepeated {
            atomicRef.compareAndSet(true, false)
            atomicRef.compareAndSet(false, true)
        }
    }

    /* measuring other methods from the method traces above */
}
การเรียกใช้การเปรียบเทียบนี้ใน Pixel 5 (ขณะที่ตรวจสอบว่า AtomicReferenceFieldUpdater#compareAndSet ได้รับการคอมไพล์ JIT ในระหว่างการวอร์มอัป) จะให้ผลลัพธ์ต่อไปนี้ใน Pixel 5 (API 33)
 50.7 ns  atomicReference_compareAndSet
135   ns  atomicRef_compareAndSet
การวัดผลยืนยันช่องว่างดังกล่าว โดยเวอร์ชัน kotlinx.atomicfu ช้ากว่าอย่างเห็นได้ชัดประมาณ 2.7 เท่า ซึ่งเป็นการยืนยันว่า ART ไม่ได้ทำการเพิ่มประสิทธิภาพที่ซ่อนอยู่ และการตรวจสอบการเข้าถึงแบบสะท้อนจะเพิ่มโอเวอร์เฮดจริงในระหว่างรันไทม์
เมื่อย้อนกลับไปดูร่องรอยเมธอดเดิม งานที่มีความหมายเพียงอย่างเดียวที่ AtomicReferenceFieldUpdater ทำคือการเรียกใช้ภายในไปยัง Unsafe.getObjectVolatile ซึ่งดำเนินการการดำเนินการระดับอะตอมที่สำคัญจริงๆ ในกรณีส่วนใหญ่ ตัวเริ่มต้นของตัวอัปเดตจะเป็นแบบคงที่ และสามารถพิสูจน์ได้ว่าถูกต้องเสมอโดยอิงตามโครงสร้างของคลาสที่อยู่รอบๆ ดังนั้น เราจึงสามารถวิเคราะห์การใช้งาน AtomicReferenceFieldUpdater ส่วนใหญ่แบบคงที่และแทนที่ด้วยตัวแปร Unsafe ภายในระหว่างการคอมไพล์ได้ นอกจากนี้ Toolchain ของบิลด์ Android ยังมีคอมไพเลอร์เพิ่มประสิทธิภาพของตัวเองที่ทำสิ่งนั้นได้ด้วย
การเพิ่มประสิทธิภาพด้วย R8
คลาส Atomic*FieldUpdater รองรับการใช้งานที่ละเอียดอ่อน ไดนามิก และอิงตามการสะท้อน แต่ก็มักใช้ในรูปแบบที่ชัดเจนแบบคงที่ ซึ่งอธิบายได้ทั้งประสิทธิภาพพื้นฐานที่ช้าและความต้องการเพิ่มประสิทธิภาพ R8 เป็นคอมไพเลอร์เพิ่มประสิทธิภาพทั้งโปรแกรมและเหมาะอย่างยิ่งสำหรับการดูผ่านรูปแบบที่ง่ายกว่าเพื่อลดค่าใช้จ่ายเพิ่มเติมของการตรวจสอบความปลอดภัยแบบสะท้อน R8 จะได้รับ JVM Bytecode หลังจากคอมไพเลอร์ Java หรือ Kotlin แต่เพื่อให้อ่านง่าย ตัวอย่างเหล่านี้จะแสดงในไวยากรณ์ Java ด้วยเหตุนี้จึงไม่มีอาร์กิวเมนต์ประเภทสำหรับ AtomicReferenceFieldUpdater
class Example {
    volatile String data = "";
    static final AtomicReferenceFieldUpdater updater =
        AtomicReferenceFieldUpdater.newUpdater(Example.class, String.class, "data");

    void example() {
        // ...
        updater.compareAndSet(this, "", "new");
        // ...
    }
}
ตัวอย่างพื้นฐานจะสร้างตัวอัปเดตแบบคงที่ขั้นสุดท้ายซึ่งเข้าถึงฟิลด์ที่ผันผวนด้วยอาร์กิวเมนต์ค่าคงที่แบบง่ายสำหรับตัวยึด ประเภท และชื่อของฟิลด์ การสะท้อนที่ใช้มีความโปร่งใสอย่างสมบูรณ์ จะเห็นได้ชัดเจนว่าผู้อัปเดตนี้อ้างอิงฟิลด์ที่ถูกต้อง และเว็บไซต์ที่สร้างผู้อัปเดตมีสิทธิ์เข้าถึงฟิลด์ที่ถูกต้อง
โดยพื้นฐานแล้ว Atomic*FieldUpdater เป็น Wrapper รอบออฟเซ็ตฟิลด์และการเรียกไปยัง Unsafe สถานการณ์ที่ดีที่สุดสำหรับการเพิ่มประสิทธิภาพคือการแทนที่ช่องอัปเดตด้วยช่องออฟเซ็ต และแทนที่การเรียกใช้ตัวอัปเดตด้วยการเรียกใช้ Unsafe
การเพิ่มประสิทธิภาพ Atomic*FieldUpdater
การเพิ่มประสิทธิภาพจะดำเนินการใน 3 ส่วน ได้แก่ การใช้เครื่องมือ การแทนที่ และการล้างข้อมูล
การใช้เครื่องมือ
ขั้นตอนแรกคือการแนะนำช่องออฟเซ็ตควบคู่ไปกับช่องอัปเดตเพื่ออำนวยความสะดวกในการเข้าถึงโดยตรงผ่านการเรียก Unsafe
static final long updater$offset =
    SyntheticUnsafe.UNSAFE.objectFieldOffset(Example.class.getDeclaredField("data"))
ระบบจะเข้าถึงฟิลด์ผ่านการสะท้อน และใช้ Unsafe เพื่อดึงออฟเซ็ตของฟิลด์ในคลาส โค้ดนี้แสดงถึงข้อมูลภายในของ Atomic*FieldUpdater หากคุณไม่สนใจการตรวจสอบการสะท้อน แต่ประเภทตัวยึดของตัวอัปเดตและประเภทฟิลด์ของฟิลด์ที่ผันผวนจะได้รับการติดตามแบบคงที่ในคอมไพเลอร์แทน
โปรดทราบว่าฟิลด์เดิมและการเริ่มต้นจะยังคงเหมือนเดิม กระบวนการเพิ่มประสิทธิภาพจะช่วยอำนวยความสะดวกและเพิ่มประสิทธิภาพการใช้งานอย่างเหมาะสม จากนั้นจึงล้างข้อมูลในภายหลัง วิธีนี้เป็นวิธีที่ง่ายในการติดตั้งใช้งาน แต่ก็ช่วยให้เพิ่มประสิทธิภาพช่องอัปเดตบางส่วนได้ โดยที่การใช้งานบางอย่างจะยังคงเหมือนเดิมในขณะที่การใช้งานอื่นๆ ได้รับการเพิ่มประสิทธิภาพ
การแทนที่
ณ จุดนี้ในคอมไพเลอร์ หลังจากจุดเชื่อมต่อการเกิดขึ้นพร้อมกันที่เหมาะสม เราจะมีรายการฟิลด์อัปเดตที่มีการวัดประสิทธิภาพ ซึ่งหมายความว่าเราสามารถเพิ่มประสิทธิภาพเว็บไซต์การโทรแต่ละแห่งแยกกันได้โดยอิงตามเงื่อนไขบางประการ ลองดูตัวอย่างการโทรต่อไปนี้
updater.compareAndSet(holder, expectedValue, newValue);
เงื่อนไขที่ Atomic*FieldUpdater กำหนดมีดังนี้
updaterมาจากช่องที่มีการวัดหรือไม่ กล่าวคือ การวิเคราะห์แบบคงที่สามารถติดตามค่าของออบเจ็กต์กลับไปยังการอ่านฟิลด์ของเครื่องมืออัปเดตที่มีการใช้เครื่องมือวัดได้หรือไม่holderเป็นคลาสเดียวกันหรือคลาสย่อยของประเภทตัวยึดที่กำหนดไว้เดิมหรือไม่newValueเป็นคลาสเดียวกันหรือคลาสย่อยของประเภทฟิลด์ที่กำหนดไว้ตั้งแต่แรกหรือไม่
หากเป็นไปตามเงื่อนไขทั้งหมด ระบบจะแทนที่การเรียกด้วยการเรียกไปยัง Unsafe โดยไม่มีการตรวจสอบการสะท้อนใดๆ
SyntheticUnsafe.UNSAFE.compareAndSwapObject(holder, Example.updater$offset, expectedValue, newValue)
การเรียกใหม่นี้รวดเร็วและง่ายกว่า แต่แตกต่างจากการเรียกเดิมในเรื่องการจัดการค่า Null ใน updater และ holder ระบบจะแทรกการตรวจสอบค่า Null สำหรับทั้ง 2 รายการ เว้นแต่จะตัดออกโดยใช้การวิเคราะห์แบบคงที่
การจัดระเบียบ
ณ จุดนี้ คลาสที่เก็บข้อมูลจะมีฟิลด์อัปเดตดั้งเดิมและฟิลด์ออฟเซ็ตใหม่ พร้อมกับ Call Site ที่อาจใช้ฟิลด์ใดฟิลด์หนึ่งจาก 2 ฟิลด์นี้ หากไม่มีการเพิ่มประสิทธิภาพเว็บไซต์ที่เรียกใช้เลย คุณควรนำช่องออฟเซ็ตออก และหากมีการเพิ่มประสิทธิภาพเว็บไซต์ที่เรียกใช้ทั้งหมด คุณควรนำช่องอัปเดตออก ในทั้ง 2 กรณี คุณควรลบการเรียกใช้การเริ่มต้นด้วย การลบฟิลด์ที่ไม่ได้ใช้และการนำโค้ดที่ไม่ได้ใช้แล้วออกนั้นทำได้ในคอมไพเลอร์อยู่แล้ว แต่การนำโค้ดการเริ่มต้นออกที่นี่ต้องใช้เทคนิคเพิ่มเติมอีกเล็กน้อย
ทั้งการเรียกใช้ newUpdater และ getDeclaredField อาจมีผลข้างเคียงเนื่องจากอาจทำให้เกิดข้อยกเว้น (และไม่ทราบการใช้งานเนื่องจากขึ้นอยู่กับเวอร์ชัน API) ซึ่งหมายความว่าการเพิ่มประสิทธิภาพทั่วไปจะนำไฟล์เหล่านี้ออกอย่างปลอดภัยไม่ได้ ดังนั้น การล้างข้อมูลนี้จึงต้องพิจารณาฟิลด์ที่มีการใช้เครื่องมืออย่างชัดเจน เนื่องจากฟิลด์เหล่านั้นเป็นที่ทราบกันดีว่าไม่มีข้อยกเว้น
ในท้ายที่สุด ตัวอย่างโปรแกรมอัปเดตแบบง่ายที่แสดงด้านบนจะมีลักษณะดังนี้หลังจากการเพิ่มประสิทธิภาพ
ผลลัพธ์
หลังจากการเพิ่มประสิทธิภาพเหล่านี้ kotlinx.atomicfu และการใช้งาน AtomicInt/Long/ReferenceFieldUpdater อย่างชัดเจนส่วนใหญ่จะมีประสิทธิภาพเทียบเท่ากับ AtomicReference เมื่อใช้ R8 อันที่จริงแล้ว ยังเร็วกว่าในบางการเปรียบเทียบด้วยซ้ำ kotlinx.atomicfu มีปลั๊กอินคอมไพเลอร์ที่สามารถแทรกอินสแตนซ์ atomic ลงในฟิลด์ได้ ซึ่งจะช่วยลดการจัดสรรที่จำเป็นในการสร้างฟิลด์ที่อัปเดตแบบอะตอม
Jetpack Compose เป็นผู้ได้รับประโยชน์หลักจากงานนี้ รันไทม์ของ Compose มีการเปรียบเทียบประสิทธิภาพระดับไมโครจำนวนมากที่ติดตามประสิทธิภาพของโครูทีนอย่างใกล้ชิดเพื่อตรวจจับการถดถอยของประสิทธิภาพตั้งแต่เนิ่นๆ เมื่ออัปเดตการเปรียบเทียบเป็น R8 เวอร์ชันใหม่ เราสังเกตเห็นว่าประสิทธิภาพเพิ่มขึ้น 2 เท่าเมื่อเปิดและยกเลิกโครูทีนใน LaunchedEffect
นอกจากนี้ ทีม ART ยังใช้การเพิ่มประสิทธิภาพเหล่านี้ในระดับ VM โดยตรงด้วย หากแอปของคุณกำหนดเป้าหมายเป็น API 36 และทำงานบน Android เวอร์ชันล่าสุด เป็นไปได้ว่าอุปกรณ์ของคุณเพิ่มประสิทธิภาพ Coroutine ในลักษณะที่คล้ายกันอยู่แล้ว การเปรียบเทียบ Coroutine ข้างต้นพบว่าประสิทธิภาพดีขึ้นประมาณ 15% หลังจากอัปเดต JIT ใน ART เวอร์ชันล่าสุด
แอปของคุณจะได้รับการเพิ่มประสิทธิภาพนี้โดยค่าเริ่มต้นเมื่ออัปเกรดเป็น AGP 9.2.0 หรือใช้ R8 9.2.0 โดยตรง ดูข้อมูลเพิ่มเติมได้ที่D8 Dexer และ R8 Shrinker
-
 กรณีศึกษา
แอปยืนยันตัวตนสำหรับการธนาคารและการลงทะเบียนซิมต้องใช้การจับภาพใบหน้าที่ชัดเจนและมีความละเอียดสูงเพื่อตรวจจับการปลอมแปลงและการใช้ดีปเฟก การจับภาพเฟรมที่คมชัดเพียงพอสำหรับการตรวจสอบความมีชีวิตและการป้องกันการปลอมแปลง โดยไม่ทำให้อุปกรณ์ที่มีหน่วยความจำต่ำขัดข้อง เป็นความท้าทายที่พบได้ทั่วไปสำหรับนักพัฒนาแอปกล้อง Android
Donovan McMurray • ใช้เวลาอ่าน 4 นาที -
 กรณีศึกษา
Grab เป็นซูเปอร์แอปชั้นนำของเอเชียตะวันออกเฉียงใต้ที่ให้บริการจัดส่ง การเดินทาง และบริการทางการเงินแก่ผู้ใช้หลายล้านคนใน 8 ประเทศผ่านแอปเดียว
Ajesh Pai, Nguyen Van Minh, Tracy Agyemang • ใช้เวลาอ่าน 5 นาที -
 กรณีศึกษา
ทีมได้สร้างฐานของโค้ด UI ที่เป็น AI แบบเนทีฟซึ่งมีขนาดเล็กกว่าการติดตั้งใช้งานเดิม 50% ขณะเดียวกันก็ลดเวลาในการดำเนินการของ AI Agent ลง 35%, ลดการแลกเปลี่ยนระหว่างวิศวกรกับ Agent ลง 32% และลดต้นทุนโทเค็นลง 33%
Pavlo Stavytskyi, Rebecca Franks • ใช้เวลาอ่าน 11 นาที
รับข้อมูลเชิงลึกล่าสุดเกี่ยวกับการพัฒนา Android ที่ส่งไปยังกล่องจดหมายของคุณทุกสัปดาห์