Kể từ AGP 9.2.0, R8 tối ưu hoá hầu hết các lệnh gọi Atomic*FieldUpdater thành các biến thể Unsafe có hiệu suất tốt hơn từ 2 đến 4 lần đối với các thao tác phổ biến. Điều này có tác động đặc biệt lớn đến thư viện kotlinx.atomicfu triển khai các nguyên tử cho kotlinx.coroutines, giúp việc khởi chạy và huỷ coroutine nhanh hơn gấp 2 lần. Để hưởng các lợi ích, hãy cập nhật AGP lên phiên bản 9.2.0 trở lên.
Khi phần lớn ứng dụng Android sử dụng Kotlin làm ngôn ngữ chính, kotlinx.coroutines đã trở thành tiêu chuẩn thực tế cho việc lập trình không đồng bộ. Thư viện này cung cấp một cách quản lý các luồng đồng thời có cấu trúc và được thiết kế phù hợp, vốn có trong Kotlin. Jetpack Compose cũng không ngoại lệ, áp dụng coroutine để quản lý các sự kiện con trỏ, ảnh động và các hoạt động tương tác khác. Tại thời điểm viết bài, hầu hết các API đồng thời trong Compose đều gọi các hàm suspend nâng cao và đang chạy và/hoặc huỷ coroutine để xử lý các bản cập nhật.
Khi nhóm Compose bắt đầu điều tra hiệu suất, họ phát hiện ra rằng coroutine là điểm tắc nghẽn đối với nhiều thao tác diễn ra bên ngoài thành phần kết hợp. Ví dụ: 80% thời gian dành cho việc tạo và cập nhật Modifier.clickable được dùng để khởi chạy và huỷ các coroutine nội bộ xử lý các bản cập nhật InteractionSource. Dựa trên những quan sát đó, phần lớn công việc cải thiện hiệu suất ban đầu tập trung vào việc loại bỏ coroutine khỏi đường dẫn mặc định và trì hoãn việc khởi chạy cho đến khi cần thiết.
Chi phí của coroutine
Cách dễ nhất để phân tích hành vi nội bộ của một hàm trên Android là ghi lại dấu vết phương thức Android Runtime (ART). Dấu vết phương thức ART là một công cụ ghi lại luồng thực thi của một ứng dụng, cho biết chính xác phương thức nào được gọi, thứ tự của các phương thức đó và thời gian thực thi của từng phương thức, giúp nhà phát triển xác định các điểm tắc nghẽn về hiệu suất. Đối với lệnh gọi LaunchedEffect { } trống, lệnh gọi sẽ có dạng như sau:
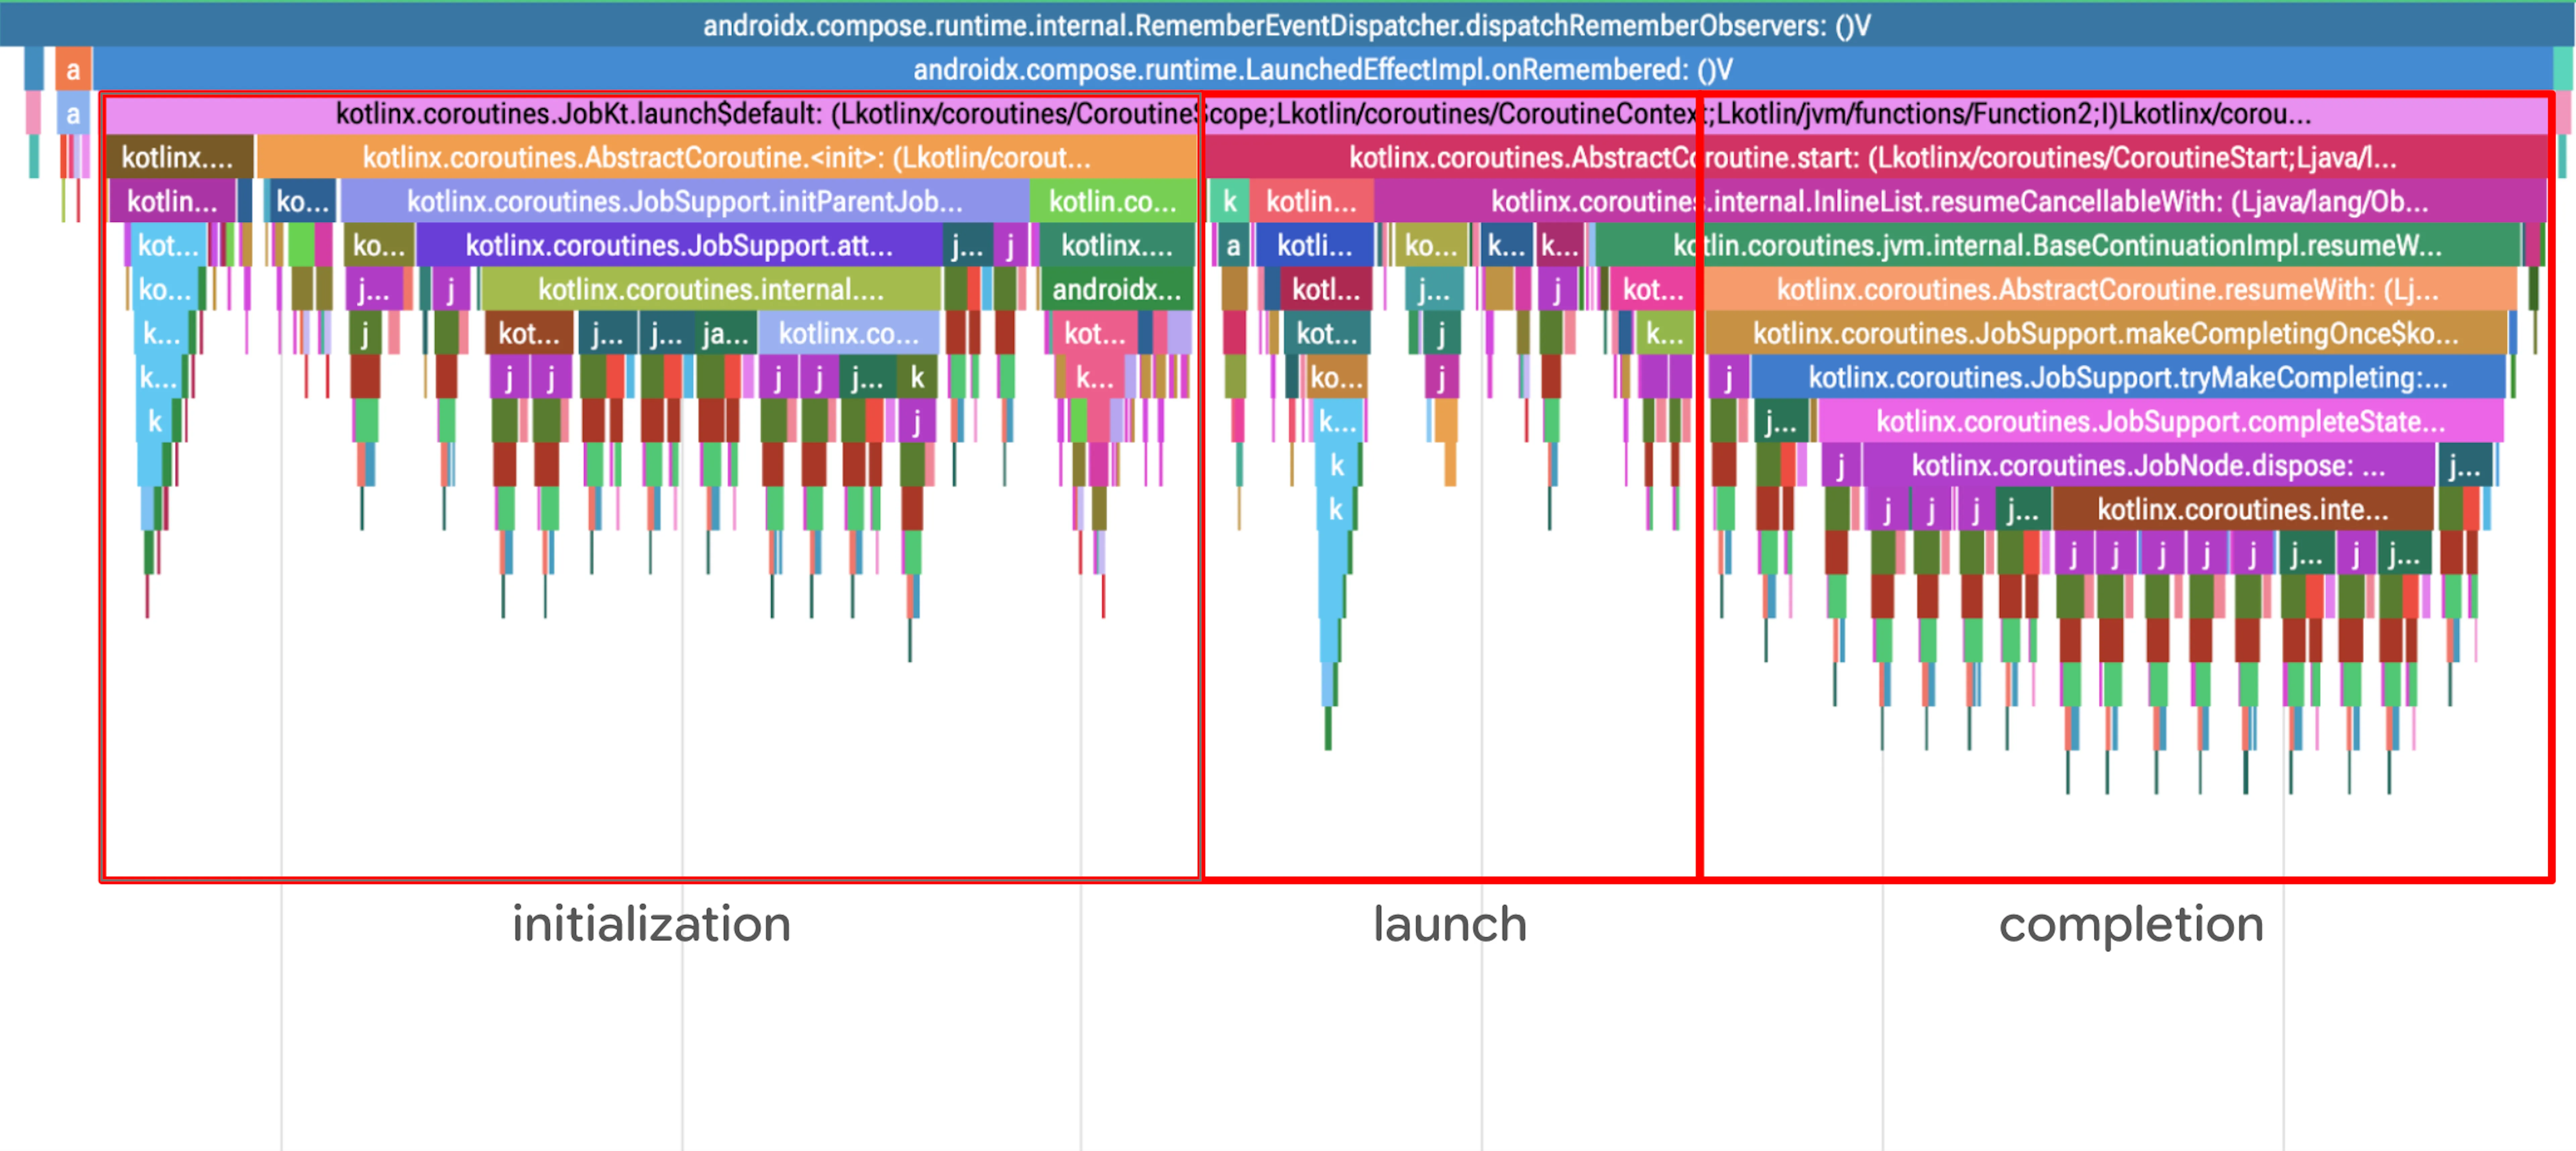
Dấu vết phương thức ở trên có thể được tách thành 3 phần:
- Đang khởi chạy một coroutine mới
- Bắt đầu coroutine
- Hoàn tất coroutine (vì coroutine thoát ngay lập tức)
Việc huỷ LaunchedEffect cũng tương tự như việc hoàn tất thông thường, ngoại trừ việc huỷ cũng tạo ra một CancellationException.
Trong hồ sơ trên, một điểm đáng ngờ ngay lập tức là các lệnh gọi thường xuyên vào java.util.concurrent.AtomicReferenceFieldUpdater (hộp màu tím hoặc xanh lục có nhãn j…). Mặc dù mỗi lệnh gọi tương đối nhanh, nhưng tần suất là điều đáng lo ngại; mọi mức hao tổn không đáng kể được trải rộng trên nhiều lệnh gọi có thể dẫn đến sự hồi quy đáng chú ý. Khi phóng to một lệnh gọi, chúng ta thấy rằng hầu hết thời gian đều dành cho... việc kiểm tra phản chiếu?
Coroutine triển khai cấu trúc cây không khoá cho mối quan hệ mẹ con, giúp xử lý đồng thời có cấu trúc. Hoá ra, thư viện kotlinx.atomicfu triển khai các thao tác nguyên tử không khoá bằng cách sử dụng một dữ liệu gốc JVM nổi tiếng, AtomicReferenceFieldUpdater. Trình cập nhật sử dụng tham chiếu lớp và tên trường để thực hiện các thao tác nguyên tử trong thời gian chạy, đồng thời phải chạy một số quy trình kiểm tra an toàn phản chiếu để đảm bảo trường tồn tại và có thể truy cập được. Mỗi thao tác trong coroutine (bắt đầu, tạm ngưng, huỷ, hoàn tất) gọi ít nhất một thao tác nguyên tử, vì vậy, nếu thao tác này chậm, coroutine sẽ không hoạt động tốt.
Điều tra AtomicReferenceFieldUpdater
Nhưng chúng ta đừng vội. AtomicReferenceFieldUpdater thực sự được tối ưu hoá tốt trên JVM trong hơn 10 năm nay và dấu vết phương thức có thể ghi lại mức hao tổn đã được loại bỏ hoàn toàn bằng cách tối ưu hoá cấp máy ảo: biên dịch trong khi thực thi (JIT) hoặc biên dịch trước (AOT). Để xác minh hiệu suất, hãy viết một vài điểm chuẩn để đo lường sự khác biệt giữa các tham chiếu nguyên tử từ kotlinx.atomicfu và java.util.concurrent.atomic.
@RunWith(AndroidJUnit4::class)
class AtomicReferenceBenchmark {
    @get:Rule
    val benchmarkRule = BenchmarkRule()

    private val atomicReference = java.util.concurrent.atomic.AtomicReference(false)
    private val atomicRef = kotlinx.atomicfu.atomic<Boolean>(false)

    @Test
    fun atomicReference_compareAndSet() {
        benchmarkRule.measureRepeated {
            atomicReference.compareAndSet(true, false)
            atomicReference.compareAndSet(false, true)
        }
    }

     @Test
    fun atomicRef_compareAndSet() {
        benchmarkRule.measureRepeated {
            atomicRef.compareAndSet(true, false)
            atomicRef.compareAndSet(false, true)
        }
    }

    /* measuring other methods from the method traces above */
}
Khi chạy điểm chuẩn này trên Pixel 5 (đồng thời đảm bảo AtomicReferenceFieldUpdater#compareAndSet được biên dịch JIT trong quá trình khởi động), bạn sẽ nhận được kết quả sau trên Pixel 5 (API 33):
 50.7 ns  atomicReference_compareAndSet
135   ns  atomicRef_compareAndSet
Các phép đo xác nhận khoảng cách, với phiên bản kotlinx.atomicfu rõ ràng là chậm hơn khoảng 2,7 lần. Điều này xác nhận rằng ART không thực hiện bất kỳ hoạt động tối ưu hoá ẩn nào và các bước kiểm tra quyền truy cập phản chiếu sẽ làm tăng mức hao tổn thực tế trong thời gian chạy.
Nhìn lại dấu vết phương thức ban đầu, công việc có ý nghĩa duy nhất mà AtomicReferenceFieldUpdater thực hiện là lệnh gọi nội bộ vào Unsafe.getObjectVolatile, thực sự thực thi thao tác nguyên tử cơ bản. Trong hầu hết các trường hợp, trình khởi tạo trình cập nhật là tĩnh và có thể được chứng minh là luôn chính xác dựa trên cấu trúc của lớp xung quanh. Do đó, người ta có thể phân tích tĩnh hầu hết các cách sử dụng AtomicReferenceFieldUpdater và thay thế chúng bằng một biến thể Unsafe nội bộ trong quá trình biên dịch. Chuỗi công cụ bản dựng Android cũng có trình biên dịch tối ưu hoá riêng có thể làm chính xác điều đó.
Tối ưu hoá bằng R8
Các lớp Atomic*FieldUpdater hỗ trợ việc sử dụng tinh tế, linh động và dựa trên phản ánh, nhưng thường được dùng trong các mẫu rõ ràng tĩnh. Điều này vừa giải thích hiệu suất cơ sở chậm vừa giải thích nhu cầu tối ưu hoá. R8 là một trình biên dịch tối ưu hoá toàn bộ chương trình và rất phù hợp để xem xét các mẫu đơn giản hơn nhằm giảm bớt hao tổn của các quy trình kiểm tra an toàn phản chiếu. R8 nhận mã byte JVM sau trình biên dịch Java hoặc Kotlin, nhưng để dễ đọc, các ví dụ này được trình bày theo cú pháp Java. Đây là lý do tại sao không có đối số kiểu cho AtomicReferenceFieldUpdater.
class Example {
    volatile String data = "";
    static final AtomicReferenceFieldUpdater updater =
        AtomicReferenceFieldUpdater.newUpdater(Example.class, String.class, "data");

    void example() {
        // ...
        updater.compareAndSet(this, "", "new");
        // ...
    }
}
Ví dụ cơ bản tạo một trình cập nhật cuối cùng tĩnh truy cập vào một trường biến động bằng các đối số hằng số đơn giản cho phần tử giữ, loại và tên của trường. Sự phản chiếu được sử dụng hoàn toàn trong suốt. Rõ ràng là trình cập nhật này tham chiếu đến một trường hợp lệ và trang web tạo trình cập nhật có quyền truy cập hợp lệ vào trường đó.
Về bản chất, Atomic*FieldUpdater là một trình bao bọc xung quanh độ lệch trường và lệnh gọi đến Unsafe. Trường hợp tối ưu nhất là thay thế trường trình cập nhật bằng trường độ lệch và thay thế lệnh gọi trình cập nhật bằng lệnh gọi đến Unsafe.
Tối ưu hoá Atomic*FieldUpdater
Quá trình tối ưu hoá được triển khai theo 3 phần: Đo lường, Thay thế và Dọn dẹp.
Khả năng đo lường
Bước đầu tiên là giới thiệu các trường bù trừ cùng với trường trình cập nhật để hỗ trợ quyền truy cập trực tiếp thông qua lệnh gọi Unsafe .
static final long updater$offset =
    SyntheticUnsafe.UNSAFE.objectFieldOffset(Example.class.getDeclaredField("data"))
Trường này được truy cập thông qua phản chiếu và Unsafe được dùng để trích xuất độ lệch trường trên lớp. Mã này đại diện cho các thành phần nội bộ của Atomic*FieldUpdater nếu bạn bỏ qua quy trình xác thực phản chiếu. Thay vào đó, loại phần tử giữ của trình cập nhật và loại trường của trường biến động được theo dõi tĩnh trong trình biên dịch.
Xin lưu ý rằng trường ban đầu và quá trình khởi chạy trường đó được giữ nguyên. Quá trình tối ưu hoá sẽ hỗ trợ và tối ưu hoá các trường hợp sử dụng một cách hiệu quả, sau đó dọn dẹp. Đây là một phương pháp triển khai đơn giản nhưng cũng cho phép tối ưu hoá một phần các trường của trình cập nhật, trong đó một số trường hợp sử dụng được giữ nguyên trong khi một số trường hợp khác được tối ưu hoá.
Thay thế
Tại thời điểm này trong trình biên dịch, sau một điểm nối đồng thời phù hợp, chúng ta có danh sách các trường trình cập nhật được đo lường. Điều này có nghĩa là chúng ta có thể tối ưu hoá từng vị trí gọi riêng lẻ dựa trên một vài điều kiện. Hãy xem xét một lệnh gọi mẫu:
updater.compareAndSet(holder, expectedValue, newValue);
Atomic*FieldUpdater yêu cầu các điều kiện sau:
updatercó đến từ một trường được đo lường không? Tức là liệu tính năng phân tích tĩnh có thể theo dõi giá trị của đối tượng trở lại một trường đọc của trình cập nhật được đo lường hay không?holdercó phải là cùng một lớp hoặc một lớp con của loại phần tử giữ khung hiển thị được xác định ban đầu không?newValuecó phải là cùng một lớp hoặc một lớp con của loại trường được xác định ban đầu không?
Nếu tất cả điều kiện đều được đáp ứng, thì lệnh gọi sẽ được thay thế bằng lệnh gọi đến Unsafe mà không có bất kỳ quy trình kiểm tra phản chiếu nào.
SyntheticUnsafe.UNSAFE.compareAndSwapObject(holder, Example.updater$offset, expectedValue, newValue)
Lệnh gọi mới này nhanh hơn và đơn giản hơn, nhưng khác với lệnh gọi ban đầu về cách xử lý các giá trị rỗng trong updater và holder. Trừ phi được loại trừ tĩnh, các quy trình kiểm tra rỗng sẽ được chèn cho cả hai.
Dọn dẹp
Tại thời điểm này, lớp lưu giữ có trường trình cập nhật ban đầu và trường độ lệch mới cùng với các trang web gọi có thể sử dụng một trong hai trường này. Nếu không có trang web gọi nào được tối ưu hoá, thì bạn nên xoá trường độ lệch. Nếu tất cả trang web gọi đều được tối ưu hoá, thì bạn nên xoá trường trình cập nhật. Trong cả hai trường hợp, lệnh gọi khởi chạy cũng phải bị xoá. Việc xoá các trường không dùng đến và xoá mã chết đã được thực hiện trong trình biên dịch, nhưng việc xoá mã khởi chạy ở đây cần thêm một vài thủ thuật.
Cả lệnh gọi đến newUpdater và getDeclaredField đều có thể có tác dụng phụ vì chúng có thể gửi ngoại lệ (và việc triển khai chúng cũng không xác định được vì phụ thuộc vào phiên bản API). Điều này có nghĩa là bằng cách tối ưu hoá chung, bạn không thể xoá các lớp này một cách an toàn. Vì vậy, việc dọn dẹp này cần phải xem xét rõ ràng các trường được đo lường, vì các trường đó được biết đến là không có ngoại lệ.
Cuối cùng, ví dụ về trình cập nhật đơn giản nêu trên sẽ có dạng như sau sau khi tối ưu hoá:
Kết quả
Sau những lần tối ưu hoá này, kotlinx.atomicfu và hầu hết các trường hợp sử dụng rõ ràng của AtomicInt/Long/ReferenceFieldUpdater hiện khớp với hiệu suất của AtomicReference khi áp dụng R8. Trên thực tế, nó thậm chí còn nhanh hơn trong một số điểm chuẩn; kotlinx.atomicfu có một trình bổ trợ trình biên dịch có thể chèn các thực thể atomic vào các trường, giảm bớt các lượt phân bổ cần thiết để tạo một trường được cập nhật tự động.
Jetpack Compose là đối tượng hưởng lợi chính từ công việc này. Môi trường thời gian chạy của Compose có một số điểm chuẩn vi mô theo dõi hiệu suất coroutine rất chặt chẽ để sớm phát hiện sự sụt giảm hiệu suất. Khi các điểm chuẩn được cập nhật lên phiên bản R8 mới, chúng tôi nhận thấy hiệu suất cải thiện gấp đôi khi khởi chạy và huỷ coroutine trong LaunchedEffect!
Ngoài ra, nhóm ART đang triển khai các tính năng tối ưu hoá này ở cấp máy ảo. Nếu ứng dụng của bạn nhắm đến API 36 và đang chạy trên một phiên bản Android gần đây, thì có thể thiết bị của bạn đã tối ưu hoá coroutine theo cách tương tự. Điểm chuẩn coroutine ở trên cho thấy hiệu suất cải thiện khoảng 15% sau khi cập nhật JIT trong các phiên bản ART gần đây.
Theo mặc định, ứng dụng của bạn sẽ nhận được tính năng tối ưu hoá này khi nâng cấp lên AGP 9.2.0 hoặc bằng cách sử dụng trực tiếp R8 9.2.0. Để biết thêm thông tin, hãy xem bài viết Trình biên dịch D8 và trình rút gọn R8.
-
 Nghiên cứu điển hình
Grab là siêu ứng dụng hàng đầu Đông Nam Á, cung cấp dịch vụ giao hàng, di chuyển và dịch vụ tài chính cho hàng triệu người dùng tại 8 quốc gia thông qua một ứng dụng duy nhất.
Ajesh Pai, Nguyen Van Minh, Tracy Agyemang • Thời gian đọc: 5 phút -
 Nghiên cứu điển hình
Nhóm đã xây dựng một toàn bộ mã nguồn giao diện người dùng dựa trên AI, nhỏ hơn 50% so với phiên bản triển khai ban đầu, đồng thời giảm 35% thời gian thực thi của tác nhân AI, giảm 32% số lần trao đổi giữa kỹ sư và tác nhân, và giảm 33% chi phí mã thông báo.
Pavlo Stavytskyi, Rebecca Franks • Thời gian đọc: 11 phút -
 Nghiên cứu điển hình
WhatsApp là nền tảng nhắn tin lớn nhất thế giới, phục vụ hàng tỷ người dùng trên toàn cầu. Đây là công cụ giao tiếp mặc định cho mọi người ở nhiều khu vực, giúp kết nối người dùng thông qua dịch vụ nhắn tin riêng tư, đáng tin cậy và bảo mật.
Niharika Arora, Tracy Agyemang, Mayank Jain • Đọc trong 8 phút
Nhận thông tin chi tiết mới nhất về hoạt động phát triển Android trong hộp thư đến của bạn hằng tuần.