從 AGP 9.2.0 開始,R8 會將大多數 Atomic*FieldUpdater 呼叫最佳化為 Unsafe 變體,在常見作業中的效能可提升 2 到 4 倍。這對 kotlinx.atomicfu 程式庫有很大的影響,該程式庫為 kotlinx.coroutines 實作原子,使啟動和取消協同程式的速度最多可提高 2 倍。如要享有這些好處,請將 AGP 更新至 9.2.0 以上版本。
由於大多數 Android 應用程式都採用 Kotlin 做為主要語言,kotlinx.coroutines已成為非同步程式設計的實際標準。這個程式庫提供設計完善且結構化的方式,可管理 Kotlin 原生的並行流程。Jetpack Compose 也不例外,採用協同程式管理指標事件、動畫和其他互動。撰寫本文時,Compose 中的大多數並行 API 都會在幕後呼叫 suspend 函式,並啟動和/或取消協同程式來處理更新。
Compose 團隊開始調查效能時,發現協同程式是許多在組合結構外發生的作業瓶頸。舉例來說,建立及更新 Modifier.clickable 的時間中,有 80% 是用於啟動和取消處理 InteractionSource 更新的內部協同程式。根據這些觀察結果,早期的效能工作大多著重於從預設路徑中移除協同程式,並延遲初始化,直到必要時才進行。
協同程式的成本
如要分析 Android 函式的內部行為,最簡單的方法是擷取 Android 執行階段 (ART) 方法追蹤記錄。ART 方法追蹤記錄工具可記錄應用程式的執行流程,準確顯示呼叫的方法、順序,以及各方法耗費的時間,方便開發人員找出效能瓶頸。空白的 LaunchedEffect { } 呼叫如下所示:
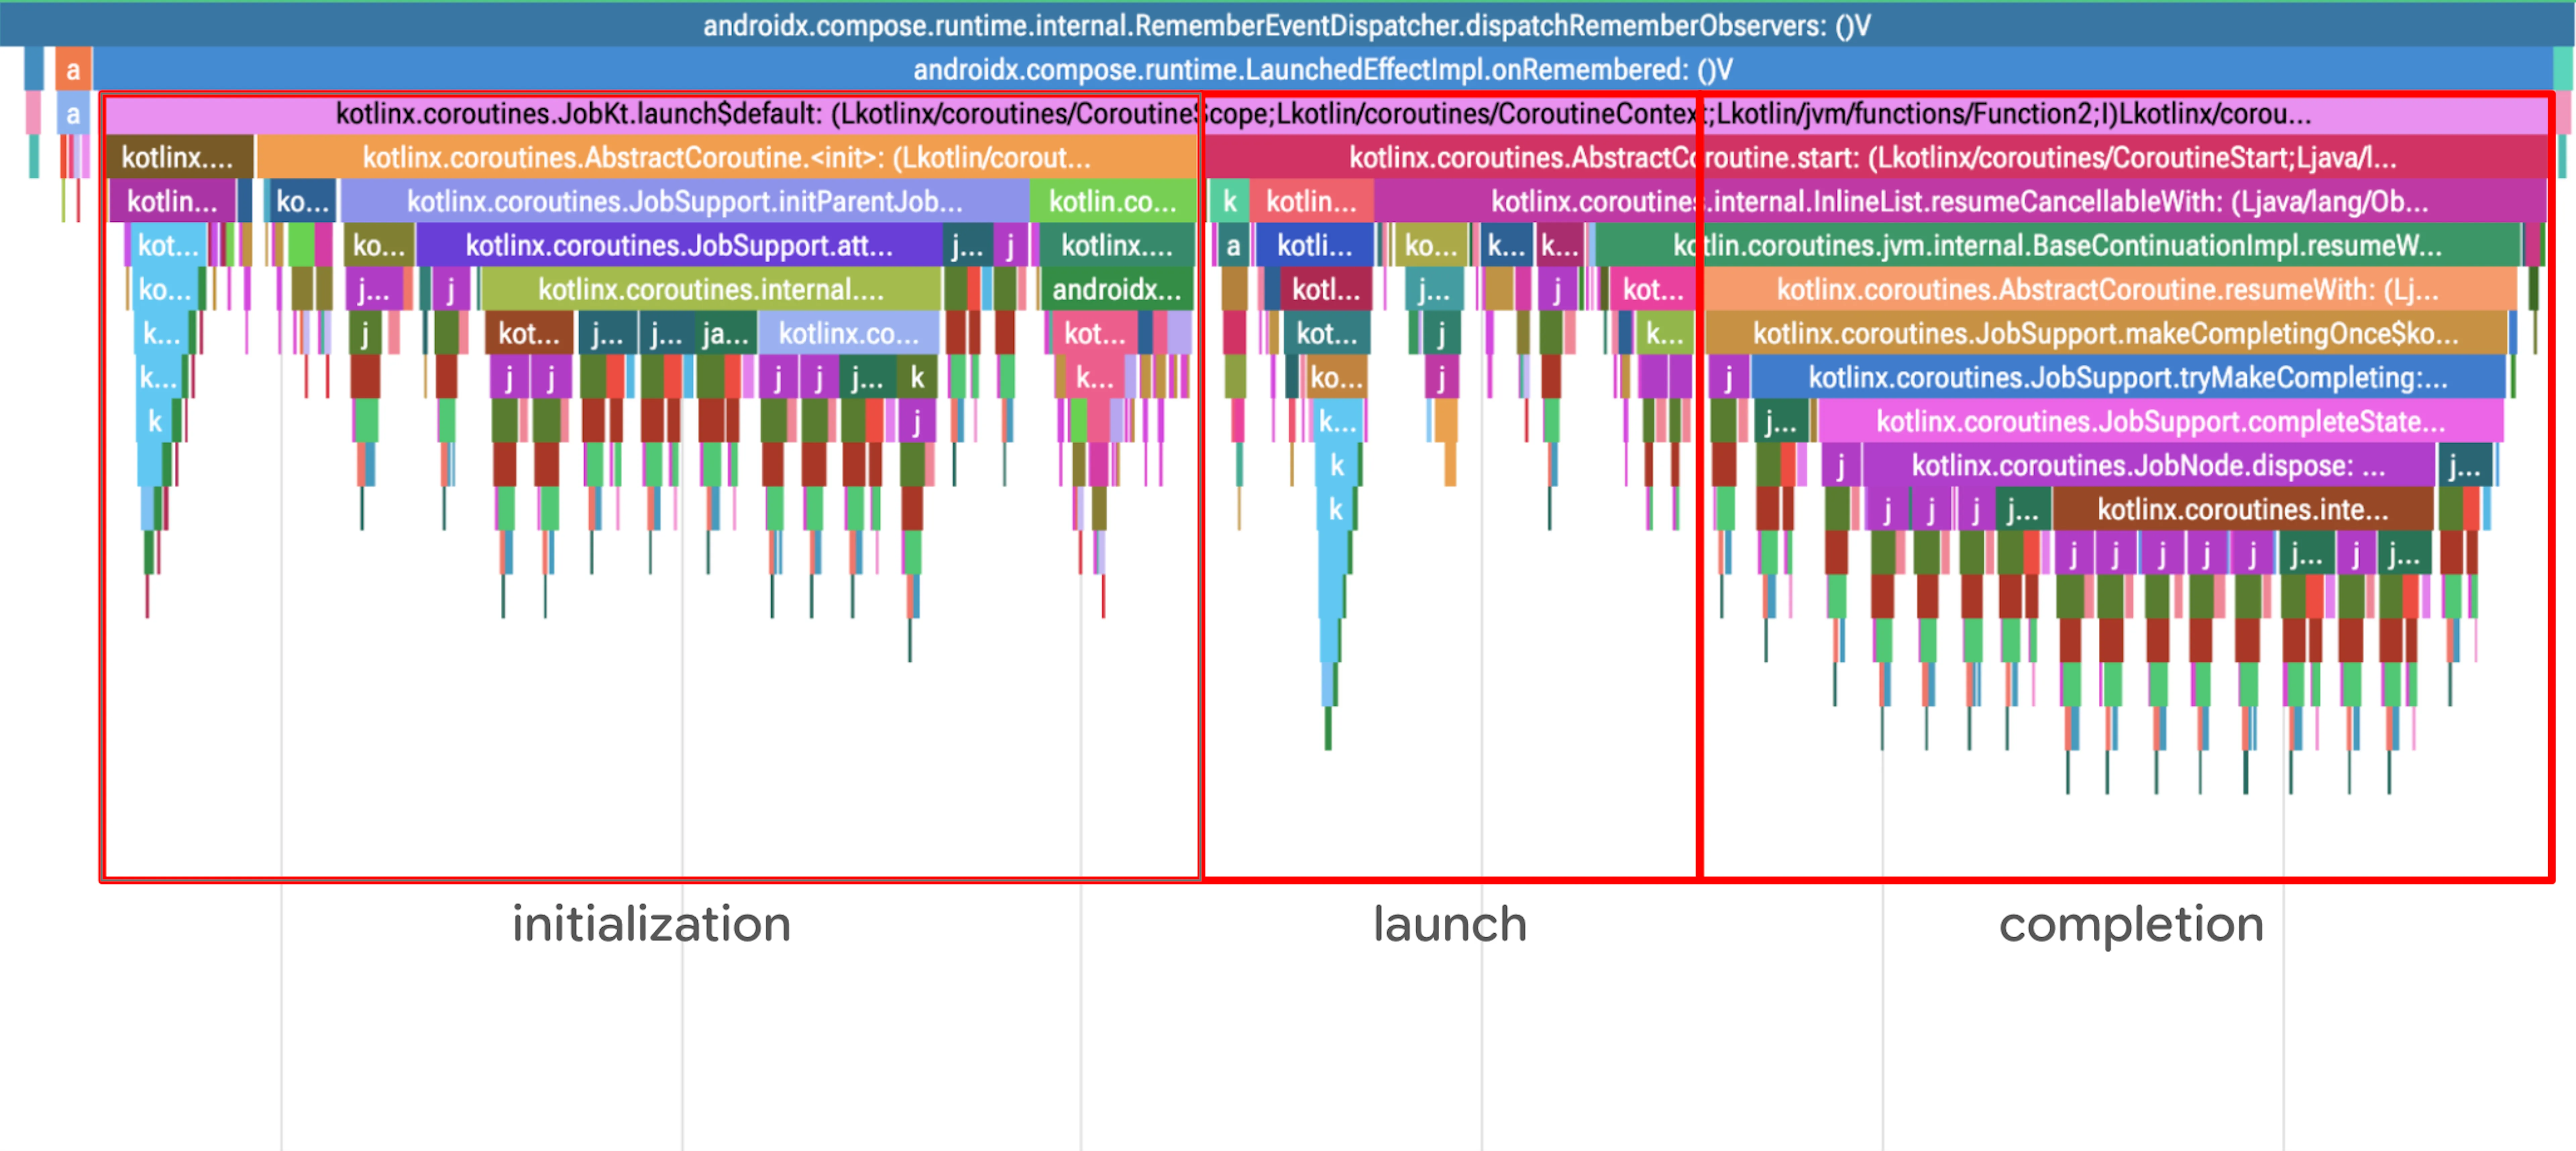
上述方法追蹤記錄可分為三個部分:
- 初始化新的協同程式
- 啟動協同程式
- 完成協同程式 (因為會立即退出)
取消 LaunchedEffect 的方式與正常完成類似,但也會建立 CancellationException。
從上方的設定檔中,可以立即發現可疑之處,那就是頻繁呼叫 java.util.concurrent.AtomicReferenceFieldUpdater (紫色或綠色方塊,標籤為 j…)。雖然每次呼叫的速度相對較快,但頻率令人擔憂;分散在多個叫用中的任何非可忽略負擔,可能會增加明顯的迴歸。放大呼叫後,發現大部分時間都花在... 反射檢查?
協同程式會為父項與子項關係實作無鎖定樹狀結構,讓結構化並行成為可能。結果發現,kotlinx.atomicfu 程式庫使用知名的 JVM 原始物件 AtomicReferenceFieldUpdater 實作無鎖定原子作業。更新程式會使用類別參照和欄位名稱,在執行階段執行不可分割作業,且必須執行多項反射安全性檢查,確保欄位存在且可存取。協同程式中的每項作業 (啟動、暫停、取消、完成) 都會呼叫至少一項不可分割作業,因此如果速度緩慢,協同程式的效能就會不佳。
調查 AtomicReferenceFieldUpdater
不過,我們別操之過急。AtomicReferenceFieldUpdater 實際上在 JVM 上已最佳化超過 10 年,而方法追蹤記錄可能會擷取完全由 VM 層級最佳化移除的負擔:即時 (JIT) 或預先 (AOT) 編譯。為了驗證效能,我們來編寫一些基準測試,測量 kotlinx.atomicfu 和 java.util.concurrent.atomic 的原子參照之間的差異。
@RunWith(AndroidJUnit4::class)
class AtomicReferenceBenchmark {
    @get:Rule
    val benchmarkRule = BenchmarkRule()

    private val atomicReference = java.util.concurrent.atomic.AtomicReference(false)
    private val atomicRef = kotlinx.atomicfu.atomic<Boolean>(false)

    @Test
    fun atomicReference_compareAndSet() {
        benchmarkRule.measureRepeated {
            atomicReference.compareAndSet(true, false)
            atomicReference.compareAndSet(false, true)
        }
    }

     @Test
    fun atomicRef_compareAndSet() {
        benchmarkRule.measureRepeated {
            atomicRef.compareAndSet(true, false)
            atomicRef.compareAndSet(false, true)
        }
    }

    /* measuring other methods from the method traces above */
}
在 Pixel 5 上執行這項基準測試 (同時確保 AtomicReferenceFieldUpdater#compareAndSet 在暖機期間經過 JIT 編譯),Pixel 5 (API 33) 會產生以下結果:
 50.7 ns  atomicReference_compareAndSet
135   ns  atomicRef_compareAndSet
測量結果證實了差距,kotlinx.atomicfu 版本明顯慢了約 2.7 倍。這證實 ART 不會執行任何隱藏的最佳化作業,且反射存取檢查會在執行階段增加實際負擔。
回顧原始方法追蹤記錄,AtomicReferenceFieldUpdater 執行的唯一有意義工作是內部呼叫 Unsafe.getObjectVolatile,實際執行基礎不可拆分作業。在大多數情況下,更新程式初始化器是靜態的,且根據周圍類別的結構,可以證明其始終正確。因此,您可以靜態分析大部分的 AtomicReferenceFieldUpdater 用途,並在編譯期間將其替換為內部 Unsafe 變體。Android 建構工具鍊剛好有專屬的最佳化編譯器,可以做到這一點。
使用 R8 進行最佳化
Atomic*FieldUpdater 類別支援細微、動態和反射式用途,但通常用於靜態明顯模式。這說明瞭基準效能緩慢的原因,以及需要最佳化的原因。R8 是全程式最佳化編譯器,非常適合透過簡單的模式,略過反射安全性檢查的負擔。R8 會在 Java 或 Kotlin 編譯器之後接收 JVM 位元碼,但為了方便閱讀,這些範例會以 Java 語法呈現。因此 AtomicReferenceFieldUpdater 沒有類型引數。
class Example {
    volatile String data = "";
    static final AtomicReferenceFieldUpdater updater =
        AtomicReferenceFieldUpdater.newUpdater(Example.class, String.class, "data");

    void example() {
        // ...
        updater.compareAndSet(this, "", "new");
        // ...
    }
}
基本範例會建立靜態最終更新工具,使用簡單的常數引數 (用於持有者、類型和欄位名稱) 存取 volatile 欄位。使用的反射完全透明。很明顯,這個更新程式參照了有效欄位,且更新程式建立網站對該欄位具有有效存取權。
本質上,Atomic*FieldUpdater 是欄位偏移和 Unsafe 呼叫的包裝函式。最佳的最佳化情境是將更新器欄位替換為偏移欄位,並將更新器呼叫替換為對 Unsafe 的呼叫。
最佳化 Atomic*FieldUpdater
最佳化作業分為三個部分:檢測、替換和清除。
檢測設備測試
第一步是引入偏移欄位和更新器欄位,以便透過 Unsafe 呼叫直接存取。
static final long updater$offset =
    SyntheticUnsafe.UNSAFE.objectFieldOffset(Example.class.getDeclaredField("data"))
系統會透過反射存取欄位,並使用 Unsafe 擷取類別的欄位偏移。如果不考慮反射驗證,這段程式碼代表 Atomic*FieldUpdater 的內部。相反地,編譯器會以靜態方式追蹤更新器的持有者類型和 volatile 欄位的欄位類型。
請注意,原始欄位及其初始化作業會保持原樣。最佳化程序會樂觀地促進及最佳化用途,然後再進行清理。這種做法雖然簡單,但也能部分最佳化更新器欄位,讓部分用途維持原樣,其他用途則進行最佳化。
替換
在編譯器的這個階段,經過適當的並行彙整點後,我們會取得檢測更新器欄位的清單。這表示我們可以根據一些條件,個別最佳化每個呼叫網站。請參考以下呼叫範例:
updater.compareAndSet(holder, expectedValue, newValue);
Atomic*FieldUpdater 要求的條件如下:
updater是否來自檢測欄位?也就是說,靜態分析能否追蹤物件的值,回溯到檢測更新器的欄位讀取?holder是否與原先定義的容器類型相同,或是其子類別?newValue是否與原先定義的欄位類型相同,或是其子類別?
如果符合所有條件,系統會將呼叫替換為對 Unsafe 的呼叫,而不進行任何反射檢查。
SyntheticUnsafe.UNSAFE.compareAndSwapObject(holder, Example.updater$offset, expectedValue, newValue)
這個新呼叫更快速、更簡單,但與原始呼叫不同,它會處理 updater 和 holder 中的空值。除非靜態排除,否則系統會為兩者插入空值檢查。
清除
此時,保留類別具有原始更新器欄位和新的偏移欄位,以及可能使用其中一個欄位的呼叫網站。如果沒有任何呼叫網站經過最佳化,則應移除 offset 欄位;如果所有呼叫網站都經過最佳化,則應移除 updater 欄位。無論是哪種情況,都應刪除初始化呼叫。編譯器已刪除未使用的欄位和無效程式碼,但移除初始化程式碼需要更多技巧。
對 newUpdater 和 getDeclaredField 的呼叫可能會產生副作用,因為它們可能會擲回例外狀況 (且其實作也未知,因為它取決於 API 版本)。這表示一般最佳化作業無法安全地移除這些程式碼。因此,這項清理作業需要明確考量檢測欄位,因為這些欄位在靜態上已知沒有例外狀況。
最後,上述簡單的更新器範例在最佳化後會像這樣:
結果
經過這些最佳化後,kotlinx.atomicfu 和大多數明確使用 AtomicInt/Long/ReferenceFieldUpdater 的情況,現在都與套用 R8 的 AtomicReference 效能相符。事實上,在某些基準測試中,它的速度甚至更快;kotlinx.atomicfu 有編譯器外掛程式,可將 atomic 執行個體內嵌至欄位,減少建立原子更新欄位所需的分配。
Jetpack Compose 是這項工作的主要受益者。Compose 執行階段有多項微基準測試,可密切追蹤協同程式效能,及早發現效能迴歸。將基準測試更新至新版 R8 後,我們發現 LaunchedEffect 啟動和取消協同程式的速度提升了 2 倍!
此外,ART 團隊也正在 VM 層級原生實作這些最佳化功能。如果應用程式指定 API 36,並在近期版本的 Android 上執行,裝置可能已採用類似方式最佳化協同程式。在最近幾個 ART 版本中,JIT 更新後,上述協同程式基準測試的效能提升了約 15%。
升級至 AGP 9.2.0 或直接使用 R8 9.2.0 時,應用程式預設會套用這項最佳化功能。詳情請參閱「D8 dexer 和 R8 縮減工具」。
-
 個案研究
Grab 是東南亞首屈一指的超級應用程式,透過單一應用程式為八個國家/地區的數百萬名使用者提供外送、交通和金融服務。
Ajesh Pai, Nguyen Van Minh, Tracy Agyemang • 閱讀時間:5 分鐘 -
 個案研究
該團隊建構了 AI 原生 UI 程式碼集,比原始實作小 50%,同時將 AI 代理執行時間縮短 35%,工程師與代理之間的互動減少 32%,並將權杖成本降低 33%。
Pavlo Stavytskyi, Rebecca Franks • 閱讀時間:11 分鐘 -
 個案研究
WhatsApp 是全球最大的訊息平台,為全球數十億使用者提供服務。WhatsApp 是不同地區使用者預設的通訊工具,透過私密、可靠且安全的訊息服務,將使用者連結在一起。
Niharika Arora, Tracy Agyemang, Mayank Jain • 閱讀時間:8 分鐘
每週透過電子郵件接收最新的 Android 開發洞察資訊。