在 Android 17 中,以 SDK 37 或更高版本为目标平台的应用将收到 MessageQueue 的新实现,该实现是无锁的。新实现可提升性能并减少丢帧,但可能会破坏对 MessageQueue 私有字段和方法进行反射的客户端。如需详细了解行为变更以及如何减轻影响,请参阅 MessageQueue 行为变更文档。这篇技术博文简要介绍了 MessageQueue 重新架构,以及如何使用 Perfetto 分析锁争用问题。
Looper 驱动每个 Android 应用的界面线程。它会从 MessageQueue 中拉取工作,将其分派给 Handler,然后重复此过程。二十年来,MessageQueue 一直使用单个监视器锁(即 synchronized 代码块)来保护其状态。
Android 17 对此组件进行了重大更新:引入了名为 DeliQueue 的无锁实现。
本文将介绍锁如何影响界面性能、如何使用 Perfetto 分析这些问题,以及用于改进 Android 主线程的具体算法和优化。
问题:锁争用和优先级反转
旧版 MessageQueue 用作受单个锁保护的优先级队列。如果后台线程在主线程执行队列维护时发布消息,则后台线程会阻塞主线程。
当两个或更多线程竞争独占使用同一锁时,这称为锁争用。这种争用可能会导致优先级倒置,从而导致界面卡顿和其他性能问题。
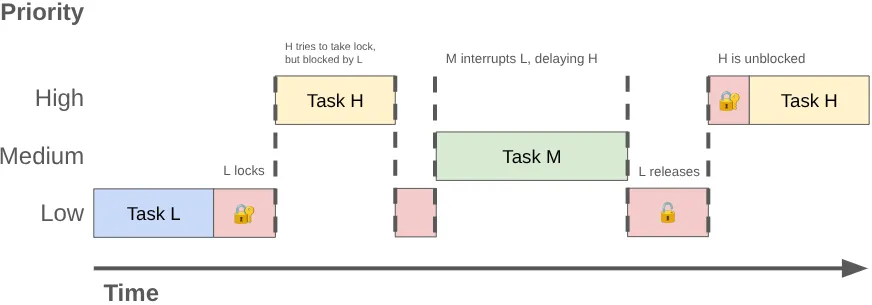
当高优先级线程(如界面线程)被迫等待低优先级线程时,可能会发生优先级倒置。请考虑以下序列:
- 低优先级后台线程获取
MessageQueue锁,以发布其所做工作的成果。 - 中优先级线程变为可运行状态,内核的调度程序为其分配 CPU 时间,从而抢占低优先级线程。
- 高优先级界面线程完成其当前任务并尝试从队列中读取数据,但由于低优先级线程持有锁而被阻塞。
低优先级线程会阻塞界面线程,而中优先级工作会进一步延迟界面线程。
使用 Perfetto 分析争用
您可以使用 Perfetto 诊断这些问题。在标准跟踪记录中,因监视器锁而被阻塞的线程会进入休眠状态,Perfetto 会显示一个切片来指示锁所有者。
查询跟踪数据时,请查找名为“monitor contention with…”的切片,后跟拥有锁的线程名称以及获取锁的代码位置。
案例研究:启动器卡顿
为了说明这一点,我们来分析一个轨迹,其中用户在相机应用中拍照后立即返回 Pixel 手机的主屏幕,在此过程中遇到了卡顿。下面是 Perfetto 的屏幕截图,其中显示了导致丢帧的事件:
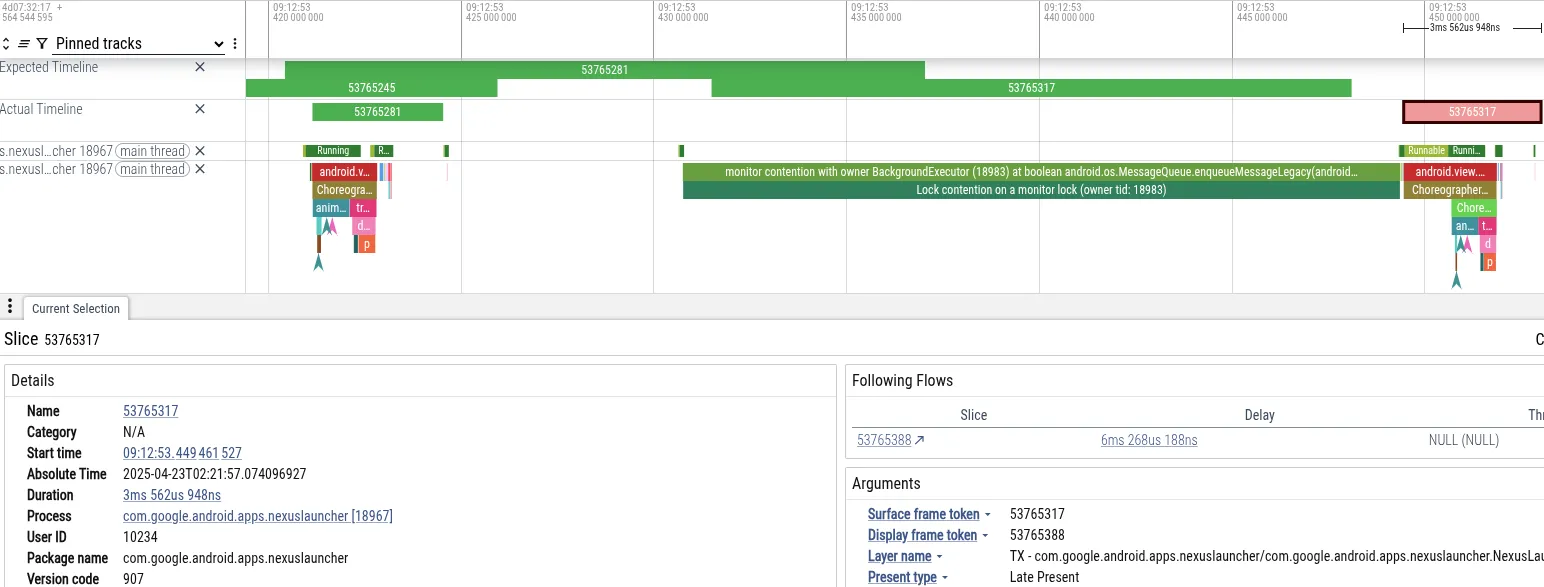
- 症状:启动器主线程错过了帧截止时间。它阻塞了 18 毫秒,超过了 60Hz 渲染所需的 16 毫秒截止时间。
- 诊断:Perfetto 显示主线程在
MessageQueue锁上被阻塞。“BackgroundExecutor”线程拥有该锁。 - 根本原因:BackgroundExecutor 以 Process.THREAD_PRIORITY_BACKGROUND(非常低的优先级)运行。它执行了一项非紧急任务(检查应用用量限额)。与此同时,中优先级线程正在使用 CPU 时间来处理来自相机的数据。操作系统调度程序抢占了 BackgroundExecutor 线程,以运行相机线程。
此序列导致启动器的界面线程(高优先级)被相机工作器线程(中优先级)间接阻塞,从而阻止启动器的后台线程(低优先级)释放锁。
使用 PerfettoSQL 查询跟踪记录
您可以使用 PerfettoSQL 查询轨迹数据,以查找特定模式。如果您有大量来自用户设备或测试的跟踪记录,并且正在寻找能说明问题的特定跟踪记录,那么此功能会非常有用。
例如,以下查询会查找与丢帧(卡顿)同时发生的 MessageQueue 争用:
INCLUDE PERFETTO MODULE android.monitor_contention;
INCLUDE PERFETTO MODULE android.frames.jank_type;

SELECT
  process_name,
  -- Convert duration from nanoseconds to milliseconds
  SUM(dur) / 1000000 AS sum_dur_ms,
  COUNT(*) AS count_contention
FROM android_monitor_contention
WHERE is_blocked_thread_main
AND short_blocked_method LIKE "%MessageQueue%"

-- Only look at app processes that had jank
AND upid IN (
  SELECT DISTINCT(upid)
  FROM actual_frame_timeline_slice
  WHERE android_is_app_jank_type(jank_type) = TRUE
)
GROUP BY process_name
ORDER BY SUM(dur) DESC;
在这个更复杂的示例中,联接跨多个表的跟踪数据,以找出应用启动期间的 MessageQueue 争用问题:
INCLUDE PERFETTO MODULE android.monitor_contention;
INCLUDE PERFETTO MODULE android.startup.startups;

-- Join package and process information for startups
DROP VIEW IF EXISTS startups;
CREATE VIEW startups AS
SELECT startup_id, ts, dur, upid
FROM android_startups
JOIN android_startup_processes USING(startup_id);

-- Intersect monitor contention with startups in the same process.
DROP TABLE IF EXISTS monitor_contention_during_startup;
CREATE VIRTUAL TABLE monitor_contention_during_startup
USING SPAN_JOIN(android_monitor_contention PARTITIONED upid, startups PARTITIONED upid);

SELECT
  process_name,
  SUM(dur) / 1000000 AS sum_dur_ms,
  COUNT(*) AS count_contention
FROM monitor_contention_during_startup
WHERE is_blocked_thread_main
AND short_blocked_method LIKE "%MessageQueue%"
GROUP BY process_name
ORDER BY SUM(dur) DESC;
您可以使用自己喜欢的 LLM 编写 PerfettoSQL 查询,以查找其他模式。
在 Google,我们使用 BigTrace 对数百万条轨迹运行 PerfettoSQL 查询。在此过程中,我们确认了之前观察到的个别现象实际上是一个系统性问题。数据显示,MessageQueue 锁争用会影响整个生态系统中的用户,这证实了进行根本性架构更改的必要性。
解决方案:无锁并发
我们通过实现无锁数据结构解决了 MessageQueue 争用问题,该结构使用原子内存操作(而非排他锁)来同步对共享状态的访问。如果无论其他线程的调度行为如何,至少有一个线程始终可以取得进展,则数据结构或算法是无锁的。此属性通常很难实现,并且对于大多数代码而言通常不值得追求。
原子基元
无锁软件通常依赖于硬件提供的原子读-改-写原语。
在旧一代 ARM64 CPU 上,原子操作使用 Load-Link/Store-Conditional (LL/SC) 循环。CPU 加载一个值并标记该地址。如果另一个线程写入该地址,则存储失败,循环会重试。由于线程可以不断尝试并成功,而无需等待其他线程,因此此操作是无锁的。
ARM64 LL/SC loop example
retry:
    ldxr    x0, [x1]        // Load exclusive from address x1 to x0
    add     x0, x0, #1      // Increment value by 1
    stxr    w2, x0, [x1]    // Store exclusive.
                            // w2 gets 0 on success, 1 on failure
cbnz w2, retry // If w2 is non-zero (failed), branch to retr较新的 ARM 架构 (ARMv8.1) 支持大型系统扩展 (LSE),其中包括比较并交换 (CAS) 或加载并添加形式的指令(如下所示)。在 Android 17 中,我们为 Android 运行时 (ART) 编译器添加了支持,以便检测何时支持 LSE 并发出优化指令:
/ ARMv8.1 LSE atomic example
ldadd   x0, x1, [x2]    // Atomic load-add.
                        // Faster, no loop required.
在我们的基准测试中,使用 CAS 的高争用代码比 LL/SC 变体快约 3 倍。
Java 编程语言通过 java.util.concurrent.atomic 提供原子基元,这些基元依赖于这些指令和其他专用 CPU 指令。
数据结构:DeliQueue
为了消除 MessageQueue 中的锁争用,我们的工程师设计了一种名为 DeliQueue 的新型数据结构。DeliQueue 将 Message 插入与 Message 处理分开:
Messages列表(Treiber 堆栈):无锁堆栈。任何线程都可以在此处推送新的Messages,而不会发生争用。- 优先级队列(最小堆):要处理的
Messages堆,由 Looper 线程独占(因此无需同步或锁定即可访问)。
入队:推送到 Treiber 堆栈
Messages 列表保存在 Treiber 堆栈 [1] 中,这是一个无锁堆栈,使用 CAS 循环来更新头指针。
public class TreiberStack <E> {
    AtomicReference<Node<E>> top =
            new AtomicReference<Node<E>>();
    public void push(E item) {
        Node<E> newHead = new Node<E>(item);
        Node<E> oldHead;
        do {
            oldHead = top.get();
            newHead.next = oldHead;
        } while (!top.compareAndSet(oldHead, newHead));
    }

    public E pop() {
        Node<E> oldHead;
        Node<E> newHead;
        do {
            oldHead = top.get();
            if (oldHead == null) return null;
            newHead = oldHead.next;
        } while (!top.compareAndSet(oldHead, newHead));
        return oldHead.item;
    }
}
源代码基于《Java Concurrency in Practice》[2],可在线获取,并已发布到公共领域
任何提供方都可以随时将新的 Message 推送到堆栈。这就像在熟食店柜台取号一样,您的号码取决于您到达的时间,但您拿到食物的顺序不一定与号码顺序一致。由于它是一个关联堆栈,因此每个 Message 都是一个子堆栈 - 您可以通过跟踪头部并向前迭代来查看 Message 队列在任何时间点的情况 - 您不会看到任何新的 Message 被推送到顶部,即使它们是在遍历期间添加的。
出队:批量转移到最小堆
为了找到下一个要处理的 Message,Looper 会从 Treiber 堆栈中处理新的 Message,方法是从堆栈顶部开始遍历堆栈并进行迭代,直到找到它之前处理的最后一个 Message。当 Looper 遍历堆栈时,它会将 Message 插入到按截止时间排序的最小堆中。由于 Looper 独占堆,因此它无需锁或原子操作即可对 Message 进行排序和处理。
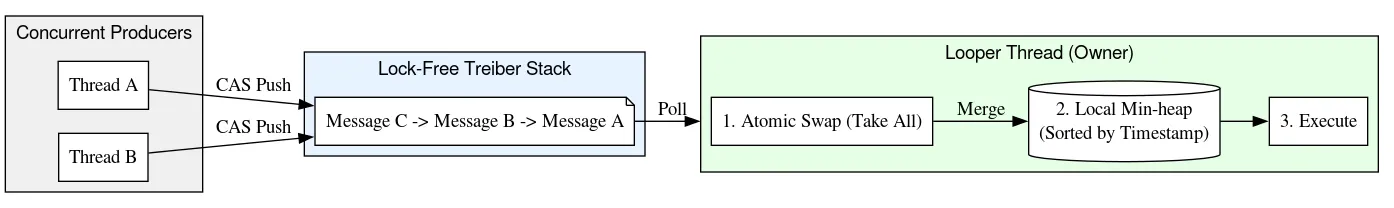
在向下遍历堆栈时,Looper 还会创建从堆叠的 Message 返回到其前置任务的链接,从而形成双向链表。创建链表是安全的,因为指向堆栈下方的链接是通过带有 CAS 的 Treiber 堆栈算法添加的,而指向堆栈上方的链接只能由 Looper 线程读取和修改。然后,这些反向链接用于在 O(1) 时间内从堆栈中的任意点移除 Message。
这种设计为提供方(将工作发布到队列的线程)提供 O(1) 插入,并为使用方 (Looper) 提供摊销的 O(log N) 处理。
使用最小堆对 Message 进行排序还解决了旧版 MessageQueue 中的一个根本缺陷,即 Message 保留在单链表(根位于顶部)中。在旧版实现中,从头部移除的时间复杂度为 O(1),但插入的时间复杂度在最坏情况下为 O(N),这导致在队列过载时扩缩性能不佳!相反,向最小堆中插入和从中移除元素的时间复杂度是对数级的,这不仅能提供具有竞争力的平均性能,而且在尾部延迟方面表现尤为出色。
旧版(已锁定)MessageQueue | DeliQueue | |
| 插入 | O(N) | O(1)(对于调用线程) O(logN)(对于 |
| 从头部移除 | O(1) | O(logN) |
在旧版队列实现中,生产者和消费者使用锁来协调对底层单链表的独占访问。在 DeliQueue 中,Treiber 堆栈负责处理并发访问,而单个消费者负责对其工作队列进行排序。
移除:通过墓碑实现一致性
DeliQueue 是一种混合数据结构,它将无锁 Treiber 堆栈与单线程最小堆相结合。在没有全局锁的情况下,保持这两个结构同步会带来一个独特的挑战:消息可能在物理上存在于栈中,但在逻辑上已从队列中移除。
为了解决这个问题,DeliQueue 使用了一种称为“墓碑化”的技术。每个 Message 都会通过向前和向后指针跟踪其在堆栈中的位置、其在堆数组中的索引,以及一个指示其是否已被移除的布尔标志。当 Message 准备好运行时,Looper 线程将 CAS 其移除标志,然后将其从堆和栈中移除。
当另一个线程需要移除 Message 时,它不会立即从数据结构中提取该对象,而是会执行以下步骤:
- 逻辑移除:线程使用 CAS 以原子方式将
Message的移除标志从 false 设置为 true。Message会保留在数据结构中,作为其待移除的证据,即所谓的“墓碑”。一旦Message被标记为待移除,DeliQueue 就会将其视为不再存在于队列中。 - 延迟清理:从数据结构中实际移除数据的操作由
Looper线程负责,并会延迟到稍后执行。移除器线程不会修改堆栈或堆,而是将Message添加到另一个无锁空闲列表堆栈。 - 结构性移除:只有
Looper可以与堆进行交互或从堆栈中移除元素。唤醒后,它会清除空闲列表并处理其中包含的Message。然后,每个Message都会与堆栈解除关联,并从堆中移除。
这种方法可使堆的所有管理都保持单线程。它最大限度地减少了所需的并发操作和内存屏障数量,使关键路径更快速、更简单。
遍历:良性 Java 内存模型数据竞态
大多数并发 API(例如 Java 标准库中的 Future,或 Kotlin 的 Job 和 Deferred)都包含一种机制,可在工作完成之前将其取消。这些类的一个实例与一个底层工作单元一一对应,对对象调用 cancel 会取消与其关联的特定操作。
如今的 Android 设备配备了多核 CPU,并采用并发分代垃圾回收机制。但在 Android 刚开发出来时,为每个工作单元分配一个对象成本太高。因此,Android 的 Handler 通过 removeMessages 的众多重载支持取消,而不是移除特定的 Message,它会移除与指定条件匹配的所有 Message。在实践中,这需要遍历在调用 removeMessages 之前插入的所有 Message,并移除匹配的 Message。
向前迭代时,线程只需要一个有序原子操作来读取堆栈的当前头部。之后,系统会使用普通字段读取来查找下一个 Message。如果 Looper 线程在移除 Message 时修改了 next 字段,则 Looper 的写入和另一个线程的读取不同步,这是一种数据争用。通常,数据争用是一种严重的 bug,可能会导致应用出现严重问题,例如泄露、无限循环、崩溃、冻结等。不过,在某些特定条件下,数据争用在 Java 内存模型中可能是良性的。假设我们从以下堆栈开始:

我们对头部执行原子读取,并看到 A。A 的 next 指针指向 B。在我们处理 B 的同时,Looper 可能会通过将 A 更新为指向 C 然后指向 D 来移除 B 和 C。
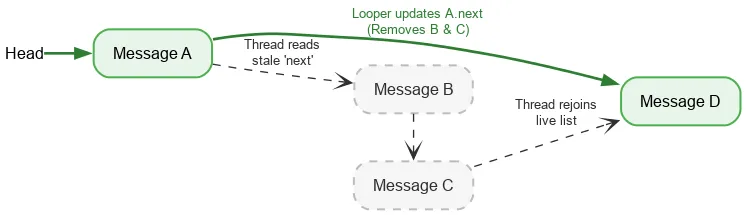
即使 B 和 C 在逻辑上已被移除,B 仍会保留其指向 C 的下一个指针,C 仍会保留其指向 D 的下一个指针。读取线程会继续遍历已分离的已移除节点,并最终在 D 处重新加入实时堆栈。
通过将 DeliQueue 设计为处理遍历和移除之间的竞争,我们实现了安全的无锁迭代。
退出:原生引用计数
Looper 由原生分配提供支持,一旦 Looper 退出,就必须手动释放该分配。如果其他某个线程在 Looper 退出时添加 Message,则可能会在原生分配释放后使用它,这违反了内存安全。我们使用带标记的引用计数来防止这种情况,其中原子的一位用于指示 Looper 是否正在退出。
在使用原生分配之前,线程会读取 refcount 原子。如果设置了退出位,则会返回 Looper 正在退出,并且不得使用原生分配。如果不是,它会尝试使用 CAS 来增加使用原生分配的活跃线程数。在完成所需操作后,它会递减计数。如果退出位是在计数递增之后但在递减之前设置的,并且计数现在为零,则会唤醒 Looper 线程。
当 Looper 线程准备退出时,它会使用 CAS 在原子中设置退出位。如果 refcount 为 0,则可以继续释放其原生分配。否则,它会自行休眠,因为知道当原生分配的最后一个用户递减引用计数时,它会被唤醒。这种方法确实意味着 Looper 线程会等待其他线程的进度,但仅在退出时如此。这种情况只会发生一次,并且对性能不敏感,它会使其他代码完全无锁地使用原生分配。
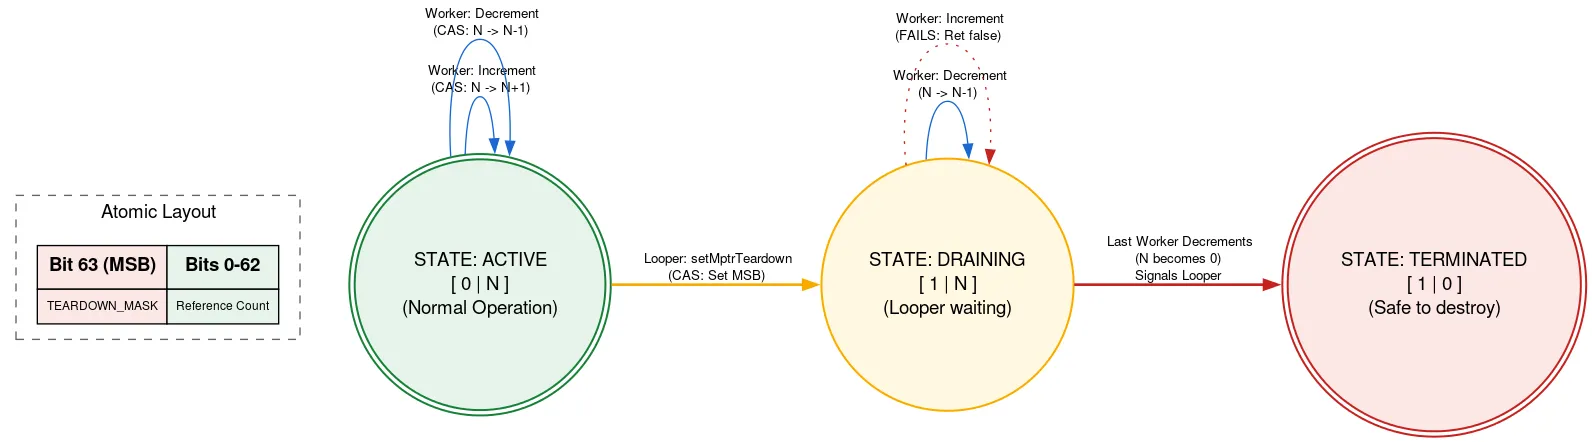
在实现过程中,还有许多其他技巧和复杂性。您可以通过查看源代码详细了解 DeliQueue。
优化:无分支编程
在开发和测试 DeliQueue 的过程中,团队运行了许多基准测试,并仔细分析了新代码。使用 simpleperf 工具发现的一个问题是,Message 比较器代码导致了流水线刷新。
标准比较器使用条件跳转,用于决定哪个 Message 排在前面的条件简化如下:
static int compareMessages(@NonNull Message m1, @NonNull Message m2) {
    if (m1 == m2) {
        return 0;
    }

    // Primary queue order is by when.
    // Messages with an earlier when should come first in the queue.
    final long whenDiff = m1.when - m2.when;
    if (whenDiff > 0) return 1;
    if (whenDiff < 0) return -1;

    // Secondary queue order is by insert sequence.
    // If two messages were inserted with the same `when`, the one inserted
    // first should come first in the queue.
    final long insertSeqDiff = m1.insertSeq - m2.insertSeq;
    if (insertSeqDiff > 0) return 1;
    if (insertSeqDiff < 0) return -1;

    return 0;
}此代码会编译为条件跳转(b.le 和 cbnz 指令)。当 CPU 遇到条件分支时,在计算出条件之前,它无法知道是否会执行该分支,因此它不知道接下来要读取哪条指令,只能使用一种称为分支预测的技术进行猜测。在二分搜索等情况下,分支方向在每一步都会发生不可预测的变化,因此有一半的预测可能会出错。分支预测在搜索和排序算法(例如最小堆中使用的算法)中通常无效,因为猜错的代价大于猜对带来的改进。如果分支预测器猜错了,它必须丢弃在假设预测值后所做的工作,并从实际采用的路径重新开始,这称为流水线刷新。
为了找出此问题,我们使用 branch-misses 性能计数器对基准进行了性能分析,该计数器会记录分支预测器猜错时的堆栈轨迹。然后,我们使用 Google pprof 直观呈现结果,如下所示:
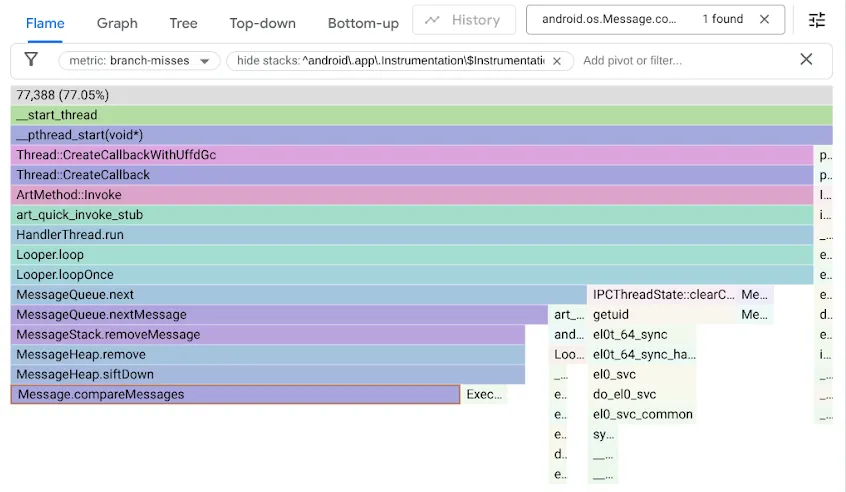
回想一下,原始 MessageQueue 代码为有序队列使用了单链表。插入操作会以线性搜索的方式按排列顺序遍历列表,在超过插入点的第一个元素处停止,并将新的 Message 链接到该元素之前。从头部移除只需解除头部关联。而 DeliQueue 使用的是最小堆,其中变更需要以对数复杂度在平衡数据结构中重新排序某些元素(向上或向下筛选),其中任何比较都有均等的机会将遍历定向到左子节点或右子节点。新算法在渐近意义上更快,但暴露了一个新的瓶颈:搜索代码有一半的时间因分支预测失误而停滞。
我们意识到分支未命中会拖慢堆代码的运行速度,因此使用无分支编程优化了代码:
// Branchless Logic
static int compareMessages(@NonNull Message m1, @NonNull Message m2) {
    final long when1 = m1.when;
    final long when2 = m2.when;
    final long insertSeq1 = m1.insertSeq;
    final long insertSeq2 = m2.insertSeq;

    // signum returns the sign (-1, 0, 1) of the argument,
    // and is implemented as pure arithmetic:
    // ((num >> 63) | (-num >>> 63))
    final int whenSign = Long.signum(when1 - when2);
    final int insertSeqSign = Long.signum(insertSeq1 - insertSeq2);

    // whenSign takes precedence over insertSeqSign,
    // so the formula below is such that insertSeqSign only matters
    // as a tie-breaker if whenSign is 0.
    return whenSign * 2 + insertSeqSign;
}为了解优化,请在 Compiler Explorer 中反汇编这两个示例,并使用 LLVM-MCA(一种可生成估计的 CPU 周期时间轴的 CPU 模拟器)。
The original code:
Index     01234567890123
[0,0]     DeER .    .  .   sub  x0, x2, x3
[0,1]     D=eER.    .  .   cmp  x0, #0
[0,2]     D==eER    .  .   cset w0, ne
[0,3]     .D==eER   .  .   cneg w0, w0, lt
[0,4]     .D===eER  .  .   cmp  w0, #0
[0,5]     .D====eER .  .   b.le #12
[0,6]     . DeE---R .  .   mov  w1, #1
[0,7]     . DeE---R .  .   b    #48
[0,8]     . D==eE-R .  .   tbz  w0, #31, #12
[0,9]     .  DeE--R .  .   mov  w1, #-1
[0,10]    .  DeE--R .  .   b    #36
[0,11]    .  D=eE-R .  .   sub  x0, x4, x5
[0,12]    .   D=eER .  .   cmp  x0, #0
[0,13]    .   D==eER.  .   cset w0, ne
[0,14]    .   D===eER  .   cneg w0, w0, lt
[0,15]    .    D===eER .   cmp  w0, #0
[0,16]    .    D====eER.   csetm        w1, lt
[0,17]    .    D===eE-R.   cmp  w0, #0
[0,18]    .    .D===eER.   csinc        w1, w1, wzr, le
[0,19]    .    .D====eER   mov  x0, x1
[0,20]    .    .DeE----R   ret
请注意,有一个条件分支 b.le,如果通过比较 when 字段已经知道结果,则可以避免比较 insertSeq 字段。
The branchless code:
Index     012345678
[0,0]     DeER .  .   sub       x0, x2, x3
[0,1]     DeER .  .   sub       x1, x4, x5
[0,2]     D=eER.  .   cmp       x0, #0
[0,3]     .D=eER  .   cset      w0, ne
[0,4]     .D==eER .   cneg      w0, w0, lt
[0,5]     .DeE--R .   cmp       x1, #0
[0,6]     . DeE-R .   cset      w1, ne
[0,7]     . D=eER .   cneg      w1, w1, lt
[0,8]     . D==eeER   add       w0, w1, w0, lsl #1
[0,9]     .  DeE--R   ret
在这里,无分支实现所用的周期和指令甚至比有分支代码的最短路径还要少,在所有情况下都更胜一筹。更快的实现加上消除预测错误的分支,使我们的某些基准测试性能提升了 5 倍!
不过,此方法并非总是适用。无分支方法通常需要执行会被丢弃的工作,如果分支在大多数情况下都是可预测的,那么这些浪费的工作可能会降低代码的运行速度。此外,移除分支通常会引入数据依赖项。现代 CPU 每个周期执行多项操作,但只有在上一条指令的输入准备就绪后,才能执行下一条指令。相比之下,CPU 可以推测分支中的数据,并在分支预测正确的情况下提前工作。
测试和验证
众所周知,验证无锁算法的正确性非常困难!
除了在开发过程中进行持续验证的标准单元测试外,我们还编写了严格的压力测试,以验证队列不变量,并尝试诱发数据争用(如果存在)。在我们的测试实验室中,我们可以在模拟设备和真实硬件上运行数百万个测试实例。
借助 Java ThreadSanitizer (JTSan) 插桩,我们还可以使用相同的测试来检测代码中的一些数据竞态。JTSan 未在 DeliQueue 中发现任何有问题的数据争用,但令人惊讶的是,它在 Robolectric 框架中检测到了两个并发 bug,我们立即修复了这两个 bug。
为了提高调试能力,我们构建了新的分析工具。以下示例展示了 Android 平台代码中的一个问题:一个线程向另一个线程发送了过多的 Message,导致大量积压,由于我们添加了 MessageQueue 插桩功能,因此可以在 Perfetto 中看到这一问题。
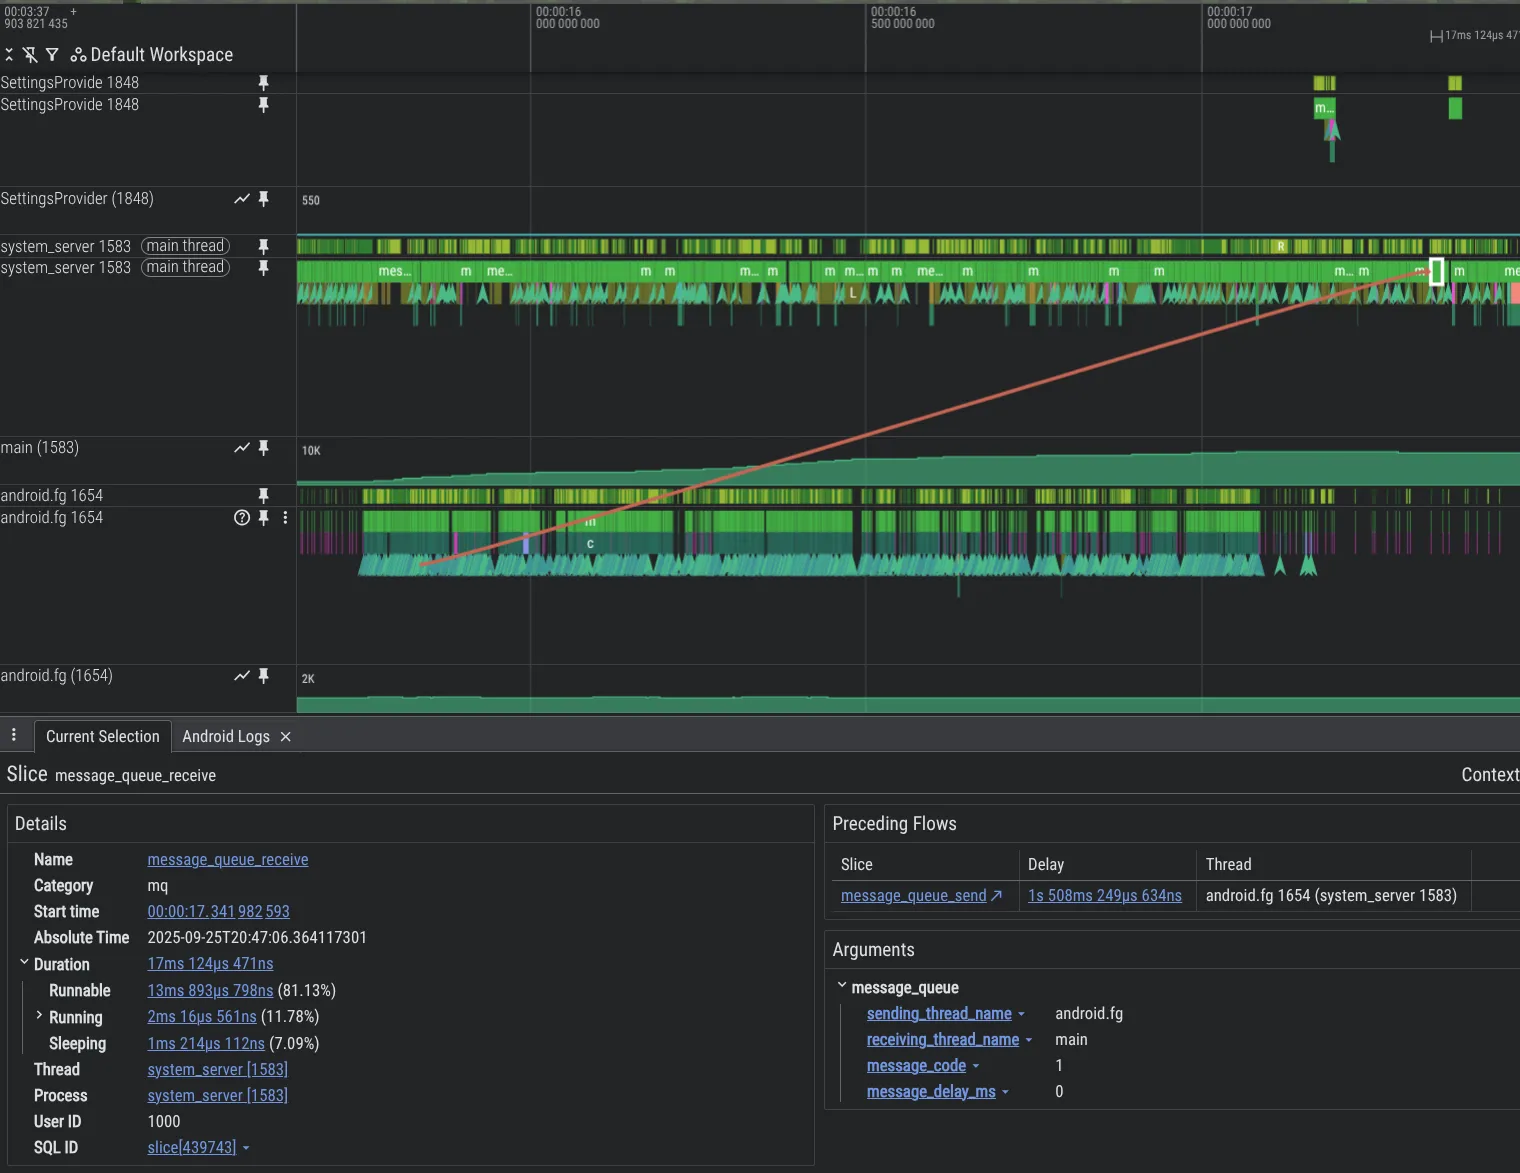
如需在 system_server 进程中启用 MessageQueue 跟踪,请在 Perfetto 配置中添加以下内容:
data_sources {
  config {
    name: "track_event"
    target_buffer: 0  # Change this per your buffers configuration
    track_event_config {
      enabled_categories: "mq"
    }
  }
}
影响
DeliQueue 通过消除 MessageQueue 中的锁来提高系统和应用性能。
- 合成基准测试:由于并发性得到改进(Treiber 堆栈)且插入速度更快(最小堆),向繁忙队列中进行多线程插入的速度比旧版
MessageQueue快 5,000 倍。 - 在从内部 Beta 版测试人员处获取的 Perfetto 跟踪记录中,我们发现应用主线程在锁争用方面花费的时间减少了 15%。
- 在相同的测试设备上,锁争用减少可显著改善用户体验,例如:
- 应用中丢失的帧数减少了 4%。
- 系统界面和启动器互动中的丢帧率降低了 7.7%。
- 从应用启动到绘制第一帧的时间减少了 9.1%(第 95 百分位)。
后续步骤
DeliQueue 将在 Android 17 中向应用发布。应用开发者应查看 Android 开发者博客上的“为应用做好准备,迎接全新无锁 MessageQueue”一文,了解如何测试其应用。
参考编号
[1] Treiber, R.K.,1986。系统编程:应对并行性。International Business Machines Incorporated, Thomas J. Watson Research Center。
[2] Goetz, B.、Peierls, T.、Bloch, J.、Bowbeer, J.、Holmes, D.、和 Lea, D. (2006). Java Concurrency in Practice。Addison-Wesley Professional。
-
 产品资讯
随着智能体开发不断加速,Android 工程领域正迈向一个令人振奋的新境界:从辅助性代码补全,跃升至智能体在您的指挥下执行端到端任务。您可以完全自主、灵活地选择要使用的模型和智能体。
Jason Buchel • 阅读用时:3 分钟 -
 产品资讯
今天,我们分享了如何将“不只是商店”的愿景推进到下一个阶段。从月活跃用户数超过 2.5 亿的“我”标签页,到连接超过 7 亿玩家资料的统一游戏平台,Google Play 始终致力于满足用户的各种需求。
Paul Feng • 阅读用时:3 分钟 -
 产品资讯
我们很高兴能通过 Googlebook 帮助用户表达自我,并让他们能够使用这些工具。
Cyrus Stoller • 阅读用时:2 分钟
每周通过电子邮件接收最新的 Android 开发洞见。