Android 17-এ, SDK 37 বা তার পরবর্তী ভার্সনকে টার্গেট করা অ্যাপগুলি MessageQueue-এর একটি নতুন ইমপ্লিমেন্টেশন পাবে যেখানে ইমপ্লিমেন্টেশনটি লক-ফ্রি। নতুন প্রয়োগ পারফর্ম্যান্স উন্নত করে এবং মিস করা ফ্রেম কমায়, তবে MessageQueue ব্যক্তিগত ফিল্ড এবং পদ্ধতিতে প্রতিফলিত ক্লায়েন্টকে ব্রেক করতে পারে। আচরণগত পরিবর্তন এবং কীভাবে আপনি প্রভাব কমাতে পারেন সেই সম্পর্কে আরও জানতে, MessageQueue আচরণগত পরিবর্তন সংক্রান্ত ডকুমেন্টেশন চেক করুন। এই টেকনিক্যাল ব্লগ পোস্ট MessageQueue রিআর্কিটেকচারের ওভারভিউ প্রদান করে এবং আপনি কীভাবে Perfetto ব্যবহার করে লক কনটেনশন সংক্রান্ত সমস্যা বিশ্লেষণ করতে পারবেন তা জানায়।
Looper প্রতিটি Android অ্যাপ্লিকেশনের UI থ্রেড চালায়। এটি MessageQueue থেকে কাজ নিয়ে Handler-এ পাঠায় এবং এই প্রসেস রিপিট করে। দু'দশক ধরে, MessageQueue তার স্টেট সুরক্ষিত রাখতে একটি একক মনিটর লক (অর্থাৎ একটি synchronized কোড ব্লক) ব্যবহার করেছে।
Android 17 এই কম্পোনেন্টে একটি গুরুত্বপূর্ণ আপডেট নিয়ে এসেছে: লক-ফ্রি ইমপ্লিমেন্টেশন যার নাম DeliQueue।
এই পোস্টে ব্যাখ্যা করা হয়েছে যে লক কীভাবে UI পারফর্ম্যান্সকে প্রভাবিত করে, Perfetto-এর মাধ্যমে কীভাবে এইসব সমস্যা বিশ্লেষণ করা যায় এবং Android-এর মূল থ্রেড উন্নত করতে কোন নির্দিষ্ট অ্যালগরিদম ও অপ্টিমাইজেশন ব্যবহার করা হয়।
সমস্যা: লক কনটেনশন ও প্রায়োরিটি ইনভার্সন
পুরনো MessageQueue একটি লক দ্বারা সুরক্ষিত প্রায়োরিটি কিউ হিসেবে কাজ করত। প্রধান থ্রেড সারি রক্ষণাবেক্ষণ করার সময় ব্যাকগ্রাউন্ড থ্রেড কোনও মেসেজ পোস্ট করলে, ব্যাকগ্রাউন্ড থ্রেড প্রধান থ্রেডকে ব্লক করে।
যখন দুই বা তার বেশি থ্রেড একই লকের এক্সক্লুসিভ ব্যবহারের জন্য প্রতিযোগিতা করে, তখন এটিকে লক কনটেনশন বলা হয়। এই বিরোধের ফলে প্রায়োরিটি ইনভার্সন হতে পারে, যার ফলে UI জ্যাঙ্ক ও অন্যান্য পারফর্ম্যান্স সংক্রান্ত সমস্যা দেখা দিতে পারে।
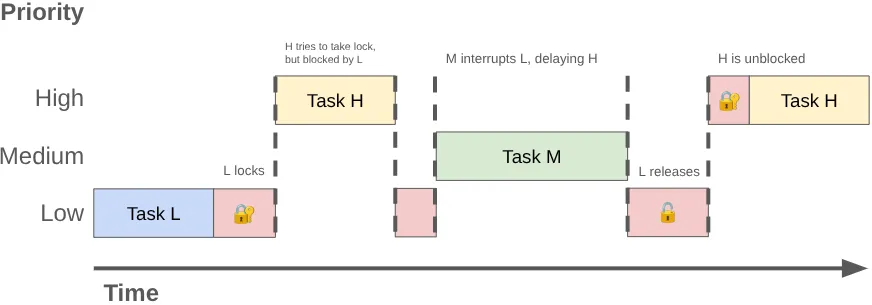
অগ্রাধিকার ইনভার্সন তখন হতে পারে যখন একটি উচ্চ-অগ্রাধিকার থ্রেড (যেমন UI থ্রেড) একটি কম-অগ্রাধিকার থ্রেডের জন্য অপেক্ষা করে। এই ক্রমটি বিবেচনা করুন:
- একটি কম অগ্রাধিকার ব্যাকগ্রাউন্ড থ্রেড
MessageQueueলক অর্জন করে যাতে এটি যে কাজ করেছে তার ফলাফল পোস্ট করতে পারে। - একটি মাঝারি অগ্রাধিকার থ্রেড রান করার উপযুক্ত হয়ে ওঠে এবং কার্নেলের শিডিউলার এটিকে সিপিইউ টাইম বরাদ্দ করে, কম অগ্রাধিকারের থ্রেডকে প্রিএম্পট করে।
- উচ্চ অগ্রাধিকার UI থ্রেড তার বর্তমান টাস্ক শেষ করে এবং সারি থেকে পড়ার চেষ্টা করে, কিন্তু ব্লক হয়ে যায় কারণ কম অগ্রাধিকারের থ্রেড লকটি ধরে রাখে।
কম-অগ্রাধিকার থ্রেড UI থ্রেডকে ব্লক করে এবং মাঝারি-অগ্রাধিকারের কাজ এটিকে আরও বিলম্বিত করে।
Perfetto-এর মাধ্যমে কনটেনশন বিশ্লেষণ করা
আপনি Perfetto ব্যবহার করে এইসব সমস্যা ডায়াগনসিস করতে পারবেন। স্ট্যান্ডার্ড ট্রেসে, মনিটর লকে ব্লক করা থ্রেড স্লিপিং স্টেটে প্রবেশ করে এবং Perfetto একটি স্লাইস দেখায় যা লকের মালিককে নির্দেশ করে।
আপনি ট্রেস ডেটা কোয়েরি করার সময়, “...-এর সাথে মনিটর কনটেনশন” নামের স্লাইস খুঁজুন, যার পরে লকটির মালিকানাধীন থ্রেডের নাম এবং লকটি যে কোড সাইটে অর্জিত হয়েছিল তার নাম থাকে।
কেস স্টাডি: লঞ্চার জ্যাঙ্ক
উদাহরণস্বরূপ, আসুন এমন একটি ট্রেস বিশ্লেষণ করি যেখানে একজন ব্যবহারকারী ক্যামেরা অ্যাপে ফটো তোলার ঠিক পরেই একটি Pixel ফোনে হোমে নেভিগেট করার সময় জ্যাঙ্ক অনুভব করেছিলেন। নিচে আমরা Perfetto-এর একটি স্ক্রিনশট দেখতে পাচ্ছি যা মিস করা ফ্রেমের দিকে নিয়ে যাওয়া ইভেন্টগুলি দেখাচ্ছে:
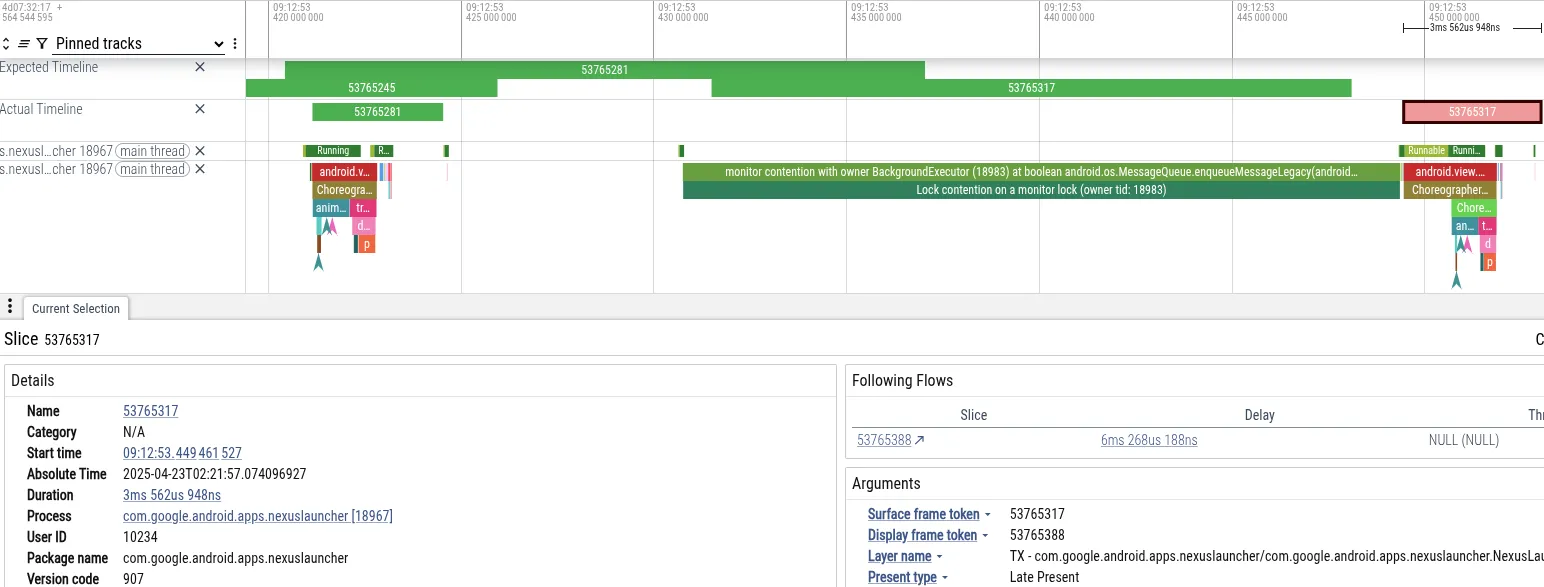
- লক্ষণ: লঞ্চার মূল থ্রেড তার ফ্রেমের ডেডলাইন মিস করেছে। এটি ১৮ মিলিসেকেন্ডের জন্য ব্লক করা হয়েছে, যা ৬০ হার্টজ রেন্ডারিংয়ের জন্য প্রয়োজনীয় ১৬ মিলিসেকেন্ডের সময়সীমা অতিক্রম করেছে।
- ডায়াগনসিস: Perfetto দেখিয়েছে যে
MessageQueueলকে মূল থ্রেড ব্লক করা হয়েছে। "BackgroundExecutor" থ্রেড লকটি দখল করে রেখেছে। - মূল কারণ: BackgroundExecutor Process.THREAD_PRIORITY_BACKGROUND (খুব কম অগ্রাধিকার) হিসেবে রান করে। এটি একটি জরুরি নয় এমন টাস্ক (অ্যাপ ব্যবহারের সীমা চেক করা) সম্পূর্ণ করেছে। একই সাথে, মাঝারি অগ্রাধিকারের থ্রেডগুলি ক্যামেরা থেকে ডেটা প্রসেস করার জন্য সিপিইউ টাইম ব্যবহার করছিল। OS শিডিউলার ক্যামেরা থ্রেড চালানোর জন্য BackgroundExecutor থ্রেডকে প্রি-এম্পট করেছে।
এই সিকোয়েন্সের কারণে লঞ্চারের UI থ্রেড (বেশি অগ্রাধিকার) ক্যামেরা ওয়ার্কার থ্রেড (মাঝারি অগ্রাধিকার) দ্বারা পরোক্ষভাবে ব্লক হয়ে যায়, যা লঞ্চারের ব্যাকগ্রাউন্ড থ্রেডকে (কম অগ্রাধিকার) লক রিলিজ করা থেকে বিরত রাখে।
PerfettoSQL-এর মাধ্যমে ট্রেস কোয়েরি করা
আপনি PerfettoSQL ব্যবহার করে নির্দিষ্ট প্যাটার্নের জন্য ট্রেস ডেটা কোয়েরি করতে পারবেন। ব্যবহারকারীর ডিভাইস বা টেস্ট থেকে আপনার কাছে অনেক ট্রেস থাকলে এবং আপনি কোনও সমস্যা দেখায় এমন নির্দিষ্ট ট্রেস খুঁজলে এটি কাজে লাগে।
যেমন, এই কোয়েরি MessageQueue কন্টেনশন খুঁজে পায় যা ড্রপ করা ফ্রেমের (জ্যাঙ্ক) সাথে মিলে যায়:
INCLUDE PERFETTO MODULE android.monitor_contention;
INCLUDE PERFETTO MODULE android.frames.jank_type;

SELECT
  process_name,
  -- Convert duration from nanoseconds to milliseconds
  SUM(dur) / 1000000 AS sum_dur_ms,
  COUNT(*) AS count_contention
FROM android_monitor_contention
WHERE is_blocked_thread_main
AND short_blocked_method LIKE "%MessageQueue%"

-- Only look at app processes that had jank
AND upid IN (
  SELECT DISTINCT(upid)
  FROM actual_frame_timeline_slice
  WHERE android_is_app_jank_type(jank_type) = TRUE
)
GROUP BY process_name
ORDER BY SUM(dur) DESC;
এই আরও জটিল উদাহরণে, অ্যাপ স্টার্টআপের সময় MessageQueue প্রতিযোগিতা শনাক্ত করতে একাধিক টেবিল জুড়ে থাকা ট্রেস ডেটা যোগ করুন:
INCLUDE PERFETTO MODULE android.monitor_contention;
INCLUDE PERFETTO MODULE android.startup.startups;

-- Join package and process information for startups
DROP VIEW IF EXISTS startups;
CREATE VIEW startups AS
SELECT startup_id, ts, dur, upid
FROM android_startups
JOIN android_startup_processes USING(startup_id);

-- Intersect monitor contention with startups in the same process.
DROP TABLE IF EXISTS monitor_contention_during_startup;
CREATE VIRTUAL TABLE monitor_contention_during_startup
USING SPAN_JOIN(android_monitor_contention PARTITIONED upid, startups PARTITIONED upid);

SELECT
  process_name,
  SUM(dur) / 1000000 AS sum_dur_ms,
  COUNT(*) AS count_contention
FROM monitor_contention_during_startup
WHERE is_blocked_thread_main
AND short_blocked_method LIKE "%MessageQueue%"
GROUP BY process_name
ORDER BY SUM(dur) DESC;
অন্যান্য প্যাটার্ন খুঁজে পেতে PerfettoSQL কোয়েরি লিখতে আপনার পছন্দের LLM ব্যবহার করতে পারেন।
Google-এ, আমরা BigTrace ব্যবহার করে লক্ষ লক্ষ ট্রেস জুড়ে PerfettoSQL কোয়েরি রান করি। এটি করার সময় আমরা কনফার্ম করেছি যে, আমরা যা দেখেছি তা আসলে সিস্টেম সংক্রান্ত সমস্যা। ডেটা থেকে জানা গেছে যে MessageQueue লক কনটেনশন সম্পূর্ণ ইকোসিস্টেম জুড়ে ব্যবহারকারীদের প্রভাবিত করে, যা মৌলিক আর্কিটেকচারাল পরিবর্তনের প্রয়োজনীয়তা প্রমাণ করে।
সমাধান: লক-ফ্রি কনকারেন্সি
আমরা MessageQueue প্রতিযোগিতা সংক্রান্ত সমস্যার সমাধান করেছি লক-ফ্রি ডেটা স্ট্রাকচার প্রয়োগ করে, শেয়ার করা স্টেট অ্যাক্সেস সিঙ্ক করার জন্য এক্সক্লুসিভ লকের পরিবর্তে অ্যাটমিক মেমরি অপারেশন ব্যবহার করে। অন্যান্য থ্রেডের শিডিউলিং আচরণ নির্বিশেষে অন্তত একটি থ্রেড যদি সবসময় অগ্রগতি করতে পারে, তাহলে একটি ডেটা স্ট্রাকচার বা অ্যালগরিদম লক-ফ্রি হয়। এই প্রপার্টি সাধারণত অর্জন করা কঠিন এবং বেশিরভাগ কোডের জন্য সাধারণত অনুসরণ করার যোগ্য নয়।
অ্যাটমিক প্রিমিটিভ
লক-ফ্রি সফ্টওয়্যার প্রায়শই হার্ডওয়্যার দ্বারা প্রদত্ত অ্যাটমিক রিড-মডিফাই-রাইট প্রিমিটিভের উপর নির্ভর করে।
পুরনো জেনারেশনের ARM64 CPU-তে, অ্যাটমিক্স লোড-লিঙ্ক/স্টোর-কন্ডিশনাল (LL/SC) লুপ ব্যবহার করে। CPU একটি ভ্যালু লোড করে এবং অ্যাড্রেস চিহ্নিত করে। অন্য কোনও থ্রেড সেই অ্যাড্রেসে লিখলে, স্টোর ব্যর্থ হয় এবং লুপ আবার চেষ্টা করে। যেহেতু থ্রেডগুলি অন্য থ্রেডের জন্য অপেক্ষা না করেই চেষ্টা চালিয়ে যেতে এবং সফল হতে পারে, তাই এই অপারেশনটি লক-মুক্ত।
ARM64 LL/SC loop example
retry:
    ldxr    x0, [x1]        // Load exclusive from address x1 to x0
    add     x0, x0, #1      // Increment value by 1
    stxr    w2, x0, [x1]    // Store exclusive.
                            // w2 gets 0 on success, 1 on failure
cbnz w2, retry // If w2 is non-zero (failed), branch to retrনতুন ARM আর্কিটেকচার (ARMv8.1) লার্জ সিস্টেম এক্সটেনশন (LSE) সাপোর্ট করে যার মধ্যে Compare-And-Swap (CAS) বা Load-And-Add (নিচে দেখানো হয়েছে) ফর্ম্যাটে নির্দেশাবলী থাকে। Android 17-এ আমরা Android Runtime (ART) কম্পাইলারে সহায়তা যোগ করেছি যাতে LSE কখন কাজ করে তা শনাক্ত করা যায় এবং অপ্টিমাইজ করা নির্দেশাবলী প্রকাশ করা যায়:
/ ARMv8.1 LSE atomic example
ldadd   x0, x1, [x2]    // Atomic load-add.
                        // Faster, no loop required.
আমাদের বেঞ্চমার্কে, CAS ব্যবহার করে এমন হাই-কনটেনশন কোড LL/SC ভেরিয়েন্টের থেকে ~3x বেশি স্পিড অর্জন করে।
Java প্রোগ্রামিং ল্যাঙ্গুয়েজ java.util.concurrent.atomic এর মাধ্যমে অ্যাটমিক প্রিমিটিভ অফার করে যা এগুলি এবং অন্যান্য বিশেষ CPU নির্দেশের উপর নির্ভর করে।
ডেটা স্ট্রাকচার: DeliQueue
MessageQueue থেকে লক কনটেনশন সরাতে, আমাদের ইঞ্জিনিয়াররা DeliQueue নামে একটি নতুন ডেটা স্ট্রাকচার ডিজাইন করেছেন। DeliQueue Message-এর প্রসেসিং থেকে Message ইনসার্ট করাকে আলাদা করে:
-
Messages-এর তালিকা (Treiber stack): লক-ফ্রি স্ট্যাক। যেকোনও থ্রেড কোনও বিরোধ ছাড়াই এখানে নতুনMessagesপুশ করতে পারে। - অগ্রাধিকার কিউ (Min-heap): ম্যানেজ করার জন্য
Messages-এর একটি হিপ, যা একচেটিয়াভাবে Looper থ্রেডের মালিকানাধীন (তাই অ্যাক্সেস করার জন্য কোনও সিঙ্ক্রোনাইজেশন বা লকের প্রয়োজন নেই)।
Enqueue: Treiber স্ট্যাকে পুশ করা হচ্ছে
Messages-এর তালিকা Treiber স্ট্যাক [1]-এ রাখা হয়, এটি একটি লক-ফ্রি স্ট্যাক যা হেড পয়েন্টার আপডেট করার জন্য CAS লুপ ব্যবহার করে।
public class TreiberStack <E> {
    AtomicReference<Node<E>> top =
            new AtomicReference<Node<E>>();
    public void push(E item) {
        Node<E> newHead = new Node<E>(item);
        Node<E> oldHead;
        do {
            oldHead = top.get();
            newHead.next = oldHead;
        } while (!top.compareAndSet(oldHead, newHead));
    }

    public E pop() {
        Node<E> oldHead;
        Node<E> newHead;
        do {
            oldHead = top.get();
            if (oldHead == null) return null;
            newHead = oldHead.next;
        } while (!top.compareAndSet(oldHead, newHead));
        return oldHead.item;
    }
}
Java Concurrency in Practice [2]-এর উপর ভিত্তি করে সোর্স কোড, অনলাইনে উপলভ্য এবং পাবলিক ডোমেনে রিলিজ করা হয়েছে
যেকোনও প্রযোজক যেকোনও সময় স্ট্যাকে নতুন Message পুশ করতে পারেন। এটি কোনও ডেলি কাউন্টারে টিকিট তোলার মতো - আপনি কখন এসেছেন তার উপর ভিত্তি করে আপনার নম্বর নির্ধারণ করা হয়, তবে আপনি যে ক্রমে আপনার খাবার পাবেন তা মিলতে হবে না। যেহেতু এটি একটি লিঙ্ক করা স্ট্যাক, তাই প্রতিটি Message হল একটি সাব-স্ট্যাক - আপনি হেড ট্র্যাক করে এবং সামনের দিকে পুনরাবৃত্তি করে যেকোনও সময়ে Message কিউ কেমন ছিল তা দেখতে পারবেন - আপনি উপরে পুশ করা কোনও নতুন Message দেখতে পাবেন না, এমনকি আপনার ট্রাভার্সালের সময় সেগুলি যোগ করা হলেও।
ডিকিউ: মিন-হিপে বাল্ক ট্রান্সফার
ম্যানেজ করার জন্য পরবর্তী Message খুঁজতে, Looper Treiber স্ট্যাক থেকে নতুন Message প্রসেস করে। এটি করার জন্য, স্ট্যাকের উপর থেকে শুরু করে এবং শেষ Message না পাওয়া পর্যন্ত এটি পুনরাবৃত্তি করে যা এটি আগে প্রসেস করেছে। যেহেতু Looper স্ট্যাকের নিচের দিকে যায়, তাই এটি ডেডলাইন-অর্ডার করা মিন-হিপে Message যোগ করে। যেহেতু Looper-এর কাছে হিপের এক্সক্লুসিভ মালিকানা থাকে, তাই এটি লক বা অ্যাটমিক ছাড়াই Message অর্ডার ও প্রসেস করে।
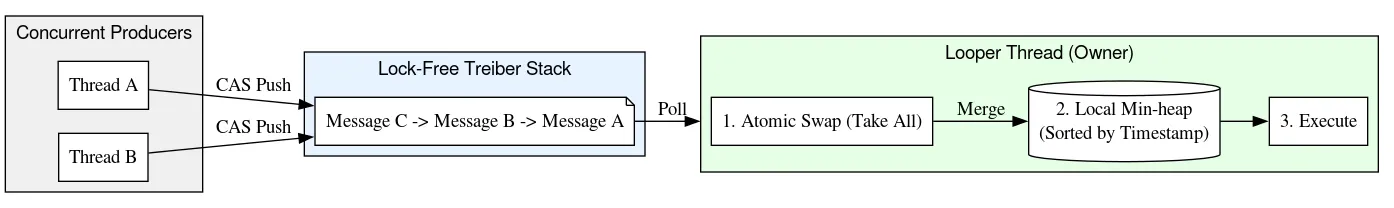
স্ট্যাকের নিচের দিকে যাওয়ার সময়, Looper স্ট্যাক করা Message থেকে তাদের পূর্বসূরীদের কাছে লিঙ্ক তৈরি করে, এইভাবে একটি ডবল-লিঙ্ক করা তালিকা তৈরি করে। লিঙ্ক করা তালিকা তৈরি করা নিরাপদ কারণ স্ট্যাকের নিচের দিকে নির্দেশ করা লিঙ্কগুলি CAS সহ Treiber স্ট্যাক অ্যালগরিদমের মাধ্যমে যোগ করা হয় এবং স্ট্যাকের উপরের লিঙ্কগুলি শুধুমাত্র Looper থ্রেড দ্বারা পড়া এবং পরিবর্তন করা হয়। এই ব্যাক লিঙ্কগুলি তারপর O(1) সময়ে স্ট্যাকের নির্বিচারে পয়েন্ট থেকে Messages সরাতে ব্যবহার করা হয়।
এই ডিজাইন প্রোডিউসারের(কিউতে থ্রেড পোস্টিংয়ের কাজ) জন্য O (1) ইনসার্শন এবং কনজিউমারের(Looper) জন্য অ্যামর্টাইজড O (log N) প্রসেসিং প্রদান করে।
Message-এর ক্রম নির্ধারণ করতে মিন-হিপ ব্যবহার করলে, লিগ্যাসি MessageQueue-এর মৌলিক ত্রুটিও সমাধান করা যায়, যেখানে Message-কে সিঙ্গল-লিঙ্কড তালিকায় (উপরে রুট করা) রাখা হয়েছিল। পুরনো ইমপ্লিমেন্টেশনে, হেড থেকে সরানো ছিল O(1), কিন্তু ইনসার্ট করার ক্ষেত্রে সবচেয়ে খারাপ পরিস্থিতি ছিল O(N) – ওভারলোড হওয়া কিউয়ের জন্য স্কেলিং খারাপ ছিল! অন্যদিকে, মিন-হিপে যোগ করা এবং সেখান থেকে সরানো লগারিদমিকভাবে স্কেল করে, প্রতিযোগিতামূলক গড় পারফর্ম্যান্স প্রদান করে তবে টেল লেটেন্সিতে সত্যিই দুর্দান্ত পারফর্ম করে।
লিগ্যাসি (লক করা) MessageQueue | DeliQueue | |
| যোগ করুন | O(N) | O(১) থ্রেড কল করার জন্য
|
| মাথা থেকে সরান | O(১) | O(logN) |
লেগেসি কিউ ইমপ্লিমেন্টেশনে, প্রোডিউসার ও কনজিউমার, অন্তর্নিহিত সিঙ্গলি-লিঙ্কড লিস্টে এক্সক্লুসিভ অ্যাক্সেস কোঅর্ডিনেট করার জন্য লক ব্যবহার করত। DeliQueue-এ, Treiber স্ট্যাক কনকারেন্ট অ্যাক্সেস ম্যানেজ করে এবং একজন গ্রাহক তার কাজের সারি অর্ডার করা ম্যানেজ করে।
সরানো: টুম্বস্টোনের মাধ্যমে ধারাবাহিকতা
DeliQueue হল একটি হাইব্রিড ডেটা স্ট্রাকচার, যা একটি লক-ফ্রি ট্রাইবার স্ট্যাককে একটি সিঙ্গেল-থ্রেডেড মিন-হিপের সাথে যুক্ত করে। গ্লোবাল লক ছাড়াই এই দুটি স্ট্রাকচার সিঙ্ক করে রাখা একটি অনন্য চ্যালেঞ্জ উপস্থাপন করে: একটি মেসেজ স্ট্যাকে শারীরিকভাবে উপস্থিত থাকতে পারে তবে লজিক্যালি সারি থেকে সরানো হতে পারে।
এই সমস্যার সমাধান করতে, DeliQueue "টুম্বস্টোনিং" নামক একটি টেকনিক ব্যবহার করে। প্রতিটি Message ব্যাকওয়ার্ড ও ফরওয়ার্ড পয়েন্টারের মাধ্যমে স্ট্যাকে নিজের পজিশন, হিপের অ্যারেতে নিজের ইন্ডেক্স এবং এটি সরানো হয়েছে কিনা তা নির্দেশকারী একটি বুলিয়ান ফ্ল্যাগ ট্র্যাক করে। Message রান করার জন্য রেডি হলে, Looper থ্রেড এটির সরানো ফ্ল্যাগ CAS করবে, তারপর এটি হিপ ও স্ট্যাক থেকে সরিয়ে দেবে।
অন্য কোনও থ্রেডকে Message সরাতে হলে, এটি ডেটা স্ট্রাকচার থেকে অবিলম্বে তা এক্সট্র্যাক্ট করে না। পরিবর্তে, এটি নিম্নলিখিত ধাপগুলি অনুসরণ করে:
- লজিক্যাল রিমুভাল: থ্রেডটি CAS ব্যবহার করে
Message-এর রিমুভাল ফ্ল্যাগকে ফলস থেকে ট্রু-তে অ্যাটমিক্যালি সেট করে।Messageডেটা স্ট্রাকচারে থেকে যায়, যা থেকে বোঝা যায় যে এটি সরানোর কাজ বাকি আছে, একে "টুম্বস্টোন" বলা হয়। কোনওMessageসরানোর জন্য ফ্ল্যাগ করা হলে, DeliQueue এটিকে এমনভাবে ট্রিট করে যেন এটি আর সারিতে নেই। - বিলম্বিত ক্লিন-আপ: ডেটা স্ট্রাকচার থেকে প্রকৃত অপসারণের দায়িত্ব
Looperথ্রেডের এবং এটি পরে পর্যন্ত স্থগিত করা হয়। স্ট্যাক বা হিপ পরিবর্তন করার পরিবর্তে, রিমুভার থ্রেডMessage-কে অন্য একটি লক-ফ্রি ফ্রিলিস্ট স্ট্যাকে যোগ করে। - স্ট্রাকচারাল রিমুভাল: শুধুমাত্র
Looperহিপের সাথে ইন্টার্যাক্ট করতে বা স্ট্যাক থেকে এলিমেন্ট সরাতে পারে। এটি জেগে উঠলে, এটি ফ্রিলিস্ট মুছে দেয় এবং এতে থাকাMessageপ্রসেস করে। প্রতিটিMessageতারপর স্ট্যাক থেকে আনলিঙ্ক করা হয় এবং হিপ থেকে সরানো হয়।
এই পদ্ধতি হিপের সব ম্যানেজমেন্টকে সিঙ্গেল-থ্রেডেড রাখে। এটি একই সাথে চলা অপারেশন এবং মেমরি বাধার সংখ্যা কমিয়ে দেয়, যার ফলে ক্রিটিক্যাল পাথ দ্রুত এবং সহজ হয়।
ট্রাভার্সাল: বিনাইন জাভা মেমরি মডেল ডেটা রেস
বেশিরভাগ কনকারেন্সি API, যেমন Java স্ট্যান্ডার্ড লাইব্রেরিতে Future বা Kotlin-এর Job এবং Deferred, কাজ সম্পূর্ণ হওয়ার আগে তা বাতিল করার মেকানিজম অন্তর্ভুক্ত করে। এইসব ক্লাসের একটি ইনস্ট্যান্স, অন্তর্নিহিত কাজের একটি ইউনিটের সাথে ১:১ ম্যাচ করে এবং কোনও অবজেক্টে cancel কল করলে, সেটির সাথে যুক্ত নির্দিষ্ট অপারেশন বাতিল হয়ে যায়।
আজকের Android ডিভাইসে মাল্টি-কোর CPU এবং কনকারেন্ট, জেনারেশনাল গার্বেজ কালেকশন থাকে। কিন্তু Android যখন প্রথম ডেভেলপ করা হয়েছিল, তখন প্রতিটি কাজের ইউনিটের জন্য একটি করে অবজেক্ট বরাদ্দ করা খুব ব্যয়বহুল ছিল। ফলস্বরূপ, Android-এর Handler removeMessages-এর অসংখ্য ওভারলোডের মাধ্যমে বাতিলকরণকে সমর্থন করে - নির্দিষ্ট Message সরানোর পরিবর্তে, এটি নির্দিষ্ট মানদণ্ডের সাথে মেলে এমন সমস্ত Message সরিয়ে দেয়। ব্যবহারিক ক্ষেত্রে, এর জন্য removeMessages কল করার আগে যোগ করা সব Message-এর মাধ্যমে ইটারেট করতে হবে এবং যেগুলি ম্যাচ করবে সেগুলি সরিয়ে দিতে হবে।
সামনের দিকে ইটারেট করার সময়, স্ট্যাকের বর্তমান হেড রিড করার জন্য থ্রেডের শুধুমাত্র একটি অর্ডার করা অ্যাটমিক অপারেশন প্রয়োজন হয়। তারপরে, পরবর্তী Message খুঁজতে সাধারণ ফিল্ড রিড ব্যবহার করা হয়। Message সরানোর সময় Looper থ্রেড next ফিল্ড পরিবর্তন করলে, Looper-এর লেখা এবং অন্য থ্রেডের পড়া সিঙ্ক করা থাকে না - এটি হল ডেটা রেস। সাধারণত, ডেটা রেস হল একটি গুরুতর সমস্যা যা আপনার অ্যাপে বিশাল সমস্যা সৃষ্টি করতে পারে - লিক, ইনফিনিট লুপ, ক্র্যাশ, ফ্রিজ এবং আরও অনেক কিছু। তবে, কিছু নির্দিষ্ট সংকীর্ণ পরিস্থিতিতে, জাভা মেমরি মডেলের মধ্যে ডেটা রেস ক্ষতিকর নাও হতে পারে। ধরা যাক, আমরা এই স্ট্যাক দিয়ে শুরু করছি:

আমরা হেডের অ্যাটমিক রিড পারফর্ম করি এবং A দেখতে পাই। A-এর পরবর্তী পয়েন্টার B-কে পয়েন্ট করে। আমরা B প্রসেস করার সাথে সাথেই, লুপার হয়ত B এবং C সরিয়ে দেবে, A-কে আপডেট করে C এবং তারপর D-তে পয়েন্ট করার মাধ্যমে।
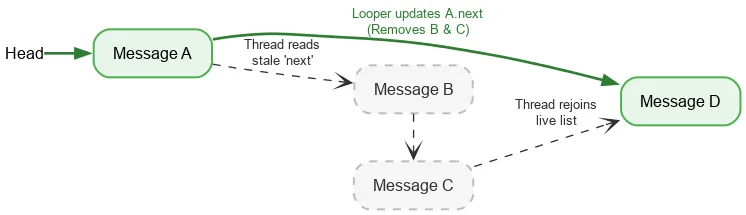
যদিও B এবং C লজিক্যালি সরিয়ে দেওয়া হয়েছে, B-এর পরবর্তী পয়েন্টার C-এ এবং C-এর পরবর্তী পয়েন্টার D-এ থেকে যায়। রিডিং থ্রেডটি বিচ্ছিন্ন সরানো নোডের মাধ্যমে ট্রাভার্স করা চালিয়ে যায় এবং অবশেষে D-এ লাইভ স্ট্যাকে আবার যোগ দেয়।
ট্রাভার্সাল ও রিমুভালের মধ্যে রেস ম্যানেজ করার জন্য DeliQueue ডিজাইন করার মাধ্যমে, আমরা নিরাপদ, লক-ফ্রি ইটারেশনের অনুমতি দিই।
বন্ধ করা হচ্ছে: নেটিভ refcount
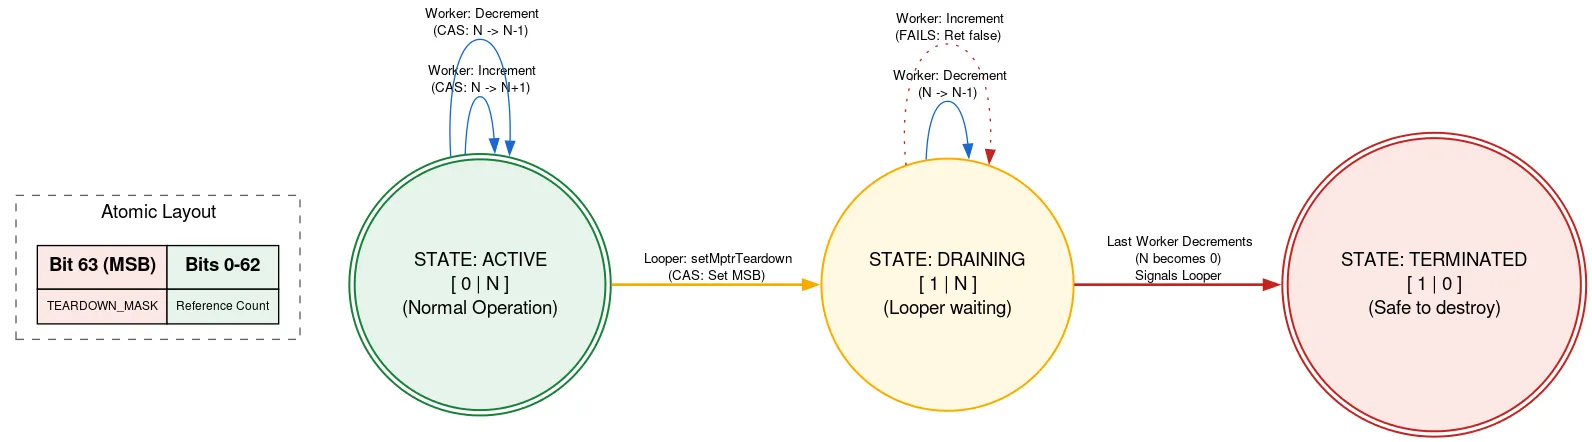
Looper নেটিভ অ্যালোকেশন দ্বারা ব্যাক-আপ করা হয় যা Looper বন্ধ হয়ে গেলে ম্যানুয়ালি ফ্রি করতে হবে। Looper বন্ধ হওয়ার সময় অন্য কোনও থ্রেড Message যোগ করলে, এটি খালি হওয়ার পরে নেটিভ অ্যালোকেশন ব্যবহার করতে পারে, যা মেমরি নিরাপত্তা লঙ্ঘন করে। আমরা ট্যাগ করা refcount ব্যবহার করে এটি প্রতিরোধ করি, যেখানে অ্যাটমিকের একটি বিট ব্যবহার করে Looper ছেড়ে যাচ্ছে কিনা তা দেখানো হয়।
নেটিভ অ্যালোকেশন ব্যবহার করার আগে, একটি থ্রেড refcount অ্যাটমিক পড়ে। ছেড়ে দেওয়ার বিট সেট করা থাকলে, এটি রিটার্ন করে যে Looper ছেড়ে দিচ্ছে এবং নেটিভ অ্যালোকেশন ব্যবহার করা যাবে না। তা না হলে, এটি নেটিভ অ্যালোকেশন ব্যবহার করে অ্যাক্টিভ থ্রেডের সংখ্যা বাড়ানোর জন্য CAS-এর চেষ্টা করে। প্রয়োজনীয় কাজ করার পরে, এটি সংখ্যা কমায়। যদি কুইটিং বিটটি তার বৃদ্ধির পরে কিন্তু হ্রাসের আগে সেট করা হয় এবং গণনা এখন শূন্য হয়, তাহলে এটি Looper থ্রেডকে জাগিয়ে তোলে।
Looper থ্রেড বন্ধ করার জন্য রেডি হলে, এটি CAS ব্যবহার করে অ্যাটমিকের মধ্যে বন্ধ করার বিট সেট করে। refcount ০ হলে, এটি নেটিভ অ্যালোকেশন ফ্রি করার জন্য এগিয়ে যেতে পারে। অন্যথায়, এটি নিজেকে পার্ক করে, এটি জেনে যে নেটিভ অ্যালোকেশনের শেষ ব্যবহারকারী যখন রেফারেন্স কাউন্ট কমাবে তখন এটি জেগে উঠবে। এই পদ্ধতির অর্থ হল, Looper থ্রেড অন্যান্য থ্রেডের প্রগ্রেসের জন্য অপেক্ষা করে, তবে শুধুমাত্র যখন এটি বন্ধ হয়ে যায়। এটি শুধুমাত্র একবারই ঘটে এবং পারফর্ম্যান্সের উপর নির্ভর করে না এবং এটি নেটিভ অ্যালোকেশন ব্যবহার করার জন্য অন্যান্য কোডকে সম্পূর্ণ লক-মুক্ত রাখে।
প্রয়োগ করার ক্ষেত্রে আরও অনেক কৌশল ও জটিলতা রয়েছে। আপনি সোর্স কোড পর্যালোচনা করে DeliQueue সম্পর্কে আরও জানতে পারবেন।
অপ্টিমাইজেশন: ব্রাঞ্চলেস প্রোগ্রামিং
DeliQueue ডেভেলপ ও পরীক্ষা করার সময়, টিমটি অনেক বেঞ্চমার্ক চালিয়েছে এবং নতুন কোডটি যত্ন সহকারে প্রোফাইল করেছে। simpleperf টুল ব্যবহার করে একটি সমস্যা শনাক্ত করা হয়েছে, সেটি হল Message তুলনাকারী কোডের কারণে পাইপলাইন ফ্লাশ।
একটি স্ট্যান্ডার্ড কম্প্যারেটর কনডিশনাল জাম্প ব্যবহার করে, কোন Message প্রথমে আসবে তা নির্ধারণ করার শর্ত নিচে সরলীকৃত করা হয়েছে:
static int compareMessages(@NonNull Message m1, @NonNull Message m2) {
    if (m1 == m2) {
        return 0;
    }

    // Primary queue order is by when.
    // Messages with an earlier when should come first in the queue.
    final long whenDiff = m1.when - m2.when;
    if (whenDiff > 0) return 1;
    if (whenDiff < 0) return -1;

    // Secondary queue order is by insert sequence.
    // If two messages were inserted with the same `when`, the one inserted
    // first should come first in the queue.
    final long insertSeqDiff = m1.insertSeq - m2.insertSeq;
    if (insertSeqDiff > 0) return 1;
    if (insertSeqDiff < 0) return -1;

    return 0;
}
এই কোডটি শর্তসাপেক্ষ জাম্পে (b.le এবং cbnz নির্দেশাবলী) কম্পাইল করে। সিপিইউ যখন কোনও কন্ডিশনাল ব্রাঞ্চের সম্মুখীন হয়, তখন কন্ডিশনটি গণনা না করা পর্যন্ত এটি জানতে পারে না যে ব্রাঞ্চটি নেওয়া হয়েছে কিনা, তাই এটি জানে না যে পরবর্তীতে কোন নির্দেশটি পড়তে হবে এবং ব্রাঞ্চ প্রেডিকশন নামক একটি কৌশল ব্যবহার করে অনুমান করতে হয়। বাইনারি সার্চের মতো ক্ষেত্রে, প্রতিটি ধাপে ব্রাঞ্চের দিকনির্দেশ অপ্রত্যাশিতভাবে আলাদা হবে, তাই অর্ধেক অনুমান ভুল হওয়ার সম্ভাবনা রয়েছে। সার্চিং ও সর্টিং অ্যালগরিদমে (যেমন, মিন-হিপে ব্যবহৃত অ্যালগরিদম) ব্রাঞ্চ প্রেডিকশন প্রায়শই কার্যকর হয় না, কারণ ভুল অনুমান করার খরচ সঠিক অনুমান করার থেকে বেশি। ব্রাঞ্চ প্রেডিক্টর ভুল অনুমান করলে, অনুমান করা ভ্যালু ধরে নিয়ে এটি যে কাজ করেছে তা বাতিল করে দিতে হবে এবং আসলে যে পথ নেওয়া হয়েছিল সেখান থেকে আবার শুরু করতে হবে - এটিকে পাইপলাইন ফ্লাশ বলা হয়।
এই সমস্যা খুঁজে পেতে, আমরা branch-misses পারফর্ম্যান্স কাউন্টার ব্যবহার করে আমাদের বেঞ্চমার্ক প্রোফাইল করেছি, যা স্ট্যাক ট্রেস রেকর্ড করে যেখানে ব্রাঞ্চ প্রেডিক্টর ভুল অনুমান করে। তারপর আমরা Google pprof-এর মাধ্যমে ফলাফল ভিজ্যুয়ালাইজ করেছি, যা নিচে দেখানো হয়েছে:
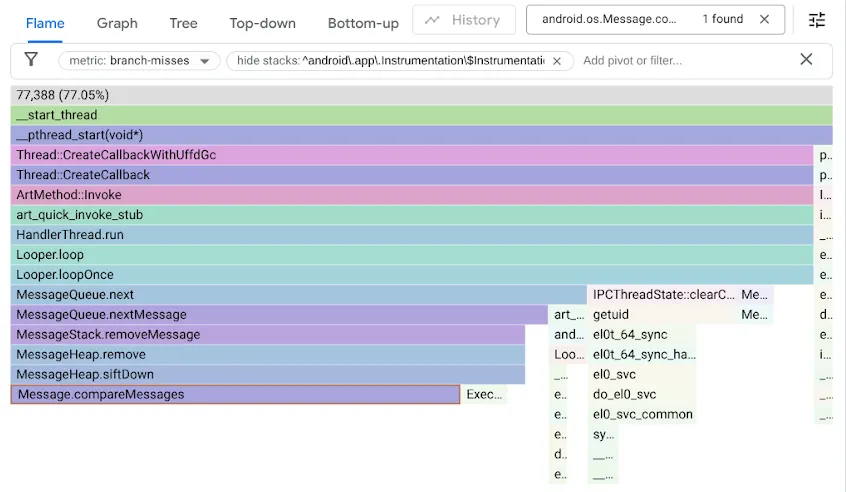
মনে রাখবেন যে আসল MessageQueue কোড অর্ডার করা সারির জন্য সিঙ্গল-লিঙ্কড তালিকা ব্যবহার করেছে। ইনসার্ট করার সময় লিনিয়ার সার্চের মতো ক্রমানুসারে সাজানো তালিকাটি স্ক্যান করা হবে এবং ইনসার্ট করার পয়েন্টের ঠিক পরে থাকা প্রথম এলিমেন্টে স্ক্যান করা বন্ধ করে তার আগে নতুন Message লিঙ্ক করা হবে। হেড থেকে সরাতে হলে শুধু হেড আনলিঙ্ক করতে হবে। DeliQueue একটি মিন-হিপ ব্যবহার করে, যেখানে মিউটেশনের জন্য একটি ভারসাম্যপূর্ণ ডেটা স্ট্রাকচারে লগারিদমিক জটিলতার সাথে কিছু উপাদান (উপরে বা নিচে শিফ্ট করা) পুনর্বিন্যাস করতে হয়, যেখানে যেকোনও তুলনার ক্ষেত্রে ট্রাভার্সালকে বাম বা ডান চাইল্ডের দিকে নির্দেশ করার সমান সম্ভাবনা থাকে। নতুন অ্যালগরিদমটি অ্যাসিম্পটোটিক্যালি দ্রুত, তবে একটি নতুন বাধা প্রকাশ করে কারণ সার্চ কোডটি অর্ধেক সময় ব্রাঞ্চ মিসে স্টল করে।
আমরা বুঝতে পেরেছি যে ব্রাঞ্চ মিসের কারণে আমাদের হিপ কোড স্লো হয়ে যাচ্ছিল, তাই আমরা ব্রাঞ্চ-ফ্রি প্রোগ্রামিং ব্যবহার করে কোড অপ্টিমাইজ করেছি:
// Branchless Logic
static int compareMessages(@NonNull Message m1, @NonNull Message m2) {
    final long when1 = m1.when;
    final long when2 = m2.when;
    final long insertSeq1 = m1.insertSeq;
    final long insertSeq2 = m2.insertSeq;

    // signum returns the sign (-1, 0, 1) of the argument,
    // and is implemented as pure arithmetic:
    // ((num >> 63) | (-num >>> 63))
    final int whenSign = Long.signum(when1 - when2);
    final int insertSeqSign = Long.signum(insertSeq1 - insertSeq2);

    // whenSign takes precedence over insertSeqSign,
    // so the formula below is such that insertSeqSign only matters
    // as a tie-breaker if whenSign is 0.
    return whenSign * 2 + insertSeqSign;
}
অপ্টিমাইজেশন বুঝতে, Compiler Explorer-এ দুটি উদাহরণ ডিসঅ্যাসেম্বল করুন এবং LLVM-MCA ব্যবহার করুন, এটি একটি CPU সিমুলেটর যা CPU সাইকেলের আনুমানিক টাইমলাইন তৈরি করতে পারে।
The original code:
Index     01234567890123
[0,0]     DeER .    .  .   sub  x0, x2, x3
[0,1]     D=eER.    .  .   cmp  x0, #0
[0,2]     D==eER    .  .   cset w0, ne
[0,3]     .D==eER   .  .   cneg w0, w0, lt
[0,4]     .D===eER  .  .   cmp  w0, #0
[0,5]     .D====eER .  .   b.le #12
[0,6]     . DeE---R .  .   mov  w1, #1
[0,7]     . DeE---R .  .   b    #48
[0,8]     . D==eE-R .  .   tbz  w0, #31, #12
[0,9]     .  DeE--R .  .   mov  w1, #-1
[0,10]    .  DeE--R .  .   b    #36
[0,11]    .  D=eE-R .  .   sub  x0, x4, x5
[0,12]    .   D=eER .  .   cmp  x0, #0
[0,13]    .   D==eER.  .   cset w0, ne
[0,14]    .   D===eER  .   cneg w0, w0, lt
[0,15]    .    D===eER .   cmp  w0, #0
[0,16]    .    D====eER.   csetm        w1, lt
[0,17]    .    D===eE-R.   cmp  w0, #0
[0,18]    .    .D===eER.   csinc        w1, w1, wzr, le
[0,19]    .    .D====eER   mov  x0, x1
[0,20]    .    .DeE----R   ret
একটি কন্ডিশনাল ব্রাঞ্চ, b.le, লক্ষ্য করুন, যা insertSeq ফিল্ডের তুলনা করা এড়িয়ে যায় যদি when ফিল্ডের তুলনা করে ফলাফল আগে থেকেই জানা থাকে।
The branchless code:
Index     012345678
[0,0]     DeER .  .   sub       x0, x2, x3
[0,1]     DeER .  .   sub       x1, x4, x5
[0,2]     D=eER.  .   cmp       x0, #0
[0,3]     .D=eER  .   cset      w0, ne
[0,4]     .D==eER .   cneg      w0, w0, lt
[0,5]     .DeE--R .   cmp       x1, #0
[0,6]     . DeE-R .   cset      w1, ne
[0,7]     . D=eER .   cneg      w1, w1, lt
[0,8]     . D==eeER   add       w0, w1, w0, lsl #1
[0,9]     .  DeE--R   ret
এখানে, ব্রাঞ্চলেস ইমপ্লিমেন্টেশন ব্রাঞ্চি কোডের মাধ্যমে সবচেয়ে ছোট পথের চেয়েও কম সাইকেল এবং নির্দেশাবলী নেয় - এটি সব ক্ষেত্রেই ভালো। আরও দ্রুত প্রয়োগ এবং ভুলভাবে অনুমান করা ব্রাঞ্চ বাদ দেওয়ার ফলে আমাদের কিছু বেঞ্চমার্কে ৫ গুণ উন্নতি হয়েছে!
তবে, এই টেকনিক সবসময় প্রযোজ্য হয় না। ব্রাঞ্চলেস অ্যাপ্রোচে সাধারণত এমন কাজ করতে হয় যা পরে বাতিল করে দেওয়া হবে এবং ব্রাঞ্চটি বেশিরভাগ সময় অনুমান করা গেলে, সেই বাতিল করা কাজ আপনার কোডকে স্লো করে দিতে পারে। এছাড়াও, কোনও ব্রাঞ্চ সরিয়ে দিলে প্রায়ই ডেটা ডিপেন্ডেন্সি তৈরি হয়। আধুনিক সিপিইউ প্রতিটি সাইকেলে একাধিক অপারেশন এক্সিকিউট করে, তবে আগের নির্দেশ থেকে ইনপুট রেডি না হওয়া পর্যন্ত এটি কোনও নির্দেশ এক্সিকিউট করতে পারে না। এর বিপরীতে, একটি CPU ব্রাঞ্চে ডেটা সম্পর্কে অনুমান করতে পারে এবং কোনও ব্রাঞ্চ সঠিকভাবে অনুমান করা হলে আগে কাজ করতে পারে।
টেস্টিং ও যাচাইকরণ
লক-ফ্রি অ্যালগরিদমের নির্ভুলতা যাচাই করা অত্যন্ত কঠিন!
ডেভেলপমেন্টের সময় ক্রমাগত যাচাইকরণের জন্য স্ট্যান্ডার্ড ইউনিট টেস্ট ছাড়াও, আমরা কঠোর স্ট্রেস টেস্ট লিখেছি যাতে কিউ ইনভেরিয়েন্ট যাচাই করা যায় এবং ডেটা রেস থাকলে তা প্ররোচিত করার চেষ্টা করা যায়। আমাদের টেস্ট ল্যাবে আমরা এমুলেট করা ডিভাইস এবং আসল হার্ডওয়্যারে লক্ষ লক্ষ টেস্ট ইন্সট্যান্স চালাতে পারি।
Java ThreadSanitizer (JTSan) ইন্সট্রুমেন্টেশনের মাধ্যমে, আমরা একই টেস্ট ব্যবহার করে আমাদের কোডে কিছু ডেটা রেসও শনাক্ত করতে পারি। JTSan, DeliQueue-এ কোনও সমস্যাজনক ডেটা রেস খুঁজে পায়নি, তবে - আশ্চর্যজনকভাবে - Robolectric ফ্রেমওয়ার্কে দুটি কনকারেন্সি বাগ শনাক্ত করেছে, যা আমরা দ্রুত সমাধান করেছি।
আমাদের ডিবাগিং ক্ষমতা উন্নত করতে, আমরা নতুন বিশ্লেষণ টুল তৈরি করেছি। Android প্ল্যাটফর্ম কোডে সমস্যা দেখানোর একটি উদাহরণ নিচে দেওয়া হল, যেখানে একটি থ্রেড অন্য থ্রেডকে Message দিয়ে ওভারলোড করছে, যার ফলে একটি বড় ব্যাকলগ তৈরি হচ্ছে, যা Perfetto-তে দেখা যাচ্ছে, আমাদের যোগ করা MessageQueue ইনস্ট্রুমেন্টেশন ফিচারের জন্য ধন্যবাদ।
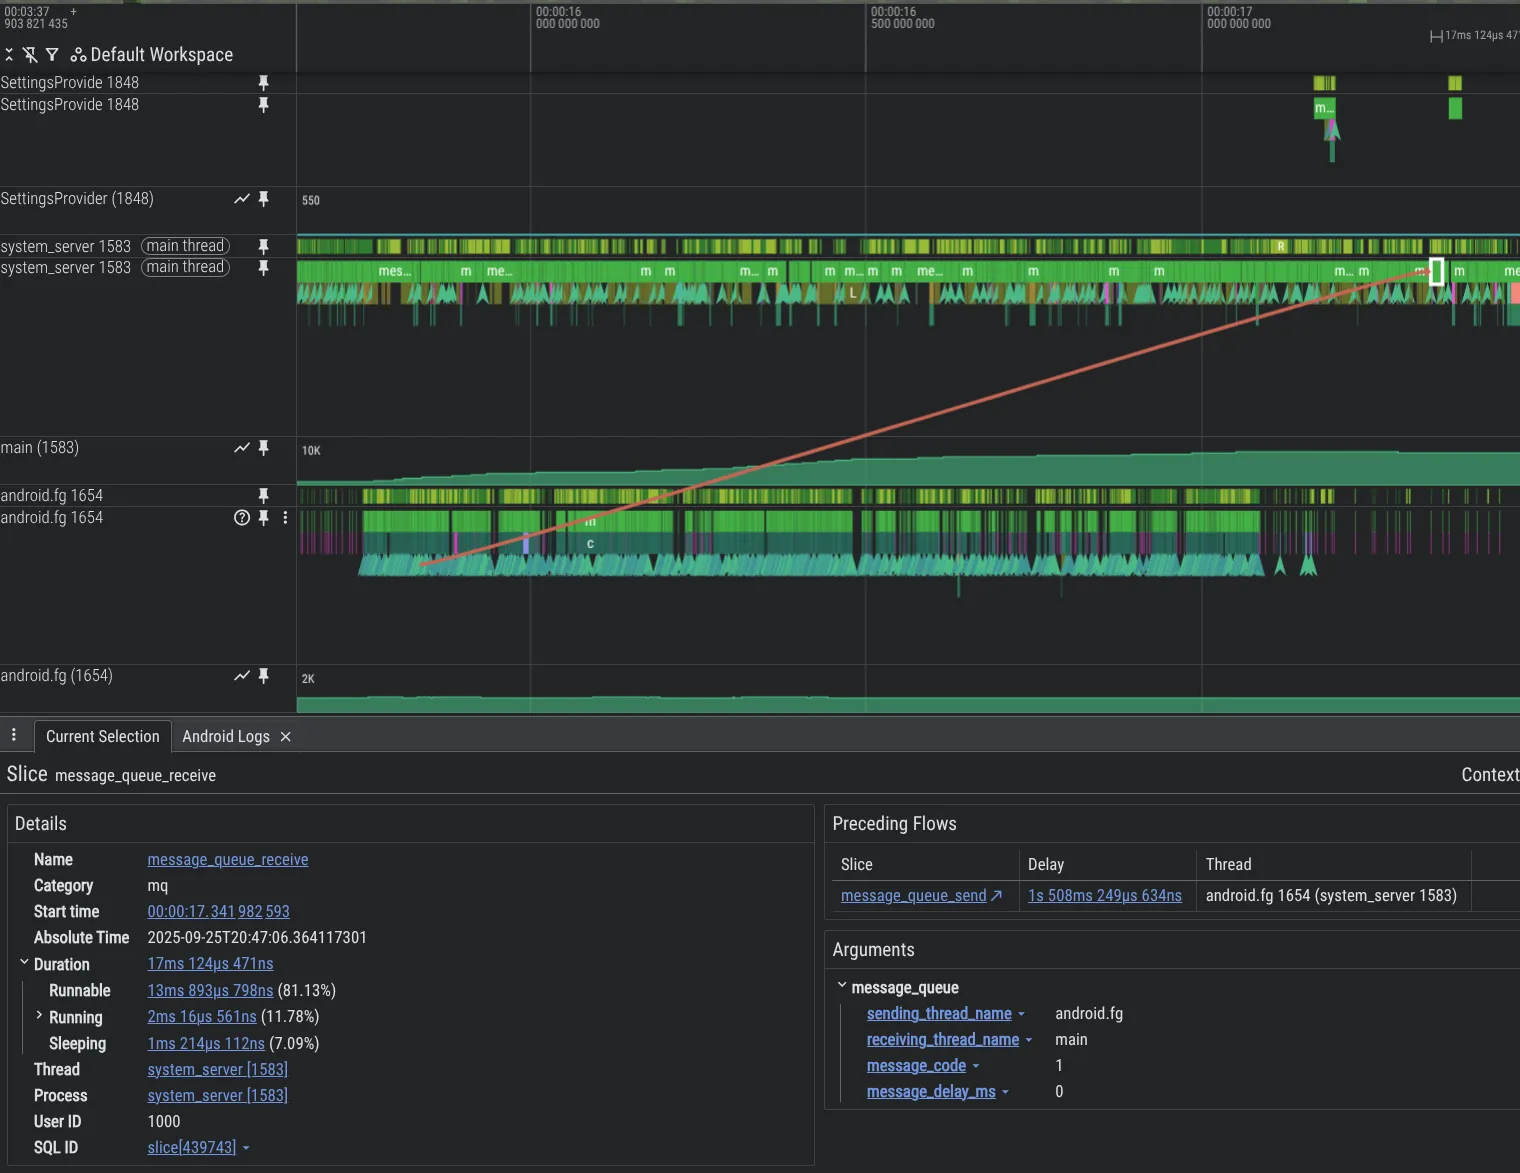
system_server প্রসেসে MessageQueue ট্রেসিং চালু করতে, আপনার Perfetto কনফিগারেশনে নিম্নলিখিতগুলি অন্তর্ভুক্ত করুন:
data_sources {
  config {
    name: "track_event"
    target_buffer: 0  # Change this per your buffers configuration
    track_event_config {
      enabled_categories: "mq"
    }
  }
}
প্রভাব
DeliQueue, MessageQueue থেকে লক সরিয়ে সিস্টেম ও অ্যাপ পারফর্ম্যান্স উন্নত করে।
- সিন্থেটিক বেঞ্চমার্ক: ব্যস্ত সারিতে মাল্টি-থ্রেডেড ইনসার্শন, উন্নত কনকারেন্সি (Treiber স্ট্যাক) এবং দ্রুত ইনসার্শনের (min-heap) কারণে, লিগ্যাসি
MessageQueue-এর চেয়ে ৫,০০০ গুণ দ্রুত। - ইন্টার্নাল বিটা টেস্টারের থেকে পাওয়া Perfetto ট্রেস অনুযায়ী, আমরা দেখতে পেয়েছি যে লক কনটেনশনে অ্যাপের মূল থ্রেডে ব্যয় করা সময় ১৫% কমে গেছে।
- একই টেস্ট ডিভাইসে, লক কন্টেনশন কমানোর ফলে ব্যবহারকারীর অভিজ্ঞতা উল্লেখযোগ্যভাবে উন্নত হয়, যেমন:
- অ্যাপে -৪% ফ্রেম মিস হয়েছে।
- সিস্টেম UI এবং লঞ্চার ইন্টার্যাকশনে -৭.৭% ফ্রেম মিস হয়েছে।
- অ্যাপ স্টার্টআপ থেকে প্রথম ফ্রেম ড্র করা পর্যন্ত সময়ের ক্ষেত্রে -৯.১%, ৯৫%ile-এ।
পরবর্তী ধাপ
Android 17-এ অ্যাপের জন্য DeliQueue রোল-আউট করা হচ্ছে। অ্যাপ ডেভেলপারদের উচিত Android Developers ব্লগে গিয়ে আপনার অ্যাপকে নতুন লক-ফ্রি MessageQueue -এর জন্য প্রস্তুত করা সংক্রান্ত তথ্য পর্যালোচনা করা, যাতে তারা জানতে পারেন কীভাবে তাদের অ্যাপ পরীক্ষা করতে হয়।
রেফারেন্স
[১] Treiber, R.K., ১৯৮৬. সিস্টেম প্রোগ্রামিং: প্যারালেলিজম সামলানো। International Business Machines Incorporated, Thomas J. ওয়াটসন রিসার্চ সেন্টার।
[২] Goetz, B., Peierls, T., Bloch, J., Bowbeer, J., Holmes, D., & Lea, D. (২০০৬). Java Concurrency in Practice. Addison-Wesley Professional.
-
 প্রোডাক্ট সংক্রান্ত খবর
এজেন্টিক ডেভেলপমেন্টের গতি বাড়ার সাথে সাথে, Android ইঞ্জিনিয়ারিং একটি নতুন দিগন্তে পৌঁছে যাচ্ছে: সহায়ক কোড সম্পূর্ণ করা থেকে শুরু করে আপনার নির্দেশনায় এন্ড-টু-এন্ড কাজ করা এজেন্ট পর্যন্ত। আপনি যে মডেল ও এজেন্ট ব্যবহার করেন, তার উপর আপনার সম্পূর্ণ নিয়ন্ত্রণ ও নমনীয়তা থাকে।
Jason Buchel • ৩ মিনিট রিডিং -
 প্রোডাক্ট সংক্রান্ত খবর
আজ আমরা শেয়ার করেছি যে কীভাবে আমরা আমাদের "স্টোরের চেয়েও বেশি কিছু" ভিশনকে পরবর্তী অধ্যায়ে নিয়ে যাচ্ছি। 'অ্যাকাউন্ট' ট্যাব থেকে, এখন ২৫০ মিলিয়নেরও বেশি মাসিক অ্যাক্টিভ ব্যবহারকারীর জন্য ব্যক্তিগত হোম বেস, আমাদের ইউনিফায়েড গেমিং প্ল্যাটফর্ম ৭০০ মিলিয়নেরও বেশি গেমার প্রোফাইলকে কানেক্ট করছে, Google Play ব্যবহারকারীদের যেখানেই থাকুক না কেন তাদের সাথে কানেক্ট করছে।
Paul Feng • ৩ মিনিট রিডিং -
 প্রোডাক্ট সংক্রান্ত খবর
Googlebook-এর মাধ্যমে, ব্যবহারকারীদের নিজেদের প্রকাশ করতে এবং এইসব টুলে অ্যাক্সেস পেতে সাহায্য করতে পেরে আমরা আনন্দিত।
Cyrus Stoller • পড়তে ২ মিনিট লাগবে
আপনার ইনবক্সে প্রতি সপ্তাহে Android ডেভেলপমেন্ট সংক্রান্ত লেটেস্ট ইনসাইট পান।