Что под капотом: MessageQueue без блокировки в Android 17
Время на чтение: 16 минут
В Android 17 приложения, использующие SDK 37 или более поздней версии, получат новую реализацию MessageQueue, которая не требует блокировки. Новая реализация повышает производительность и снижает количество пропущенных кадров, но может нарушить работу клиентов, которые используют закрытые поля и методы MessageQueue. Чтобы узнать больше об изменении поведения и о том, как можно уменьшить его влияние, ознакомьтесь с документацией по изменению поведения MessageQueue. В этой записи технического блога рассказывается о реархитектуре MessageQueue и о том, как анализировать проблемы с конфликтами блокировок с помощью Perfetto.
Looper управляет потоком UI каждого приложения для Android. Он извлекает задачи из MessageQueue, отправляет их в Handler и повторяет этот процесс. В течение двух десятилетий в MessageQueue использовалась одна блокировка монитора (т.е. блок кода synchronized) для защиты своего состояния.
В Android 17 этот компонент значительно обновлен: добавлена реализация без блокировки под названием DeliQueue.
В этой статье мы расскажем, как блокировки влияют на производительность интерфейса, как анализировать эти проблемы с помощью Perfetto, а также какие алгоритмы и оптимизации используются для улучшения основного потока Android.
Проблема: конкуренция за блокировку и инверсия приоритетов
Устаревший класс MessageQueue работал как приоритетная очередь, защищенная одной блокировкой. Если фоновый поток публикует сообщение, пока основной поток выполняет обслуживание очереди, фоновый поток блокирует основной.
Если два или более потоков конкурируют за эксклюзивное использование одной блокировки, это называется конкуренцией за блокировку. Это может привести к инверсии приоритетов, что, в свою очередь, вызывает задержки в работе интерфейса и другие проблемы с производительностью.
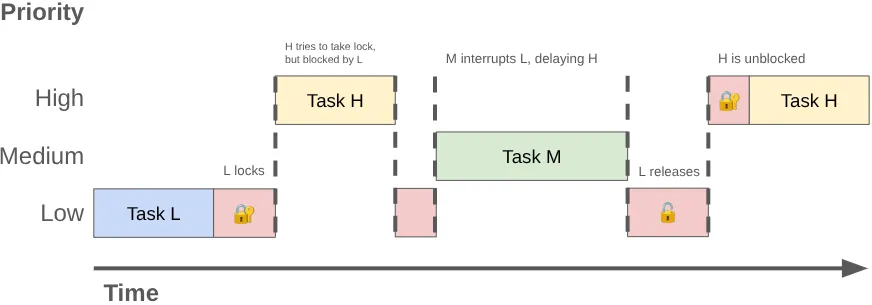
Инверсия приоритетов может произойти, когда поток с высоким приоритетом (например, поток UI) ожидает поток с низким приоритетом. Рассмотрим следующую последовательность:
- Низкоприоритетный фоновый поток получает блокировку
MessageQueue, чтобы опубликовать результат своей работы. - Поток со средним приоритетом становится исполняемым, и планировщик ядра выделяет ему процессорное время, вытесняя поток с низким приоритетом.
- Поток UI с высоким приоритетом завершает текущую задачу и пытается считать данные из очереди, но оказывается заблокирован, поскольку блокировку удерживает поток с низким приоритетом.
Поток с низким приоритетом блокирует поток UI, а работа со средним приоритетом задерживает его ещё больше.
Анализ конкуренции с помощью Perfetto
Для диагностики этих проблем можно использовать Perfetto. В стандартной трассировке поток, заблокированный блокировкой монитора, переходит в спящий режим, и Perfetto показывает фрагмент, указывающий владельца блокировки.
При запросе данных трассировки ищите фрагменты с названием "monitor contention with …" (конфликт монитора с …), за которым следует название потока, владеющего блокировкой, и сайт кода, где была получена блокировка.
Пример: задержка в панели запуска
Чтобы проиллюстрировать это, давайте проанализируем трассировку, в которой пользователь столкнулся с задержкой при переходе на главный экран на телефоне Pixel сразу после того, как сделал снимок в приложении камеры. Ниже мы видим скриншот Perfetto, показывающий события, которые привели к пропущенному кадру:
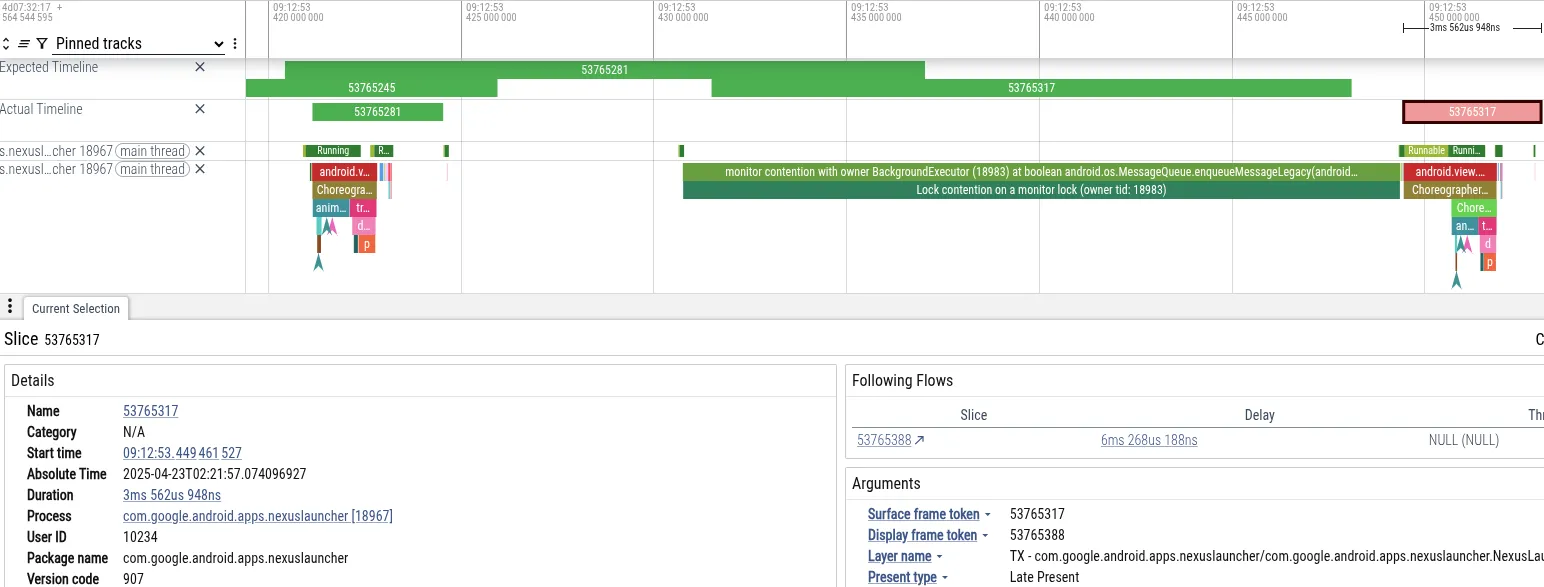
- Признак. Основной поток панели запуска не успел обработать кадр. Он был заблокирован на 18 мс, что превышает предельное значение в 16 мс, необходимое для рендеринга с частотой 60 Гц.
- Диагностика. Perfetto показал, что основной поток заблокирован на блокировке
MessageQueue. Блокировка принадлежала потоку BackgroundExecutor. - Основная причина. BackgroundExecutor работает с приоритетом Process.THREAD_PRIORITY_BACKGROUND (очень низкий). Оно выполняло несрочную задачу (проверяло лимиты на использование приложений). В то же время потоки со средним приоритетом использовали процессорное время для обработки данных с камеры. Планировщик ОС вытеснил поток BackgroundExecutor, чтобы запустить потоки камеры.
В результате поток UI панели запуска (высокий приоритет) был косвенно заблокирован рабочим потоком камеры (средний приоритет), который не позволял фоновому потоку панели запуска (низкий приоритет) снять блокировку.
Как запрашивать трассировки с помощью PerfettoSQL
Вы можете использовать PerfettoSQL, чтобы запрашивать данные трассировки для определенных шаблонов. Это полезно, если у вас есть большой банк трассировок с пользовательских устройств или тестов и вы ищете конкретные трассировки, которые демонстрируют проблему.
Например, этот запрос находит конфликты MessageQueue, совпадающие с пропущенными кадрами (помехами):
INCLUDE PERFETTO MODULE android.monitor_contention;
INCLUDE PERFETTO MODULE android.frames.jank_type;

SELECT
  process_name,
  -- Convert duration from nanoseconds to milliseconds
  SUM(dur) / 1000000 AS sum_dur_ms,
  COUNT(*) AS count_contention
FROM android_monitor_contention
WHERE is_blocked_thread_main
AND short_blocked_method LIKE "%MessageQueue%"

-- Only look at app processes that had jank
AND upid IN (
  SELECT DISTINCT(upid)
  FROM actual_frame_timeline_slice
  WHERE android_is_app_jank_type(jank_type) = TRUE
)
GROUP BY process_name
ORDER BY SUM(dur) DESC;
В этом более сложном примере мы объединяем данные трассировки из нескольких таблиц, чтобы выявить конкуренцию MessageQueue во время запуска приложения.
INCLUDE PERFETTO MODULE android.monitor_contention;
INCLUDE PERFETTO MODULE android.startup.startups;

-- Join package and process information for startups
DROP VIEW IF EXISTS startups;
CREATE VIEW startups AS
SELECT startup_id, ts, dur, upid
FROM android_startups
JOIN android_startup_processes USING(startup_id);

-- Intersect monitor contention with startups in the same process.
DROP TABLE IF EXISTS monitor_contention_during_startup;
CREATE VIRTUAL TABLE monitor_contention_during_startup
USING SPAN_JOIN(android_monitor_contention PARTITIONED upid, startups PARTITIONED upid);

SELECT
  process_name,
  SUM(dur) / 1000000 AS sum_dur_ms,
  COUNT(*) AS count_contention
FROM monitor_contention_during_startup
WHERE is_blocked_thread_main
AND short_blocked_method LIKE "%MessageQueue%"
GROUP BY process_name
ORDER BY SUM(dur) DESC;
Вы можете использовать свою любимую LLM для написания запросов PerfettoSQL, чтобы находить другие шаблоны.
В Google мы используем BigTrace, чтобы выполнять запросы PerfettoSQL к миллионам трассировок. В результате мы подтвердили, что проблема, о которой нам сообщали, действительно носит системный характер. Данные показали, что MessageQueue конкуренция за блокировку влияет на пользователей во всей экосистеме, что подтверждает необходимость фундаментального изменения архитектуры.
Решение: параллелизм без блокировок
Мы решили проблему с конкуренцией MessageQueue, внедрив структуру данных без блокировки, которая использует атомарные операции с памятью вместо эксклюзивных блокировок для синхронизации доступа к общему состоянию. Структура данных или алгоритм являются неблокирующими, если по крайней мере один поток всегда может выполняться независимо от поведения планирования других потоков. Этого свойства обычно трудно достичь, и в большинстве случаев оно не стоит затраченных усилий.
Атомарные примитивы
ПО без блокировок часто полагается на атомарные примитивы чтения-изменения-записи, предоставляемые аппаратным обеспечением.
На более старых процессорах ARM64 атомарные операции использовали цикл Load-Link/Store-Conditional (LL/SC). ЦП загружает значение и помечает адрес. Если другой поток записывает данные по этому адресу, сохранение завершается ошибкой и цикл повторяется. Поскольку потоки могут продолжать попытки и добиваться успеха, не дожидаясь другого потока, эта операция не блокируется.
ARM64 LL/SC loop example
retry:
    ldxr    x0, [x1]        // Load exclusive from address x1 to x0
    add     x0, x0, #1      // Increment value by 1
    stxr    w2, x0, [x1]    // Store exclusive.
                            // w2 gets 0 on success, 1 on failure
cbnz w2, retry // If w2 is non-zero (failed), branch to retr(посмотреть в Compiler Explorer)
Более новые архитектуры ARM (ARMv8.1) поддерживают Large System Extensions (LSE), которые включают инструкции в форме Compare-And-Swap (CAS) или Load-And-Add (показано ниже). В Android 17 мы добавили в компилятор Android Runtime (ART) поддержку обнаружения LSE и генерации оптимизированных инструкций:
/ ARMv8.1 LSE atomic example
ldadd   x0, x1, [x2]    // Atomic load-add.
                        // Faster, no loop required.
В наших тестах код с высокой конкуренцией, использующий CAS, работает примерно в три раза быстрее, чем вариант с LL/SC.
Язык программирования Java предлагает атомарные примитивы через java.util.concurrent.atomic, которые полагаются на эти и другие специализированные инструкции ЦП.
Структура данных: DeliQueue
Чтобы устранить конкуренцию за блокировку в MessageQueue, наши инженеры разработали новую структуру данных под названием DeliQueue. DeliQueue разделяет вставку Message и обработку Message:
- Список
Messages(стек Трейбера) – стек без блокировки. Любой поток может передавать сюда новыеMessagesбез конфликтов. - Приоритетная очередь (минимальная куча). Куча
Messages, которые нужно обработать. Она принадлежит исключительно потоку Looper, поэтому для доступа к ней не требуется синхронизация или блокировка.
Постановка в очередь: добавление в стек Трейбера
Список Messages хранится в стеке Трейбера [1] – стеке без блокировки, в котором для обновления указателя на начало используется цикл CAS.
public class TreiberStack <E> {
    AtomicReference<Node<E>> top =
            new AtomicReference<Node<E>>();
    public void push(E item) {
        Node<E> newHead = new Node<E>(item);
        Node<E> oldHead;
        do {
            oldHead = top.get();
            newHead.next = oldHead;
        } while (!top.compareAndSet(oldHead, newHead));
    }

    public E pop() {
        Node<E> oldHead;
        Node<E> newHead;
        do {
            oldHead = top.get();
            if (oldHead == null) return null;
            newHead = oldHead.next;
        } while (!top.compareAndSet(oldHead, newHead));
        return oldHead.item;
    }
}
База кода, основанная на книге Java Concurrency in Practice [2], доступна онлайн и является общественным достоянием.
Любой производитель может в любой момент добавить в стек новые Message. Это похоже на талончик в очереди: ваш номер определяется временем, когда вы пришли, но порядок, в котором вы получите еду, может не совпадать с ним. Поскольку это связанный стек, каждый Message является подстеком. Вы можете увидеть, как выглядела очередь Message в любой момент времени, отслеживая заголовок и выполняя итерацию вперед. Вы не увидите никаких новых Message, помещенных сверху, даже если они добавляются во время обхода.
Dequeue: bulk transfer to a min-heap
Чтобы найти следующий Message для обработки, Looper обрабатывает новые Message из стека Трейбера, проходя по стеку сверху вниз и повторяя итерации, пока не найдет последний Message, который он обрабатывал ранее. По мере того как Looper проходит вниз по стеку, он вставляет Message в упорядоченную по срокам минимальную кучу. Поскольку Looper является эксклюзивным владельцем кучи, он упорядочивает и обрабатывает Message без блокировок и атомарных операций.
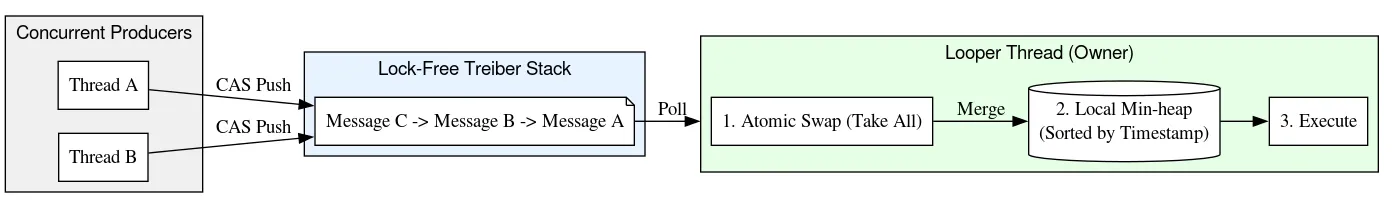
При проходе по стеку Looper также создает ссылки от Message в стеке к их предшественникам, формируя таким образом двусвязный список. Создание связанного списка безопасно, поскольку ссылки, указывающие вниз по стеку, добавляются с помощью алгоритма стека Трейбера с CAS, а ссылки вверх по стеку считываются и изменяются только потоком Looper. Эти обратные ссылки затем используются для удаления Message из произвольных точек стека за время O(1).
Такая структура обеспечивает вставку O(1) для производителей (потоков, отправляющих задачи в очередь) и амортизированную обработку O(log N) для потребителя (Looper).
Использование двоичной кучи для упорядочивания Message также устраняет фундаментальный недостаток устаревшего MessageQueue, в котором Message хранились в односвязном списке (с корнем вверху). В устаревшей реализации удаление из начала было O(1), но вставка в худшем случае имела O(N) – плохое масштабирование для перегруженных очередей! И наоборот, вставка в минимальную кучу и удаление из нее масштабируются логарифмически, обеспечивая конкурентоспособную среднюю производительность, но действительно превосходную задержку в хвосте.
Устаревшая версия (заблокировано) MessageQueue | DeliQueue | |
| Вставить | O(N) | O(1) для вызова потока O(logN) для потока |
| Удалить из заголовка | O(1) | O(logN) |
В устаревшей реализации очереди производители и потребитель использовали блокировку для координации эксклюзивного доступа к базовому односвязному списку. В DeliQueue стек Трейбера обрабатывает параллельный доступ, а единственный потребитель обрабатывает упорядочение своей рабочей очереди.
Удаление: согласованность с помощью надгробий
DeliQueue – это гибридная структура данных, объединяющая стек Трейбера без блокировки с однопоточной двоичной кучей. Синхронизация этих двух структур без глобальной блокировки представляет собой уникальную проблему: сообщение может физически присутствовать в стеке, но логически быть удалено из очереди.
Чтобы решить эту проблему, в DeliQueue используется метод, называемый "tombstoning". Каждый Message отслеживает свое положение в стеке с помощью указателей назад и вперед, свой индекс в массиве кучи и логический флаг, указывающий, был ли он удален. Когда Message будет готова к запуску, поток Looper выполнит операцию CAS для флага удаления, а затем удалит задачу из кучи и стека.
Когда другому потоку нужно удалить Message, он не извлекает его из структуры данных сразу. Вместо этого выполняются следующие действия:
- Логическое удаление. Поток использует CAS, чтобы атомарно изменить флаг удаления
Messageс false на true.Messageостается в структуре данных как свидетельство ожидающего удаления, так называемое "надгробие". Как толькоMessageпомечается для удаления, DeliQueue обрабатывает его так, как если бы он больше не существовал в очереди, когда бы он ни был найден. - Отложенная очистка. Фактическое удаление из структуры данных выполняется потоком
Looperи откладывается на более позднее время. Вместо того чтобы изменять стек или кучу, поток удаления добавляетMessageв другой стек списка свободных блоков без блокировки. - Структурное удаление. Только
Looperможет взаимодействовать с кучей или удалять элементы из стека. Проснувшись, он очищает список и обрабатывает содержащиеся в немMessage. Затем каждый объектMessageотвязывается от стека и удаляется из кучи.
При таком подходе все управление кучей осуществляется в одном потоке. Это позволяет минимизировать количество параллельных операций и барьеров памяти, что ускоряет и упрощает критический путь.
Обход: безопасные состояния гонки в модели памяти Java
Большинство API для параллельного выполнения, например Future в стандартной библиотеке Java или Job и Deferred в Kotlin, включают механизм отмены работы до ее завершения. Экземпляр одного из этих классов соответствует 1:1 единице базовой работы, а вызов cancel для объекта отменяет связанные с ними конкретные операции.
Современные устройства Android оснащены многоядерными процессорами и поколенческими сборщиками мусора, работающими параллельно. Но когда Android только разрабатывался, было слишком дорого выделять по одному объекту на каждую единицу работы. Поэтому в Handler Android поддерживается отмена с помощью многочисленных перегрузок removeMessages. Вместо удаления определенного Message удаляются все Message, соответствующие указанным критериям. На практике для этого нужно перебрать все элементы Message, вставленные до вызова removeMessages, и удалить совпадающие.
При итерации вперед потоку требуется только одна упорядоченная атомарная операция для чтения текущей вершины стека. После этого для поиска следующего Message используются обычные чтения полей. Если поток Looper изменяет поля next при удалении Message, запись Looper и чтение другого потока не синхронизируются. Это называется состоянием гонки. Обычно состояние гонки – это серьезная ошибка, которая может привести к большим проблемам в приложении, например утечкам, бесконечным циклам, сбоям, зависаниям и т. д. Однако в некоторых узких условиях гонки данных могут быть безопасными в рамках модели памяти Java. Предположим, у нас есть стопка из следующих карт:

Мы выполняем атомарное чтение головы и видим A. Указатель следующего элемента в A указывает на B. В то же время, когда мы обрабатываем B, цикл может удалить B и C, обновив A, чтобы указать на C, а затем на D.
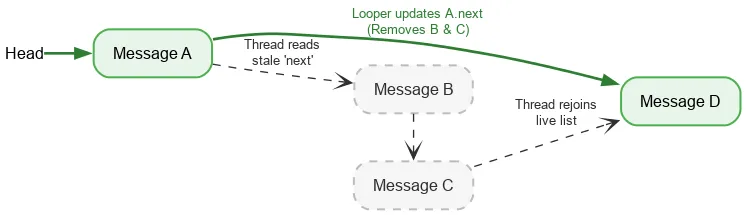
Хотя B и C логически удалены, B сохраняет указатель на следующий элемент C, а C – на D. Поток чтения продолжает проходить через отсоединенные удаленные узлы и в конечном итоге снова присоединяется к активному стеку в D.
Благодаря тому, что DeliQueue может обрабатывать гонки между обходом и удалением, мы можем обеспечить безопасную итерацию без блокировок.
Quitting: Native refcount
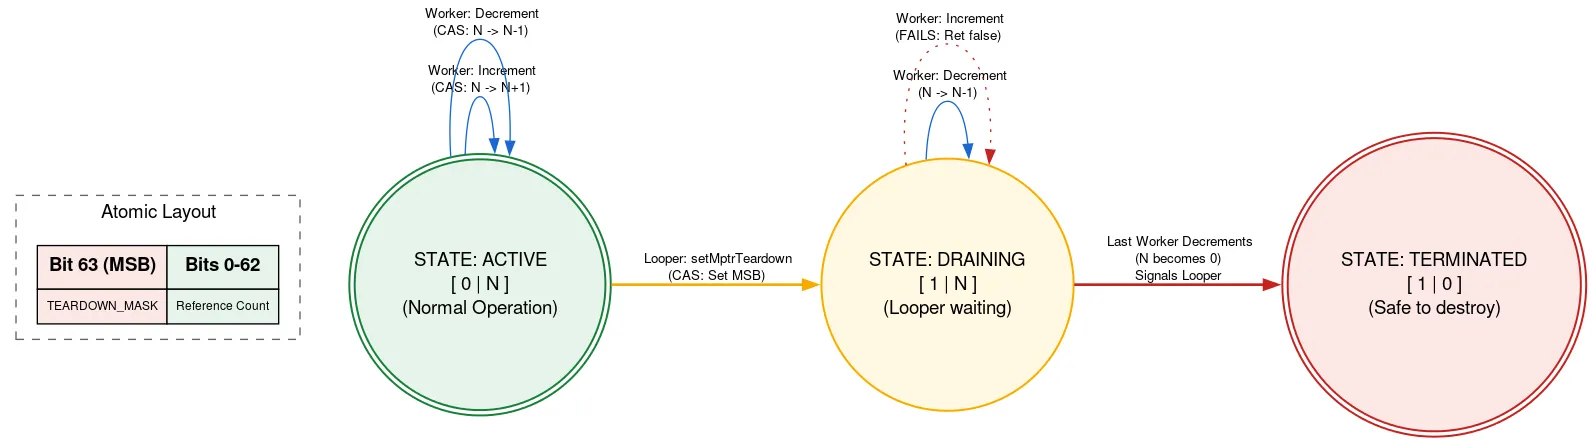
Looper поддерживается нативным распределением, которое необходимо освободить вручную после выхода из Looper. Если другой поток добавляет Message, пока Looper завершает работу, он может использовать нативное выделение памяти после того, как оно было освобождено, что является нарушением безопасности памяти. Чтобы этого не происходило, мы используем тегированный счетчик ссылок, в котором один бит атомарной переменной указывает, завершает ли работу Looper.
Перед использованием нативного выделения поток считывает атомарный счетчик ссылок. Если бит выхода установлен, возвращается значение, указывающее, что Looper завершает работу и нативное выделение памяти использовать нельзя. Если нет, то он пытается выполнить операцию CAS, чтобы увеличить количество активных потоков, используя нативное распределение. После выполнения необходимых действий он уменьшает счетчик. Если бит выхода был установлен после увеличения, но до уменьшения, и счетчик теперь равен нулю, то он активирует поток Looper.
Когда поток Looper готов к завершению, он использует CAS, чтобы установить бит завершения в атомарной переменной. Если счетчик ссылок равен 0, можно освободить нативное выделение. В противном случае он приостанавливает работу, зная, что будет запущен, когда последний пользователь нативного распределения уменьшит счетчик ссылок. При таком подходе поток Looper ожидает завершения других потоков, но только когда он сам завершает работу. Это происходит только один раз и не влияет на производительность, а также позволяет использовать другой код для нативного выделения памяти без блокировки.
В реализации есть много других хитростей и сложностей. Чтобы узнать больше о DeliQueue, изучите исходный код.
Оптимизация: программирование без ветвления
В процессе разработки и тестирования DeliQueue команда провела множество тестов производительности и тщательно профилировала новый код. Simpleperf помог выявить проблему с очисткой конвейера, которая возникала из-за кода компаратора Message.
Стандартный компаратор использует условные переходы, при этом условие для определения того, какой Message идет первым, упрощено ниже:
static int compareMessages(@NonNull Message m1, @NonNull Message m2) {
    if (m1 == m2) {
        return 0;
    }

    // Primary queue order is by when.
    // Messages with an earlier when should come first in the queue.
    final long whenDiff = m1.when - m2.when;
    if (whenDiff > 0) return 1;
    if (whenDiff < 0) return -1;

    // Secondary queue order is by insert sequence.
    // If two messages were inserted with the same `when`, the one inserted
    // first should come first in the queue.
    final long insertSeqDiff = m1.insertSeq - m2.insertSeq;
    if (insertSeqDiff > 0) return 1;
    if (insertSeqDiff < 0) return -1;

    return 0;
}
Этот код компилируется в условные переходы (инструкции b.le и cbnz). Когда ЦП сталкивается с условным ветвлением, он не может знать, какая ветвь будет выбрана, пока не будет вычислено условие. Поэтому он не знает, какую инструкцию читать дальше, и должен угадать, используя метод, называемый предсказанием ветвлений. В случае двоичного поиска направление ветвления будет непредсказуемо отличаться на каждом шаге, поэтому вполне вероятно, что половина прогнозов будет неверной. Предсказание ветвлений часто неэффективно в алгоритмах поиска и сортировки (например, в алгоритме, используемом в минимальной куче), поскольку цена неправильного предположения больше, чем улучшение от правильного. Если предсказатель ветвлений ошибается, он должен отбросить работу, выполненную после предположения предсказанного значения, и начать заново с пути, который был фактически выбран. Это называется очисткой конвейера.
Чтобы найти эту проблему, мы профилировали наши тесты производительности с помощью счетчика производительности branch-misses, который записывает трассировки стека, когда предсказатель ветвлений ошибается. Затем мы визуализировали результаты с помощью Google pprof, как показано ниже.
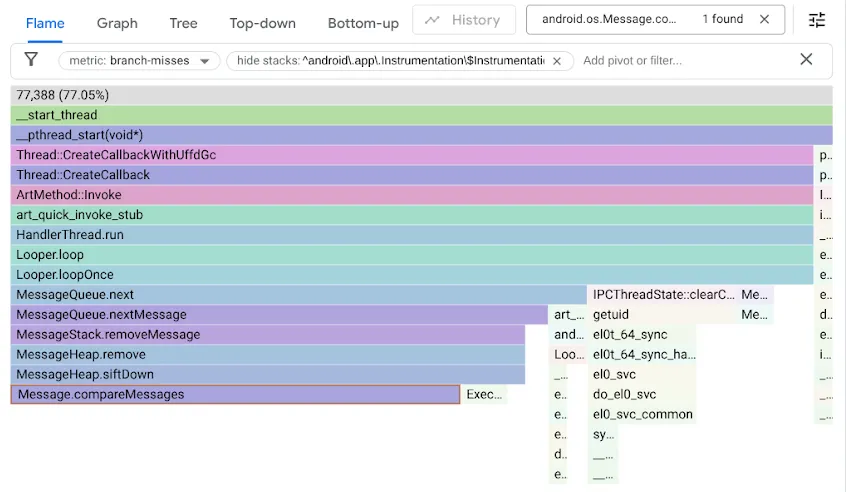
Напомним, что в исходном коде MessageQueue для упорядоченной очереди использовался односвязный список. Вставка будет проходить по списку в порядке сортировки в виде линейного поиска, останавливаясь на первом элементе, который находится за точкой вставки, и связывая новый Message перед ним. Чтобы удалить элемент из начала списка, достаточно отменить связь с ним. В то же время в DeliQueue используется минимальная куча, в которой изменения требуют переупорядочивания некоторых элементов (просеивания вверх или вниз) с логарифмической сложностью в сбалансированной структуре данных, где любое сравнение имеет равные шансы направить обход к левому или правому дочернему элементу. Новый алгоритм асимптотически быстрее, но выявляет новое узкое место, поскольку код поиска останавливается на промахах ветвления в половине случаев.
Поняв, что промахи ветвления замедляют код кучи, мы оптимизировали его, используя программирование без ветвления:
// Branchless Logic
static int compareMessages(@NonNull Message m1, @NonNull Message m2) {
    final long when1 = m1.when;
    final long when2 = m2.when;
    final long insertSeq1 = m1.insertSeq;
    final long insertSeq2 = m2.insertSeq;

    // signum returns the sign (-1, 0, 1) of the argument,
    // and is implemented as pure arithmetic:
    // ((num >> 63) | (-num >>> 63))
    final int whenSign = Long.signum(when1 - when2);
    final int insertSeqSign = Long.signum(insertSeq1 - insertSeq2);

    // whenSign takes precedence over insertSeqSign,
    // so the formula below is such that insertSeqSign only matters
    // as a tie-breaker if whenSign is 0.
    return whenSign * 2 + insertSeqSign;
}
Чтобы понять, как работает оптимизация, декомпилируйте два примера в Compiler Explorer и используйте LLVM-MCA – симулятор ЦП, который может генерировать расчетную временную шкалу циклов ЦП.
The original code:
Index     01234567890123
[0,0]     DeER .    .  .   sub  x0, x2, x3
[0,1]     D=eER.    .  .   cmp  x0, #0
[0,2]     D==eER    .  .   cset w0, ne
[0,3]     .D==eER   .  .   cneg w0, w0, lt
[0,4]     .D===eER  .  .   cmp  w0, #0
[0,5]     .D====eER .  .   b.le #12
[0,6]     . DeE---R .  .   mov  w1, #1
[0,7]     . DeE---R .  .   b    #48
[0,8]     . D==eE-R .  .   tbz  w0, #31, #12
[0,9]     .  DeE--R .  .   mov  w1, #-1
[0,10]    .  DeE--R .  .   b    #36
[0,11]    .  D=eE-R .  .   sub  x0, x4, x5
[0,12]    .   D=eER .  .   cmp  x0, #0
[0,13]    .   D==eER.  .   cset w0, ne
[0,14]    .   D===eER  .   cneg w0, w0, lt
[0,15]    .    D===eER .   cmp  w0, #0
[0,16]    .    D====eER.   csetm        w1, lt
[0,17]    .    D===eE-R.   cmp  w0, #0
[0,18]    .    .D===eER.   csinc        w1, w1, wzr, le
[0,19]    .    .D====eER   mov  x0, x1
[0,20]    .    .DeE----R   ret
Обратите внимание на условную ветвь b.le, которая позволяет избежать сравнения полей insertSeq, если результат уже известен из сравнения полей when.
The branchless code:
Index     012345678
[0,0]     DeER .  .   sub       x0, x2, x3
[0,1]     DeER .  .   sub       x1, x4, x5
[0,2]     D=eER.  .   cmp       x0, #0
[0,3]     .D=eER  .   cset      w0, ne
[0,4]     .D==eER .   cneg      w0, w0, lt
[0,5]     .DeE--R .   cmp       x1, #0
[0,6]     . DeE-R .   cset      w1, ne
[0,7]     . D=eER .   cneg      w1, w1, lt
[0,8]     . D==eeER   add       w0, w1, w0, lsl #1
[0,9]     .  DeE--R   ret
В этом случае реализация без ветвления требует меньше циклов и инструкций, чем даже самый короткий путь через код с ветвлением – это лучше во всех случаях. Более быстрая реализация и устранение неверно предсказанных ветвей позволили в пять раз улучшить некоторые из наших контрольных показателей.
Однако этот метод не всегда применим. Подходы без ветвления обычно требуют выполнения работы, которая будет отброшена, и если ветвь предсказуема большую часть времени, эта потраченная впустую работа может замедлить ваш код. Кроме того, удаление ветви часто приводит к зависимости данных. Современные процессоры выполняют несколько операций за цикл, но они не могут выполнить инструкцию, пока не будут готовы входные данные из предыдущей инструкции. В отличие от него, ЦП может предполагать, какие данные будут в ветвях, и работать на опережение, если ветвь предсказана правильно.
Тестирование и проверка
Проверка правильности алгоритмов без блокировки, как известно, сложна!
Помимо стандартного модульного тестирования для непрерывной проверки во время разработки, мы также написали строгие стресс-тесты, чтобы проверить инварианты очереди и попытаться вызвать состояние гонки, если оно существует. В наших тестовых лабораториях мы можем запускать миллионы тестовых экземпляров на эмулированных устройствах и на реальном оборудовании.
С помощью инструмента Java ThreadSanitizer (JTSan) мы смогли использовать те же тесты, чтобы обнаружить некоторые состояния гонки в нашем коде. JTSan не обнаружил проблемных состояний гонки в DeliQueue, но, к нашему удивлению, выявил две ошибки параллелизма в фреймворке Robolectric, которые мы оперативно исправили.
Чтобы улучшить возможности отладки, мы создали новые инструменты анализа. Ниже приведен пример проблемы в коде платформы Android, когда один поток перегружает другой поток с помощью Message, вызывая большое отставание, видимое в Perfetto благодаря добавленной нами функции инструментирования MessageQueue.
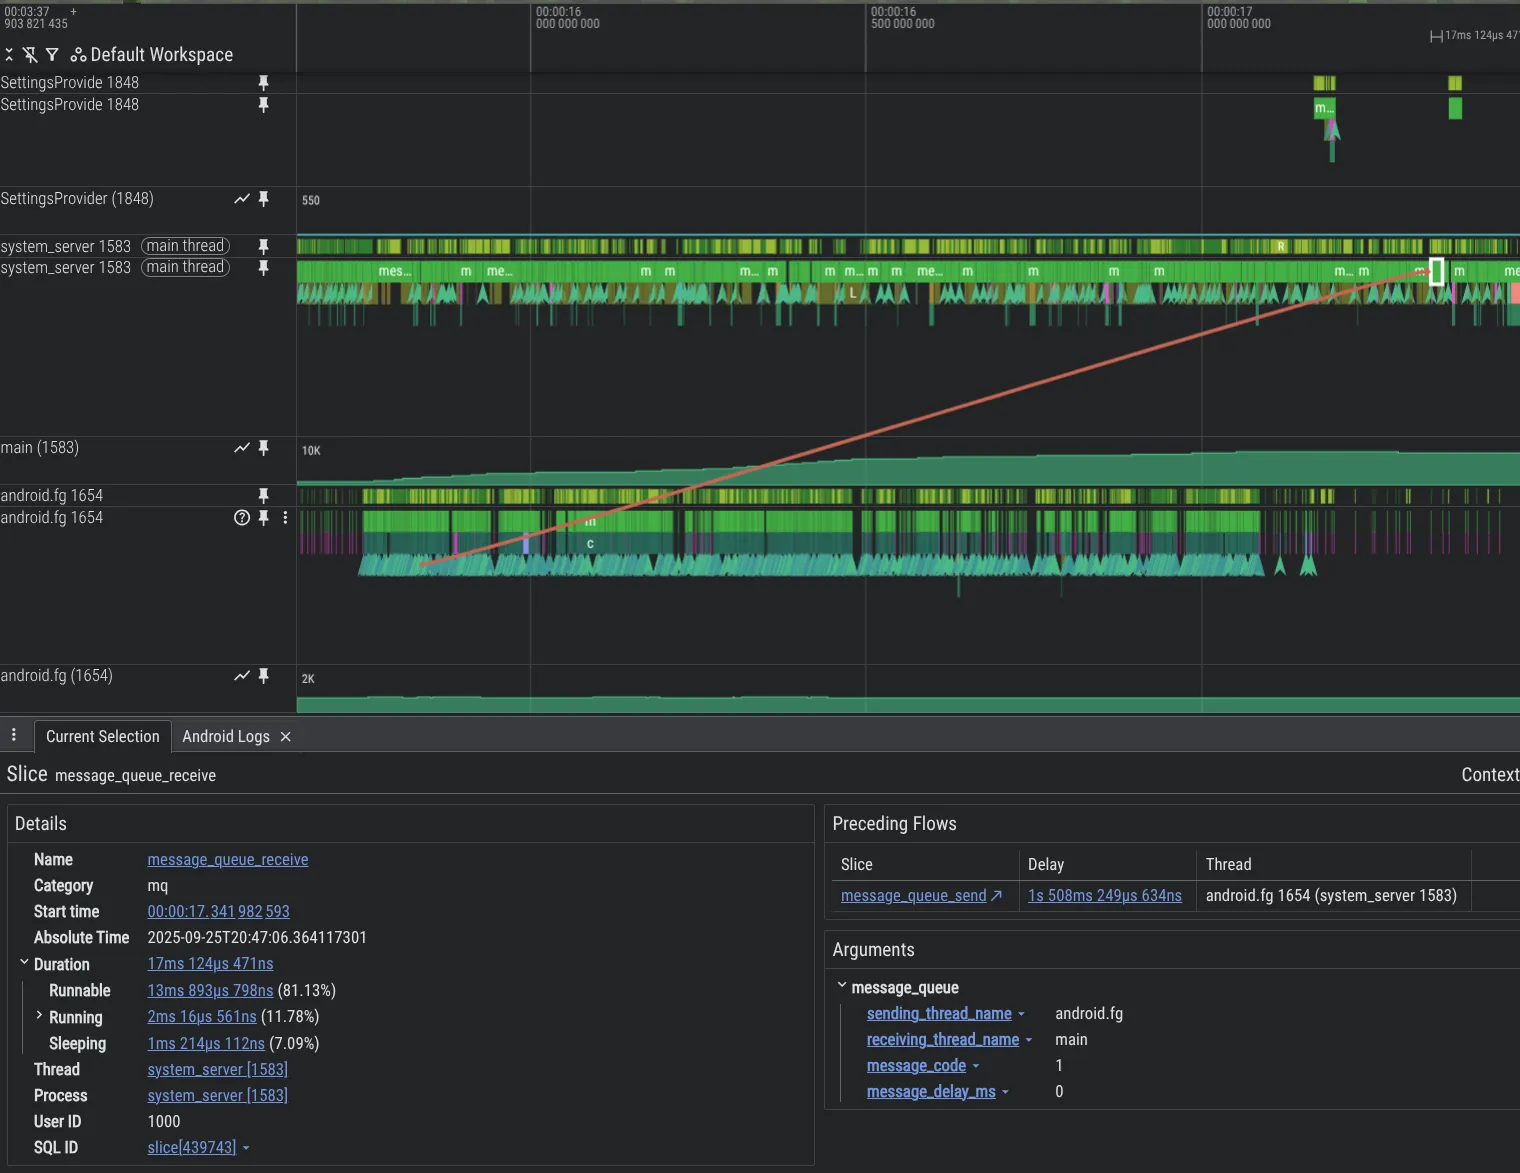
Чтобы включить трассировку MessageQueue в процессе system_server, добавьте в конфигурацию Perfetto следующее:
data_sources {
  config {
    name: "track_event"
    target_buffer: 0  # Change this per your buffers configuration
    track_event_config {
      enabled_categories: "mq"
    }
  }
}
Влияние изменений
DeliQueue повышает производительность системы и приложений, устраняя блокировки из MessageQueue.
- Синтетические тесты. Многопоточные вставки в занятые очереди выполняются до 5000 раз быстрее,чем в устаревшей версии
MessageQueue, благодаря улучшенному параллелизму (стек Трейбера) и более быстрым вставкам (минимальная куча). - Трассировки Perfetto, полученные от внутренних тестировщиков бета-версии, показали, что время, которое основной поток приложения тратит на конкуренцию за блокировку, сократилось на 15 %.
- На тех же тестовых устройствах снижение конкуренции за блокировку привело к значительному улучшению удобства для пользователей, например:
- -4% пропущенных кадров в приложениях.
- На 7,7% меньше пропущенных кадров при взаимодействии с интерфейсом системы и панелью запуска.
- Время от запуска приложения до отрисовки первого кадра сократилось на 9, 1 % (95-й процентиль).
Дальнейшие действия
DeliQueue появится в приложениях на Android 17. Разработчикам приложений рекомендуется ознакомиться с записью в блоге Android Developers о том, как подготовить приложение к работе с новым API MessageQueue, не требующим блокировки. В ней также рассказывается, как тестировать приложения.
Ссылки
[1] Treiber, R.K., 1986. Системное программирование: работа с параллелизмом. International Business Machines Incorporated, Thomas J. Watson Research Center.
[2] Goetz, B., Peierls, T., Bloch, J., Bowbeer, J., Holmes, D., & Lea, D. (2006). Java Concurrency in Practice. Addison-Wesley Professional.
-
 Новости о продуктах
Приложения, предназначенные для предстоящего выпуска Android, больше не смогут напрямую записывать данные в контакты с помощью разрешения WRITE_CONTACTS.
Roxanna Aliabadi Walker • Время на чтение: 6 минут -
 Новости о продуктах
По мере развития агентных технологий разработка для Android выходит на новый уровень: от вспомогательного автозаполнения кода до агентов, выполняющих сквозные задачи под вашим руководством. Вы можете выбирать любые модели и агентов.
Jason Buchel • Время на чтение: 3 минуты -
 Новости о продуктах
Сегодня мы рассказали, как планируем развивать концепцию "больше, чем магазин". Google Play доступен пользователям на разных платформах. Например, вкладка "Вы" – это персональный центр управления, которым ежемесячно пользуются более 250 миллионов активных пользователей за месяц. А наша единая игровая платформа объединяет более 700 миллионов игровых профилей.
Paul Feng • Время на чтение: 3 минуты
Получайте еженедельную рассылку с последними новостями о разработке для Android.