เบื้องหลัง: MessageQueue แบบไม่มีการล็อกของ Android 17
ใช้เวลาอ่าน 16 นาที
ใน Android 17 แอปที่กำหนดเป้าหมายเป็น SDK 37 ขึ้นไปจะได้รับการติดตั้งใช้งาน MessageQueue ใหม่ซึ่งไม่มีการล็อก การใช้งานใหม่นี้จะช่วยปรับปรุงประสิทธิภาพและลดเฟรมที่ขาดหายไป แต่อาจทำให้ไคลเอ็นต์ที่แสดงผลในช่องและเมธอดส่วนตัวของ MessageQueue เสียหาย ดูข้อมูลเพิ่มเติมเกี่ยวกับการเปลี่ยนแปลงลักษณะการทำงานและวิธีลดผลกระทบได้ที่เอกสารประกอบเกี่ยวกับการเปลี่ยนแปลงลักษณะการทำงานของ MessageQueue บล็อกโพสต์ทางเทคนิคนี้แสดงภาพรวมของสถาปัตยกรรมใหม่ของ MessageQueue และวิธีวิเคราะห์ปัญหาการแย่งชิงล็อกโดยใช้ Perfetto
Looper จะขับเคลื่อนเธรด UI ของแอปพลิเคชัน Android ทุกแอป โดยจะดึงงานจาก MessageQueue ส่งไปยัง Handler และทำซ้ำ เป็นเวลา 2 ทศวรรษที่ MessageQueue ใช้การล็อกจอภาพเดียว (เช่น บล็อกโค้ด synchronized) เพื่อปกป้องสถานะของตนเอง
Android 17 มีการอัปเดตที่สำคัญสำหรับคอมโพเนนต์นี้ ซึ่งก็คือการติดตั้งใช้งานแบบไม่มีการล็อกที่ชื่อว่า DeliQueue
โพสต์นี้จะอธิบายว่าการล็อกส่งผลต่อประสิทธิภาพของ UI อย่างไร วิธีวิเคราะห์ปัญหาเหล่านี้ด้วย Perfetto รวมถึงอัลกอริทึมและการเพิ่มประสิทธิภาพที่เฉพาะเจาะจงซึ่งใช้เพื่อปรับปรุงเทรดหลักของ Android
ปัญหา: การแย่งชิงล็อกและการกลับลำดับความสำคัญ
MessageQueue เดิมทำหน้าที่เป็นคิวที่มีลำดับความสำคัญซึ่งได้รับการปกป้องโดยการล็อกเพียงครั้งเดียว หากเทรดเบื้องหลังโพสต์ข้อความขณะที่เทรดหลักดำเนินการบำรุงรักษาคิว เทรดเบื้องหลังจะบล็อกเทรดหลัก
เมื่อเทรดอย่างน้อย 2 เทรดแข่งขันกันเพื่อใช้ล็อกเดียวกันแต่เพียงผู้เดียว เราจะเรียกว่าการแย่งชิงล็อก การแย่งชิงนี้อาจทำให้เกิดการกลับลำดับความสำคัญ ซึ่งนำไปสู่ความกระตุกของ UI และปัญหาด้านประสิทธิภาพอื่นๆ
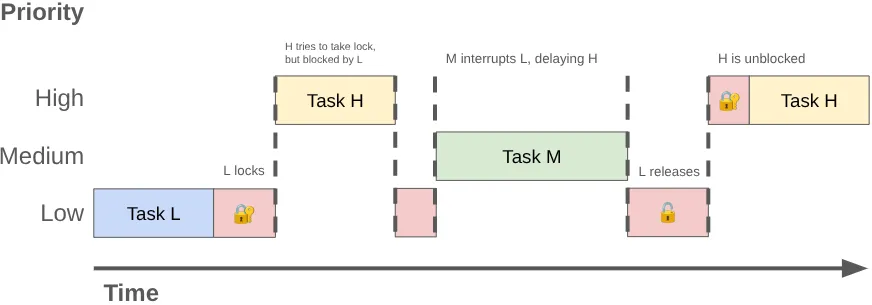
การกลับลำดับความสำคัญอาจเกิดขึ้นเมื่อเธรดที่มีลำดับความสำคัญสูง (เช่น เธรด UI) ต้องรอเธรดที่มีลำดับความสำคัญต่ำ ลองพิจารณาลำดับต่อไปนี้
- เทรดเบื้องหลังที่มีลำดับความสำคัญต่ำจะได้รับล็อก
MessageQueueเพื่อโพสต์ผลลัพธ์ของงานที่ทำ - เทรดลำดับความสำคัญปานกลางจะทำงานได้ และตัวจัดตารางเวลาของเคอร์เนลจะจัดสรรเวลา CPU ให้กับเทรดดังกล่าว โดยจะแย่งสิทธิ์เทรดที่มีลำดับความสำคัญต่ำ
- เธรด UI ที่มีลำดับความสำคัญสูงทำงานปัจจุบันเสร็จและพยายามอ่านจากคิว แต่ถูกบล็อกเนื่องจากเธรดที่มีลำดับความสำคัญต่ำถือล็อกอยู่
เธรดที่มีลำดับความสำคัญต่ำจะบล็อกเธรด UI และงานที่มีลำดับความสำคัญปานกลางจะทำให้เธรด UI ล่าช้าออกไปอีก
การวิเคราะห์การช่วงชิงทรัพยากรด้วย Perfetto
คุณสามารถวินิจฉัยปัญหาเหล่านี้ได้โดยใช้ Perfetto ในการติดตามมาตรฐาน เทรดที่ถูกบล็อกในการล็อกมอนิเตอร์จะเข้าสู่สถานะพัก และ Perfetto จะแสดงส่วนที่ระบุเจ้าของการล็อก
เมื่อค้นหาข้อมูลการติดตาม ให้มองหา Slice ที่ชื่อ "monitor contention with …" ตามด้วยชื่อของชุดข้อความที่เป็นเจ้าของล็อกและเว็บไซต์โค้ดที่ได้รับล็อก
กรณีศึกษา: Launcher ขัดข้อง
เราจะวิเคราะห์การติดตามที่ผู้ใช้พบอาการกระตุกขณะไปยังหน้าแรกในโทรศัพท์ Pixel ทันทีหลังจากถ่ายภาพในแอปกล้องถ่ายรูป ด้านล่างนี้คือภาพหน้าจอของ Perfetto ที่แสดงเหตุการณ์ที่นำไปสู่เฟรมที่พลาดไป
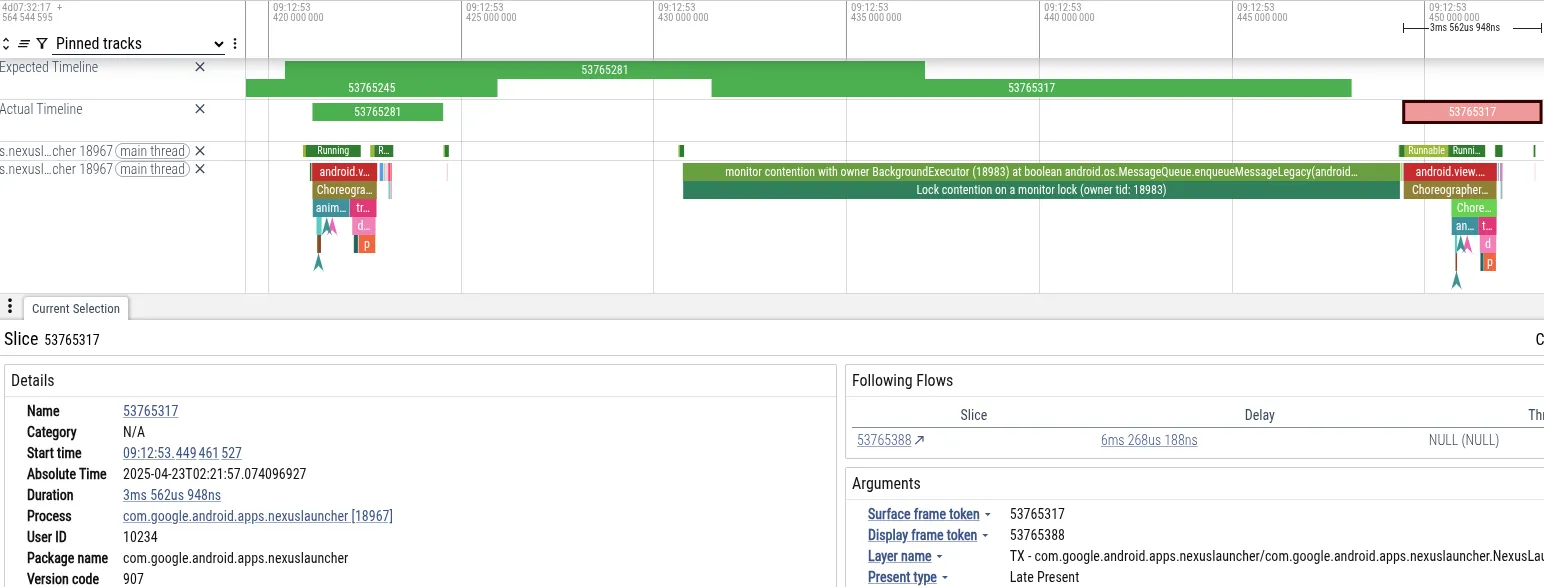
- อาการ: เทรดหลักของ Launcher ไม่ทันกำหนดเวลาเฟรม โดยบล็อกเป็นเวลา 18 มิลลิวินาที ซึ่งเกินกำหนดเวลา 16 มิลลิวินาทีที่จำเป็นสำหรับการแสดงผล 60Hz
- การวินิจฉัย: Perfetto แสดงเทรดหลักที่ถูกบล็อกในล็อก
MessageQueueเทรด "BackgroundExecutor" เป็นเจ้าของล็อก - สาเหตุของปัญหา: BackgroundExecutor ทำงานที่ Process.THREAD_PRIORITY_BACKGROUND (ลำดับความสำคัญต่ำมาก) เนื่องจากกำลังทำงานที่ไม่เร่งด่วน (ตรวจสอบขีดจำกัดการใช้งานแอป) ในขณะเดียวกัน เทรดที่มีลำดับความสำคัญปานกลางก็ใช้เวลา CPU ในการประมวลผลข้อมูลจากกล้อง ตัวจัดตารางเวลาของระบบปฏิบัติการได้แย่งสิทธิ์เทรด BackgroundExecutor เพื่อเรียกใช้เทรดกล้อง
ลำดับนี้ทำให้เธรด UI ของ Launcher (ลำดับความสำคัญสูง) ถูกบล็อกโดยอ้อมจากเทรดผู้ปฏิบัติงานของกล้อง (ลำดับความสำคัญปานกลาง) ซึ่งทำให้เธรดเบื้องหลังของ Launcher (ลำดับความสำคัญต่ำ) ไม่สามารถปลดล็อกได้
การค้นหาการติดตามด้วย PerfettoSQL
คุณสามารถใช้ PerfettoSQL เพื่อค้นหาข้อมูลการติดตามสำหรับรูปแบบที่เฉพาะเจาะจงได้ ซึ่งจะเป็นประโยชน์หากคุณมีคลังการติดตามขนาดใหญ่จากอุปกรณ์ของผู้ใช้หรือการทดสอบ และคุณกำลังค้นหาการติดตามที่เฉพาะเจาะจงซึ่งแสดงให้เห็นปัญหา
ตัวอย่างเช่น การค้นหานี้จะค้นหาการแย่งชิงทรัพยากร MessageQueue ที่เกิดขึ้นพร้อมกับเฟรมที่หายไป (กระตุก)
INCLUDE PERFETTO MODULE android.monitor_contention;
INCLUDE PERFETTO MODULE android.frames.jank_type;

SELECT
  process_name,
  -- Convert duration from nanoseconds to milliseconds
  SUM(dur) / 1000000 AS sum_dur_ms,
  COUNT(*) AS count_contention
FROM android_monitor_contention
WHERE is_blocked_thread_main
AND short_blocked_method LIKE "%MessageQueue%"

-- Only look at app processes that had jank
AND upid IN (
  SELECT DISTINCT(upid)
  FROM actual_frame_timeline_slice
  WHERE android_is_app_jank_type(jank_type) = TRUE
)
GROUP BY process_name
ORDER BY SUM(dur) DESC;
ในตัวอย่างที่ซับซ้อนยิ่งขึ้นนี้ ให้รวมข้อมูลการติดตามที่ครอบคลุมหลายตารางเพื่อระบุการแย่งชิง MessageQueue ระหว่างการเริ่มต้นแอป
INCLUDE PERFETTO MODULE android.monitor_contention;
INCLUDE PERFETTO MODULE android.startup.startups;

-- Join package and process information for startups
DROP VIEW IF EXISTS startups;
CREATE VIEW startups AS
SELECT startup_id, ts, dur, upid
FROM android_startups
JOIN android_startup_processes USING(startup_id);

-- Intersect monitor contention with startups in the same process.
DROP TABLE IF EXISTS monitor_contention_during_startup;
CREATE VIRTUAL TABLE monitor_contention_during_startup
USING SPAN_JOIN(android_monitor_contention PARTITIONED upid, startups PARTITIONED upid);

SELECT
  process_name,
  SUM(dur) / 1000000 AS sum_dur_ms,
  COUNT(*) AS count_contention
FROM monitor_contention_during_startup
WHERE is_blocked_thread_main
AND short_blocked_method LIKE "%MessageQueue%"
GROUP BY process_name
ORDER BY SUM(dur) DESC;
คุณสามารถใช้ LLM ที่คุณชื่นชอบเพื่อเขียนการค้นหา PerfettoSQL เพื่อค้นหารูปแบบอื่นๆ ได้
ที่ Google เราใช้ BigTrace เพื่อเรียกใช้การค้นหา PerfettoSQL ในการติดตามหลายล้านรายการ ซึ่งทำให้เรายืนยันได้ว่าสิ่งที่เห็นจากเรื่องราวที่เล่าต่อกันมานั้นเป็นปัญหาเชิงระบบจริงๆ ข้อมูลแสดงให้เห็นว่าการแย่งชิงล็อกของ MessageQueue ส่งผลกระทบต่อผู้ใช้ทั่วทั้งระบบนิเวศ ซึ่งเป็นการยืนยันถึงความจำเป็นในการเปลี่ยนแปลงสถาปัตยกรรมพื้นฐาน
โซลูชัน: การทำงานพร้อมกันแบบไม่มีการล็อก
เราแก้ไขปัญหาการแย่งชิงทรัพยากรของ MessageQueue โดยใช้โครงสร้างข้อมูลแบบไม่มีการล็อก โดยใช้การดำเนินการหน่วยความจำแบบอะตอมแทนการล็อกแบบเอกสิทธิ์เฉพาะบุคคลเพื่อซิงค์การเข้าถึงสถานะที่แชร์ โครงสร้างข้อมูลหรืออัลกอริทึมจะไม่มีการล็อกหากมีเทรดอย่างน้อย 1 เทรดที่ทำงานได้เสมอ ไม่ว่าลักษณะการกำหนดเวลาของเทรดอื่นๆ จะเป็นอย่างไร โดยทั่วไปแล้ว คุณสมบัตินี้ทำได้ยาก และมักไม่คุ้มค่าที่จะดำเนินการกับโค้ดส่วนใหญ่
องค์ประกอบพื้นฐานแบบอะตอม
ซอฟต์แวร์ที่ไม่มีการล็อกมักจะอาศัยพื้นฐานการอ่าน-แก้ไข-เขียนแบบอะตอมที่ฮาร์ดแวร์มีให้
ใน CPU ARM64 รุ่นเก่า อะตอมิกใช้ลูป Load-Link/Store-Conditional (LL/SC) CPU จะโหลดค่าและทำเครื่องหมายที่อยู่ หากเทรดอื่นเขียนไปยังที่อยู่นั้น การจัดเก็บจะล้มเหลว และลูปจะลองอีกครั้ง เนื่องจากเทรดสามารถพยายามต่อไปและดำเนินการสำเร็จได้โดยไม่ต้องรอเทรดอื่น การดำเนินการนี้จึงไม่มีการล็อก
ARM64 LL/SC loop example
retry:
    ldxr    x0, [x1]        // Load exclusive from address x1 to x0
    add     x0, x0, #1      // Increment value by 1
    stxr    w2, x0, [x1]    // Store exclusive.
                            // w2 gets 0 on success, 1 on failure
cbnz w2, retry // If w2 is non-zero (failed), branch to retrสถาปัตยกรรม ARM ที่ใหม่กว่า (ARMv8.1) รองรับ Large System Extensions (LSE) ซึ่งรวมถึงวิธีการในรูปแบบ Compare-And-Swap (CAS) หรือ Load-And-Add (แสดงด้านล่าง) ใน Android 17 เราได้เพิ่มการรองรับคอมไพเลอร์ Android Runtime (ART) เพื่อตรวจหาเมื่อระบบรองรับ LSE และส่งคำสั่งที่เพิ่มประสิทธิภาพแล้ว
/ ARMv8.1 LSE atomic example
ldadd   x0, x1, [x2]    // Atomic load-add.
                        // Faster, no loop required.
ในการเปรียบเทียบของเรา โค้ดที่มีการแย่งชิงทรัพยากรสูงซึ่งใช้ CAS จะมีความเร็วเพิ่มขึ้นประมาณ 3 เท่าเมื่อเทียบกับตัวแปร LL/SC
ภาษาโปรแกรม Java มีองค์ประกอบพื้นฐานแบบอะตอมผ่าน java.util.concurrent.atomic ซึ่งอาศัยคำสั่ง CPU เฉพาะเหล่านี้และคำสั่งอื่นๆ
โครงสร้างข้อมูล: DeliQueue
วิศวกรของเราได้ออกแบบโครงสร้างข้อมูลแบบใหม่ที่เรียกว่า DeliQueue เพื่อนำการแย่งชิงล็อกออกจาก MessageQueue DeliQueue จะแยกการแทรก Message ออกจากการประมวลผล Message ดังนี้
- รายการของ
Messages(Treiber stack): สแต็กที่ไม่มีการล็อก ชุดข้อความใดๆ สามารถพุชMessagesใหม่ที่นี่ได้โดยไม่มีการแย่งชิงทรัพยากร - คิวที่มีลำดับความสำคัญ (Min-heap): กอง
Messagesที่ต้องจัดการ ซึ่งเป็นของเทรด Looper โดยเฉพาะ (จึงไม่จำเป็นต้องมีการซิงค์หรือล็อกเพื่อเข้าถึง)
Enqueue: pushing to a Treiber stack
รายการ Messages จะเก็บไว้ในสแต็ก Treiber [1] ซึ่งเป็นสแต็กแบบไม่มีล็อกที่ใช้ลูป CAS เพื่ออัปเดตตัวชี้ส่วนหัว
public class TreiberStack <E> {
    AtomicReference<Node<E>> top =
            new AtomicReference<Node<E>>();
    public void push(E item) {
        Node<E> newHead = new Node<E>(item);
        Node<E> oldHead;
        do {
            oldHead = top.get();
            newHead.next = oldHead;
        } while (!top.compareAndSet(oldHead, newHead));
    }

    public E pop() {
        Node<E> oldHead;
        Node<E> newHead;
        do {
            oldHead = top.get();
            if (oldHead == null) return null;
            newHead = oldHead.next;
        } while (!top.compareAndSet(oldHead, newHead));
        return oldHead.item;
    }
}
ซอร์สโค้ดที่อิงตาม Java Concurrency in Practice [2] พร้อมใช้งานออนไลน์และเผยแพร่เป็นสาธารณสมบัติ
ผู้ผลิตสามารถพุช Message ใหม่ไปยังสแต็กได้ทุกเมื่อ ซึ่งคล้ายกับการดึงตั๋วที่เคาน์เตอร์อาหารสำเร็จรูป โดยหมายเลขของคุณจะกำหนดตามเวลาที่คุณมาถึง แต่ลำดับที่คุณได้รับอาหารไม่จำเป็นต้องตรงกัน เนื่องจากเป็นสแต็กที่ลิงก์กัน Message ทุกรายการจึงเป็นสแต็กย่อย คุณสามารถดูว่าคิว Message เป็นอย่างไร ณ จุดใดก็ได้โดยการติดตามส่วนหัวและทำซ้ำไปข้างหน้า คุณจะไม่เห็น Message ใหม่ที่พุชไว้ด้านบน แม้ว่าจะมีการเพิ่มในระหว่างการข้ามผ่านก็ตาม
Dequeue: bulk transfer to a min-heap
หากต้องการค้นหา Message ถัดไปที่จะจัดการ Looper จะประมวลผล Message ใหม่จากสแต็ก Treiber โดยเดินผ่านสแต็กโดยเริ่มจากด้านบนและทำซ้ำจนกว่าจะพบ Message สุดท้ายที่ประมวลผลก่อนหน้านี้ เมื่อ Looper เคลื่อนที่ลงไปตามสแต็ก ระบบจะแทรก Message ลงในฮีปต่ำสุดที่เรียงตามกำหนดเวลา เนื่องจาก Looper เป็นเจ้าของฮีปแต่เพียงผู้เดียว จึงจัดลำดับและประมวลผล Message โดยไม่มีการล็อกหรืออะตอมมิก
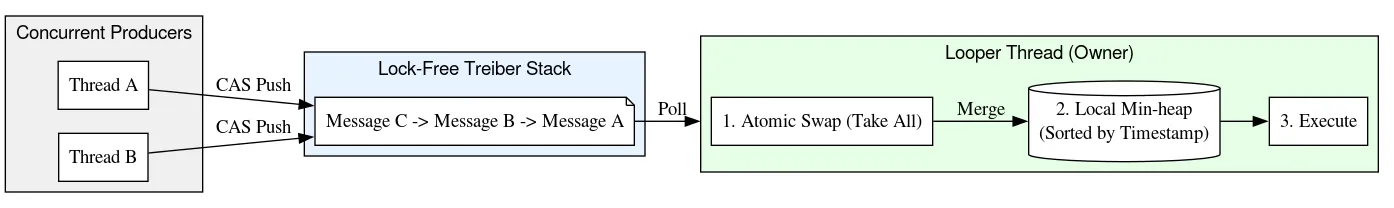
เมื่อเดินลงไปตามสแต็ก Looper จะสร้างลิงก์จาก Message ที่ซ้อนกันกลับไปยังรายการก่อนหน้าด้วย จึงทำให้เกิดรายการที่ลิงก์ซ้อนกัน การสร้างรายการที่ลิงก์นั้นปลอดภัยเนื่องจากระบบจะเพิ่มลิงก์ที่ชี้ลงไปยังสแต็กผ่านอัลกอริทึมสแต็ก Treiber ที่มี CAS และลิงก์ที่ชี้ขึ้นไปยังสแต็กจะอ่านและแก้ไขโดยเทรด Looper เท่านั้น จากนั้นระบบจะใช้ลิงก์ย้อนกลับเหล่านี้เพื่อนำ Message ออกจากจุดที่กำหนดเองในสแต็กในเวลา O(1)
การออกแบบนี้ให้การแทรก O(1) สำหรับผู้ผลิต (ชุดข้อความที่โพสต์งานไปยังคิว) และการประมวลผล O(log N) ที่ตัดจำหน่ายสำหรับผู้ใช้ (Looper)
การใช้ Min-Heap เพื่อจัดลำดับ Message ยังช่วยแก้ไขข้อบกพร่องพื้นฐานใน MessageQueue เดิม ซึ่งเก็บ Message ไว้ในรายการที่ลิงก์แบบเดี่ยว (มีรากอยู่ที่ด้านบน) ในการติดตั้งใช้งานแบบเดิม การนำออกจากส่วนหัวคือ O(1) แต่การแทรกมีกรณีที่แย่ที่สุดคือ O(N) ซึ่งปรับขนาดได้ไม่ดีสำหรับคิวที่โอเวอร์โหลด ในทางกลับกัน การแทรกและการนำออกจาก Min-Heap จะปรับขนาดแบบลอการิทึม ซึ่งให้ประสิทธิภาพเฉลี่ยที่แข่งขันได้ แต่โดดเด่นมากในเรื่องเวลาในการตอบสนองแบบ Tail
เวอร์ชันเดิม (ล็อก) MessageQueue | DeliQueue | |
| แทรก | O(N) | O(1) สำหรับชุดข้อความการโทร O(logN) สำหรับเทรด |
| นำออกจากศีรษะ | O(1) | O(logN) |
ในการใช้งานคิวแบบเดิม ผู้ผลิตและผู้บริโภคใช้การล็อกเพื่อประสานงานการเข้าถึงรายการที่ลิงก์แบบเดี่ยวที่สำคัญโดยเฉพาะ ใน DeliQueue สแต็ก Treiber จะจัดการการเข้าถึงพร้อมกัน และผู้ใช้รายเดียวจะจัดการการจัดลำดับคิวงาน
การนำออก: ความสอดคล้องกันผ่าน Tombstone
DeliQueue เป็นโครงสร้างข้อมูลแบบผสมที่รวมสแต็ก Treiber แบบไม่มีล็อกเข้ากับมินฮีปแบบเทรดเดียว การซิงค์โครงสร้างทั้ง 2 แบบนี้โดยไม่มีการล็อกส่วนกลางทำให้เกิดความท้าทายที่ไม่เหมือนใคร นั่นคือข้อความอาจปรากฏในสแต็ก แต่ถูกนำออกจากคิวในทางตรรกะ
เพื่อแก้ปัญหานี้ DeliQueue ใช้เทคนิคที่เรียกว่า "Tombstoning" โดย Message แต่ละรายการจะติดตามตำแหน่งของตนเองในสแต็กผ่านตัวชี้ไปข้างหลังและไปข้างหน้า ดัชนีในอาร์เรย์ของฮีป และแฟล็กบูลีนที่ระบุว่ามีการนำออกหรือไม่ เมื่อ Message พร้อมที่จะทำงาน เทรด Looper จะ CAS แฟล็กที่นำออก จากนั้นนำออกจากฮีปและสแต็ก
เมื่อชุดข้อความอื่นต้องการนำ Message ออก ระบบจะไม่ดึงข้อมูลออกจากโครงสร้างข้อมูลทันที แต่จะทำตามขั้นตอนต่อไปนี้แทน
- การนำออกเชิงตรรกะ: เทรดใช้ CAS เพื่อตั้งค่าแฟล็กการนำออกของ
Messageจากเท็จเป็นจริงโดยอัตโนมัติMessageจะยังคงอยู่ในโครงสร้างข้อมูลเพื่อเป็นหลักฐานว่ากำลังรอนำออก ซึ่งเรียกว่า "Tombstone" เมื่อมีการแจ้งว่าต้องการนำMessageออก DeliQueue จะถือว่าไม่มีข้อมูลดังกล่าวอยู่ในคิวอีกต่อไปเมื่อใดก็ตามที่พบข้อมูลนั้น - การล้างข้อมูลที่เลื่อนออกไป: การนำออกจากโครงสร้างข้อมูลจริงเป็นความรับผิดชอบของเทรด
Looperและจะเลื่อนออกไปจนกว่าจะถึงภายหลัง เธรดตัวนำออกจะเพิ่มMessageไปยังสแต็กรายการว่างแบบไม่มีการล็อกอีกรายการหนึ่ง แทนที่จะแก้ไขสแต็กหรือฮีป - การนำออกเชิงโครงสร้าง: เฉพาะ
Looperเท่านั้นที่โต้ตอบกับฮีปหรือนำองค์ประกอบออกจากสแต็กได้ เมื่อตื่นขึ้นมา ระบบจะล้างรายการที่ว่างและประมวลผลMessageที่มีอยู่ จากนั้นระบบจะยกเลิกการลิงก์Messageแต่ละรายการจากสแต็กและนำออกจากฮีป
วิธีนี้จะทำให้การจัดการฮีปทั้งหมดเป็นแบบเทรดเดียว ซึ่งจะช่วยลดจำนวนการดำเนินการที่เกิดขึ้นพร้อมกันและอุปสรรคด้านหน่วยความจำที่จำเป็น ทำให้เส้นทางวิกฤตเร็วขึ้นและง่ายขึ้น
การข้าม: การแย่งชิงข้อมูลโมเดลหน่วยความจำ Java ที่ไม่เป็นอันตราย
API การทำงานพร้อมกันส่วนใหญ่ เช่น Future ในไลบรารีมาตรฐานของ Java หรือ Job และ Deferred ของ Kotlin มีกลไกในการยกเลิกงานก่อนที่จะเสร็จสมบูรณ์ อินสแตนซ์ของคลาสใดคลาสหนึ่งเหล่านี้จะจับคู่แบบ 1:1 กับหน่วยงานที่เกี่ยวข้อง และการเรียกใช้ cancel ในออบเจ็กต์จะยกเลิกการดำเนินการที่เฉพาะเจาะจงซึ่งเชื่อมโยงกับออบเจ็กต์เหล่านั้น
อุปกรณ์ Android ในปัจจุบันมี CPU แบบหลายคอร์และเครื่องมือเก็บหน่วยความจำแอปตามรุ่นที่ทำงานพร้อมกัน แต่เมื่อ Android ได้รับการพัฒนาขึ้นเป็นครั้งแรก การจัดสรรออบเจ็กต์ 1 รายการสำหรับงานแต่ละหน่วยนั้นมีค่าใช้จ่ายสูงเกินไป ด้วยเหตุนี้ Handler ของ Android จึงรองรับการยกเลิกผ่านการโอเวอร์โหลดจำนวนมากของ removeMessages แทนที่จะนำ Message ที่เฉพาะเจาะจงออก ระบบจะนำ Message ทั้งหมดที่ตรงกับเกณฑ์ที่ระบุออก ในทางปฏิบัติ คุณจะต้องทำซ้ำผ่าน Message ทั้งหมดที่แทรกไว้ก่อนที่จะเรียกใช้ removeMessages และนำรายการที่ตรงกันออก
เมื่อทำซ้ำไปข้างหน้า เทรดต้องการการดำเนินการแบบอะตอมมิกที่มีการจัดลำดับเพียงรายการเดียวเพื่ออ่านส่วนหัวปัจจุบันของสแต็ก หลังจากนั้น ระบบจะใช้การอ่านฟิลด์แบบธรรมดาเพื่อค้นหา Message ถัดไป หากเทรด Looper แก้ไขช่อง next ขณะนำ Message ออก การเขียนของ Looper และการอ่านของเทรดอื่นจะไม่ซิงค์กัน ซึ่งเรียกว่าการแย่งใช้ข้อมูล โดยปกติแล้ว การแย่งใช้ข้อมูลเป็นข้อบกพร่องร้ายแรงที่อาจทำให้เกิดปัญหาใหญ่ในแอป เช่น การรั่วไหล, การวนซ้ำไม่สิ้นสุด, ข้อขัดข้อง, อาการค้าง และอื่นๆ อย่างไรก็ตาม ภายใต้เงื่อนไขที่จำกัดบางอย่าง การแย่งชิงข้อมูลอาจไม่เป็นอันตรายภายในโมเดลหน่วยความจำของ Java สมมติว่าเราเริ่มด้วยกองไพ่ต่อไปนี้

เราทำการอ่านแบบอะตอมมิกของส่วนหัวและเห็น A ตัวชี้ถัดไปของ A ชี้ไปที่ B ในขณะเดียวกันกับที่เราประมวลผล B ตัววนซ้ำอาจนำ B และ C ออกโดยอัปเดต A ให้ชี้ไปยัง C แล้วจึงชี้ไปยัง D
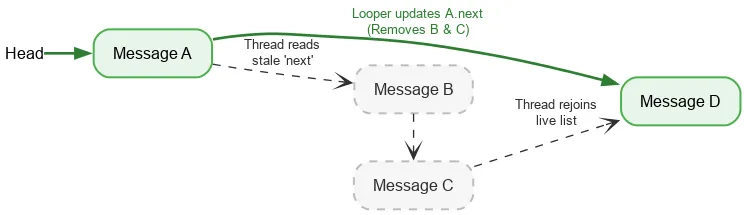
แม้ว่า B และ C จะถูกนำออกตามตรรกะ แต่ B ยังคงเก็บตัวชี้ถัดไปไว้ที่ C และ C ไปยัง D เทรดการอ่านจะยังคงข้ามผ่านโหนดที่ถูกนำออกซึ่งแยกออกมา และในที่สุดจะกลับเข้าร่วมสแต็กที่ใช้งานอยู่ ณ D
การออกแบบ DeliQueue ให้จัดการกับการแข่งขันระหว่างการข้ามและการนำออกช่วยให้เราสามารถทำซ้ำได้อย่างปลอดภัยโดยไม่ต้องล็อก
กำลังออก: Refcount แบบเนทีฟ
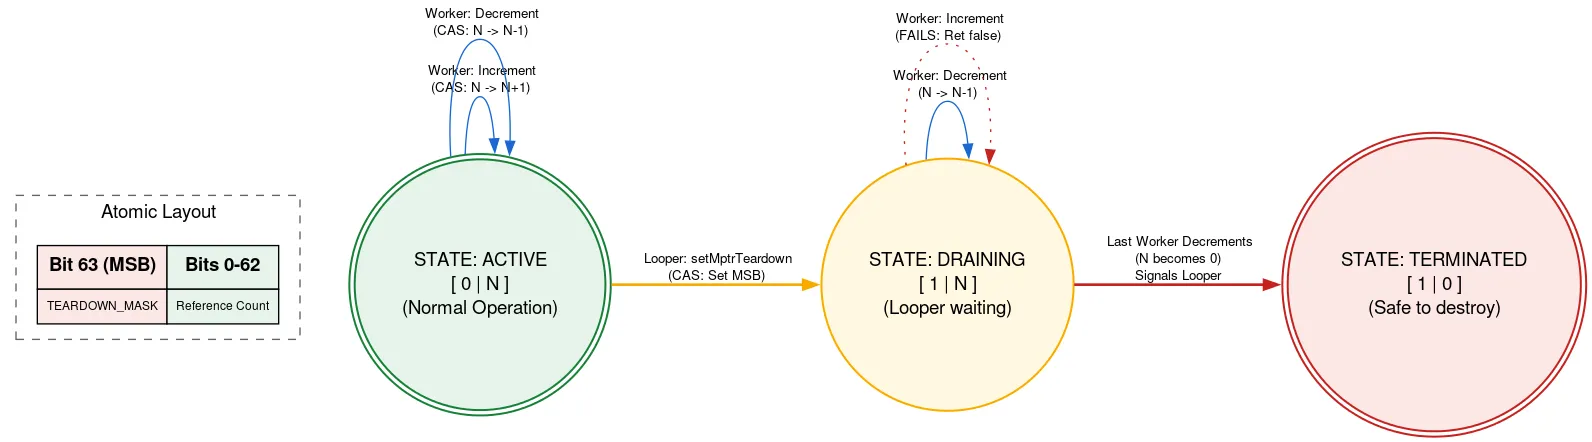
Looper ได้รับการสนับสนุนโดยการจัดสรรแบบเนทีฟที่ต้องเพิ่มพื้นที่ว่างด้วยตนเองเมื่อ Looper ออกแล้ว หากชุดข้อความอื่นกำลังเพิ่ม Message ขณะที่ Looper กำลังออก ชุดข้อความดังกล่าวอาจใช้การจัดสรรแบบเนทีฟหลังจากที่ว่างแล้ว ซึ่งเป็นการละเมิดความปลอดภัยของหน่วยความจำ เราป้องกันปัญหานี้โดยใช้ tagged refcount ซึ่งจะใช้ 1 บิตของอะตอมเพื่อระบุว่า Looper กำลังจะปิดหรือไม่
ก่อนใช้การจัดสรรแบบเนทีฟ เทรดจะอ่านอะตอมมิก refcount หากมีการตั้งค่าบิตการออก ระบบจะแสดงผลว่า Looper กำลังออกและต้องไม่ใช้การจัดสรรแบบเนทีฟ หากไม่เป็นเช่นนั้น ระบบจะพยายามใช้ CAS เพื่อเพิ่มจำนวนชุดข้อความที่ใช้งานอยู่โดยใช้การจัดสรรแบบเนทีฟ หลังจากทำสิ่งที่ต้องทำแล้ว ระบบจะลดจำนวนลง หากมีการตั้งค่าบิตการออกหลังจากเพิ่มขึ้นแต่ก่อนลดลง และตอนนี้จำนวนเป็น 0 ระบบจะปลุกเทรด Looper
เมื่อเทรด Looper พร้อมที่จะออก เทรดจะใช้ CAS เพื่อตั้งค่าบิตการออกในอะตอม หาก refcount เป็น 0 ระบบจะดำเนินการต่อเพื่อเพิ่มพื้นที่ว่างในการจัดสรรแบบเนทีฟได้ ไม่เช่นนั้น ระบบจะพักตัวเองไว้ โดยรู้ว่าจะถูกปลุกเมื่อผู้ใช้รายสุดท้ายของการจัดสรรแบบเนทีฟลดจำนวนการอ้างอิง แนวทางนี้หมายความว่าเทรด Looper จะรอความคืบหน้าของเทรดอื่นๆ แต่จะรอเฉพาะเมื่อกำลังจะออกเท่านั้น ซึ่งจะเกิดขึ้นเพียงครั้งเดียวและไม่ส่งผลต่อประสิทธิภาพ และจะเก็บโค้ดอื่นๆ ไว้เพื่อใช้การจัดสรรแบบเนทีฟโดยไม่มีการล็อกอย่างสมบูรณ์
ยังมีเคล็ดลับและความซับซ้อนอื่นๆ อีกมากมายในการติดตั้งใช้งาน ดูข้อมูลเพิ่มเติมเกี่ยวกับ DeliQueue ได้โดยการตรวจสอบซอร์สโค้ด
การเพิ่มประสิทธิภาพ: การเขียนโปรแกรมแบบไม่มี Branch
ในระหว่างการพัฒนาและทดสอบ DeliQueue ทีมได้ทำการเปรียบเทียบหลายครั้งและวิเคราะห์โค้ดใหม่อย่างรอบคอบ ปัญหาหนึ่งที่พบจากการใช้เครื่องมือ simpleperf คือการล้างไปป์ไลน์ที่เกิดจากโค้ดตัวเปรียบเทียบ Message
ตัวเปรียบเทียบมาตรฐานจะใช้การข้ามแบบมีเงื่อนไข โดยมีเงื่อนไขในการตัดสินใจว่า Message ใดจะมาก่อนตามที่อธิบายไว้ด้านล่าง
static int compareMessages(@NonNull Message m1, @NonNull Message m2) {
    if (m1 == m2) {
        return 0;
    }

    // Primary queue order is by when.
    // Messages with an earlier when should come first in the queue.
    final long whenDiff = m1.when - m2.when;
    if (whenDiff > 0) return 1;
    if (whenDiff < 0) return -1;

    // Secondary queue order is by insert sequence.
    // If two messages were inserted with the same `when`, the one inserted
    // first should come first in the queue.
    final long insertSeqDiff = m1.insertSeq - m2.insertSeq;
    if (insertSeqDiff > 0) return 1;
    if (insertSeqDiff < 0) return -1;

    return 0;
}
โค้ดนี้จะคอมไพล์เป็นการข้ามแบบมีเงื่อนไข (คำสั่ง b.le และ cbnz) เมื่อ CPU พบ Branch แบบมีเงื่อนไข ก็จะไม่ทราบว่ามีการใช้ Branch หรือไม่จนกว่าจะมีการคำนวณเงื่อนไข จึงไม่ทราบว่าควรอ่านคำสั่งใดต่อไป และต้องเดาโดยใช้เทคนิคที่เรียกว่าการคาดคะเน Branch ในกรณีอย่างการค้นหาแบบไบนารี ทิศทางของสาขาจะแตกต่างกันอย่างคาดเดาไม่ได้ในแต่ละขั้นตอน ดังนั้นจึงเป็นไปได้ว่าการคาดคะเนครึ่งหนึ่งจะผิดพลาด การคาดคะเนสาขามักไม่มีประสิทธิภาพในอัลกอริทึมการค้นหาและการจัดเรียง (เช่น อัลกอริทึมที่ใช้ใน Min-Heap) เนื่องจากต้นทุนของการเดาผิดมีมากกว่าการปรับปรุงจากการเดาถูก เมื่อตัวคาดการณ์สาขาคาดเดาผิด ตัวคาดการณ์จะต้องทิ้งงานที่ทำหลังจากสมมติค่าที่คาดการณ์ไว้ และเริ่มใหม่อีกครั้งจากเส้นทางที่ใช้จริง ซึ่งเรียกว่าการล้างไปป์ไลน์
เราพบปัญหานี้จากการทำโปรไฟล์การเปรียบเทียบโดยใช้ตัวนับประสิทธิภาพ branch-misses ซึ่งจะบันทึกสแต็กเทรซที่ตัวคาดการณ์สาขาคาดเดาผิด จากนั้นเราจึงแสดงผลลัพธ์ด้วย Google pprof ดังที่แสดงด้านล่าง
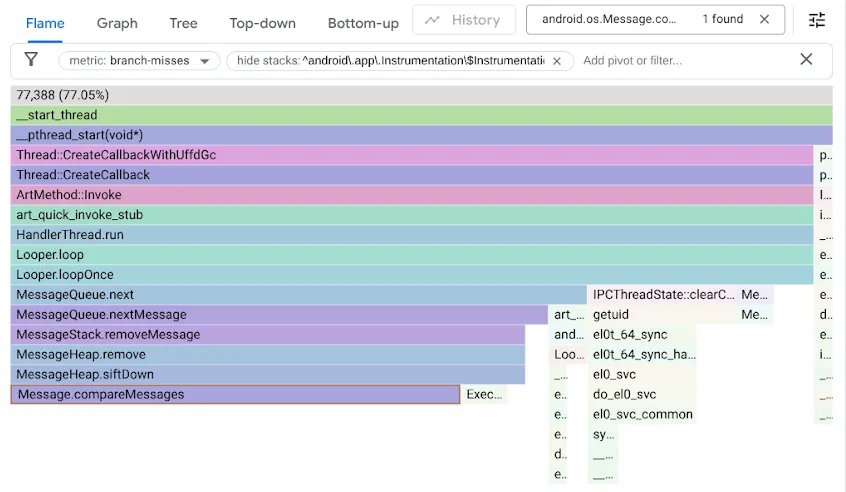
โปรดทราบว่าโค้ด MessageQueue เดิมใช้รายการที่ลิงก์แบบเดี่ยวสำหรับคิวที่เรียงลำดับ การแทรกจะข้ามรายการตามลำดับการจัดเรียงเป็นการค้นหาเชิงเส้น โดยหยุดที่องค์ประกอบแรกที่ผ่านจุดแทรกและลิงก์ Message ใหม่ไว้ข้างหน้า หากต้องการถอดออกจากหัว เพียงยกเลิกการลิงก์หัว ในขณะที่ DeliQueue ใช้ Min-Heap ซึ่งการเปลี่ยนแปลงต้องมีการจัดเรียงองค์ประกอบบางอย่างใหม่ (การเลื่อนขึ้นหรือลง) ด้วยความซับซ้อนแบบลอการิทึมในโครงสร้างข้อมูลที่สมดุล ซึ่งการเปรียบเทียบใดๆ มีโอกาสเท่ากันในการกำหนดทิศทางการข้ามไปยังโหนดลูกด้านซ้ายหรือโหนดลูกด้านขวา อัลกอริทึมใหม่จะทำงานได้เร็วขึ้นแบบอะซิมโทติก แต่จะแสดงจุดคอขวดใหม่เนื่องจากโค้ดการค้นหาหยุดทำงานเมื่อเกิด Branch Miss ครึ่งหนึ่งของเวลาทั้งหมด
เมื่อตระหนักว่าการพลาดสาขาทำให้โค้ดฮีปช้าลง เราจึงเพิ่มประสิทธิภาพโค้ดโดยใช้การเขียนโปรแกรมแบบไม่มีสาขา
// Branchless Logic
static int compareMessages(@NonNull Message m1, @NonNull Message m2) {
    final long when1 = m1.when;
    final long when2 = m2.when;
    final long insertSeq1 = m1.insertSeq;
    final long insertSeq2 = m2.insertSeq;

    // signum returns the sign (-1, 0, 1) of the argument,
    // and is implemented as pure arithmetic:
    // ((num >> 63) | (-num >>> 63))
    final int whenSign = Long.signum(when1 - when2);
    final int insertSeqSign = Long.signum(insertSeq1 - insertSeq2);

    // whenSign takes precedence over insertSeqSign,
    // so the formula below is such that insertSeqSign only matters
    // as a tie-breaker if whenSign is 0.
    return whenSign * 2 + insertSeqSign;
}
หากต้องการทำความเข้าใจการเพิ่มประสิทธิภาพ ให้ถอดแยกตัวอย่างทั้ง 2 รายการใน Compiler Explorer และใช้ LLVM-MCA ซึ่งเป็นเครื่องจำลอง CPU ที่สามารถสร้างไทม์ไลน์โดยประมาณของรอบ CPU
The original code:
Index     01234567890123
[0,0]     DeER .    .  .   sub  x0, x2, x3
[0,1]     D=eER.    .  .   cmp  x0, #0
[0,2]     D==eER    .  .   cset w0, ne
[0,3]     .D==eER   .  .   cneg w0, w0, lt
[0,4]     .D===eER  .  .   cmp  w0, #0
[0,5]     .D====eER .  .   b.le #12
[0,6]     . DeE---R .  .   mov  w1, #1
[0,7]     . DeE---R .  .   b    #48
[0,8]     . D==eE-R .  .   tbz  w0, #31, #12
[0,9]     .  DeE--R .  .   mov  w1, #-1
[0,10]    .  DeE--R .  .   b    #36
[0,11]    .  D=eE-R .  .   sub  x0, x4, x5
[0,12]    .   D=eER .  .   cmp  x0, #0
[0,13]    .   D==eER.  .   cset w0, ne
[0,14]    .   D===eER  .   cneg w0, w0, lt
[0,15]    .    D===eER .   cmp  w0, #0
[0,16]    .    D====eER.   csetm        w1, lt
[0,17]    .    D===eE-R.   cmp  w0, #0
[0,18]    .    .D===eER.   csinc        w1, w1, wzr, le
[0,19]    .    .D====eER   mov  x0, x1
[0,20]    .    .DeE----R   ret
โปรดสังเกตสาขาแบบมีเงื่อนไข 1 สาขา b.le ซึ่งหลีกเลี่ยงการเปรียบเทียบช่อง insertSeq หากทราบผลลัพธ์จากการเปรียบเทียบช่อง when แล้ว
The branchless code:
Index     012345678
[0,0]     DeER .  .   sub       x0, x2, x3
[0,1]     DeER .  .   sub       x1, x4, x5
[0,2]     D=eER.  .   cmp       x0, #0
[0,3]     .D=eER  .   cset      w0, ne
[0,4]     .D==eER .   cneg      w0, w0, lt
[0,5]     .DeE--R .   cmp       x1, #0
[0,6]     . DeE-R .   cset      w1, ne
[0,7]     . D=eER .   cneg      w1, w1, lt
[0,8]     . D==eeER   add       w0, w1, w0, lsl #1
[0,9]     .  DeE--R   ret
ในกรณีนี้ การใช้งานแบบไม่มี Branch จะใช้รอบและคำสั่งน้อยกว่าเส้นทางที่สั้นที่สุดผ่านโค้ดแบบมี Branch ซึ่งดีกว่าในทุกกรณี การติดตั้งใช้งานที่รวดเร็วขึ้นและการกำจัด Branch ที่คาดการณ์ผิดพลาดส่งผลให้การเปรียบเทียบประสิทธิภาพบางรายการของเราดีขึ้นถึง 5 เท่า
อย่างไรก็ตาม เทคนิคนี้อาจใช้ไม่ได้เสมอไป โดยทั่วไปแล้ว วิธีการแบบไม่มี Branch จะต้องทำงานที่จะถูกทิ้ง และหาก Branch คาดเดาได้เกือบตลอดเวลา งานที่เสียเปล่านั้นอาจทำให้โค้ดทำงานช้าลง นอกจากนี้ การนำสาขาออกมักจะทำให้เกิดการขึ้นต่อกันของข้อมูล CPU สมัยใหม่จะดำเนินการหลายอย่างต่อรอบ แต่จะดำเนินการตามคำสั่งไม่ได้จนกว่าอินพุตจากคำสั่งก่อนหน้าจะพร้อม ในทางตรงกันข้าม CPU สามารถคาดเดาเกี่ยวกับข้อมูลในสาขา และทำงานล่วงหน้าได้หากคาดการณ์สาขาได้อย่างถูกต้อง
การทดสอบและการตรวจสอบ
การตรวจสอบความถูกต้องของอัลกอริทึมแบบ Lock-Free เป็นเรื่องที่ยากมาก
นอกเหนือจาก Unit Test มาตรฐานสำหรับการตรวจสอบความถูกต้องอย่างต่อเนื่องในระหว่างการพัฒนาแล้ว เรายังเขียนการทดสอบความเครียดที่เข้มงวดเพื่อยืนยันค่าคงที่ของคิวและพยายามกระตุ้นให้เกิดสภาวะการแย่งชิงทรัพยากรหากมี ในห้องปฏิบัติการทดสอบ เราสามารถเรียกใช้อินสแตนซ์ทดสอบหลายล้านรายการในอุปกรณ์จำลองและในฮาร์ดแวร์จริง
ด้วยการใช้เครื่องมือ Java ThreadSanitizer (JTSan) เราสามารถใช้การทดสอบเดียวกันเพื่อตรวจหาการแย่งชิงข้อมูลในโค้ดได้ด้วย JTSan ไม่พบการแย่งใช้ทรัพยากรข้อมูลที่เป็นปัญหาใน DeliQueue แต่ที่น่าประหลาดใจคือตรวจพบบั๊กการทำงานพร้อมกัน 2 รายการในเฟรมเวิร์ก Robolectric ซึ่งเราได้แก้ไขทันที
เราได้สร้างเครื่องมือวิเคราะห์ใหม่เพื่อปรับปรุงความสามารถในการแก้ไขข้อบกพร่อง ด้านล่างนี้คือตัวอย่างที่แสดงปัญหาในโค้ดแพลตฟอร์ม Android ซึ่งเทรดหนึ่งโอเวอร์โหลดอีกเทรดหนึ่งด้วย Message ทำให้เกิดงานค้างจำนวนมาก ซึ่งมองเห็นได้ใน Perfetto ด้วยฟีเจอร์การวัด MessageQueue ที่เราเพิ่มเข้ามา
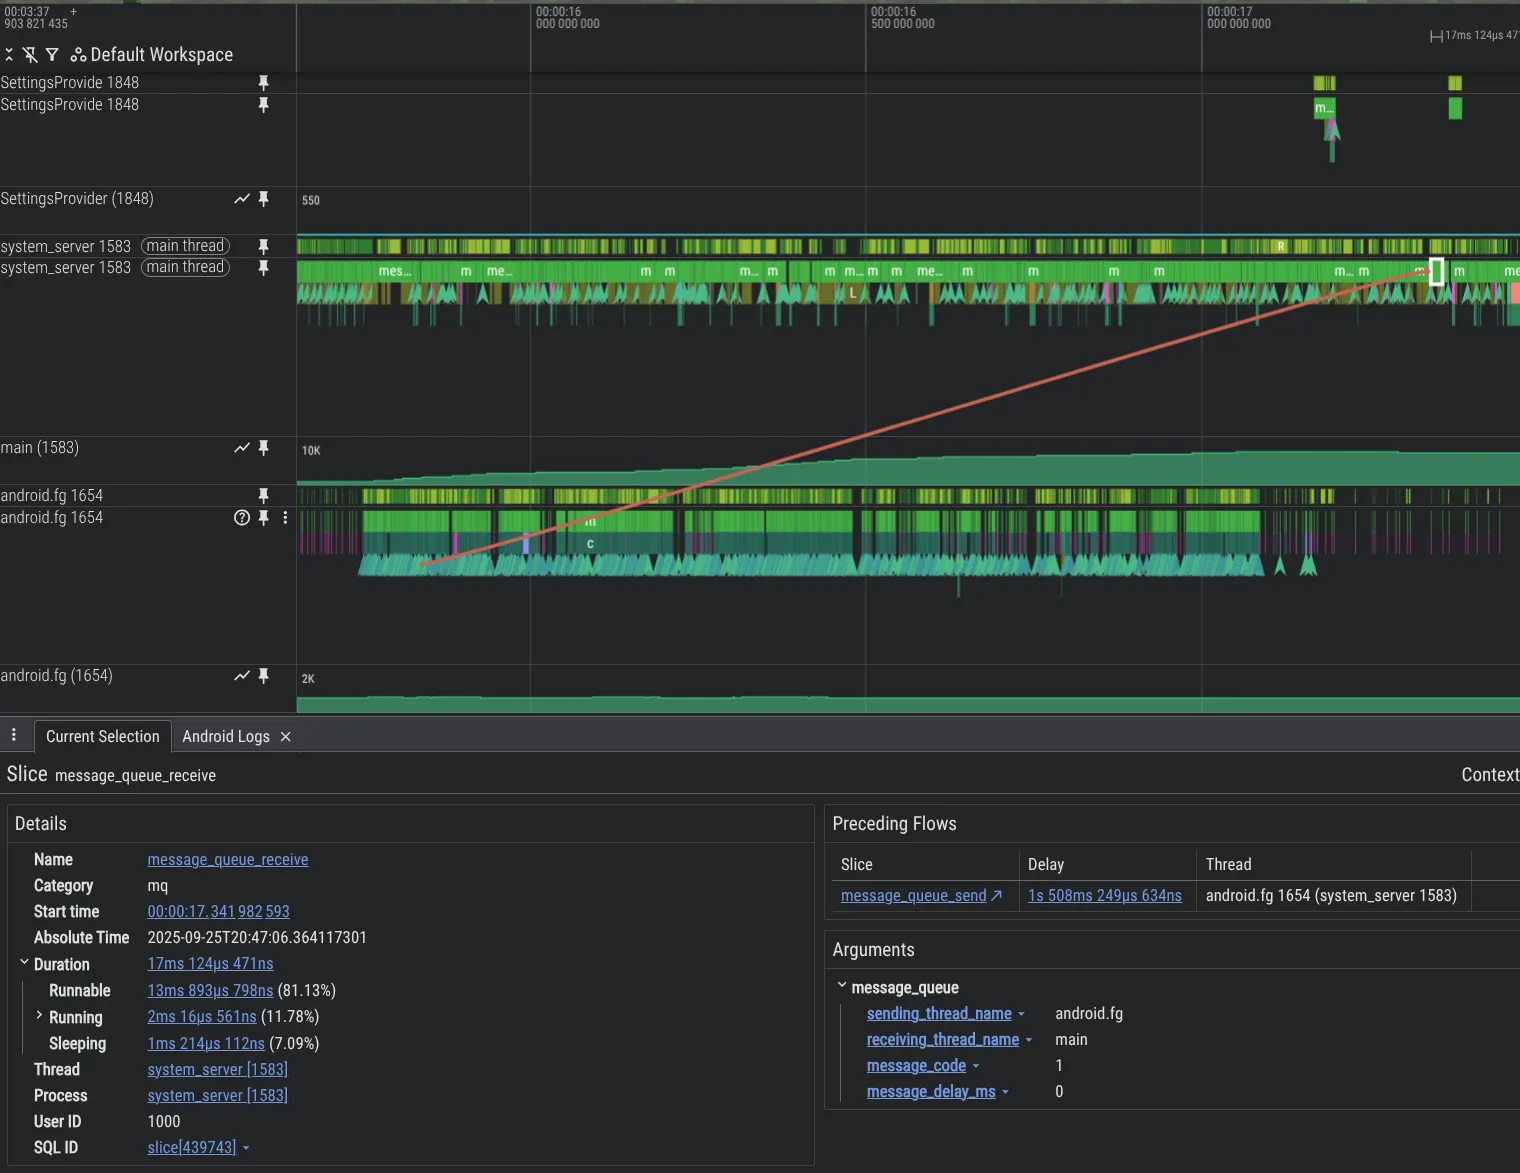
หากต้องการเปิดใช้การติดตาม MessageQueue ในกระบวนการ system_server ให้ใส่ข้อมูลต่อไปนี้ในการกำหนดค่า Perfetto
data_sources {
  config {
    name: "track_event"
    target_buffer: 0  # Change this per your buffers configuration
    track_event_config {
      enabled_categories: "mq"
    }
  }
}
ผลกระทบ
DeliQueue ช่วยปรับปรุงประสิทธิภาพของระบบและแอปโดยการนำการล็อกออกจาก MessageQueue
- การเปรียบเทียบประสิทธิภาพแบบสังเคราะห์: การแทรกแบบหลายเธรดลงในคิวที่มีการใช้งานสูงจะเร็วขึ้นสูงสุด 5,000 เท่าเมื่อเทียบกับ
MessageQueueเดิม เนื่องจากมีการปรับปรุงการทำงานพร้อมกัน (Treiber Stack) และการแทรกที่เร็วขึ้น (Min-heap) - ในการติดตาม Perfetto ที่ได้จากผู้ทดสอบเวอร์ชันเบต้าภายใน เราพบว่าเวลาที่เทรดหลักของแอปใช้ในการแย่งชิงล็อกลดลง 15%
- ในอุปกรณ์ทดสอบเดียวกัน การแย่งชิงล็อกที่ลดลงส่งผลให้ประสบการณ์ของผู้ใช้ดีขึ้นอย่างมาก เช่น
- เฟรมที่พลาดในแอปลดลง 4%
- เฟรมที่หายไปลดลง 7.7% ในการโต้ตอบกับ UI ของระบบและ Launcher
- เวลาตั้งแต่เริ่มต้นแอปจนถึงเฟรมแรกที่วาดลดลง 9.1% ที่เปอร์เซ็นไทล์ที่ 95
ขั้นตอนถัดไป
DeliQueue จะเปิดตัวในแอปใน Android 17 นักพัฒนาแอปควรอ่านบทความเรื่องการเตรียมแอปให้พร้อมสำหรับMessageQueueแบบใหม่ที่ไม่มีการล็อกในบล็อกของนักพัฒนาแอป Android เพื่อดูวิธีทดสอบแอปของตน
ข้อมูลอ้างอิง
[1] Treiber, R.K., 1986. การเขียนโปรแกรมระบบ: การรับมือกับความขนาน International Business Machines Incorporated, Thomas J. Watson Research Center
[2] Goetz, B., Peierls, T., Bloch, J., Bowbeer, J., Holmes, D., และ Lea, D. (2006). Java Concurrency in Practice Addison-Wesley Professional
-
 ข่าวสารเกี่ยวกับผลิตภัณฑ์
ดูวิธีที่เครื่องมือขยายช่องทางของ Google Play ใน Play Console ช่วยเพิ่มการเข้าถึงผู้ซื้อใน Store, เว็บ และแพลตฟอร์มภายนอก พร้อมทั้งปกป้องมาร์จิน
Phalene Gowling, Rejane França • ใช้เวลาอ่าน 4 นาที -
 ข่าวสารเกี่ยวกับผลิตภัณฑ์
Unity ขับเคลื่อนเกมบนอุปกรณ์เคลื่อนที่มากกว่าครึ่งหนึ่งทั่วโลก ดังนั้นความประทับใจแรกจึงเป็นสิ่งสำคัญ สำหรับนักพัฒนาเกม ประสบการณ์การเตรียมความพร้อมผู้ใช้งานใหม่ที่ราบรื่นและเชื่อถือได้เป็นสิ่งสำคัญในการกระตุ้นการคงผู้ใช้ไว้ตั้งแต่วันแรกและความผูกพันในระยะยาว
Michelle Martin • ใช้เวลาอ่าน 1 นาที -
 ข่าวสารเกี่ยวกับผลิตภัณฑ์
ตั้งแต่การดื่มด่ำอย่างเต็มรูปแบบที่บ้านไปจนถึงประสบการณ์ที่เข้าถึงได้ง่ายในระหว่างเดินทาง การสร้างแอปบน Android XR ช่วยให้คุณเข้าถึงผู้ใช้ได้ทุกที่ทุกเวลาในแอปพลิเคชันเชิงพื้นที่ทุกประเภท ที่งาน Android Developer Summit เราได้ประกาศความสำเร็จที่น่าตื่นเต้นด้วยการเปิดตัว XREAL AURA
Amy Zeppenfeld, Vinny DaSilva • ใช้เวลาอ่าน 3 นาที
รับข้อมูลเชิงลึกล่าสุดเกี่ยวกับการพัฒนา Android ที่ส่งไปยังกล่องจดหมายของคุณทุกสัปดาห์