Trong Android 17, các ứng dụng nhắm đến SDK 37 trở lên sẽ nhận được một cách triển khai mới của MessageQueue, trong đó cách triển khai này không có khoá. Cách triển khai mới giúp cải thiện hiệu suất và giảm số khung hình bị bỏ lỡ, nhưng có thể làm hỏng các ứng dụng khách phản ánh trên các trường và phương thức riêng tư của MessageQueue. Để tìm hiểu thêm về thay đổi về hành vi và cách giảm thiểu tác động, hãy xem tài liệu về thay đổi về hành vi của MessageQueue. Bài đăng trên blog kỹ thuật này cung cấp thông tin tổng quan về việc tái cấu trúc MessageQueue và cách bạn có thể phân tích các vấn đề về tranh chấp khoá bằng Perfetto.
Looper điều khiển luồng giao diện người dùng của mọi ứng dụng Android. Vòng lặp này lấy công việc từ MessageQueue, gửi công việc đó đến Handler rồi lặp lại. Trong hai thập kỷ, MessageQueue đã sử dụng một khoá giám sát duy nhất (tức là một khối mã synchronized) để bảo vệ trạng thái của nó.
Android 17 ra mắt một bản cập nhật quan trọng cho thành phần này: một phương thức triển khai không khoá có tên là DeliQueue.
Bài đăng này giải thích cách khoá ảnh hưởng đến hiệu suất giao diện người dùng, cách phân tích các vấn đề này bằng Perfetto, cũng như các thuật toán và hoạt động tối ưu hoá cụ thể dùng để cải thiện luồng chính của Android.
Vấn đề: Tranh chấp khoá và đảo ngược mức độ ưu tiên
MessageQueue cũ hoạt động như một hàng đợi ưu tiên được bảo vệ bằng một khoá duy nhất. Nếu một luồng nền đăng thông báo trong khi luồng chính thực hiện việc duy trì hàng đợi, thì luồng nền sẽ chặn luồng chính.
Khi hai hoặc nhiều luồng đang cạnh tranh để sử dụng độc quyền cùng một khoá, thì đây được gọi là Tranh chấp khoá. Sự tranh chấp này có thể gây ra tình trạng Đảo ngược mức độ ưu tiên, dẫn đến hiện tượng giật giao diện người dùng và các vấn đề khác về hiệu suất.
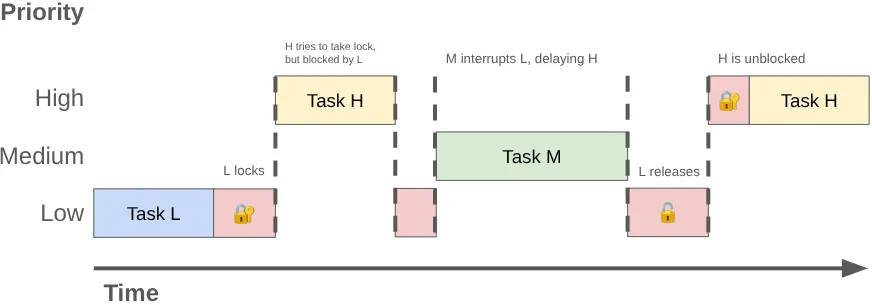
Đảo ngược mức độ ưu tiên có thể xảy ra khi một luồng có mức độ ưu tiên cao (như luồng giao diện người dùng) phải chờ một luồng có mức độ ưu tiên thấp. Hãy xem xét trình tự sau:
- Một luồng nền có mức độ ưu tiên thấp sẽ nhận được khoá
MessageQueueđể đăng kết quả của công việc mà luồng đó đã thực hiện. - Một luồng có mức độ ưu tiên trung bình có thể chạy và trình lập lịch biểu của Kernel sẽ phân bổ Thời gian của CPU cho luồng đó, ưu tiên luồng có mức độ ưu tiên thấp.
- Luồng giao diện người dùng có mức độ ưu tiên cao hoàn thành nhiệm vụ hiện tại và cố gắng đọc từ hàng đợi, nhưng bị chặn vì luồng có mức độ ưu tiên thấp giữ khoá.
Luồng có mức độ ưu tiên thấp chặn luồng giao diện người dùng và công việc có mức độ ưu tiên trung bình sẽ làm chậm luồng giao diện người dùng hơn nữa.
Phân tích tranh chấp bằng Perfetto
Bạn có thể chẩn đoán các vấn đề này bằng Perfetto. Trong một dấu vết tiêu chuẩn, một luồng bị chặn trên khoá giám sát sẽ chuyển sang trạng thái ngủ và Perfetto cho thấy một lát cắt cho biết chủ sở hữu khoá.
Khi bạn truy vấn dữ liệu theo dõi, hãy tìm các lát cắt có tên "monitor contention with …" (giám sát tranh chấp với …) theo sau là tên của luồng sở hữu khoá và trang web mã nơi khoá được lấy.
Nghiên cứu điển hình: Trình chạy bị giật
Để minh hoạ, hãy phân tích một dấu vết trong đó người dùng gặp phải hiện tượng giật khi di chuyển về màn hình chính trên điện thoại Pixel ngay sau khi chụp ảnh trong ứng dụng máy ảnh. Dưới đây là ảnh chụp màn hình của Perfetto cho thấy các sự kiện dẫn đến khung hình bị bỏ lỡ:
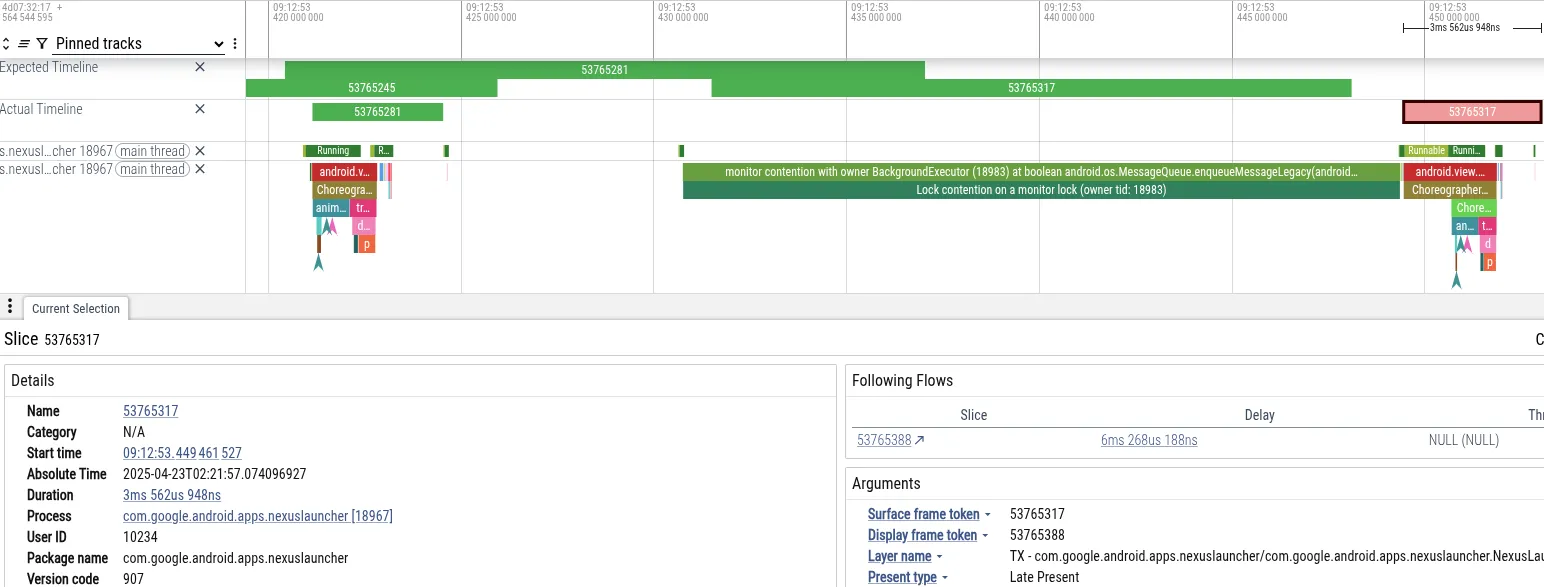
- Triệu chứng: Luồng chính của Trình chạy đã bỏ lỡ thời hạn khung hình. Luồng này bị chặn trong 18 mili giây, vượt quá thời hạn 16 mili giây cần thiết để kết xuất 60Hz.
- Chẩn đoán: Perfetto cho thấy luồng chính bị chặn trên khoá
MessageQueue. Một luồng "BackgroundExecutor" sở hữu khoá. - Nguyên nhân gốc: BackgroundExecutor chạy ở mức Process.THREAD_PRIORITY_BACKGROUND (mức độ ưu tiên rất thấp). Ứng dụng này đã thực hiện một tác vụ không khẩn cấp (kiểm tra giới hạn sử dụng ứng dụng). Đồng thời, các luồng có mức độ ưu tiên trung bình đang sử dụng thời gian của CPU để xử lý dữ liệu từ camera. Trình lập lịch biểu của hệ điều hành đã ưu tiên luồng BackgroundExecutor để chạy các luồng camera.
Trình tự này khiến luồng giao diện người dùng của Trình chạy (mức độ ưu tiên cao) bị chặn gián tiếp bởi luồng worker của camera (mức độ ưu tiên trung bình), khiến luồng nền của Trình chạy (mức độ ưu tiên thấp) không thể giải phóng khoá.
Truy vấn dấu vết bằng PerfettoSQL
Bạn có thể sử dụng PerfettoSQL để truy vấn dữ liệu theo dõi cho các mẫu cụ thể. Điều này sẽ hữu ích nếu bạn có một ngân hàng dấu vết lớn từ các thiết bị hoặc thử nghiệm của người dùng và bạn đang tìm kiếm các dấu vết cụ thể cho thấy vấn đề.
Ví dụ: truy vấn này tìm thấy tranh chấp MessageQueue trùng khớp với các khung hình bị rớt (giật):
INCLUDE PERFETTO MODULE android.monitor_contention;
INCLUDE PERFETTO MODULE android.frames.jank_type;

SELECT
  process_name,
  -- Convert duration from nanoseconds to milliseconds
  SUM(dur) / 1000000 AS sum_dur_ms,
  COUNT(*) AS count_contention
FROM android_monitor_contention
WHERE is_blocked_thread_main
AND short_blocked_method LIKE "%MessageQueue%"

-- Only look at app processes that had jank
AND upid IN (
  SELECT DISTINCT(upid)
  FROM actual_frame_timeline_slice
  WHERE android_is_app_jank_type(jank_type) = TRUE
)
GROUP BY process_name
ORDER BY SUM(dur) DESC;
Trong ví dụ phức tạp hơn này, hãy kết hợp dữ liệu theo dõi trải dài trên nhiều bảng để xác định tranh chấp MessageQueue trong quá trình khởi động ứng dụng:
INCLUDE PERFETTO MODULE android.monitor_contention;
INCLUDE PERFETTO MODULE android.startup.startups;

-- Join package and process information for startups
DROP VIEW IF EXISTS startups;
CREATE VIEW startups AS
SELECT startup_id, ts, dur, upid
FROM android_startups
JOIN android_startup_processes USING(startup_id);

-- Intersect monitor contention with startups in the same process.
DROP TABLE IF EXISTS monitor_contention_during_startup;
CREATE VIRTUAL TABLE monitor_contention_during_startup
USING SPAN_JOIN(android_monitor_contention PARTITIONED upid, startups PARTITIONED upid);

SELECT
  process_name,
  SUM(dur) / 1000000 AS sum_dur_ms,
  COUNT(*) AS count_contention
FROM monitor_contention_during_startup
WHERE is_blocked_thread_main
AND short_blocked_method LIKE "%MessageQueue%"
GROUP BY process_name
ORDER BY SUM(dur) DESC;
Bạn có thể sử dụng LLM yêu thích của mình để viết truy vấn PerfettoSQL nhằm tìm các mẫu khác.
Tại Google, chúng tôi sử dụng BigTrace để chạy các truy vấn PerfettoSQL trên hàng triệu dấu vết. Khi làm vậy, chúng tôi xác nhận rằng những gì chúng tôi thấy trên thực tế là một vấn đề mang tính hệ thống. Dữ liệu cho thấy MessageQueue tình trạng tranh chấp khoá ảnh hưởng đến người dùng trên toàn bộ hệ sinh thái, chứng minh sự cần thiết của một thay đổi cơ bản về cấu trúc.
Giải pháp: đồng thời không khoá
Chúng tôi đã giải quyết vấn đề tranh chấp MessageQueue bằng cách triển khai cấu trúc dữ liệu không khoá, sử dụng các thao tác bộ nhớ nguyên tử thay vì khoá độc quyền để đồng bộ hoá quyền truy cập vào trạng thái dùng chung. Cấu trúc dữ liệu hoặc thuật toán không có khoá nếu ít nhất một luồng luôn có thể tiến hành bất kể hành vi lập lịch biểu của các luồng khác. Thuộc tính này thường khó đạt được và thường không đáng để theo đuổi đối với hầu hết mã.
Các dữ liệu gốc nguyên tử
Phần mềm không khoá thường dựa vào các dữ liệu gốc Đọc-Sửa đổi-Ghi nguyên tử mà phần cứng cung cấp.
Trên các CPU ARM64 thế hệ cũ, các nguyên tử sử dụng vòng lặp Load-Link/Store-Conditional (LL/SC). CPU tải một giá trị và đánh dấu địa chỉ. Nếu một luồng khác ghi vào địa chỉ đó, thì thao tác lưu trữ sẽ không thành công và vòng lặp sẽ thử lại. Vì các luồng có thể tiếp tục thử và thành công mà không cần chờ một luồng khác, nên thao tác này không có khoá.
ARM64 LL/SC loop example
retry:
    ldxr    x0, [x1]        // Load exclusive from address x1 to x0
    add     x0, x0, #1      // Increment value by 1
    stxr    w2, x0, [x1]    // Store exclusive.
                            // w2 gets 0 on success, 1 on failure
cbnz w2, retry // If w2 is non-zero (failed), branch to retr(xem trong Trình khám phá trình biên dịch)
Các cấu trúc ARM mới hơn (ARMv8.1) hỗ trợ Large System Extensions (LSE) (Phần mở rộng hệ thống lớn) bao gồm các lệnh ở dạng Compare-And-Swap (CAS) (So sánh và hoán đổi) hoặc Load-And-Add (Tải và thêm) (được minh hoạ bên dưới). Trong Android 17, chúng tôi đã thêm tính năng hỗ trợ cho trình biên dịch Android Runtime (ART) để phát hiện thời điểm LSE được hỗ trợ và đưa ra các lệnh tối ưu hoá:
/ ARMv8.1 LSE atomic example
ldadd   x0, x1, [x2]    // Atomic load-add.
                        // Faster, no loop required.
Trong các điểm chuẩn của chúng tôi, mã có mức độ tranh chấp cao sử dụng CAS đạt tốc độ nhanh hơn khoảng 3 lần so với biến thể LL/SC.
Ngôn ngữ lập trình Java cung cấp các dữ liệu gốc nguyên tử thông qua java.util.concurrent.atomic dựa trên các lệnh này và các lệnh CPU chuyên biệt khác.
Cấu trúc dữ liệu: DeliQueue
Để loại bỏ tình trạng tranh chấp khoá khỏi MessageQueue, các kỹ sư của chúng tôi đã thiết kế một cấu trúc dữ liệu mới có tên là DeliQueue. DeliQueue tách biệt việc chèn Message khỏi quá trình xử lý Message:
- Danh sách
Messages(Treiber stack): Ngăn xếp không khoá. Mọi luồng đều có thể đẩyMessagesmới vào đây mà không có tranh chấp. - Hàng đợi ưu tiên (Min-heap): Một vùng nhớ khối xếp của
Messagescần xử lý, do luồng Looper sở hữu riêng (do đó không cần đồng bộ hoá hoặc khoá để truy cập).
Thêm vào hàng đợi: đẩy vào ngăn xếp Treiber
Danh sách Messages được lưu giữ trong ngăn xếp Treiber [1], một ngăn xếp không khoá sử dụng vòng lặp CAS để cập nhật con trỏ đầu.
public class TreiberStack <E> {
    AtomicReference<Node<E>> top =
            new AtomicReference<Node<E>>();
    public void push(E item) {
        Node<E> newHead = new Node<E>(item);
        Node<E> oldHead;
        do {
            oldHead = top.get();
            newHead.next = oldHead;
        } while (!top.compareAndSet(oldHead, newHead));
    }

    public E pop() {
        Node<E> oldHead;
        Node<E> newHead;
        do {
            oldHead = top.get();
            if (oldHead == null) return null;
            newHead = oldHead.next;
        } while (!top.compareAndSet(oldHead, newHead));
        return oldHead.item;
    }
}
Mã nguồn dựa trên Java Concurrency in Practice [2], có trên mạng và được phát hành công khai
Bất kỳ nhà sản xuất nào cũng có thể đẩy Message mới vào ngăn xếp bất cứ lúc nào. Điều này giống như việc lấy số thứ tự tại quầy bán đồ ăn nhanh – số của bạn được xác định theo thời điểm bạn đến, nhưng thứ tự bạn nhận được đồ ăn không nhất thiết phải khớp với số thứ tự đó. Vì đây là một ngăn xếp được liên kết, nên mỗi Message là một ngăn xếp phụ. Bạn có thể xem hàng đợi Message trông như thế nào tại bất kỳ thời điểm nào bằng cách theo dõi phần đầu và lặp lại về phía trước. Bạn sẽ không thấy bất kỳ Message mới nào được đẩy lên trên, ngay cả khi chúng được thêm vào trong quá trình truyền tải của bạn.
Dequeue: bulk transfer to a min-heap
Để tìm Message tiếp theo cần xử lý, Looper sẽ xử lý Message mới từ ngăn xếp Treiber bằng cách duyệt qua ngăn xếp bắt đầu từ trên cùng và lặp lại cho đến khi tìm thấy Message cuối cùng mà nó đã xử lý trước đó. Khi Looper di chuyển xuống ngăn xếp, nó sẽ chèn Message vào vùng nhớ khối xếp tối thiểu được sắp xếp theo thời hạn. Vì Looper sở hữu riêng vùng nhớ khối xếp, nên nó sẽ sắp xếp và xử lý Message mà không cần khoá hoặc nguyên tử.
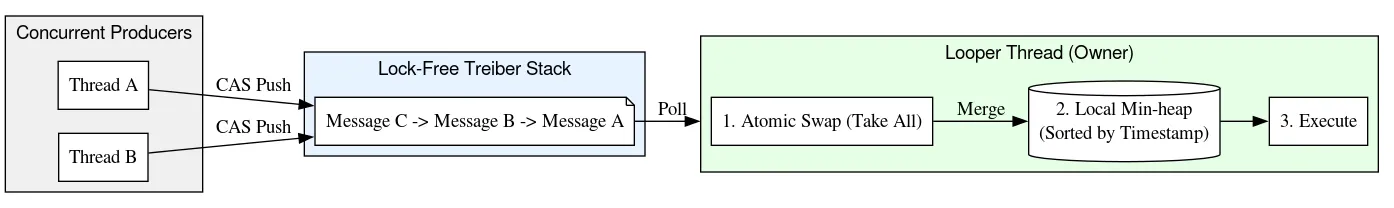
Khi đi xuống ngăn xếp, Looper cũng tạo các đường liên kết từ Messages xếp chồng trở lại các phần tử trước đó, từ đó tạo thành một danh sách liên kết đôi. Việc tạo danh sách liên kết là an toàn vì các liên kết trỏ xuống ngăn xếp được thêm thông qua thuật toán ngăn xếp Treiber bằng CAS và các liên kết lên ngăn xếp chỉ được đọc và sửa đổi bằng luồng Looper. Sau đó, các đường liên kết ngược này được dùng để xoá Message khỏi các điểm tuỳ ý trong ngăn xếp theo thời gian O(1).
Thiết kế này cung cấp tính năng chèn O(1) cho nhà sản xuất (các luồng đăng công việc vào hàng đợi) và xử lý O(log N) khấu hao cho người tiêu dùng (Looper).
Việc sử dụng min-heap để sắp xếp Message cũng giải quyết một lỗi cơ bản trong MessageQueue cũ, trong đó Message được lưu giữ trong một danh sách liên kết đơn (bắt nguồn từ trên cùng). Trong cách triển khai cũ, việc xoá khỏi phần đầu là O(1), nhưng việc chèn có trường hợp xấu nhất là O(N) – mở rộng kém cho các hàng đợi bị quá tải! Ngược lại, việc chèn vào và xoá khỏi min-heap sẽ điều chỉnh theo thang logarit, mang lại hiệu suất trung bình cạnh tranh nhưng thực sự vượt trội về độ trễ đuôi.
Cũ (đã khoá) MessageQueue | DeliQueue | |
| Chèn | O(N) | O(1) cho luồng gọi O(logN) cho chuỗi |
| Tháo khỏi đầu | O(1) | O(logN) |
Trong quá trình triển khai hàng đợi cũ, nhà sản xuất và người tiêu dùng đã sử dụng khoá để điều phối quyền truy cập độc quyền vào danh sách liên kết đơn cơ bản. Trong DeliQueue, ngăn xếp Treiber xử lý quyền truy cập đồng thời và một người tiêu dùng duy nhất xử lý việc sắp xếp hàng đợi công việc của mình.
Xoá: tính nhất quán thông qua tombstone
DeliQueue là một cấu trúc dữ liệu kết hợp, kết hợp ngăn xếp Treiber không khoá với vùng nhớ khối xếp tối thiểu đơn luồng. Việc đồng bộ hoá hai cấu trúc này mà không có khoá chung đặt ra một thách thức riêng: một thông báo có thể xuất hiện trên ngăn xếp nhưng bị xoá khỏi hàng đợi theo logic.
Để giải quyết vấn đề này, DeliQueue sử dụng một kỹ thuật gọi là "tombstoning" (đánh dấu xoá). Mỗi Message theo dõi vị trí của nó trong ngăn xếp thông qua con trỏ lùi và tiến, chỉ mục của nó trong mảng của vùng nhớ khối xếp và một cờ boolean cho biết liệu nó đã bị xoá hay chưa. Khi một Message sẵn sàng chạy, luồng Looper sẽ CAS cờ đã xoá, sau đó xoá cờ đó khỏi vùng nhớ khối xếp và ngăn xếp.
Khi một luồng khác cần xoá một Message, luồng đó sẽ không trích xuất ngay lập tức khỏi cấu trúc dữ liệu. Thay vào đó, phương thức này thực hiện các bước sau:
- Xoá logic: luồng sử dụng CAS để đặt cờ xoá của
Messagetừ false thành true một cách tự động.Messagevẫn nằm trong cấu trúc dữ liệu dưới dạng bằng chứng về việc đang chờ xoá, còn gọi là "tombstone". Sau khi mộtMessageđược gắn cờ để xoá, DeliQueue sẽ coi như nó không còn tồn tại trong hàng đợi bất cứ khi nào tìm thấy. - Dọn dẹp trì hoãn: Việc xoá thực tế khỏi cấu trúc dữ liệu là trách nhiệm của luồng
Loopervà được trì hoãn cho đến sau này. Thay vì sửa đổi ngăn xếp hoặc vùng nhớ khối xếp, luồng xoá sẽ thêmMessagevào một ngăn xếp danh sách trống không khoá khác. - Xoá cấu trúc: Chỉ
Loopermới có thể tương tác với vùng nhớ khối xếp hoặc xoá các phần tử khỏi ngăn xếp. Khi thức dậy, luồng này sẽ xoá danh sách trống và xử lý cácMessagetrong danh sách đó. Sau đó, mỗiMessagesẽ được huỷ liên kết khỏi ngăn xếp và bị xoá khỏi vùng nhớ khối xếp.
Phương pháp này giúp tất cả hoạt động quản lý vùng nhớ khối xếp đều là đơn luồng. Điều này giúp giảm thiểu số lượng thao tác đồng thời và rào cản bộ nhớ cần thiết, giúp đường dẫn quan trọng nhanh hơn và đơn giản hơn.
Duyệt qua: các cuộc đua dữ liệu mô hình bộ nhớ Java lành tính
Hầu hết các API đồng thời, chẳng hạn như Future trong thư viện chuẩn của Java hoặc Job và Deferred của Kotlin, đều có cơ chế huỷ công việc trước khi hoàn tất. Một thực thể của một trong các lớp này khớp 1:1 với một đơn vị công việc cơ bản và việc gọi cancel trên một đối tượng sẽ huỷ các thao tác cụ thể liên quan đến các lớp đó.
Các thiết bị Android ngày nay có CPU đa nhân và tính năng thu gom rác đồng thời theo thế hệ. Tuy nhiên, khi Android mới được phát triển, việc phân bổ một đối tượng cho mỗi đơn vị công việc là quá tốn kém. Do đó, Handler của Android hỗ trợ huỷ thông qua nhiều phương thức nạp chồng của removeMessages – thay vì xoá một Message cụ thể, phương thức này sẽ xoá tất cả Message khớp với tiêu chí đã chỉ định. Trên thực tế, việc này đòi hỏi phải lặp lại tất cả Message được chèn trước khi removeMessages được gọi và xoá những mục khớp.
Khi lặp lại, một luồng chỉ cần một thao tác nguyên tử có thứ tự để đọc phần đầu hiện tại của ngăn xếp. Sau đó, các lượt đọc trường thông thường sẽ được dùng để tìm Message tiếp theo. Nếu luồng Looper sửa đổi các trường next trong khi xoá Message, thì thao tác ghi của Looper và thao tác đọc của một luồng khác sẽ không được đồng bộ hoá – đây là tình trạng tương tranh dữ liệu. Thông thường, tranh chấp dữ liệu là một lỗi nghiêm trọng có thể gây ra các vấn đề lớn trong ứng dụng của bạn, chẳng hạn như rò rỉ, vòng lặp vô hạn, sự cố, treo máy, v.v. Tuy nhiên, trong một số điều kiện hẹp, các cuộc đua dữ liệu có thể không gây hại trong Mô hình bộ nhớ Java. Giả sử chúng ta bắt đầu với một ngăn xếp gồm:

Chúng tôi thực hiện thao tác đọc nguyên tử của phần đầu và thấy A. Con trỏ tiếp theo của A trỏ đến B. Đồng thời khi chúng ta xử lý B, trình lặp có thể xoá B và C bằng cách cập nhật A để trỏ đến C rồi đến D.
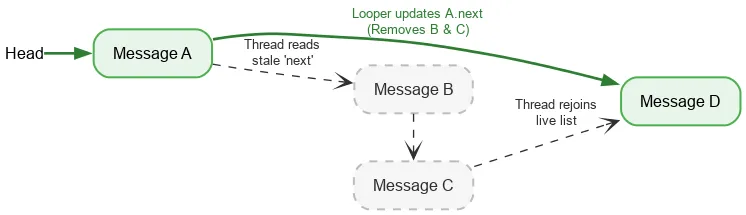
Mặc dù B và C đã bị xoá về mặt logic, nhưng B vẫn giữ lại con trỏ tiếp theo đến C và C đến D. Luồng đọc tiếp tục duyệt qua các nút đã bị xoá và cuối cùng kết hợp lại với ngăn xếp đang hoạt động tại D.
Bằng cách thiết kế DeliQueue để xử lý các xung đột giữa việc duyệt qua và xoá, chúng tôi cho phép lặp lại an toàn, không khoá.
Quitting: Native refcount
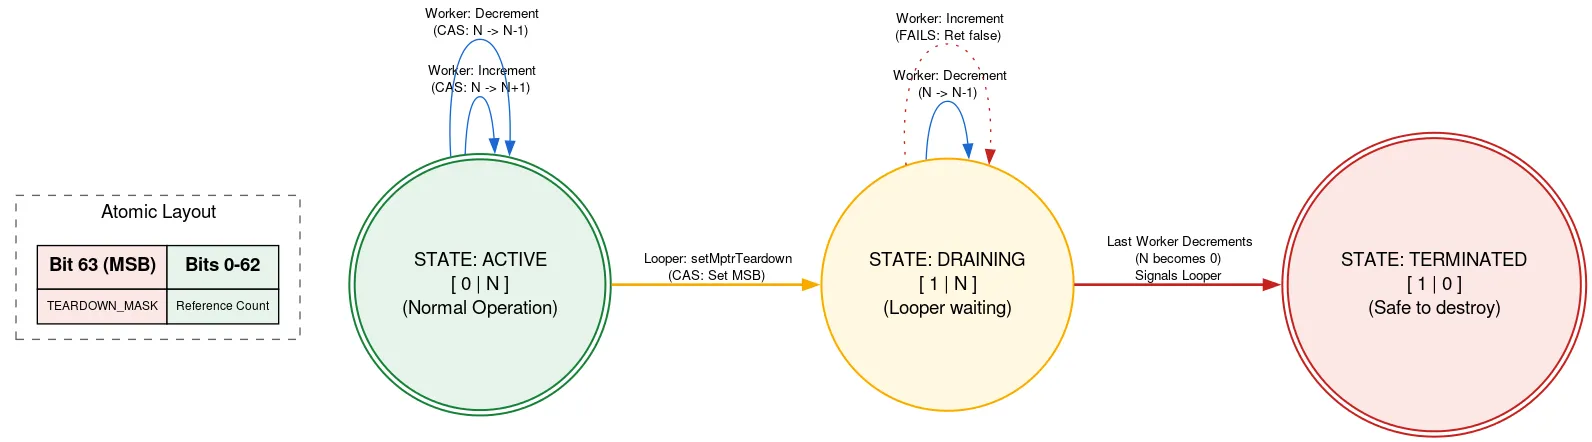
Looper được hỗ trợ bởi một quá trình phân bổ gốc mà bạn phải giải phóng theo cách thủ công sau khi Looper thoát. Nếu một số luồng khác đang thêm Message trong khi Looper đang thoát, thì luồng đó có thể sử dụng quá trình phân bổ gốc sau khi được giải phóng, đây là một lỗi vi phạm về an toàn bộ nhớ. Chúng tôi ngăn chặn điều này bằng cách sử dụng số lượng tham chiếu được gắn thẻ, trong đó một bit của nguyên tử được dùng để cho biết liệu Looper có đang thoát hay không.
Trước khi sử dụng quá trình phân bổ gốc, một luồng sẽ đọc nguyên tử refcount. Nếu bit thoát được đặt, thì bit này sẽ trả về rằng Looper đang thoát và không được sử dụng quá trình phân bổ gốc. Nếu không, nó sẽ cố gắng thực hiện CAS để tăng số lượng luồng đang hoạt động bằng cách sử dụng phân bổ gốc. Sau khi thực hiện những việc cần làm, nó sẽ giảm số lượng. Nếu bit thoát được đặt sau khi tăng nhưng trước khi giảm và số lượng hiện bằng 0, thì bit này sẽ đánh thức luồng Looper.
Khi luồng Looper sẵn sàng thoát, luồng này sẽ sử dụng CAS để đặt bit thoát trong nguyên tử. Nếu refcount là 0, thì lớp này có thể tiếp tục giải phóng quá trình phân bổ gốc. Nếu không, nó sẽ tự dừng lại, biết rằng nó sẽ được đánh thức khi người dùng cuối cùng của quá trình phân bổ gốc giảm số lượng tham chiếu. Cách tiếp cận này có nghĩa là luồng Looper sẽ chờ tiến trình của các luồng khác, nhưng chỉ khi luồng này thoát. Điều này chỉ xảy ra một lần và không ảnh hưởng đến hiệu suất, đồng thời giữ cho mã khác sử dụng quá trình phân bổ gốc hoàn toàn không bị khoá.
Có rất nhiều thủ thuật và sự phức tạp khác trong quá trình triển khai. Bạn có thể tìm hiểu thêm về DeliQueue bằng cách xem mã nguồn.
Tối ưu hoá: lập trình không phân nhánh
Trong quá trình phát triển và thử nghiệm DeliQueue, nhóm đã chạy nhiều phép đo điểm chuẩn và lập hồ sơ mã mới một cách cẩn thận. Một vấn đề được xác định bằng cách sử dụng công cụ simpleperf là việc xoá quy trình do mã so sánh Message gây ra.
Một bộ so sánh tiêu chuẩn sử dụng các bước nhảy có điều kiện, với điều kiện để quyết định Message nào xuất hiện trước được đơn giản hoá như sau:
static int compareMessages(@NonNull Message m1, @NonNull Message m2) {
    if (m1 == m2) {
        return 0;
    }

    // Primary queue order is by when.
    // Messages with an earlier when should come first in the queue.
    final long whenDiff = m1.when - m2.when;
    if (whenDiff > 0) return 1;
    if (whenDiff < 0) return -1;

    // Secondary queue order is by insert sequence.
    // If two messages were inserted with the same `when`, the one inserted
    // first should come first in the queue.
    final long insertSeqDiff = m1.insertSeq - m2.insertSeq;
    if (insertSeqDiff > 0) return 1;
    if (insertSeqDiff < 0) return -1;

    return 0;
}
Mã này biên dịch thành các bước nhảy có điều kiện (lệnh b.le và cbnz). Khi gặp một nhánh có điều kiện, CPU không thể biết liệu nhánh đó có được thực hiện hay không cho đến khi điều kiện được tính toán, vì vậy, CPU không biết lệnh nào cần đọc tiếp theo và phải đoán bằng một kỹ thuật gọi là dự đoán nhánh. Trong trường hợp như tìm kiếm nhị phân, hướng rẽ nhánh sẽ khác nhau theo cách không thể đoán trước ở mỗi bước, vì vậy, có khả năng một nửa số dự đoán sẽ sai. Dự đoán nhánh thường không hiệu quả trong các thuật toán tìm kiếm và sắp xếp (chẳng hạn như thuật toán được dùng trong min-heap), vì chi phí đoán sai lớn hơn mức cải thiện từ việc đoán đúng. Khi bộ dự đoán nhánh đoán sai, nó phải loại bỏ công việc đã thực hiện sau khi giả định giá trị dự đoán và bắt đầu lại từ đường dẫn thực tế đã thực hiện – đây được gọi là xả đường ống.
Để tìm ra vấn đề này, chúng tôi đã phân tích các điểm chuẩn bằng cách sử dụng bộ đếm hiệu suất branch-misses. Bộ đếm này ghi lại dấu vết ngăn xếp khi trình dự đoán nhánh đoán sai. Sau đó, chúng tôi trực quan hoá kết quả bằng Google pprof, như minh hoạ dưới đây:
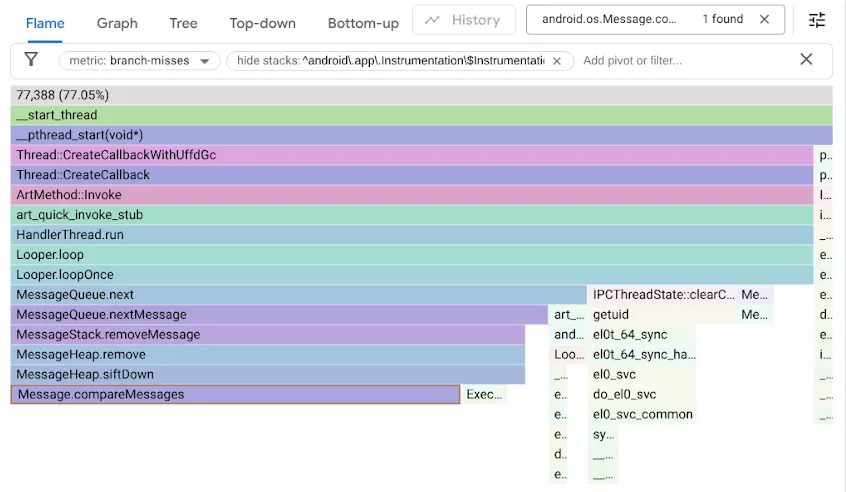
Hãy nhớ lại rằng mã MessageQueue gốc đã sử dụng danh sách liên kết đơn cho hàng đợi có thứ tự. Thao tác chèn sẽ duyệt qua danh sách theo thứ tự sắp xếp dưới dạng tìm kiếm tuyến tính, dừng lại ở phần tử đầu tiên vượt qua điểm chèn và liên kết Message mới trước phần tử đó. Để xoá khỏi phần đầu, bạn chỉ cần huỷ liên kết phần đầu. Trong khi DeliQueue sử dụng min-heap, trong đó các đột biến yêu cầu sắp xếp lại một số phần tử (sàng lọc lên hoặc xuống) với độ phức tạp logarit trong cấu trúc dữ liệu cân bằng, trong đó bất kỳ phép so sánh nào cũng có cơ hội đồng đều để hướng quá trình truyền tải đến phần tử con bên trái hoặc phần tử con bên phải. Thuật toán mới nhanh hơn về mặt tiệm cận, nhưng lại bộc lộ một điểm tắc nghẽn mới khi mã tìm kiếm bị đình trệ do lỗi nhánh trong một nửa thời gian.
Nhận thấy rằng việc thiếu nhánh đang làm chậm mã vùng nhớ khối xếp, chúng tôi đã tối ưu hoá mã bằng cách sử dụng lập trình không nhánh:
// Branchless Logic
static int compareMessages(@NonNull Message m1, @NonNull Message m2) {
    final long when1 = m1.when;
    final long when2 = m2.when;
    final long insertSeq1 = m1.insertSeq;
    final long insertSeq2 = m2.insertSeq;

    // signum returns the sign (-1, 0, 1) of the argument,
    // and is implemented as pure arithmetic:
    // ((num >> 63) | (-num >>> 63))
    final int whenSign = Long.signum(when1 - when2);
    final int insertSeqSign = Long.signum(insertSeq1 - insertSeq2);

    // whenSign takes precedence over insertSeqSign,
    // so the formula below is such that insertSeqSign only matters
    // as a tie-breaker if whenSign is 0.
    return whenSign * 2 + insertSeqSign;
}
Để hiểu rõ cách tối ưu hoá, hãy phân tách hai ví dụ trong Trình khám phá trình biên dịch và sử dụng LLVM-MCA, một trình mô phỏng CPU có thể tạo dòng thời gian ước tính của chu kỳ CPU.
The original code:
Index     01234567890123
[0,0]     DeER .    .  .   sub  x0, x2, x3
[0,1]     D=eER.    .  .   cmp  x0, #0
[0,2]     D==eER    .  .   cset w0, ne
[0,3]     .D==eER   .  .   cneg w0, w0, lt
[0,4]     .D===eER  .  .   cmp  w0, #0
[0,5]     .D====eER .  .   b.le #12
[0,6]     . DeE---R .  .   mov  w1, #1
[0,7]     . DeE---R .  .   b    #48
[0,8]     . D==eE-R .  .   tbz  w0, #31, #12
[0,9]     .  DeE--R .  .   mov  w1, #-1
[0,10]    .  DeE--R .  .   b    #36
[0,11]    .  D=eE-R .  .   sub  x0, x4, x5
[0,12]    .   D=eER .  .   cmp  x0, #0
[0,13]    .   D==eER.  .   cset w0, ne
[0,14]    .   D===eER  .   cneg w0, w0, lt
[0,15]    .    D===eER .   cmp  w0, #0
[0,16]    .    D====eER.   csetm        w1, lt
[0,17]    .    D===eE-R.   cmp  w0, #0
[0,18]    .    .D===eER.   csinc        w1, w1, wzr, le
[0,19]    .    .D====eER   mov  x0, x1
[0,20]    .    .DeE----R   ret
Lưu ý một nhánh có điều kiện, b.le, giúp tránh so sánh các trường insertSeq nếu kết quả đã được biết từ việc so sánh các trường when.
The branchless code:
Index     012345678
[0,0]     DeER .  .   sub       x0, x2, x3
[0,1]     DeER .  .   sub       x1, x4, x5
[0,2]     D=eER.  .   cmp       x0, #0
[0,3]     .D=eER  .   cset      w0, ne
[0,4]     .D==eER .   cneg      w0, w0, lt
[0,5]     .DeE--R .   cmp       x1, #0
[0,6]     . DeE-R .   cset      w1, ne
[0,7]     . D=eER .   cneg      w1, w1, lt
[0,8]     . D==eeER   add       w0, w1, w0, lsl #1
[0,9]     .  DeE--R   ret
Ở đây, phương thức triển khai không phân nhánh mất ít chu kỳ và lệnh hơn so với đường dẫn ngắn nhất thông qua mã phân nhánh – phương thức này tốt hơn trong mọi trường hợp. Việc triển khai nhanh hơn cộng với việc loại bỏ các nhánh dự đoán sai đã giúp cải thiện gấp 5 lần một số điểm chuẩn của chúng tôi!
Tuy nhiên, không phải lúc nào bạn cũng có thể áp dụng kỹ thuật này. Các phương pháp không phân nhánh thường yêu cầu thực hiện công việc sẽ bị loại bỏ và nếu nhánh có thể dự đoán được hầu hết thời gian, thì công việc lãng phí đó có thể làm chậm mã của bạn. Ngoài ra, việc xoá một nhánh thường gây ra phụ thuộc dữ liệu. CPU hiện đại thực thi nhiều thao tác mỗi chu kỳ, nhưng không thể thực thi một lệnh cho đến khi dữ liệu đầu vào của lệnh đó từ một lệnh trước đó đã sẵn sàng. Ngược lại, CPU có thể suy đoán về dữ liệu trong các nhánh và tiếp tục hoạt động nếu một nhánh được dự đoán chính xác.
Kiểm thử và xác thực
Việc xác thực tính chính xác của các thuật toán không khoá là một việc cực kỳ khó khăn!
Ngoài các bài kiểm thử đơn vị tiêu chuẩn để xác thực liên tục trong quá trình phát triển, chúng tôi cũng viết các bài kiểm thử nghiêm ngặt để xác minh các bất biến của hàng đợi và cố gắng gây ra xung đột dữ liệu nếu có. Trong phòng thí nghiệm kiểm thử, chúng tôi có thể chạy hàng triệu phiên bản kiểm thử trên các thiết bị mô phỏng và trên phần cứng thực.
Với khả năng đo lường của Java ThreadSanitizer (JTSan), chúng ta có thể sử dụng cùng một quy trình kiểm thử để phát hiện một số xung đột dữ liệu trong mã. JTSan không tìm thấy bất kỳ cuộc đua dữ liệu có vấn đề nào trong DeliQueue, nhưng thật bất ngờ, công cụ này thực sự phát hiện ra hai lỗi đồng thời trong khung Robolectric mà chúng tôi đã nhanh chóng khắc phục.
Để cải thiện khả năng gỡ lỗi, chúng tôi đã xây dựng các công cụ phân tích mới. Dưới đây là ví dụ cho thấy một vấn đề trong mã nền tảng Android, trong đó một luồng đang làm quá tải một luồng khác bằng Message, gây ra tình trạng tồn đọng lớn, có thể thấy trong Perfetto nhờ tính năng đo lường MessageQueue mà chúng tôi đã thêm vào.
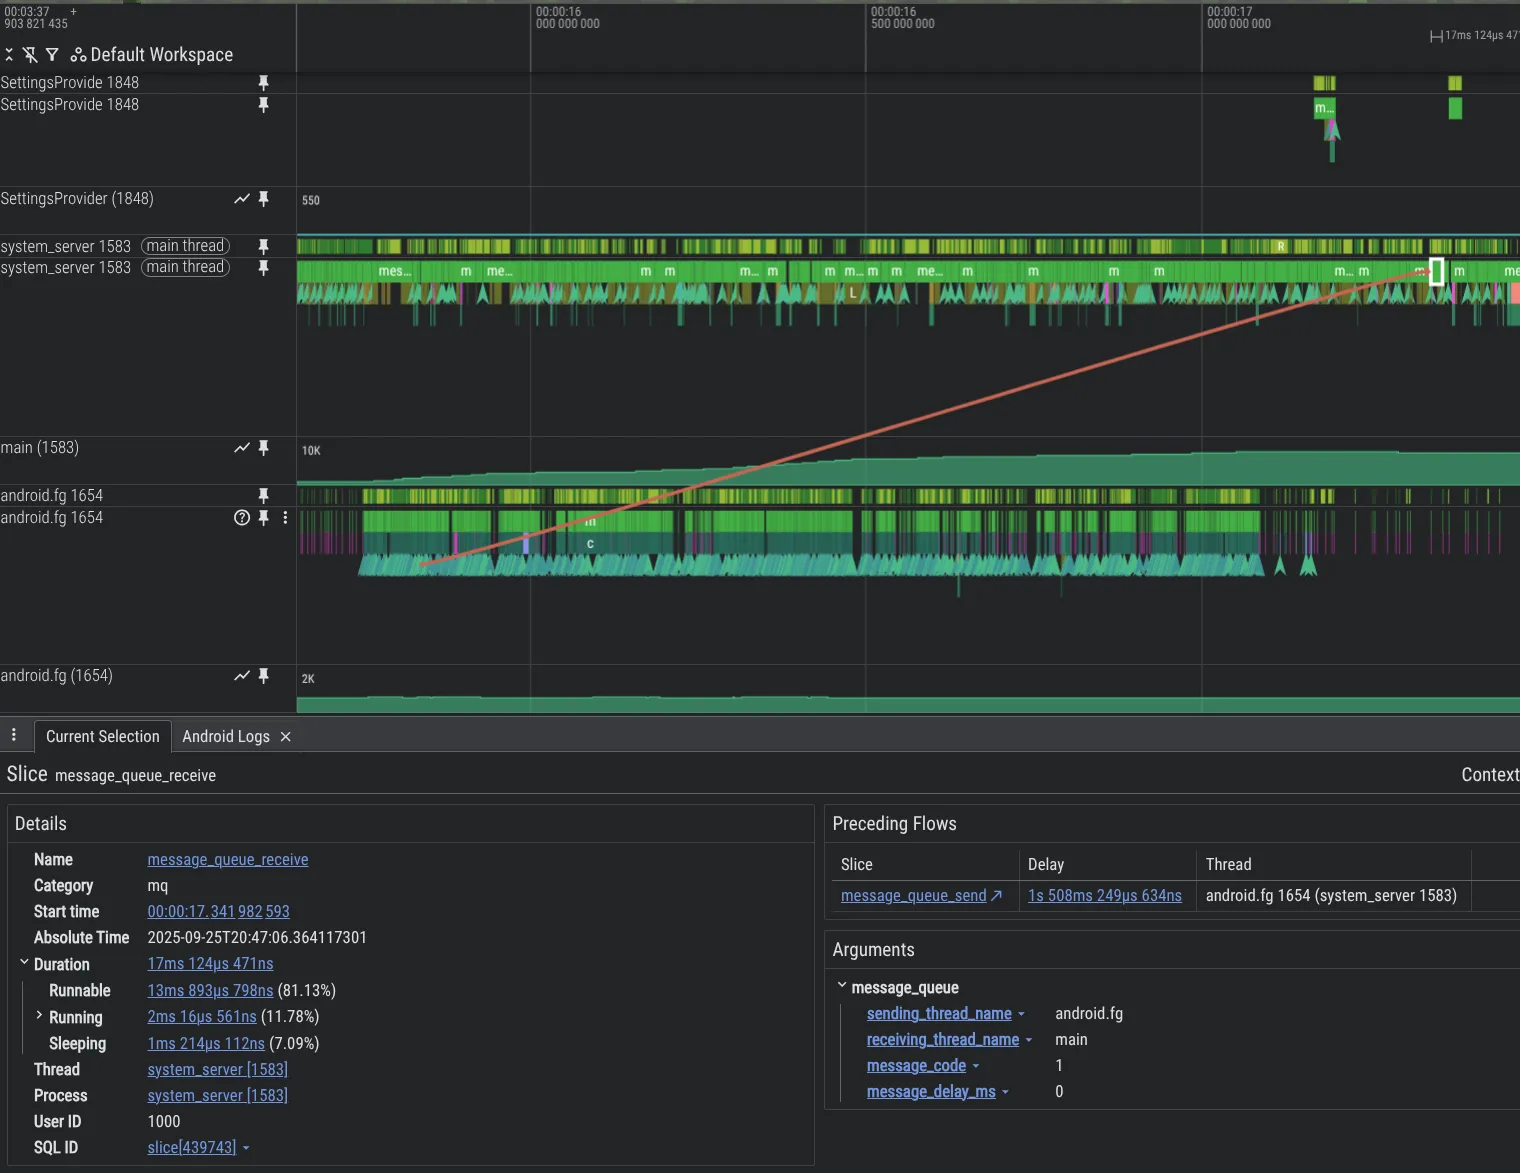
Để bật tính năng theo dõi MessageQueue trong quy trình system_server, hãy thêm nội dung sau vào cấu hình Perfetto:
data_sources {
  config {
    name: "track_event"
    target_buffer: 0  # Change this per your buffers configuration
    track_event_config {
      enabled_categories: "mq"
    }
  }
}
Mức độ tác động
DeliQueue cải thiện hiệu suất của hệ thống và ứng dụng bằng cách loại bỏ các khoá khỏi MessageQueue.
- Điểm chuẩn tổng hợp: việc chèn nhiều luồng vào hàng đợi bận rộn nhanh hơn tới 5.000 lần so với
MessageQueuecũ, nhờ khả năng đồng thời được cải thiện (ngăn xếp Treiber) và chèn nhanh hơn (min-heap). - Trong dấu vết Perfetto thu được từ người kiểm thử phiên bản thử nghiệm nội bộ, chúng tôi nhận thấy thời gian luồng chính của ứng dụng dành cho việc tranh chấp khoá giảm 15%.
- Trên cùng một thiết bị thử nghiệm, việc giảm tranh chấp khoá giúp cải thiện đáng kể trải nghiệm người dùng, chẳng hạn như:
- -Giảm 4% số khung hình bị bỏ lỡ trong ứng dụng.
- -7,7% khung hình bị bỏ lỡ trong các hoạt động tương tác với Giao diện người dùng hệ thống và Trình chạy.
- Giảm 9,1% thời gian từ khi khởi động ứng dụng đến khi khung hình đầu tiên được vẽ, ở phân vị thứ 95.
Các bước tiếp theo
DeliQueue sẽ được triển khai cho các ứng dụng trong Android 17. Nhà phát triển ứng dụng nên xem bài viết chuẩn bị ứng dụng cho tính năng khoá mới MessageQueue trên Blog dành cho nhà phát triển Android để tìm hiểu cách thử nghiệm ứng dụng.
Tài liệu tham khảo
[1] Treiber, R.K., 1986. Lập trình hệ thống: Xử lý tính song song. International Business Machines Incorporated, Thomas J. Trung tâm nghiên cứu Watson.
[2] Goetz, B., Peierls, T., Bloch, J., Bowbeer, J., Holmes, D., & Lea, D. (2006). Java Concurrency in Practice (Tính đồng thời trong Java trong thực tế). Addison-Wesley Professional.
-
 Tin tức về sản phẩm
Trong kỷ nguyên trí tuệ nhân tạo, người dùng không còn chỉ thao tác trên các ứng dụng mà còn thể hiện những mục tiêu cấp cao và mong đợi các tác nhân AI như Gemini hoàn thành các quy trình làm việc nhiều bước, đôi khi trên nhiều ứng dụng trên thiết bị của họ.
Jingyu Shi • Thời gian đọc: 4 phút -
 Tin tức về sản phẩm
Hôm nay, tại Hội nghị Nhà phát triển Android, chúng tôi xin thông báo về việc cung cấp rộng rãi nhiều công cụ và API được thiết kế để loại bỏ những trở ngại hằng ngày và giúp bạn linh hoạt hơn trong việc xây dựng các ứng dụng Android tuyệt vời.
Matthew McCullough • Thời gian đọc: 4 phút -
 Tin tức về sản phẩm
Android Studio Rabbit 2 hiện đã ổn định và sẵn sàng để bạn sử dụng trong môi trường thực tế. Bản phát hành này bao gồm các tính năng chính giúp cải thiện quá trình phát triển của bạn, chẳng hạn như Bring Your Own Agent (Sử dụng tác nhân của riêng bạn), các tính năng mới của Trình mô phỏng XR, bản cập nhật LeakCanary, công cụ quản lý kỹ năng mới của tác nhân, tính năng xem xét mã bằng AI và nhiều tính năng khác.
Matthew Warner • Đọc trong 3 phút
Nhận thông tin chi tiết mới nhất về hoạt động phát triển Android trong hộp thư đến của bạn hằng tuần.