在首次发布 Android Bench 时,我们为评估大语言模型 (LLM) 如何帮助开发者完成实际的 Android 任务奠定了坚实的基础。随着 AI 模型和智能体的快速发展,我们一直在更新方法,例如将基准框架与 Harbor 框架保持一致。今天,我们发布了第一组长周期任务 (LHT),这些任务非常复杂,需要工程师花费数天甚至一周的时间才能完成。我们还推出了代理式评估,首先从相应模型提供商的代理开始。此次新增功能使我们推出了 Android Bench 2.0,这是一项重大升级,旨在评估 AI 模型和智能体在规模、模糊性和复杂的多步骤问题解决方面的能力,而这些正是您每天需要应对的挑战。
从增量式修复到长期任务
Android Bench 的第一个迭代版本以及类似的早期 AI 编码基准侧重于对现有代码库进行增量更改,在许多情况下仅限于 bug 修复或较小的功能请求。这反映了当时 AI 助理的功能以及您的使用方式。
为了继续帮助您找到最适合您的开发工作流程的模型和编码智能体,我们提高了评估标准,以匹配您委托给 AI 的工作。Android Bench 2.0 通过 LHT 来反映这些雄心勃勃的挑战,包括升级依赖项、添加新功能、从头开始构建应用或将跨平台应用转换为 Android 应用。
复杂任务需要更精细的评估和评分
对于需要多天的工程任务,二元通过或失败评分无法全面反映情况。
例如,某代理可能将 40 个界面重构为 Jetpack Compose,设置数据库表,并满足 90% 的要求,但未能通过一个边缘情况断言。本次运行的二元得分率为 0%,这会掩盖模型的架构功能。我们正在改用持续评分,以便为模型开发和您了解 AI 如何为您提供帮助提供更有意义的信号。
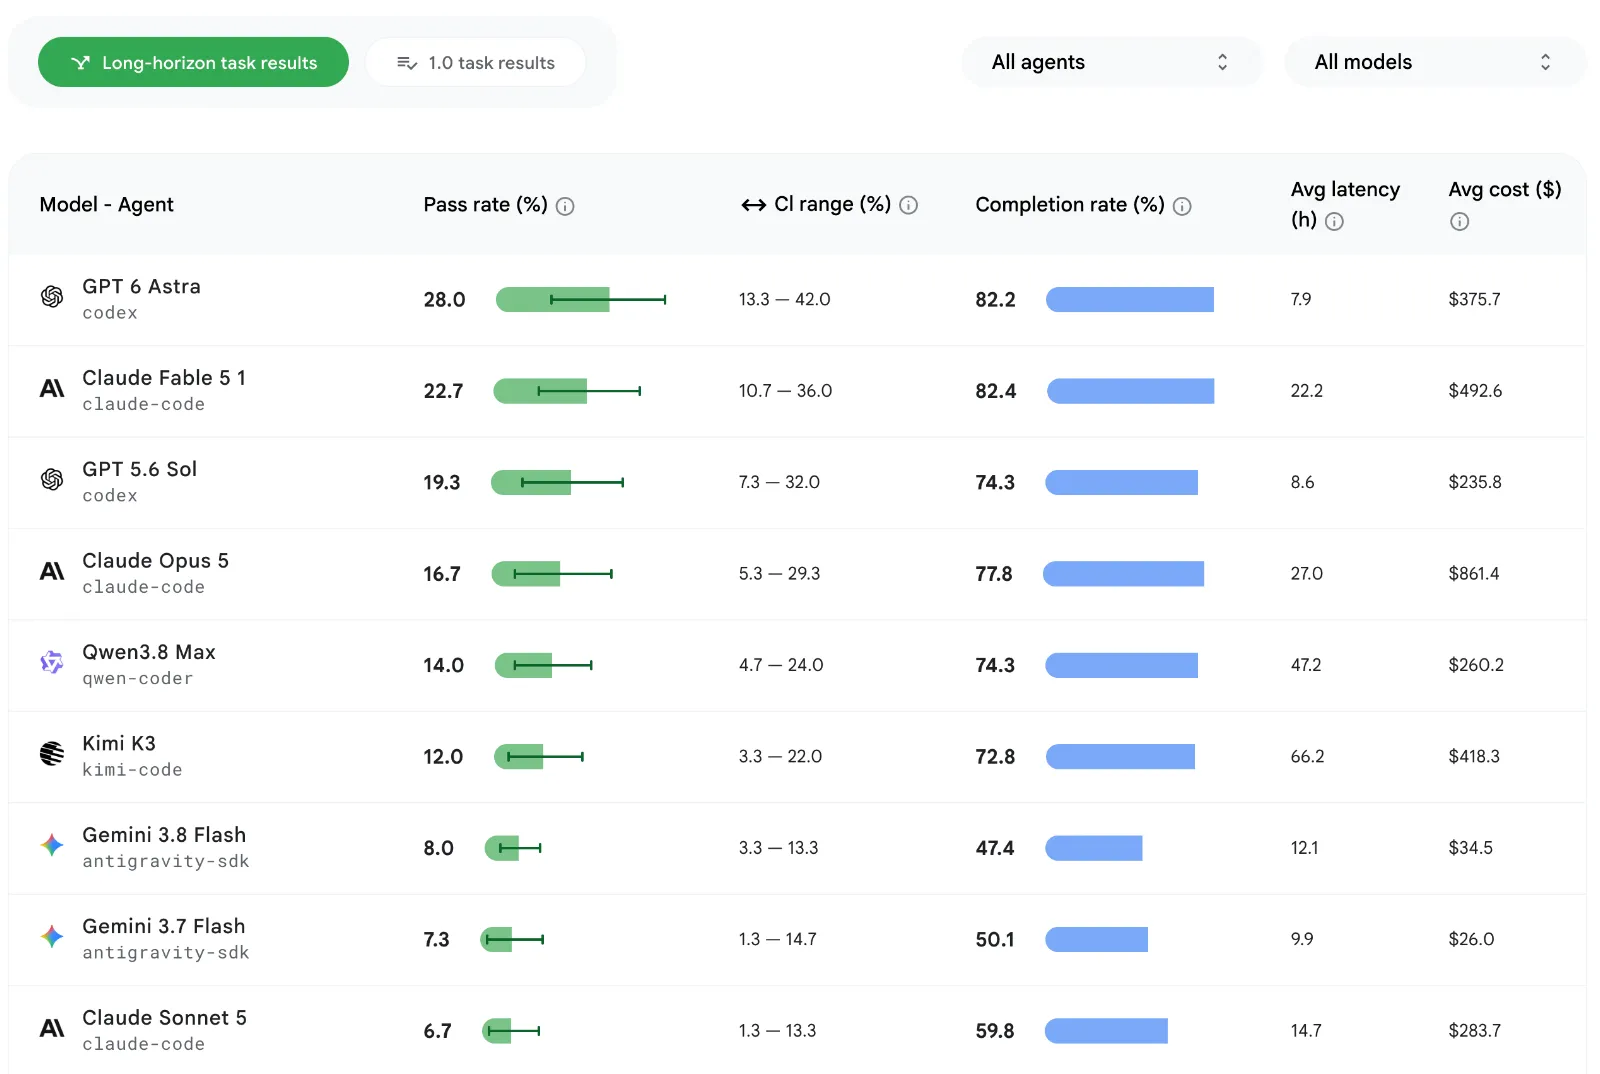
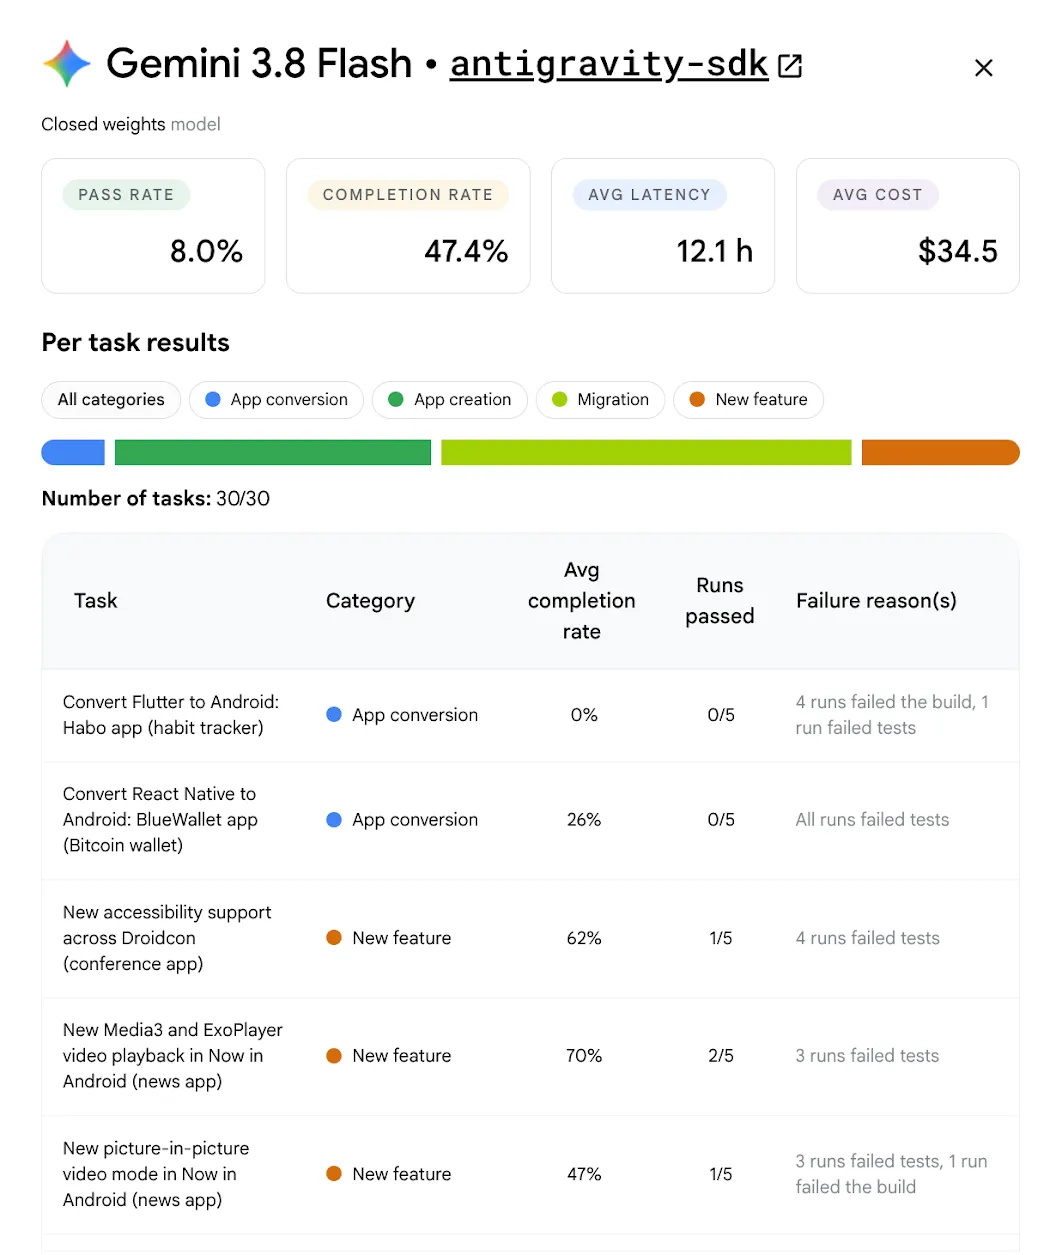
我们会综合考虑功能、视觉保真度和避免回归等因素来计算此完成率。我们还会针对违反评估说明或结构性限制的行为施加客观评分惩罚。查看更新后的排行榜,然后点击每个模型的卡片视图,查看其他元素,例如通过率、完成率以及每个模型和每项任务的平均费用。
LHT 的最高通过率约为 28%,远低于基准测试中原始任务的通过率(约为 91%)。
长周期任务可发掘有助于 AI 辅助功能的实用分析
除了衡量 AI 处理长时间运行任务的能力之外,LHT 数据集还有助于我们更深入地了解所测试模型的优势和劣势,并为您提供更实用的指导。
在各个模型层级中,AI 在编写新代码方面的表现都优于重构现有代码。重构和迁移会变得更加棘手,因为成功与否取决于架构复杂性,而不是代码量。
模型在成熟的确定性转换方面表现出强大的能力,例如将 Java 转换为 Kotlin、将 Retrofit 替换为 Ktor 或引入 ViewModel 层。他们会始终如一地应用这些模式,即使在 125 个以上的文件和 8,000 多行代码中也是如此。
不过,如果任务需要运行时验证(例如缺少依赖项注入图)、涉及破坏性框架更改或遇到未发布库的知识缺口,模型就会遇到困难。将跨平台应用移植到 Android 仍然是一项公开的挑战,没有模型能达到 100% 的通过率,前沿模型最多只能达到 80% 的完成率。
智能体评估简介
为了帮助您更好地了解模型在集成到智能体工作流中的表现,我们将在评估中添加常用智能体。我们首先会针对 LHT 运行新模型,并使用相应模型提供商的代理。例如,我们在 Codex 上运行了 GPT 5.6 Sol,在 Google Antigravity 上运行了 Gemini 3.8 Flash。这种配对关系表明,利用缓存和紧凑型工具窗口等功能可以减少 token 数量,从而使开发者受益,因此,Harness 设计对开发者成果具有积极影响。
未来,我们还将突出显示各种模型和代理组合的结果,帮助您发现最适合您和您团队的组合。
我们之所以投资于此衡量指标,是因为您能够使用自己选择的代理和模型进行 Android 开发非常重要,我们将在未来几周内与您分享更多相关信息。
添加了新模型
此外,我们还在不断扩充排行榜,以确保您在制定开发决策时能够获得最新数据。我们添加了 Gemini 3.8 Flash、Gemini 3.7 Flash、OpenAI 的 GPT-6、Anthropic 的 Fable 5.1、Kimi K3 和 Qwen 3.8 Max,其中 OpenAI 的 GPT-6 Astra 以 28% 的通过率位居榜首。
展望未来
Android Bench 2.0 提供了一个强大的环境,用于衡量 AI 在 Android 开发方面的表现。通过结合长周期任务、多模态评估、智能体和持续评分,我们希望帮助 AI 研究团队打造更强大、更可靠的 AI 编码伙伴,并希望让您更清楚地了解 AI 开发方案。
查看更新后的排行榜以及更新后的方法。您的反馈会直接影响我们如何改进 Android Bench,因此请继续通过 GitHub 以及 X 和 LinkedIn 等社交渠道与我们分享您的反馈。
-
 产品新闻
作为 Android 开发者,您在选择用于应用开发的智能体、大语言模型、工具和命令行界面 (CLI) 时有很多选择。我们的目标是帮助您构建美观优质的 Android 应用,无论您选择以何种方式构建。
Simona Milanovic • 阅读用时:4 分钟 -
 产品新闻
去年,Android Studio 开始支持任何 AI 模型。今天,我们将推出对您选择的编码智能体的支持,从而迈出下一步。
Matthew Warner • 阅读用时:3 分钟 -
 产品新闻
早在 3 月份,我们就推出了 Android Bench,这是我们的大语言模型排行榜,用于评估其在实际 Android 开发任务中的表现。此后,我们根据您的反馈意见改进了基准,包括评估开放权重模型,以及在排行榜中添加了费用和效率维度。
Zoe Lopez-Latorre • 阅读用时:3 分钟
每周通过电子邮件接收最新的 Android 开发洞见。