Android Bench 2.0: Zorlu uzun vadeli görevlerle sınırları zorlama
Okuma süresi: 3 dakika
Android Bench'i ilk kullanıma sunduğumuzda, büyük dil modellerinin (LLM'ler) geliştiricilere gerçek dünyadaki Android görevlerinde nasıl yardımcı olduğunu değerlendirmek için titiz bir temel oluşturduk. Yapay zeka modelleri ve aracıları hızla geliştiği için metodolojimizi güncelledik. Örneğin, karşılaştırma çerçevemizi Harbor çerçevesiyle uyumlu hale getirdik. Bugün uzun vadeli görevlerin (LHT) ilk grubunu kullanıma sunuyoruz. Bu görevler, mühendislerin tamamlaması birkaç gün hatta bir hafta süren, oldukça karmaşık görevlerdir. Ayrıca, ilgili model sağlayıcıların temsilcileriyle başlayarak temsilci tabanlı değerlendirmeyi de kullanıma sunuyoruz. Bu eklemeyle Android Bench 2.0'a geçiyoruz. Bu, yapay zeka modellerini ve aracılarını her gün karşılaştığınız ölçek, belirsizlik ve karmaşık çok adımlı problem çözme konularında değerlendirmek için tasarlanmış büyük bir yükseltmedir.
Küçük düzeltmelerden uzun vadeli görevlere
Android Bench'in ilk sürümü ve benzer erken yapay zeka kodlama karşılaştırmaları, mevcut depolarda yapılan artımlı değişikliklere odaklanıyordu. Bu değişiklikler çoğu durumda hata düzeltmeleri veya daha küçük özellik istekleriyle sınırlıydı. Bu, o sırada yapay zeka yardımının özelliklerinin yanı sıra onu nasıl kullandığınızı da yansıtıyordu.
Geliştirme iş akışınıza en uygun modelleri ve kodlama aracılarını bulmanıza yardımcı olmaya devam etmek için değerlendirmelerimizin çıtasını yükselterek yapay zekaya devrettiğiniz işlerle eşleşmesini sağladık. Android Bench 2.0, bağımlılıkları yükseltme, yeni özellikler ekleme, uygulamaları sıfırdan oluşturma veya platformlar arası bir uygulamayı Android'e dönüştürme gibi LHT'lerle bu iddialı zorlukları yansıtır.
Karmaşık görevler daha ayrıntılı bir değerlendirme ve puanlama gerektirir.
Çok gün süren mühendislik görevlerinde, ikili (geçti/kaldı) notlandırma, durumu tam olarak yansıtmaz.
Örneğin, bir temsilci 40 ekranı Jetpack Compose'a yeniden düzenleyebilir, veritabanı tabloları oluşturabilir ve koşulların% 90'ını karşılayabilir ancak tek bir uç durum onaylamasında başarısız olabilir. İkili puanlama, bu çalıştırmayı %0 olarak değerlendirerek modelin mimari yeteneklerini gizler. Hem model geliştirme hem de yapay zekanın size nasıl yardımcı olabileceğini anlamanız için daha anlamlı bir sinyal sağlamak amacıyla sürekli puanlamaya geçiyoruz.
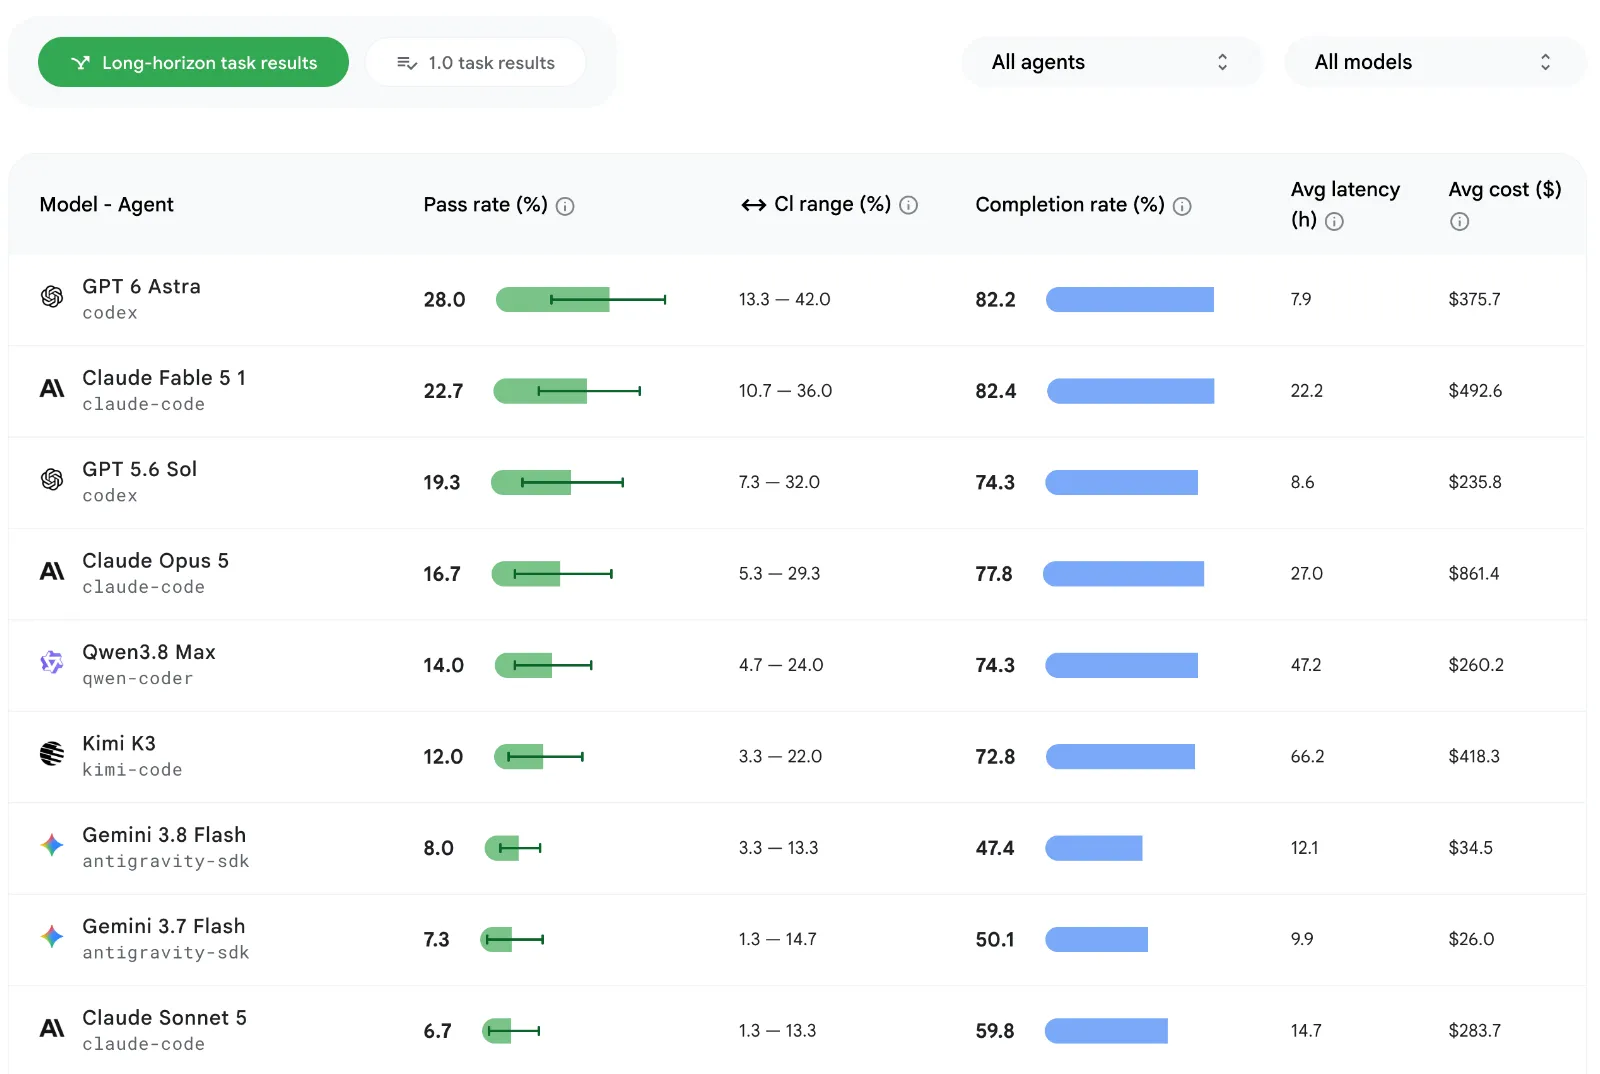
Bu tamamlama oranını işlevsellik, görsel doğruluk ve gerilemeleri önleme gibi faktörlerin bir kombinasyonuyla hesaplarız. Ayrıca, değerlendirme talimatlarından veya yapısal kısıtlamalardan sapmalar için de objektif puanlama cezaları uygularız. Güncellenen skor tablosuna göz atın ve her modelin kart görünümünü tıklayarak geçme oranı, tamamlama oranı ve model başına ve görev başına ortalama maliyetler gibi ek öğeleri görün.
LHT'ler için en yüksek geçme oranı yaklaşık%28 olup karşılaştırmadaki orijinal görevlerin geçme oranı olan% 91'den çok daha düşüktür.

Uzun vadeli görevler, yapay zeka yardımcısı için faydalı analizler sunar
LHT veri seti, yapay zekanın uzun süren görevleri ne kadar iyi yönettiğini ölçmenin yanı sıra test edilen modellerin güçlü ve zayıf yönleri hakkında daha fazla bilgi edinmemize yardımcı olur. Ayrıca, size daha pratik rehberlik sunar.
Yapay zeka, model katmanlarında mevcut kodu yeniden düzenlemek yerine yeni kod yazma konusunda daha başarılıdır. Başarı, kod hacminden ziyade mimari karmaşıklığa bağlı olduğundan yeniden düzenlemeler ve taşımalar daha zor hale gelir.
Modeller, Java'yı Kotlin'e dönüştürme, Retrofit'i Ktor ile değiştirme veya ViewModel katmanı ekleme gibi iyi bilinen, deterministik dönüşümlerde güçlü yetenekler gösterir. Bu kalıpları 125'ten fazla dosya ve 8.000'den fazla kod satırında bile tutarlı bir şekilde uygularlar.
Ancak görevler, çalışma zamanı doğrulaması (ör. eksik bağımlılık ekleme grafikleri) gerektirdiğinde, çerçeve değişikliklerini bozduğunda veya yayınlanmamış kitaplıklarla ilgili bilgi eksiklikleriyle karşılaştığında modeller zorlanır. Platformlar arası uygulamaları Android'e taşıma, çözüme ulaşmamış bir sorun olmaya devam ediyor. Hiçbir model% 100 başarı oranına ulaşamıyor ve en gelişmiş modeller en fazla% 80 tamamlanma oranına ulaşıyor.
Temsilci değerlendirmeleri kullanıma sunuluyor
Modellerin, ajan tabanlı iş akışlarınıza entegre edildiğinde nasıl performans gösterdiğini daha iyi anlamanıza yardımcı olmak için değerlendirmemize en çok tercih edilen ajanları ekliyoruz. İşe, yeni modelleri ilgili model sağlayıcının aracılarıyla birlikte LHT'lere karşı çalıştırarak başlıyoruz. Örneğin, Codex'te GPT 5.6 Sol'u, Google Antigravity'de ise Gemini 3.8 Flash'i çalıştırdık. Bu eşleştirme, istem önbelleğe alma ve kompakt araç penceresi oluşturma gibi özelliklerin jeton sayısında azalmaya yol açabildiğini göstererek koşum tasarımının geliştirici sonuçlarını nasıl olumlu yönde etkilediğini gösteriyor.
Gelecekte, hangi kombinasyonların sizin ve ekibiniz için en iyi sonucu verdiğini keşfetmenize yardımcı olmak amacıyla çeşitli model ve aracı kombinasyonlarındaki sonuçları da vurgulayarak bu özelliği genişleteceğiz.
Android geliştirmede istediğiniz aracı ve modeli kullanabilmeniz önemli olduğundan bu ölçüme yatırım yapıyoruz. Önümüzdeki haftalarda bu konuyla ilgili daha fazla bilgi paylaşacağız.
Yeni modeller eklendi
Ayrıca, geliştirme kararlarınız için en güncel verilere sahip olmanızı sağlamak amacıyla skor tablomuzu genişletmeye devam ediyoruz. Gemini 3.8 Flash, Gemini 3.7 Flash, OpenAI'ın GPT-6'sı, Anthropic'in Fable 5.1'i, Kimi K3 ve Qwen 3.8 Max'i ekledik. OpenAI'ın GPT-6 Astra'sı% 28 geçme oranıyla listenin başında yer alıyor.
Geleceğe dönük planlar
Android Bench 2.0, Android geliştirmede yapay zekayı ölçmek için sağlam bir ortam sunar. Uzun vadeli görevleri, çok formatlı değerlendirmeyi, aracıları ve sürekli puanlamayı birleştirerek yapay zeka araştırma ekiplerinin daha yetenekli ve güvenilir yapay zeka kodlama ortakları oluşturmasına yardımcı olmayı ve yapay zeka geliştirme seçenekleriniz hakkında daha fazla şeffaflık sağlamayı amaçlıyoruz.
Güncellenen metodoloji ile birlikte güncellenen skor tablosuna göz atın. Geri bildirimleriniz, Android Bench'i geliştirme şeklimizi doğrudan etkiler. Bu nedenle, lütfen geri bildirimlerinizi GitHub'da ve X ile LinkedIn gibi sosyal medya kanallarımızda bizimle paylaşmaya devam edin.
-
 Ürün Haberleri
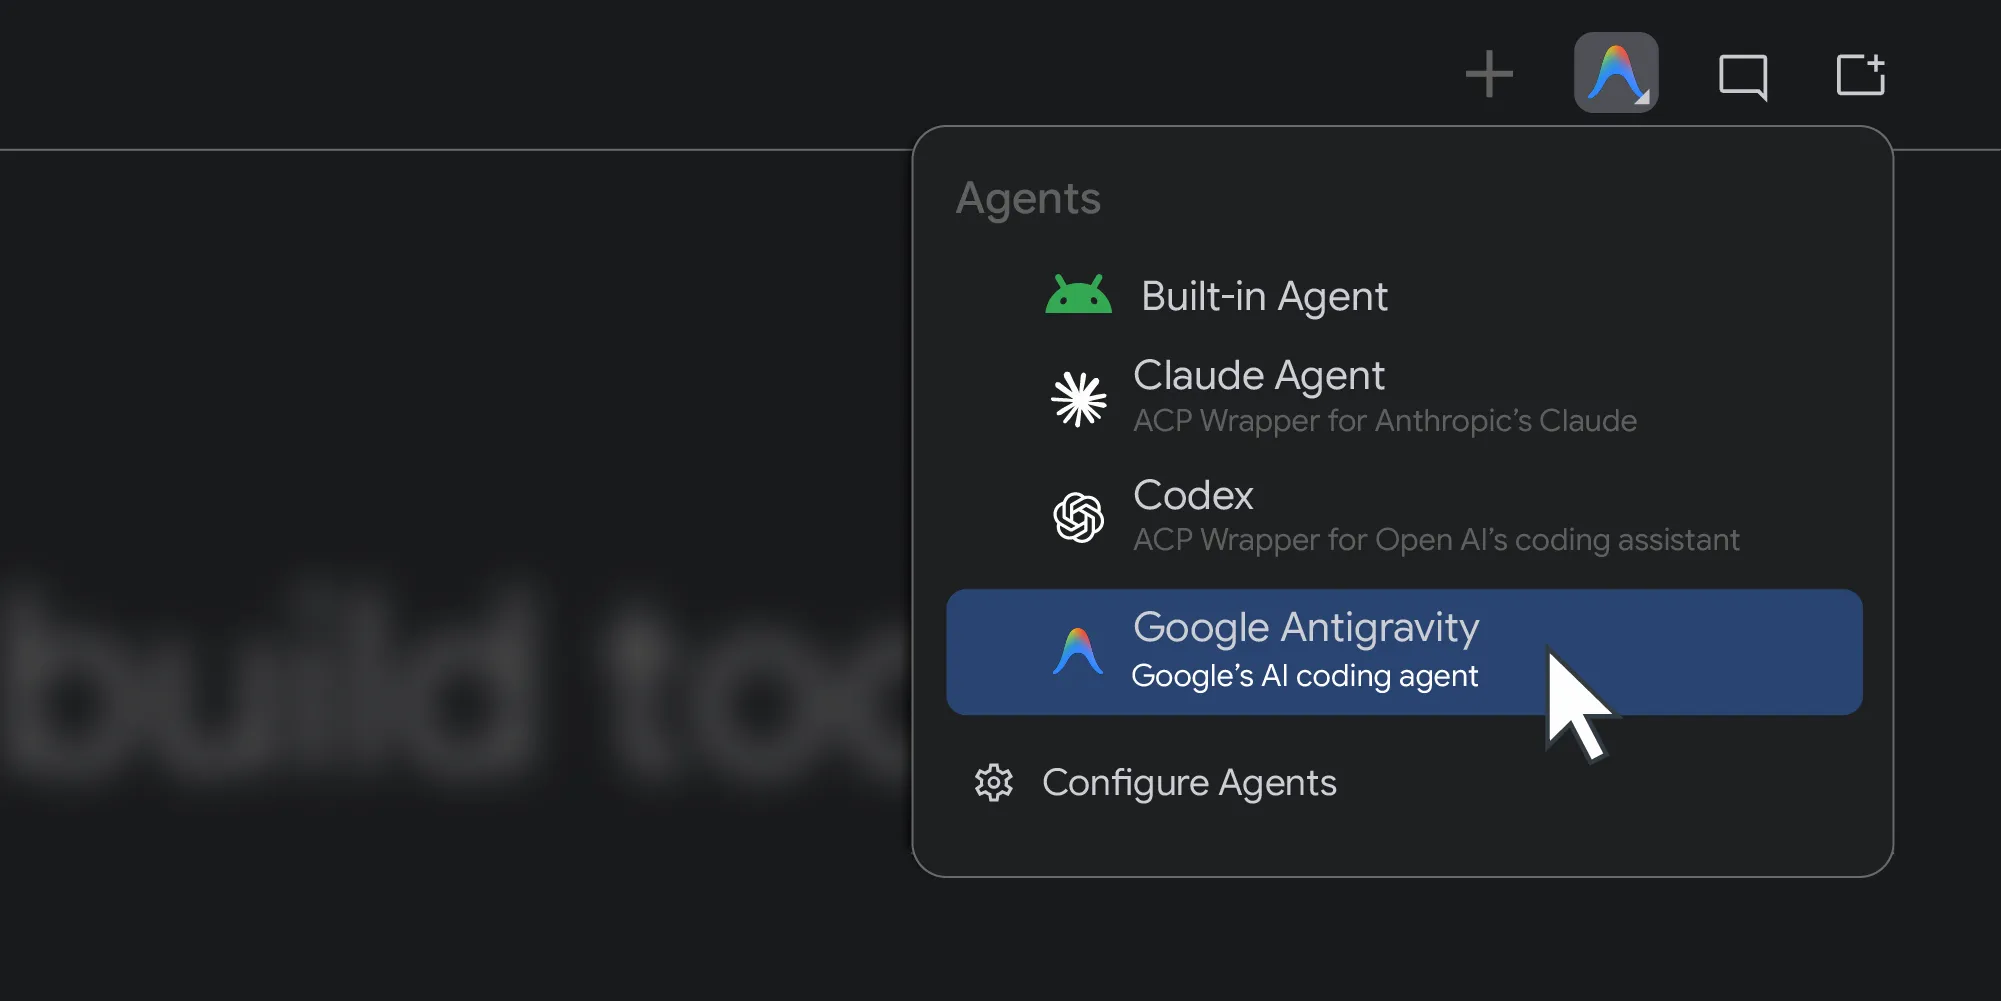
Geçen yıl Android Studio, tüm yapay zeka modellerine açıldı. Bugün, kodlama aracınızı seçme desteğini sunarak bir sonraki adımı atıyoruz.
Matthew Warner • Okuma süresi: 3 dk. -

 Ürün Haberleri
Mart ayında, gerçek dünyadaki Android geliştirme görevleri için LLM skor tablomuz olan Android Bench'i tanıtmıştık. O zamandan beri, açık ağırlıklı modelleri değerlendirme ve maliyet ile verimlilik boyutlarını skor tablosuna ekleme gibi geri bildirimleriniz doğrultusunda karşılaştırma ölçütünü geliştirdik.
Zoe Lopez-Latorre • Okuma süresi: 3 dk. -
 Ürün Haberleri
Bugün Android 17'yi yayınlıyor ve desteklenen çoğu Pixel cihazda kullanıma sunuyoruz. Önümüzdeki aylarda Android 17'nin yüklü olduğu yeni cihazlar satışa sunulacak.
Matthew McCullough • Okuma süresi: 13 dakika
Android geliştirmeyle ilgili en son analizleri haftalık olarak gelen kutunuza alın.