Android için LLM'lerin ölçülme şeklinin gelişmesi: Android Bench'te yeni bir dönem
Okuma süresi: 3 dakika

Mart ayında, gerçek dünyadaki Android geliştirme görevleri için LLM skor tablomuz olan Android Bench'i tanıtmıştık. Amacımız, Android geliştirmede model yetenekleri konusunda şeffaflık sağlamak ve model iyileştirmelerini teşvik ederek günlük iş akışınızda daha faydalı yapay zeka seçenekleri sunmaktır. O zamandan beri, açık ağırlıklı modellerin değerlendirilmesi ve maliyet ile verimlilik boyutlarının skor tablosuna eklenmesi de dahil olmak üzere geri bildirimlerinize göre karşılaştırmayı geliştirdik.
Ancak yapay zeka özellikleri sürekli gelişiyor ve ölçüm de buna ayak uydurmalıdır. Temmuz sürümümüz kapsamında, modelleri değerlendirmek için kullanılan karşılaştırma aracısının güncellenmiş bir sürümünü içeren Harbor çerçevesini kullanmaya başladık.
Değerlendirmemizde yaptığımız bu değişikliğin yanı sıra, Temmuz sürümünde liderlik tablosuna 8 yeni model (Claude Fable 5, Claude Sonnet 5, Claude Opus 4.8, GLM 5.2, Kimi K2.7 Code, MiniMax M3, Qwen 3.7 Plus ve Qwen 3.7 Max) ekliyoruz. Ayrıca, Android geliştirici topluluğu olarak sizin de karşılaştırmaya katkıda bulunabileceğiniz fırsatları paylaşıyoruz.
Harbor çerçevesiyle metodolojimizi geliştirme
Android Bench'i tasarlarken metodolojimizi o sırada mevcut olan önde gelen endüstri standartlarına dayandırdık. Genel amaçlı bir karşılaştırma aracısı olan mini-swe-agent v1'i kullandık ve Android geliştirmenin nüanslarına uyarlayarak modellerin yaygın Android geliştirme görevlerindeki yetenekleri için temel bir ölçüm sağladık.
Android geliştirme alanındaki en yeni model özelliklerini doğru şekilde ölçen, son teknoloji değerlendirmeler sunmaya devam etmek için karşılaştırma testimizi Harbor çerçevesine göre standartlaştırıyoruz. Harbor, herkesin karşılaştırma testi yapmasını, tercih ettiği kurulumu değerlendirmesini veya sonuçları paylaşmasını kolaylaştıran standartlar ve entegrasyonlar tanımlayarak size daha fazla şeffaflık ve görünürlük sağlar.
Bu yükseltme, modelleri ve yeteneklerini daha titiz bir şekilde değerlendirmemize olanak tanıyor. Güncellenmiş bir temel oluşturmak için tüm modellerde karşılaştırma testini yeniden yaptık. Bu, puanlamada küçük bir değişiklik olduğu anlamına gelir ancak web sitemizdeki arşivde geçmiş puanları görüntülemeye devam edebilirsiniz.
Android Bench'in sizin için faydalı olmasını istiyoruz. Bu nedenle, değerlendirmelerimiz ve sektör geliştikçe Android Bench'i sürekli olarak güncelleyeceğiz.
8 yeni modelle skor tablosunu genişletme
Skor tablosunu güncel tutma taahhüdümüz kapsamında Android Bench skor tablosuna Claude Fable 5, Claude Sonnet 5, Claude Opus 4.8, GLM 5.2, Kimi K2.7 Code, MiniMax M3, Qwen 3.7 Plus ve Qwen 3.7 Max'i ekledik.
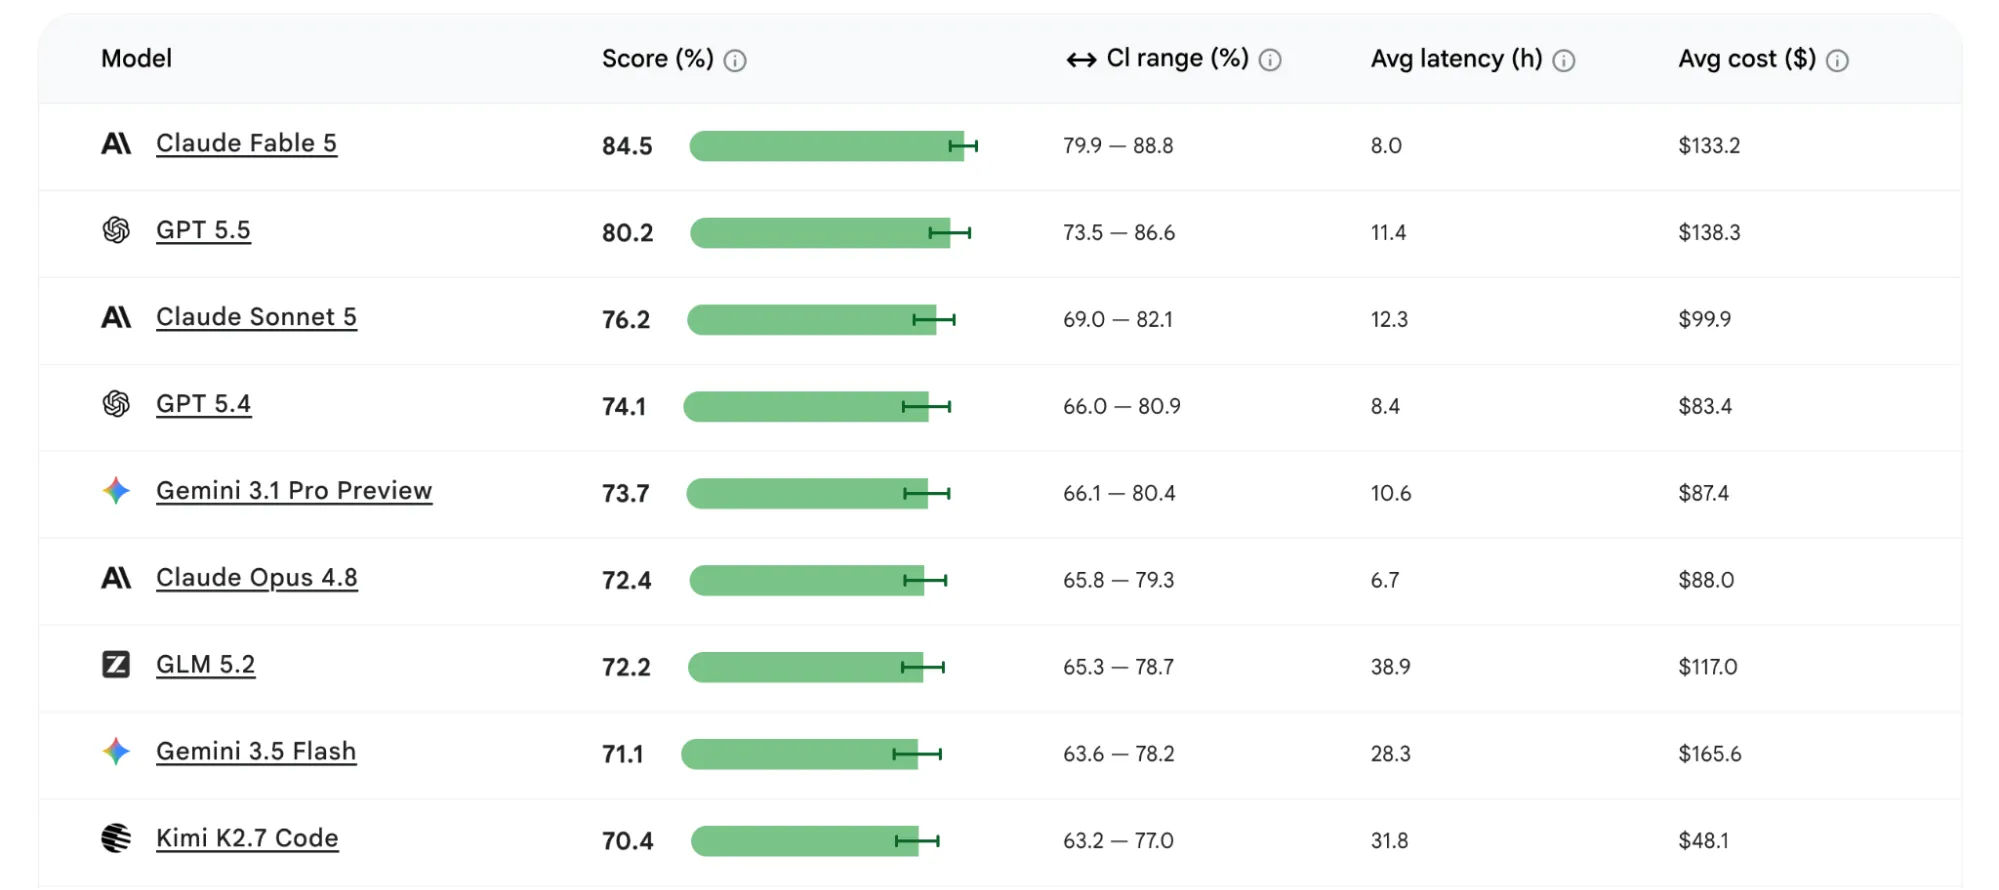
84,5 puanla Claude Fable 5'in liderlik tablosunun en üstünde, 80,2 puanla GPT 5.5'in ikinci sırada ve 76,2 puanla Claude Sonnet 5'in üçüncü sırada olduğunu göreceksiniz.
Yalnızca açık ağırlıklı modeller karşılaştırıldığında 72, 2 puanla GLM 5.2 birinci sırada yer alıyor. 70, 4 puanla Kimi K2.7 Code ise ikinci sırada.
Bu yeni ve önceki modellerin, Jetpack Compose geçişleri, giyilebilir cihazlarda ağ oluşturma ve platform API güncellemeleri gibi Android'e özgü zorluklarla nasıl başa çıktığını görmek için güncellenen skor tablosunda model performansı ve verimlilik metriklerini inceleyebilirsiniz.
Android Bench'i topluluk katkılarına açıyoruz
Başlangıçtan beri açık ve şeffaf bir yaklaşımı benimsedik. Bu nedenle, orijinal metodolojimizi ve test düzeneğimizi GitHub'da herkese açık olarak paylaştık. Veri setimizle ilgili geri bildirimde bulunmak için bir yol talep ettiniz. Şimdi, Android geliştirici topluluğu olarak Android Bench'i şekillendirme fırsatı sunarak işbirliğini bir adım daha ileri taşıyoruz.
Bugünden itibaren Android Bench'e iki şekilde katkıda bulunabilirsiniz:
- Modellerin sizin için önemli olan senaryoları nasıl ele aldığını değerlendirmek için kendi Android geliştirme görevlerinizi tasarlayıp gönderin.
- Karşılaştırma değerlendirmelerini doğrudan çalıştırıp paylaşın. Tercih ettiğiniz modelleri veri kümemize veya kendi özel görevlerinize göre test edin.
Gönderilen görevleri inceleyip karşılaştırmaya eklenip eklenmeyeceklerini değerlendireceğiz. Küresel Android geliştirici topluluğunun çeşitli ve günlük gerçeklerini gerçekten yansıtan bir ölçüt oluşturmayı umuyoruz.
Geleceğe bakış
Ajan geliştirme için giderek daha fazla seçenek sunuluyor. Bu nedenle, en yeni ölçütleri korumak, güvendiğiniz yapay zeka yardımının daha akıllı, daha faydalı ve daha etkili olmasını sağlar. Görevlere göz atmak için GitHub depomuza gidin. Ekibimize inceleme için bir görev gönderebilirsiniz. Ayrıca veri kümesini keşfetmek veya değerlendirme göndermek için Harbor Hub'ı inceleyebilirsiniz.
Her zaman olduğu gibi, güncellenmiş skor tablosunu web sitemizde bulabilir veya metodolojiyi okuyabilirsiniz.
-
 Ürün Haberleri
Geçen yıl Android Studio, tüm yapay zeka modellerine açıldı. Bugün, kodlama aracınızı seçme desteğini sunarak bir sonraki adımı atıyoruz.
Matthew Warner • Okuma süresi: 3 dk. -
 Ürün Haberleri
Bugün, mühendislerin tamamlaması birkaç gün hatta bir hafta süren, büyük ölçüde karmaşık görevler olan uzun vadeli görevlerin (LHT) ilk grubunu yayınlıyoruz. Ayrıca, ilgili model sağlayıcıların temsilcileriyle başlayarak temsilci tabanlı değerlendirmeyi de kullanıma sunuyoruz.
Matthew McCullough • Okuma süresi: 3 dk. -
 Ürün Haberleri
Google Play'de, büyümenizi sağlamanıza, yeni iş modellerine uyum sağlamanıza ve kullanıcılarınıza tam olarak bulundukları yerde ulaşmanıza yardımcı olmak için abonelik platformumuzu sürekli olarak genişletiyoruz.
Sheenam Mittal • Okuma süresi: 4 dakika
Android geliştirmeyle ilgili en son analizleri haftalık olarak gelen kutunuza alın.