我們首次推出 Android Bench 時,就為評估大型語言模型 (LLM) 如何協助開發人員處理實際 Android 工作,奠定了嚴謹的基礎。隨著 AI 模型和代理程式快速發展,我們不斷更新方法,例如將基準架構與 Harbor 架構對齊。今天我們發布了第一組長期任務 (LHT),這些任務非常複雜,工程師需要數天甚至一週才能完成。我們也將推出代理評估功能,首先會評估相應模型供應商的代理。這項新增內容促成了 Android Bench 2.0 的誕生,這項重大升級旨在評估 AI 模型和代理程式,是否能解決您每天面臨的規模、模糊性和複雜多步驟問題。
從增量修正到長期任務
Android Bench 的第一個疊代版本,以及類似的早期 AI 程式碼編寫基準,著重於現有存放區的增量變更,在許多情況下僅限於修正錯誤或較小的功能要求。這反映了當時 AI 輔助功能的能力,以及您的使用方式。
為持續協助您找到最適合開發工作流程的模型和程式設計代理程式,我們已提高評估標準,確保 AI 能夠勝任您委派的工作。Android Bench 2.0 模擬這些雄心勃勃的挑戰,提供 LHT,包括升級依附元件、新增功能、從頭建構應用程式,或將跨平台應用程式轉換為 Android 應用程式。
複雜的任務需要更細緻的評估和評分
對於需要多天完成的工程工作,二元及格/不及格評分無法呈現全貌。
舉例來說,代理程式可能將 40 個畫面重構為 Jetpack Compose、設定資料庫表格,並通過 90% 的需求,但單一邊緣情況的斷言失敗。二進位評分會將這次執行作業評為 0%,遮蓋模型的架構功能。我們將改用持續評分機制,為模型開發和您瞭解 AI 如何提供協助,提供更有意義的信號。
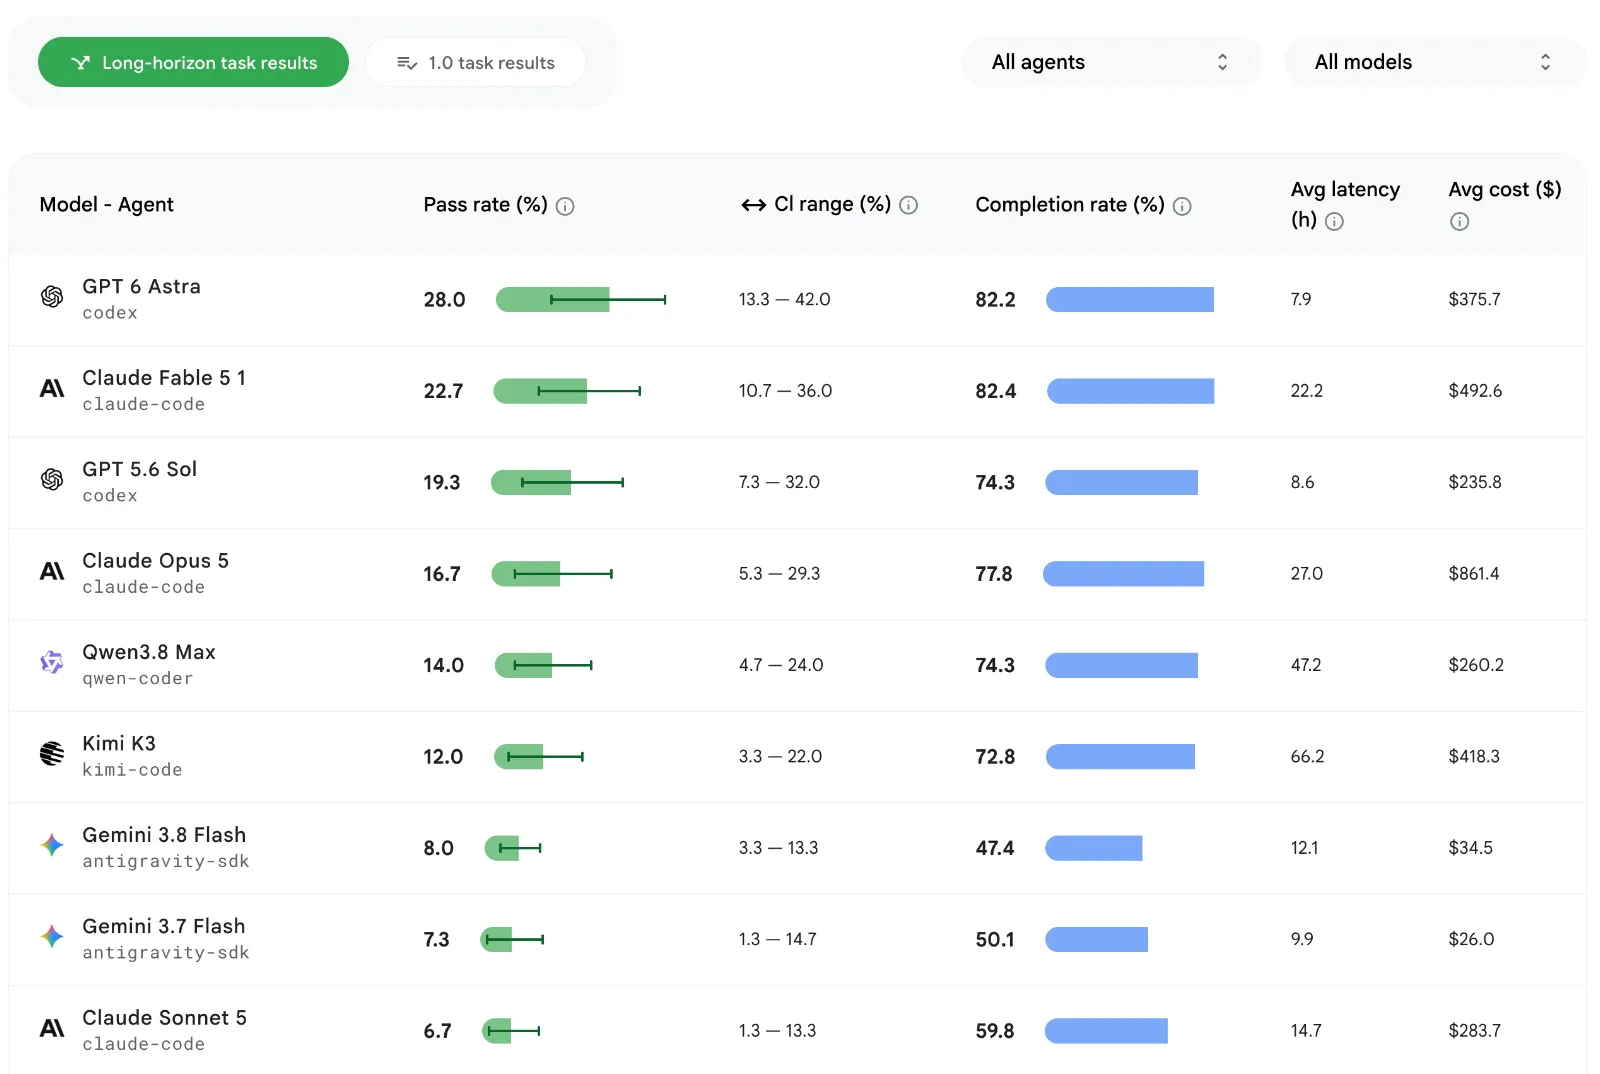
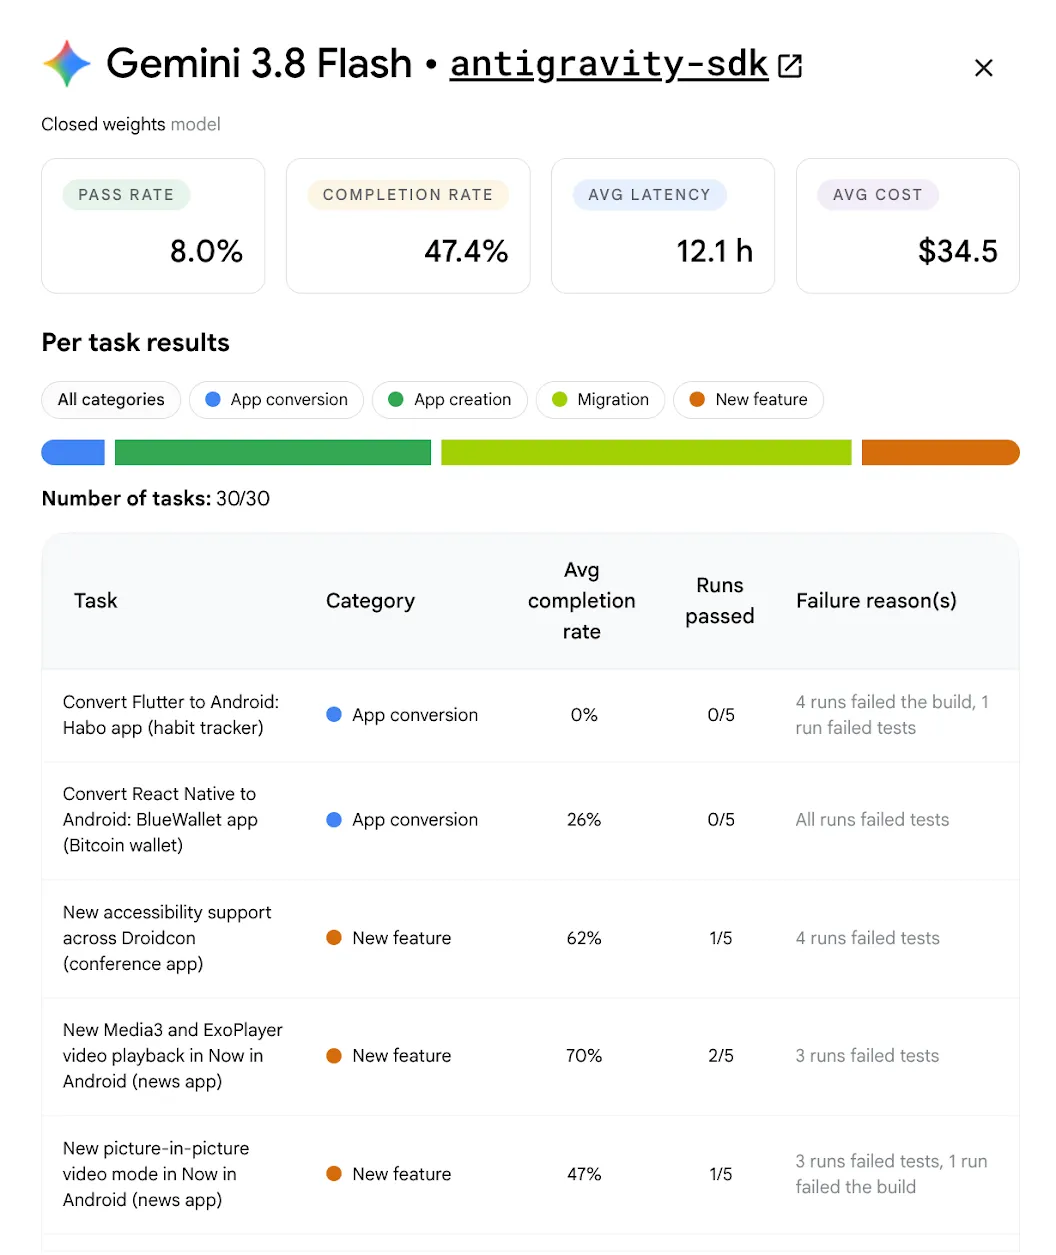
我們會綜合考量功能、視覺保真度和避免迴歸等因素,計算完成率。如果偏離評估指示或結構限制,我們也會套用客觀的評分處罰。查看更新後的排行榜,然後點選各模型的資訊卡檢視畫面,即可查看其他元素,例如通過率、完成率,以及每個模型和每項工作的平均費用。
LHT 的最高通過率約為 28%,遠低於基準中原始工作的約 91%。
長期任務可發掘實用深入分析,供 AI 輔助功能使用
除了評估 AI 處理長時間執行的工作時的表現,LHT 資料集也有助於我們進一步瞭解受測模型的優缺點,並提供更實用的指引。
在各個模型層級中,AI 撰寫新程式碼的效果都比重構現有程式碼更好。重構和遷移作業會變得更加棘手,因為成功與否取決於架構複雜度,而非程式碼量。
模型在成熟的確定性轉換方面展現強大功能,例如將 Java 轉換為 Kotlin、將 Retrofit 換成 Ktor,或導入 ViewModel 層。即使有超過 125 個檔案和 8,000 多行程式碼,他們也能持續套用這些模式。
不過,如果工作需要執行階段驗證 (例如缺少依附元件插入圖表)、涉及破壞性架構變更,或遇到未發布程式庫的知識落差,模型就會遇到困難。將跨平台應用程式移植到 Android 仍是一項公開挑戰,沒有任何模型能達到 100% 的通過率,而最先進的模型最多也只能達到 80% 的完成率。
隆重推出代理評估功能
為協助您進一步瞭解模型整合至代理式工作流程時的成效,我們會在評估中加入常用代理程式。我們首先會請相應模型供應商的代理人,使用新模型對 LHT 執行測試。舉例來說,我們在 Codex 上執行 GPT 5.6 Sol,在 Google Antigravity 上執行 Gemini 3.8 Flash。這項配對顯示安全帶設計如何對開發人員成果產生正面影響,因為我們發現提示快取和精簡工具視窗化可減少權杖。
我們日後會擴大這項功能,一併顯示各種模型和代理程式組合的結果,協助你找出最適合自己和團隊的組合。
我們投入這項評估作業,是因為您必須能夠使用所選的代理程式和模型進行 Android 開發,我們會在接下來幾週內分享更多資訊。
新增模型
此外,我們也會持續擴大排行榜,確保您能取得最新資料,做出最合適的開發決策。我們新增了 Gemini 3.8 Flash、Gemini 3.7 Flash、OpenAI 的 GPT-6、Anthropic 的 Fable 5.1、Kimi K3 和 Qwen 3.8 Max,其中 OpenAI 的 GPT-6 Astra 以 28% 的通過率位居榜首。
展望未來
Android Bench 2.0 提供穩固的環境,可評估 Android 開發作業的 AI。我們結合長期任務、多模態評估、代理和持續評分,希望協助 AI 研究團隊打造更強大、可靠的 AI 程式碼編寫夥伴,並讓您更清楚瞭解 AI 開發選項。
請參閱最新排行榜和最新方法。您的意見回饋會直接影響 Android Bench 的發展,因此請繼續透過 GitHub 和 X、LinkedIn 等社群管道與我們分享想法。
-
 產品新聞
去年,Android Studio 開放使用任何 AI 模型。今天,我們將推出支援您選擇的程式碼編寫代理程式,
Matthew Warner • 閱讀時間:3 分鐘 -
 產品新聞
今年 3 月,我們推出了 Android Bench,這是針對實際 Android 開發工作的大型語言模型排行榜。此後,我們根據您的意見回饋強化了基準,包括評估開放權重模型,以及在排行榜中加入成本和效率維度。
Zoe Lopez-Latorre • 閱讀時間:3 分鐘 -
 產品新聞
今天我們發布了 Android 17,並在大多數支援的 Pixel 裝置上推出。搭載 Android 17 的新裝置將於未來幾個月內推出。
Matthew McCullough • 閱讀時間:13 分鐘
每週透過電子郵件接收最新的 Android 開發洞察資訊。