今年 3 月,我們推出了 Android Bench,這是針對實際 Android 開發工作的大型語言模型排行榜。我們的目標是讓您清楚瞭解 Android 開發中的模型功能,並鼓勵模型改良,為日常工作流程提供更多實用的 AI 選項。自此之後,我們根據您的意見回饋,強化了基準,包括評估開放權重模型,並在排行榜中加入成本和效率維度。
但 AI 功能不斷演進,評估方式也必須與時俱進。在 7 月發布的版本中,我們採用了 Harbor 架構,其中包含用於評估模型的基準化代理程式更新版本。
除了更新評估方式,我們也在 7 月發布的排行榜中新增 8 個模型,包括 Claude Fable 5、Claude Sonnet 5、Claude Opus 4.8、GLM 5.2、Kimi K2.7 Code、MiniMax M3、Qwen 3.7 Plus 和 Qwen 3.7 Max。我們也將分享機會,讓 Android 開發人員社群能為基準做出貢獻。
運用 Harbor 架構升級方法
設計 Android Bench 時,我們以當時的領先業界標準為方法基礎。我們使用一般用途基準化代理程式 mini-swe-agent v1,並根據 Android 開發的細微差異進行調整,為模型在常見 Android 開發工作中的能力提供基準評估。
為持續提供最先進的評估方式,準確評估 Android 開發的最新模型功能,我們將基準標準化為 Harbor 架構。Harbor 定義了標準和整合功能,讓任何人都能輕鬆執行基準測試、評估偏好的設定,或分享結果,進一步提升透明度和能見度。
升級後,我們就能更嚴格地評估模型及其功能,並重新執行所有模型的基準測試,建立更新後的基準。這表示分數會略有變動,但您仍可在我們網站的封存中查看歷來分數。
為確保 Android Bench 對您有幫助,我們會隨著評估和產業發展持續更新。
排行榜新增 8 個模型
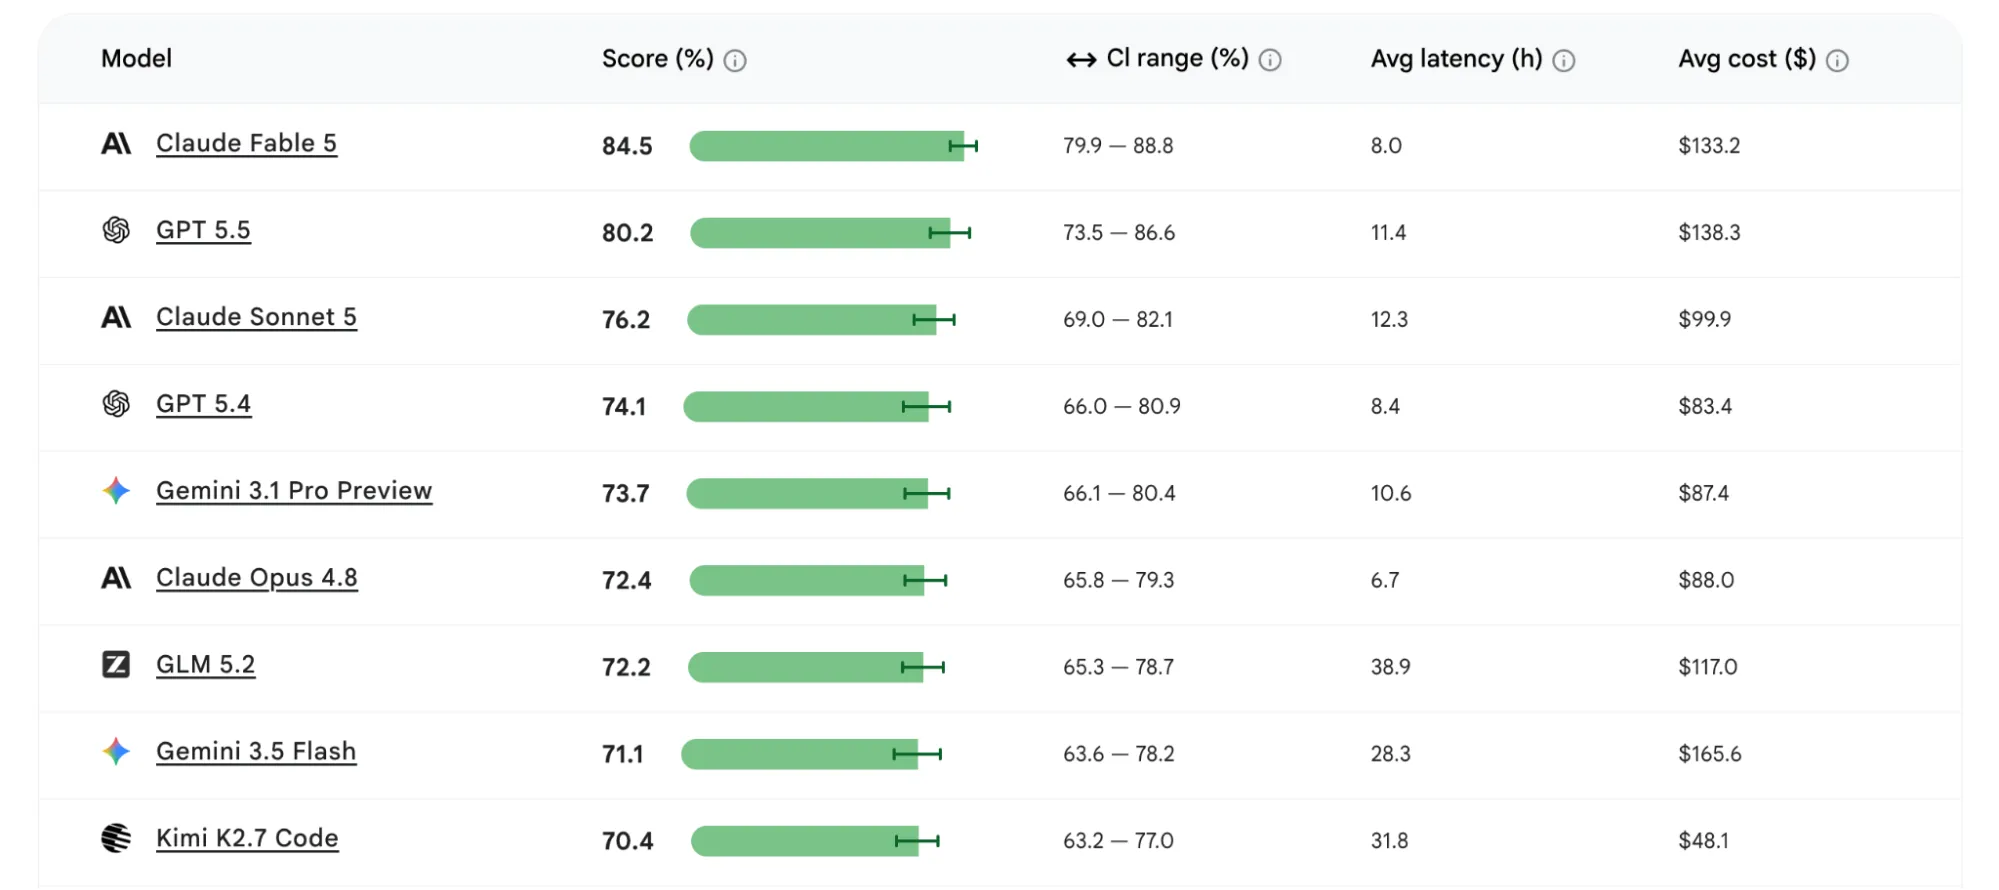
為確保排行榜內容與時俱進,我們在 Android Bench 排行榜中新增了 Claude Fable 5、Claude Sonnet 5、Claude Opus 4.8、GLM 5.2、Kimi K2.7 Code、MiniMax M3、Qwen 3.7 Plus 和 Qwen 3.7 Max。
您會看到 Claude Fable 5 以 84.5 分位居排行榜第一,其次是 GPT 5.5,得分 80.2 分,而 Claude Sonnet 5 則以 76.2 分位居第三。
如果只比較開放權重模型,GLM 5.2 以 72.2 分位居第一,Kimi K2.7 Code 則以 70.4 分緊隨其後。
您可以在更新後的排行榜上查看模型效能和效率指標,瞭解這些新舊模型如何解決 Android 特有的挑戰,例如 Jetpack Compose 遷移、穿戴式裝置網路和平台 API 更新。
開放社群協作 Android Bench
我們從一開始就重視公開透明的做法,因此在 GitHub 上公開了原始方法和測試架構。您希望提供資料集意見回饋,因此我們進一步合作,讓 Android 開發人員社群有機會參與 Android Bench 的開發。
即日起,您可以透過下列兩種方式為 Android Bench 做出貢獻:
- 設計並提交自己的 Android 開發工作,評估模型處理您重視情境的能力。
- 直接執行並分享基準評估,根據我們的資料集或您自己的自訂工作,測試偏好的模型。
我們會審查提交的作業,並評估是否將其新增至基準。我們希望建立的基準能真正反映全球 Android 開發人員社群的多元日常實況。
展望未來
隨著代理程式開發選項越來越多,維持尖端基準可確保您仰賴的 AI 輔助功能持續變得更聰明、實用且有效。請前往我們的 GitHub 存放區查看工作。歡迎將工作提交給我們的團隊審查,並前往 Harbor Hub 探索資料集或提交評估。
-
 產品新聞
去年,Android Studio 開放使用任何 AI 模型。今天,我們將推出支援您選擇的程式碼編寫代理程式,
Matthew Warner • 閱讀時間:3 分鐘 -
 產品新聞
我們今天發布了第一組長期任務 (LHT),這些任務非常複雜,工程師需要數天甚至一週才能完成。我們也將推出代理評估功能,首先會評估相應模型供應商的代理。
Matthew McCullough • 閱讀時間:3 分鐘 -
 產品新聞
Google Play 持續擴大訂閱平台,協助您推動成長、適應新商業模式,並在使用者所在之處與他們互動。
Sheenam Mittal • 閱讀時間:4 分鐘
每週透過電子郵件接收最新的 Android 開發洞察資訊。