כשהשקנו את Android Bench, יצרנו בסיס קפדני להערכת האופן שבו מודלים גדולים של שפה (LLM) עוזרים למפתחים במשימות Android בעולם האמיתי. מודלים וסוכנים של AI מתפתחים במהירות, ואנחנו מעדכנים את המתודולוגיה שלנו בהתאם. למשל, אנחנו מתאימים את מסגרת ההשוואה שלנו למסגרת Harbor. היום אנחנו משיקים את הקבוצה הראשונה של משימות ארוכות-טווח (LHT), שהן משימות מורכבות מאוד שלמהנדס לוקח כמה ימים או אפילו שבוע להשלים. אנחנו גם משיקים הערכת תפקוד של סוכנים, החל מסוכנים של ספקי מודלים תואמים. התוספת הזו מביאה אותנו ל-Android Bench 2.0 – שדרוג משמעותי שנועד להעריך מודלים וסוכני AI בהתאם להיקף, לעמימות ולפתרון הבעיות המורכב בכמה שלבים שאתם מתמודדים איתם מדי יום.
מתיקונים מצטברים ועד למשימות ארוכות טווח
הגרסה הראשונה של Android Bench, יחד עם מבחני ביצועים מוקדמים דומים של תכנות באמצעות AI, התמקדה בשינויים הדרגתיים במאגרים קיימים, ובמקרים רבים הוגבלה לתיקוני באגים או לבקשות קטנות יותר להוספת תכונות. התשובות האלה שיקפו את היכולות של הכלים מבוססי ה-AI באותו זמן, ואת האופן שבו השתמשתם בהם.
כדי להמשיך לעזור לכם למצוא את המודלים וסוכני התכנות שהכי מתאימים לתהליך הפיתוח שלכם, העלינו את רף ההערכות שלנו כך שיתאים לעבודה שאתם מאצילים ל-AI. Android Bench 2.0 משקף את האתגרים השאפתניים האלה באמצעות משימות ארוכות טווח שכוללות שדרוג של יחסי תלות, הוספת תכונות חדשות, פיתוח אפליקציות מאפס או המרה של אפליקציה בפלטפורמות שונות ל-Android.
משימות מורכבות דורשות הערכה וניקוד מפורטים יותר
במשימות הנדסה שנמשכות כמה ימים, ציון בינארי של "עבר" או "נכשל" לא משקף את התמונה המלאה.
לדוגמה, נציג יכול לשכתב 40 מסכים ל-Jetpack Compose, להגדיר טבלאות של מסדי נתונים ולעמוד ב-90% מהדרישות, אבל להיכשל בטענה אחת של מקרה קצה. בדירוג בינארי, ההרצה הזו מקבלת ציון של 0%, מה שמסתיר את היכולות הארכיטקטוניות של המודל. אנחנו עוברים לניקוד רציף כדי לספק אות משמעותי יותר, גם לפיתוח המודל וגם כדי להבין איך AI יכול לעזור לכם.
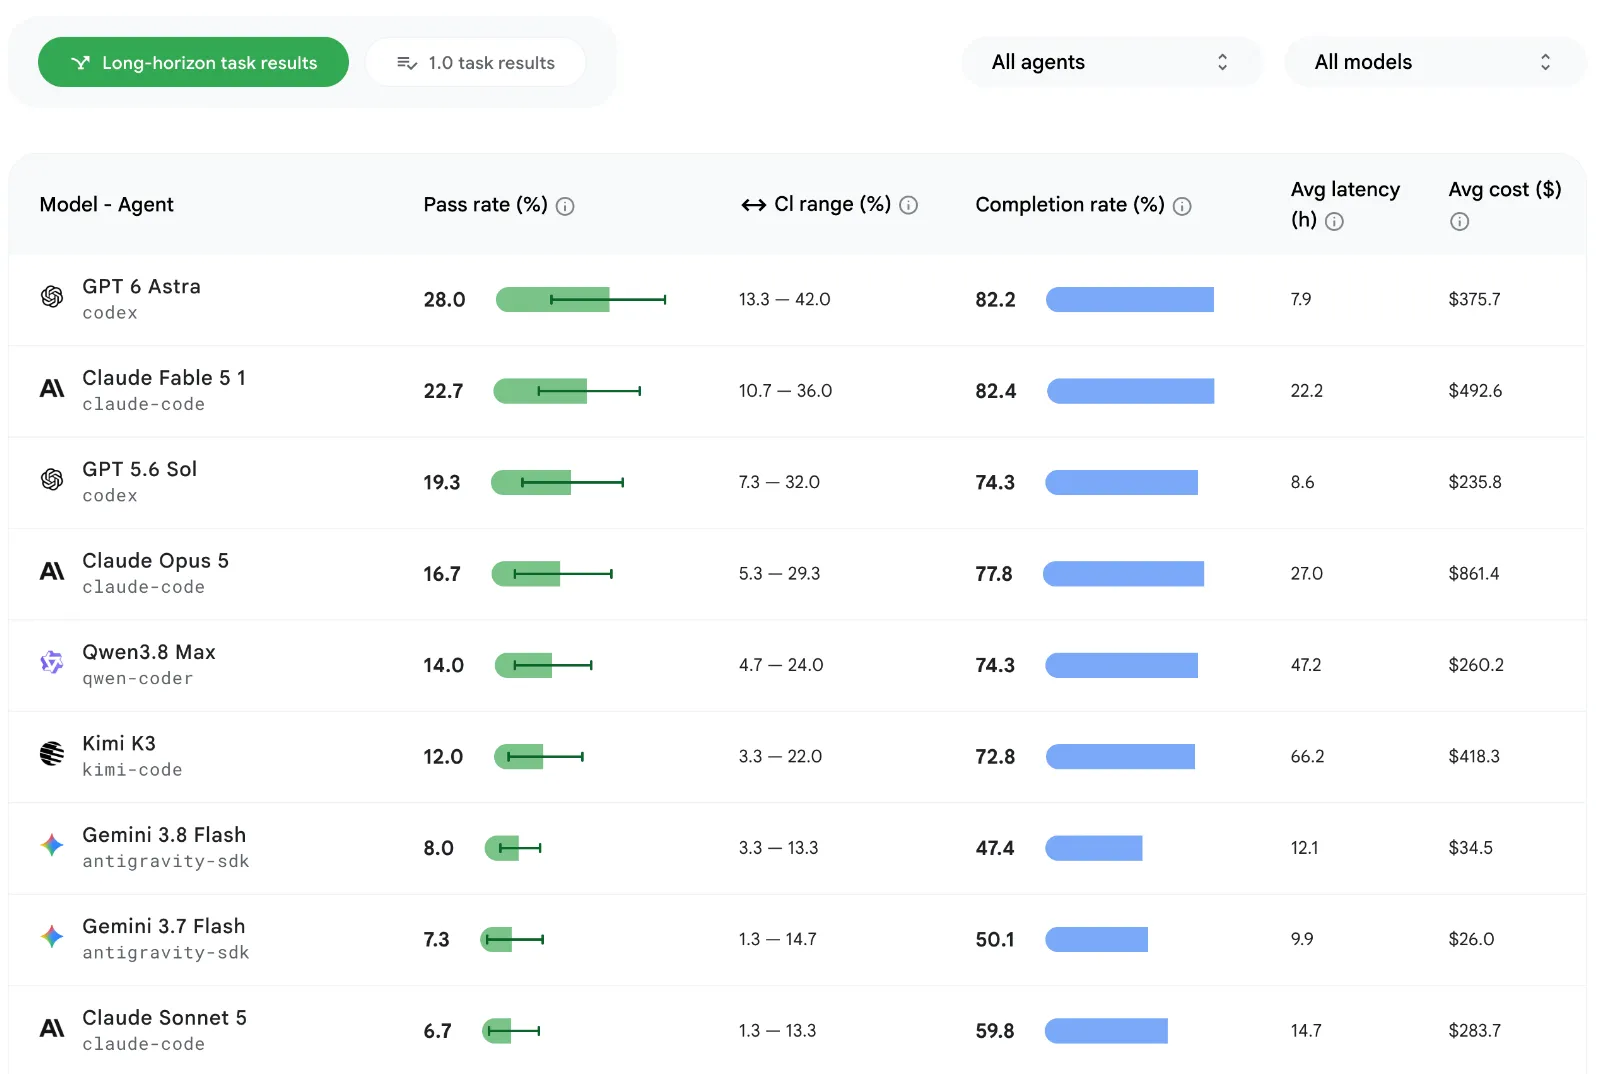
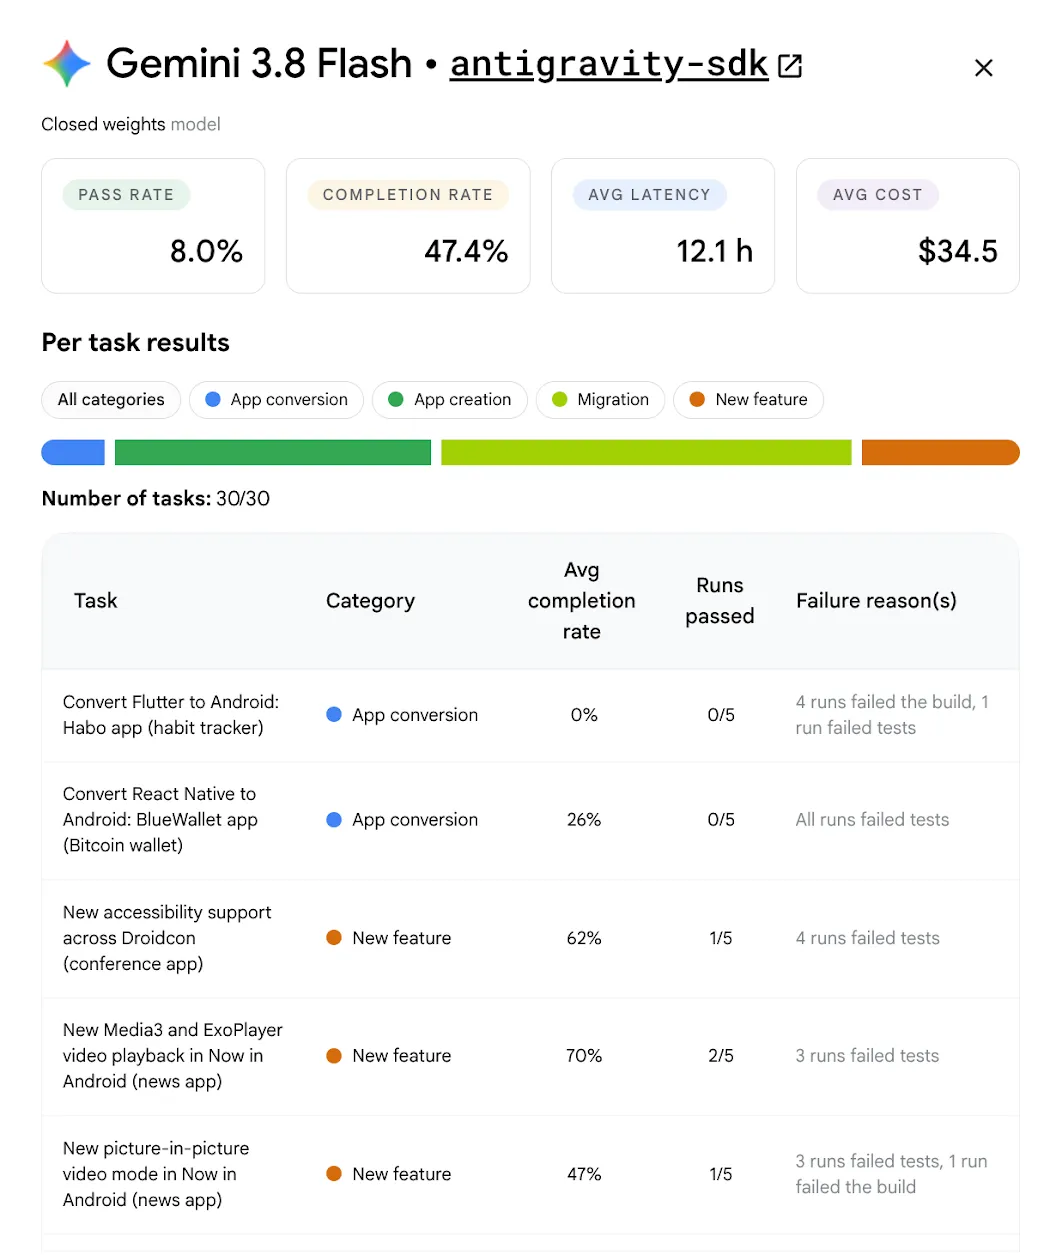
אנחנו מחשבים את שיעור ההשלמה הזה באמצעות שילוב של גורמים כמו פונקציונליות, נאמנות חזותית והימנעות מרגרסיות. אנחנו גם מורידים נקודות באופן אובייקטיבי על חריגות מהוראות ההערכה או מהמגבלות המבניות. כדאי לעיין בטבלת המובילים המעודכנת וללחוץ על תצוגת הכרטיסים של כל מודל כדי לראות רכיבים נוספים, כמו שיעור המעבר, שיעור ההשלמה והעלויות הממוצעות לכל מודל ולכל משימה.
שיעור ההצלחה הגבוה ביותר במשימות LHT הוא כ-28%, הרבה יותר נמוך משיעור ההצלחה של כ-91% במשימות המקוריות בבנצ'מרק.
משימות ארוכות-טווח מספקות תובנות מועילות לכלים מבוססי-AI
מעבר למדידת היכולת של ה-AI לטפל במשימות ארוכות, מערך הנתונים של LHT עוזר לנו ללמוד עוד על נקודות החוזק והחולשה של המודלים שנבדקו, ואנחנו מציעים לכם הנחיות מעשיות יותר.
בכל רמות המודלים, ה-AI כותב קוד חדש טוב יותר מאשר משכתב קוד קיים. הגורמים שמשפיעים על ההצלחה של תהליכי שכתוב והעברה הם המורכבות של הארכיטקטורה ולא נפח הקוד, ולכן התהליכים האלה הופכים למורכבים יותר.
המודלים מציגים יכולות חזקות בטרנספורמציות דטרמיניסטיות מבוססות, כמו המרת Java ל-Kotlin, החלפת Retrofit ב-Ktor או הוספת שכבת ViewModel. הם מיישמים את התבניות האלה באופן עקבי, גם על פני יותר מ-125 קבצים ויותר מ-8,000 שורות קוד.
עם זאת, המודלים מתקשים במשימות שדורשות אימות בזמן ריצה (כמו תרשימים חסרים של הזרקת תלויות), כוללות שינויים משמעותיים ב-framework או נתקלות בפערי ידע עם ספריות שלא פורסמו. היסב אפליקציות בפלטפורמות שונות ל-Android הוא עדיין אתגר פתוח – אף מודל לא מגיע ל-100% הצלחה, והמודלים פורצי הדרך מגיעים לכל היותר ל-80% שיעור השלמה.
השקת הכלי "הערכת תפקוד הסוכנים"
כדי לעזור לכם להבין טוב יותר את ביצועי המודלים כשהם משולבים בתהליכי העבודה של הסוכנים, אנחנו מוסיפים להערכה שלנו סוכנים נפוצים. אנחנו מתחילים בהפעלת מודלים חדשים מול LHT עם סוכנים מספק המודלים המתאים. לדוגמה, הפעלנו את GPT 5.6 Sol ב-Codex ואת Gemini 3.8 Flash ב-Google Antigravity. השילוב הזה מראה איך עיצוב הרתמה משפיע באופן חיובי על תוצאות הפיתוח, כי ראינו ששמירת הנחיות במטמון וחלונות של הכלי קומפקטיים יכולים להפחית את מספר הטוקנים.
בעתיד נרחיב את האפשרות הזו ונדגיש גם תוצאות משילובים שונים של מודלים וסוכנים, כדי לעזור לכם לגלות אילו שילובים הכי מתאימים לכם ולצוות שלכם.
אנחנו משקיעים במדידה הזו כי חשוב לנו שתהיה לכם אפשרות להשתמש בסוכן ובמודל שאתם בוחרים לפיתוח ב-Android, ויהיה לנו עוד מידע לשתף איתכם בשבועות הקרובים.
הוספנו מודלים חדשים
בנוסף, אנחנו ממשיכים להרחיב את טבלת המובילים כדי לוודא שיש לכם את הנתונים הכי עדכניים לקבלת החלטות בנוגע לפיתוח. הוספנו את Gemini 3.8 Flash, Gemini 3.7 Flash, GPT-6 של OpenAI, Fable 5.1 של Anthropic, Kimi K3 ו-Qwen 3.8 Max, ו-GPT-6 Astra של OpenAI הגיע למקום הראשון עם שיעור מעבר של 28%.
במבט קדימה
Android Bench 2.0 מספק סביבה חזקה למדידת יכולות ה-AI לפיתוח ב-Android. אנחנו מקווים שהשילוב של משימות ארוכות-טווח, הערכה מולטי-מודאלית, סוכנים וניקוד רציף יאפשר לצוותי מחקר בתחום ה-AI לפתח שותפי תכנות מבוססי-AI עם יכולות מתקדמות ואמינות יותר, וגם יספק לכם יותר שקיפות לגבי האפשרויות לפיתוח AI.
כדאי לעיין בטבלת המובילים המעודכנת ובמתודולוגיה המעודכנת. המשוב שלכם משפיע ישירות על האופן שבו אנחנו מפתחים את Android Bench, אז המשיכו לשתף איתנו את המשוב שלכם ב-GitHub, וגם בערוצים שלנו ברשתות החברתיות כמו X ו-LinkedIn.
-
 חדשות על המוצר
היום, במפגש של מפתחי Android, אנחנו מכריזים על הזמינות הרחבה של הרבה כלים וממשקי API שנועדו להסיר את החיכוך היומיומי ולתת לכם יותר גמישות ליצור אפליקציות Android נהדרות.
Matthew McCullough • משך הקריאה: 4 דקות -
 חדשות על המוצר
ככל שהפיתוח של סוכני AI מתקדם, הנדסת Android מגיעה לתחום חדש ומלהיב: מעבר מהשלמת קוד מסייעת לסוכנים שמבצעים משימות מקצה לקצה לפי ההנחיות שלכם. אתם יכולים לבחור את המודלים והסוכנים שאתם רוצים להשתמש בהם, וליהנות מגמישות מלאה.
Jason Buchel • משך הקריאה: 3 דקות -
 חדשות על המוצר
כמפתחים ל-Android, יש לכם הרבה אפשרויות לבחור מתוכן את הסוכנים, המודלים הגדולים של השפה (LLM), הכלים וממשקי שורת הפקודה (CLI) שבהם תשתמשו לפיתוח אפליקציות. המטרה שלנו היא לעזור לכם לפתח אפליקציות יפות ואיכותיות ל-Android, לא משנה באיזו דרך תבחרו לפתח אותן.
Simona Milanovic • משך הקריאה: 4 דקות
רוצים לקבל טיפים עדכניים לפיתוח Android ישירות לאימייל כל שבוע?