Mejora el desarrollo de Android asistido por IA y los LLM con Android Bench
Lectura de 2 min
Queremos que puedas crear apps para Android de alta calidad de forma más rápida y sencilla, y una de las formas en que te ayudamos a aumentar tu productividad es poniendo la IA a tu alcance. Sabemos que quieres una IA que realmente comprenda los matices de la plataforma de Android, por lo que hemos estado midiendo el rendimiento de los LLM en las tareas de desarrollo de Android. Hoy lanzamos la primera versión de Android Bench, nuestra tabla de clasificación oficial de LLM para el desarrollo de Android.
Nuestro objetivo es proporcionar a los creadores de modelos un benchmark para evaluar las capacidades de los LLM para el desarrollo de Android. Estableciendo un modelo de referencia claro y confiable de lo que es un desarrollo de Android de alta calidad, ayudamos a los creadores de modelos a identificar brechas y acelerar las mejoras, lo que permite a los desarrolladores trabajar de manera más eficiente con una gama más amplia de modelos útiles para elegir para la asistencia de IA, lo que, en última instancia, conducirá a apps de mayor calidad en todo el ecosistema Android.
Diseñado con tareas de desarrollo de Android del mundo real
Para crear la comparativa, seleccionamos un conjunto de tareas en una variedad de áreas comunes de desarrollo de Android. Se compone de desafíos reales de dificultad variable, que se obtienen de repositorios públicos de Android en GitHub. Entre los casos de uso, se incluyen resolver cambios rotundos en las versiones de Android, realizar tareas específicas de un dominio, como las redes en wearables, y migrar a la versión más reciente de Jetpack Compose, por nombrar algunos.
En cada evaluación, se intenta que un LLM corrija el problema informado en la tarea, que luego verificamos con pruebas de unidades o de instrumentación. Este enfoque independiente del modelo nos permite medir la capacidad de un modelo para navegar por bases de código complejas, comprender las dependencias y resolver el tipo de problemas que encuentras todos los días.
Validamos esta metodología con varios creadores de LLM, incluido JetBrains.
“Medir el impacto de la IA en Android es un desafío enorme, por lo que es genial ver un marco de trabajo tan sólido y realista. Si bien realizamos comparativas de forma activa, Android Bench es una incorporación única y bienvenida. Esta metodología es exactamente el tipo de evaluación rigurosa que los desarrolladores de Android necesitan en este momento”.
- Kirill Smelov, director de Integraciones de IA en JetBrains.
Los primeros resultados de Android Bench
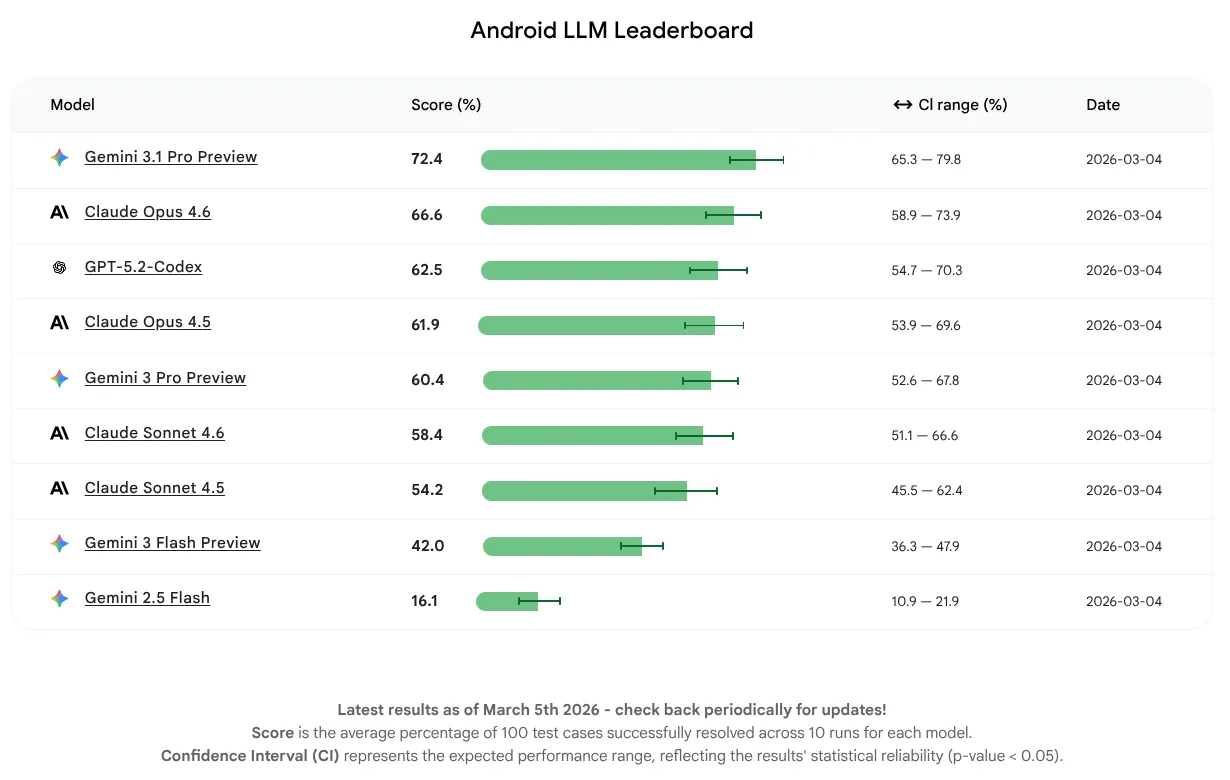
Para esta versión inicial, queríamos medir puramente el rendimiento del modelo y no enfocarnos en el uso de agentes o herramientas. Los modelos pudieron completar correctamente entre el 16% y el 72% de las tareas. Este es un rango amplio que demuestra que algunos LLM ya tienen una base sólida de conocimientos sobre Android, mientras que otros tienen más margen de mejora. Independientemente de dónde se encuentren los modelos ahora, anticipamos una mejora continua a medida que alentamos a los creadores de LLM a mejorar sus modelos para el desarrollo de Android.
El LLM con la puntuación promedio más alta para esta primera versión es Gemini 3.1 Pro, seguido de cerca por Claude Opus 4.6. Puedes probar todos los modelos que evaluamos para la asistencia de IA en tus proyectos de Android con claves de API en la versión estable más reciente de Android Studio.
Proporcionamos transparencia a los desarrolladores y creadores de LLM
Valoramos un enfoque abierto y transparente, por lo que pusimos nuestra metodología, el conjunto de datos y el agente de pruebas a disposición del público en GitHub.
Un desafío para cualquier comparativa pública es el riesgo de contaminación de datos, en el que los modelos pueden haber visto tareas de evaluación durante su proceso de entrenamiento. Tomamos medidas para garantizar que nuestros resultados reflejen un razonamiento genuino en lugar de memorización o conjeturas, incluida una revisión manual exhaustiva de las trayectorias de los agentes o la integración de una cadena canary para desalentar el entrenamiento.
De cara al futuro, seguiremos desarrollando nuestra metodología para preservar la integridad del conjunto de datos y, al mismo tiempo, realizaremos mejoras para las próximas versiones de la comparativa, por ejemplo, aumentando la cantidad y la complejidad de las tareas.
Esperamos ver cómo Android Bench puede mejorar la asistencia de IA a largo plazo. Nuestra visión es cerrar la brecha entre el concepto y el código de calidad. Estamos sentando las bases para un futuro en el que, sin importar lo que imagines, puedas crearlo en Android.
-
 Novedades de productos
Hoy, en Android Dev Summit, anunciamos la amplia disponibilidad de muchas herramientas y APIs diseñadas para eliminar las dificultades cotidianas y brindarte más flexibilidad para crear apps para Android increíbles.
Matthew McCullough • Lectura de 4 min -
 Novedades de productos
Hoy lanzamos el primer conjunto de tareas de largo horizonte (LHT), que son tareas de gran complejidad que a un ingeniero le lleva varios días o incluso una semana completar. También presentamos la evaluación de agentes, que comienza con los agentes de los proveedores de modelos correspondientes.
Matthew McCullough • Lectura de 3 min -
 Novedades de productos
Hoy lanzamos Android 17 y lo ponemos a disposición de la mayoría de los dispositivos Pixel compatibles. Busca dispositivos nuevos que ejecuten Android 17 en los próximos meses.
Matthew McCullough • Lectura de 13 min
Recibe la información más reciente sobre el desarrollo de Android en tu bandeja de entrada todas las semanas.