Ewolucja sposobu pomiaru modeli LLM na Androidzie: nowa era Android Bench
Czas czytania: 3 minuty
W marcu wprowadziliśmy Android Bench – naszą tabelę wyników LLM w przypadku rzeczywistych zadań związanych z programowaniem na Androida. Naszym celem było zapewnienie przejrzystości w zakresie możliwości modeli w programowaniu na Androida oraz zachęcenie do ich ulepszania, aby zapewnić Ci bardziej przydatne opcje AI w codziennej pracy. Od tego czasu ulepszyliśmy ten test porównawczy na podstawie Waszych opinii, m.in. oceniliśmy modele o otwartej architekturze i dodaliśmy do tabeli wyników wymiary kosztów i wydajności.
Możliwości AI stale się rozwijają, więc pomiary muszą za nimi nadążać. W ramach lipcowej wersji wprowadziliśmy platformę Harbor, która zawiera zaktualizowaną wersję agenta testowego używanego do oceny modeli.
W tej lipcowej wersji oprócz zmiany sposobu oceny dodajemy do tabeli wyników 8 nowych modeli: Claude Fable 5, Claude Sonnet 5, Claude Opus 4.8, GLM 5.2, Kimi K2.7 Code, MiniMax M3, Qwen 3.7 Plus i Qwen 3.7 Max. Udostępniamy też możliwości, dzięki którym społeczność deweloperów Androida może przyczynić się do rozwoju tego benchmarku.
Ulepszanie naszej metodologii za pomocą platformy Harbor
Projektując Android Bench, oparliśmy naszą metodologię na wiodących standardach branżowych dostępnych w tym czasie. Użyliśmy ogólnego agenta do testów porównawczych mini-swe-agent w wersji 1 i dostosowaliśmy go do niuansów programowania na Androida, aby uzyskać pomiar bazowy możliwości modeli w przypadku typowych zadań związanych z programowaniem na Androida.
Aby nadal dostarczać Ci najnowocześniejsze oceny, które dokładnie mierzą możliwości najnowszych modeli w zakresie programowania aplikacji na Androida, ujednolicamy nasz test porównawczy, dostosowując go do platformy Harbor. Harbor określa standardy i integracje, które ułatwiają każdemu przeprowadzenie testu porównawczego, ocenę preferowanej konfiguracji lub udostępnianie wyników, co zapewnia większą przejrzystość i widoczność.
Ta aktualizacja umożliwia nam dokładniejszą ocenę modeli i ich możliwości. Ponownie przeprowadziliśmy test porównawczy na wszystkich modelach, aby ustalić zaktualizowaną wartość bazową. Oznacza to niewielką zmianę w punktacji, ale nadal będziesz mieć możliwość wyświetlania historycznych wyników w archiwum w naszej witrynie.
Chcemy, aby Android Bench był dla Ciebie przydatny, dlatego będziemy go stale aktualizować w miarę rozwoju naszych ocen i branży.
Rozszerzenie tabeli wyników o 8 nowych modeli
W ramach naszego zaangażowania w utrzymywanie aktualności tabeli wyników dodaliśmy do niej modele Claude Fable 5, Claude Sonnet 5, Claude Opus 4.8, GLM 5.2, Kimi K2.7 Code, MiniMax M3, Qwen 3.7 Plus i Qwen 3.7 Max.
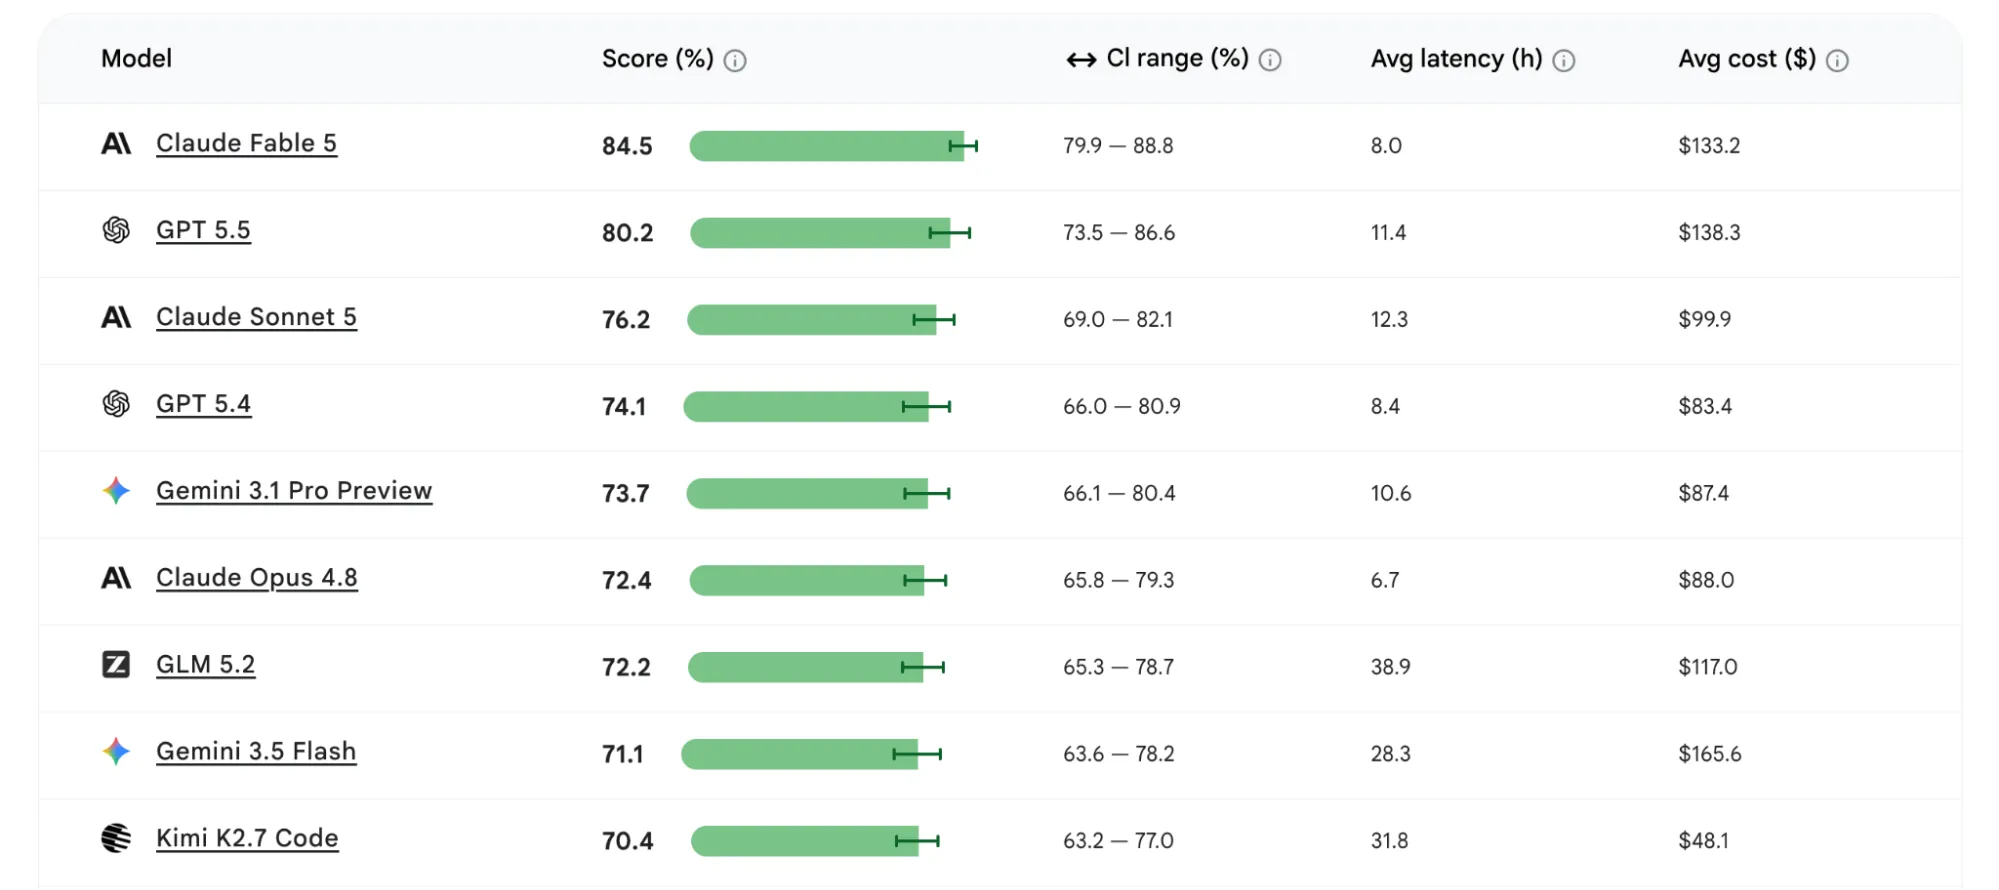
Na szczycie tabeli wyników znajduje się model Claude Fable 5 z wynikiem 84,5, a za nim GPT 5.5 z wynikiem 80,2. Na 3 miejscu jest Claude Sonnet 5 z wynikiem 76,2.
W przypadku porównania tylko modeli o otwartej architekturze na pierwszym miejscu znajduje się GLM 5.2 z wynikiem 72,2, a za nim Kimi K2.7 Code z wynikiem 70,4.
Na zaktualizowanej tablicy wyników możesz sprawdzić skuteczność i wydajność modeli, aby zobaczyć, jak radzą sobie z wyzwaniami związanymi z Androidem, takimi jak migracje Jetpack Compose, sieci na urządzeniach do noszenia i aktualizacje interfejsu API platformy.
Otwarcie Android Bench na współtworzenie przez społeczność
Od początku cenimy otwarte i przejrzyste podejście, dlatego udostępniliśmy naszą pierwotną metodologię i platformę testową publicznie w GitHubie. Poprosiliście nas o możliwość przesyłania opinii o naszym zbiorze danych, dlatego rozszerzamy współpracę i dajemy społeczności programistów na Androida szansę na kształtowanie Android Bench.
Od dziś możesz wspierać projekt Android Bench na 2 sposoby:
- Projektuj i przesyłaj własne zadania związane z tworzeniem aplikacji na Androida, aby ocenić, jak modele radzą sobie w scenariuszach, które są dla Ciebie ważne.
- Przeprowadzaj i udostępniaj oceny porównawcze, testując preferowane modele na naszym zbiorze danych lub własnych zadaniach niestandardowych.
Sprawdzimy przesłane zadania i ocenimy, czy zostaną dodane do testu porównawczego. Chcemy stworzyć punkt odniesienia, który będzie odzwierciedlać różnorodne, codzienne realia globalnej społeczności deweloperów Androida.
Co dalej
Wraz z rosnącą liczbą opcji rozwoju agentów utrzymywanie najnowocześniejszego punktu odniesienia zapewnia, że pomoc AI, na której polegasz, staje się coraz inteligentniejsza, bardziej przydatna i skuteczniejsza. Aby zapoznać się z zadaniami, otwórz nasze repozytorium GitHub. Zachęcamy do przesłania zadania do sprawdzenia przez nasz zespół. Możesz też zapoznać się z Harbor Hub, aby przejrzeć zbiór danych lub przesłać oceny.
Jak zawsze, zaktualizowaną tablicę wyników znajdziesz na naszej stronie. Możesz też zapoznać się z metodologią.
-
 Wiadomości o usługach
Dziś udostępniamy pierwszy zestaw zadań długoterminowych (LHT), czyli bardzo złożonych zadań, których wykonanie zajmuje inżynierowi kilka dni, a nawet tydzień. Wprowadzamy też ocenę agentów, zaczynając od agentów od odpowiednich dostawców modeli.
Matthew McCullough • Czas czytania: 3 minuty -
 Wiadomości o usługach
Z przyjemnością ogłaszamy stabilną wersję bibliotek AndroidX Security State 1.1.0 i Security State Provider 1.0.0.
Maunik Shah, Alec Garcia, Joseph Yong • Czas czytania: 4 minuty -
 Wiadomości o usługach
Debugowanie bezprzewodowe na Androidzie jest teraz szybsze, bardziej niezawodne i łatwiejsze w konfiguracji niż kiedykolwiek. W ADB Wi-Fi 2.0 wprowadziliśmy nowy stos serwerów i inteligentniejsze zarządzanie siecią, aby bezpośrednio uwzględnić opinie deweloperów dotyczące luk w użyteczności.
Steven Jenkins, Sherif Eid, Fabien Sanglard • Czas czytania: 1 minuta
Otrzymuj co tydzień najnowsze informacje o tworzeniu aplikacji na Androida na swoją skrzynkę odbiorczą.