从 AGP 9.2.0 开始,R8 会将大多数 Atomic*FieldUpdater 调用优化为 Unsafe 变体,从而在常见操作中将性能提升 2 到 4 倍。这对为 kotlinx.coroutines 实现原子操作的 kotlinx.atomicfu 库产生了特别大的影响,使协程的启动和取消速度提高了 2 倍。如需获享这些优势,请将 AGP 更新到 9.2.0 或更高版本。
随着大多数 Android 应用采用 Kotlin 作为首选主要语言,kotlinx.coroutines已成为异步编程的事实标准。该库提供了一种精心设计且结构化的方式来管理 Kotlin 原生的并发流。Jetpack Compose 也不例外,它采用协程来管理指针事件、动画和其他互动。在撰写本文时,Compose 中的大多数并发 API 都会在后台调用 suspend 函数,并启动和/或取消协程来处理更新。
当 Compose 团队开始调查性能问题时,发现协程是许多在组合之外发生的操作的瓶颈。例如,在创建和更新 Modifier.clickable 所花费的时间中,有 80% 的时间用于启动和取消处理 InteractionSource 更新的内部协程。基于这些观察结果,早期的大部分性能工作都集中在从默认路径中移除协程,并将初始化延迟到必要时。
协程的成本
若要分析 Android 上某个函数的内部行为,最简单的方法是捕获 Android 运行时 (ART) 方法轨迹。ART 方法轨迹是一种记录应用执行流程的工具,可准确显示调用的方法、调用顺序以及每个方法所花费的时间,从而帮助开发者找出性能瓶颈。对于空的 LaunchedEffect { } 调用,它看起来应该如下所示:
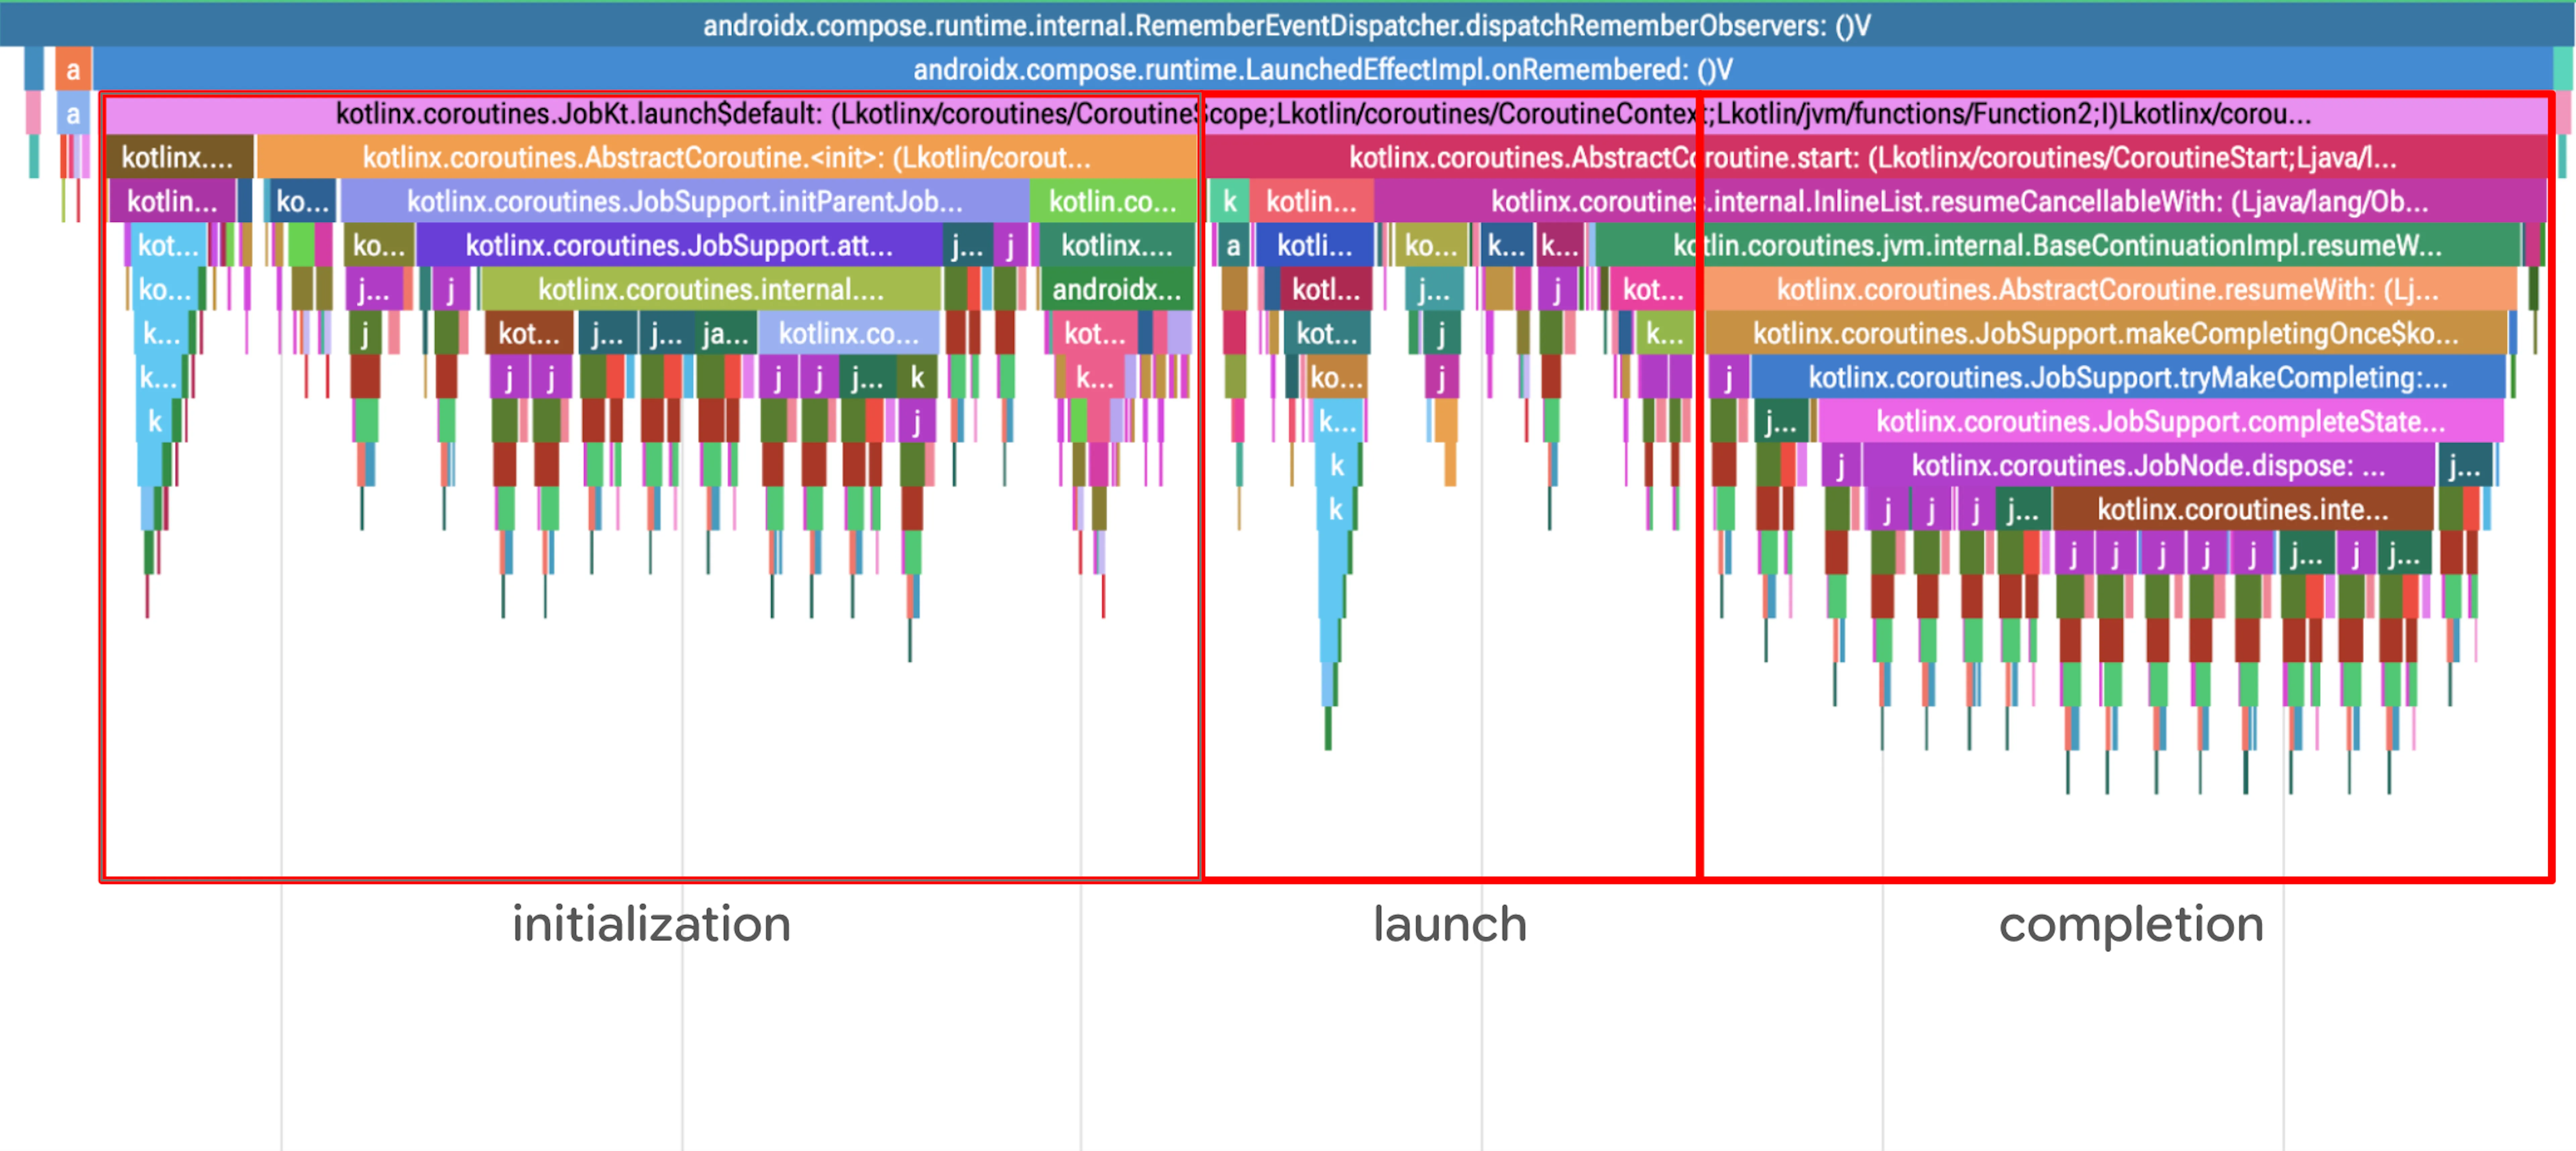
上述方法轨迹可分为三个部分:
- 初始化新协程
- 启动协程
- 正在完成协程(因为它会立即退出)
取消 LaunchedEffect 与正常完成类似,但它还会创建 CancellationException。
从上面的性能分析结果中,可以立即发现一个可疑之处,那就是频繁调用 java.util.concurrent.AtomicReferenceFieldUpdater(带有 j… 标签的紫色或绿色框)。虽然每次调用都相对较快,但频率令人担忧;分散在多次调用中的任何不可忽略的开销都可能会累积成明显的回归。放大调用后,我们发现大部分时间都花在了…反射检查上?
协程为父子关系实现了一种无锁树结构,从而实现了结构化并发。原来,kotlinx.atomicfu 库使用一个众所周知的 JVM 基元 AtomicReferenceFieldUpdater 来实现无锁原子操作。更新器使用类引用和字段名称在运行时执行原子操作,并且必须运行多项反射安全检查,以确保字段存在且可访问。协程中的每个操作(启动、挂起、取消、完成)都会调用至少一个原子操作,因此如果原子操作速度缓慢,协程的性能也会不佳。
调查 AtomicReferenceFieldUpdater
但我们先别操之过急。AtomicReferenceFieldUpdater 实际上在 JVM 上已经过 10 多年的优化,方法轨迹可能会捕获通过虚拟机级优化(即时 [JIT] 或预先 [AOT] 编译)完全消除的开销。为了验证性能,我们来编写一些基准测试,以衡量 kotlinx.atomicfu 和 java.util.concurrent.atomic 中的原子引用之间的差异。
@RunWith(AndroidJUnit4::class)
class AtomicReferenceBenchmark {
    @get:Rule
    val benchmarkRule = BenchmarkRule()

    private val atomicReference = java.util.concurrent.atomic.AtomicReference(false)
    private val atomicRef = kotlinx.atomicfu.atomic<Boolean>(false)

    @Test
    fun atomicReference_compareAndSet() {
        benchmarkRule.measureRepeated {
            atomicReference.compareAndSet(true, false)
            atomicReference.compareAndSet(false, true)
        }
    }

     @Test
    fun atomicRef_compareAndSet() {
        benchmarkRule.measureRepeated {
            atomicRef.compareAndSet(true, false)
            atomicRef.compareAndSet(false, true)
        }
    }

    /* measuring other methods from the method traces above */
}
在 Pixel 5 上运行此基准(同时确保在预热期间对 AtomicReferenceFieldUpdater#compareAndSet 进行 JIT 编译),在 Pixel 5 (API 33) 上会产生以下结果:
 50.7 ns  atomicReference_compareAndSet
135   ns  atomicRef_compareAndSet
测量结果证实了这一差距,kotlinx.atomicfu 版本明显慢了大约 2.7 倍。这证实了 ART 不会执行任何隐藏的优化,并且反射访问检查会在运行时增加实际开销。
回顾原始方法轨迹,AtomicReferenceFieldUpdater 执行的唯一有意义的工作是对 Unsafe.getObjectVolatile 的内部调用,该调用实际上执行了底层原子操作。在大多数情况下,更新程序初始化程序是静态的,并且可以根据周围类的结构证明始终正确。因此,可以静态分析大多数 AtomicReferenceFieldUpdater 用法,并在编译期间将其替换为内部 Unsafe 变体。Android 构建工具链也恰好有自己的优化编译器,可以做到这一点。
使用 R8 进行优化
Atomic*FieldUpdater 类支持细微、动态和基于反射的使用,但通常用于静态明显的模式。这既解释了基准性能缓慢的原因,也说明了优化的必要性。R8 是一款全程序优化编译器,非常适合通过更简单的模式来减少反射安全检查的开销。R8 在 Java 或 Kotlin 编译器之后接收 JVM 字节码,但为了便于阅读,这些示例以 Java 语法呈现。这就是为什么 AtomicReferenceFieldUpdater 没有类型实参的原因。
class Example {
    volatile String data = "";
    static final AtomicReferenceFieldUpdater updater =
        AtomicReferenceFieldUpdater.newUpdater(Example.class, String.class, "data");

    void example() {
        // ...
        updater.compareAndSet(this, "", "new");
        // ...
    }
}
基本示例创建了一个静态 final 更新器,该更新器使用简单的常量参数(用于持有者、类型和字段名称)访问 volatile 字段。所用的反射完全透明。可以清楚地看到,此更新程序引用了有效字段,并且更新程序创建位置对该字段具有有效访问权限。
从本质上讲,Atomic*FieldUpdater 是对字段偏移量和对 Unsafe 的调用的封装容器。最佳优化方案是将更新器字段替换为偏移字段,并将更新器调用替换为对 Unsafe 的调用。
优化 Atomic*FieldUpdater
优化分三个部分实施:插桩、替换和清理。
插桩
第一步是引入偏移字段和更新程序字段,以便通过 Unsafe 调用直接访问。
static final long updater$offset =
    SyntheticUnsafe.UNSAFE.objectFieldOffset(Example.class.getDeclaredField("data"))
该字段通过反射进行访问,并使用 Unsafe 提取类中的字段偏移量。如果您不考虑反射验证,此代码表示 Atomic*FieldUpdater 的内部。相反,更新器的持有者类型和 volatile 字段的字段类型会在编译器中静态跟踪。
请注意,原始字段及其初始化保持原样。优化过程会乐观地促进和优化使用,然后进行清理。这是一种简单的实现方法,但也允许对更新器字段进行部分优化,其中一些用法保持原样,而另一些用法则进行了优化。
替换
在编译器中的这个阶段,在合适的并发联接点之后,我们会有一个插桩更新器字段列表。这意味着,我们可以根据一些条件单独优化每个调用点。请参考以下示例调用:
updater.compareAndSet(holder, expectedValue, newValue);
Atomic*FieldUpdater 要求的条件如下:
updater是否来自插桩字段?也就是说,静态分析能否将对象的值追溯到插桩更新器的字段读取?holder是最初定义的持有者类型还是其子类?newValue是否与最初定义的字段类型属于同一类或子类?
如果满足所有条件,则该调用会被替换为对 Unsafe 的调用,而无需进行任何反射检查。
SyntheticUnsafe.UNSAFE.compareAndSwapObject(holder, Example.updater$offset, expectedValue, newValue)
这个新调用速度更快、更简单,但与原始调用在处理 updater 和 holder 中的 null 值方面有所不同。除非静态排除,否则系统会为两者插入 null 检查。
清理
此时,持有类具有原始更新器字段和新偏移量字段,以及可能使用其中一个字段的调用网站。如果所有调用点均未优化,则应移除 offset 字段;如果所有调用点均已优化,则应移除 updater 字段。在这两种情况下,初始化调用也应一并删除。编译器已经完成了未使用字段的删除和死代码的移除,但要移除此处的初始化代码,还需要一些技巧。
对 newUpdater 和 getDeclaredField 的调用都可能会产生副作用,因为它们可能会抛出异常(并且其实现也未知,因为它取决于 API 版本)。这意味着,通过通用优化,无法安全地移除它们。因此,此清理工作需要明确考虑插桩字段,因为这些字段在静态上已知没有异常。
最后,上面显示的简单更新程序示例在优化后如下所示:
结果
经过这些优化后,kotlinx.atomicfu 和大多数显式使用 AtomicInt/Long/ReferenceFieldUpdater 的情况现在都与应用 R8 后的 AtomicReference 性能相当。事实上,在某些基准测试中,它的速度甚至更快;kotlinx.atomicfu 有一个编译器插件,可以将 atomic 实例内嵌到字段中,从而减少创建原子更新字段所需的分配。
Jetpack Compose 是这项工作的主要受益者。Compose 运行时具有许多微基准,这些微基准会密切跟踪协程性能,以便尽早发现性能下降。当基准测试更新到新版 R8 时,我们注意到在 LaunchedEffect 中启动和取消协程时,性能提升了 2 倍!
除此之外,ART 团队正在虚拟机级别原生实现这些优化。如果您的应用以 API 36 为目标平台,并且在搭载近期 Android 版本的设备上运行,那么您的设备可能已经以类似的方式优化了协程。在最近版本的 ART 中进行 JIT 更新后,上述协程基准测试观察到性能提升了约 15%。
升级到 AGP 9.2.0 或直接使用 R8 9.2.0 后,您的应用将默认获得此优化。如需了解详情,请参阅 D8 dexer 和 R8 缩减器。
-
 案例研究
Grab 是东南亚领先的超级应用,通过单一应用为八个国家/地区的数百万用户提供配送、出行和金融服务。
Ajesh Pai, Nguyen Van Minh, Tracy Agyemang • 阅读用时:5 分钟 -
 案例研究
该团队构建了一个 AI 原生界面代码库,其规模比原始实现缩小了 50%,同时将 AI 智能体执行时间缩短了 35%,工程师与智能体之间的交互减少了 32%,并将 token 成本降低了 33%。
Pavlo Stavytskyi, Rebecca Franks • 预计阅读时间:11 分钟 -
 案例研究
WhatsApp 是全球最大的即时通讯平台,为全球数十亿用户提供服务。它是不同地区用户的默认通讯工具,通过私密、可靠且安全的即时通讯服务连接用户。
Niharika Arora, Tracy Agyemang, Mayank Jain • 阅读用时:8 分钟
每周通过电子邮件接收最新的 Android 开发洞见。