AGP 9.2.0 以降、R8 はほとんどの Atomic*FieldUpdater 呼び出しを Unsafe バリアントに最適化し、一般的なオペレーションで 2 ~ 4 倍のパフォーマンス向上を実現します。これは、kotlinx.coroutines のアトミックを実装する kotlinx.atomicfu ライブラリに特に大きな影響を与え、コルーチンの起動とキャンセルが最大 2 倍高速になります。このメリットを得るには、AGP を 9.2.0 以降に更新してください。
ほとんどの Android アプリが Kotlin をメインの言語として採用しているため、kotlinx.coroutines は非同期プログラミングのデファクト スタンダードとなっています。このライブラリは、Kotlin にネイティブな同時実行フローを管理するための、適切に設計された構造化された方法を提供します。Jetpack Compose も例外ではなく、ポインタイベント、アニメーション、その他のインタラクションの管理にコルーチンを採用しています。この記事の執筆時点で、Compose のほとんどの同時実行 API は、内部で suspend 関数を呼び出し、コルーチンを起動またはキャンセルして更新を処理しています。
Compose チームがパフォーマンスの調査を開始したところ、コンポジション外で行われる多くのオペレーションでコルーチンがボトルネックになっていることが判明しました。たとえば、Modifier.clickable の作成と更新に費やされた時間の 80% は、InteractionSource の更新を処理する内部コルーチンの起動とキャンセルに費やされていました。これらの観察結果に基づき、初期のパフォーマンス作業の多くは、デフォルトのパスからコルーチンを削除し、必要になるまで初期化を遅らせることに重点を置いていました。
コルーチンのコスト
Android で関数の内部動作を分析する最も簡単な方法は、Android ランタイム(ART)メソッド トレースをキャプチャすることです。ART メソッド トレースは、アプリの実行フローを記録するツールです。呼び出されたメソッド、その順序、各メソッドに費やされた時間を正確に表示することで、デベロッパーがパフォーマンスのボトルネックを特定できるようにします。空の LaunchedEffect { } 呼び出しの場合は、次のようになります。
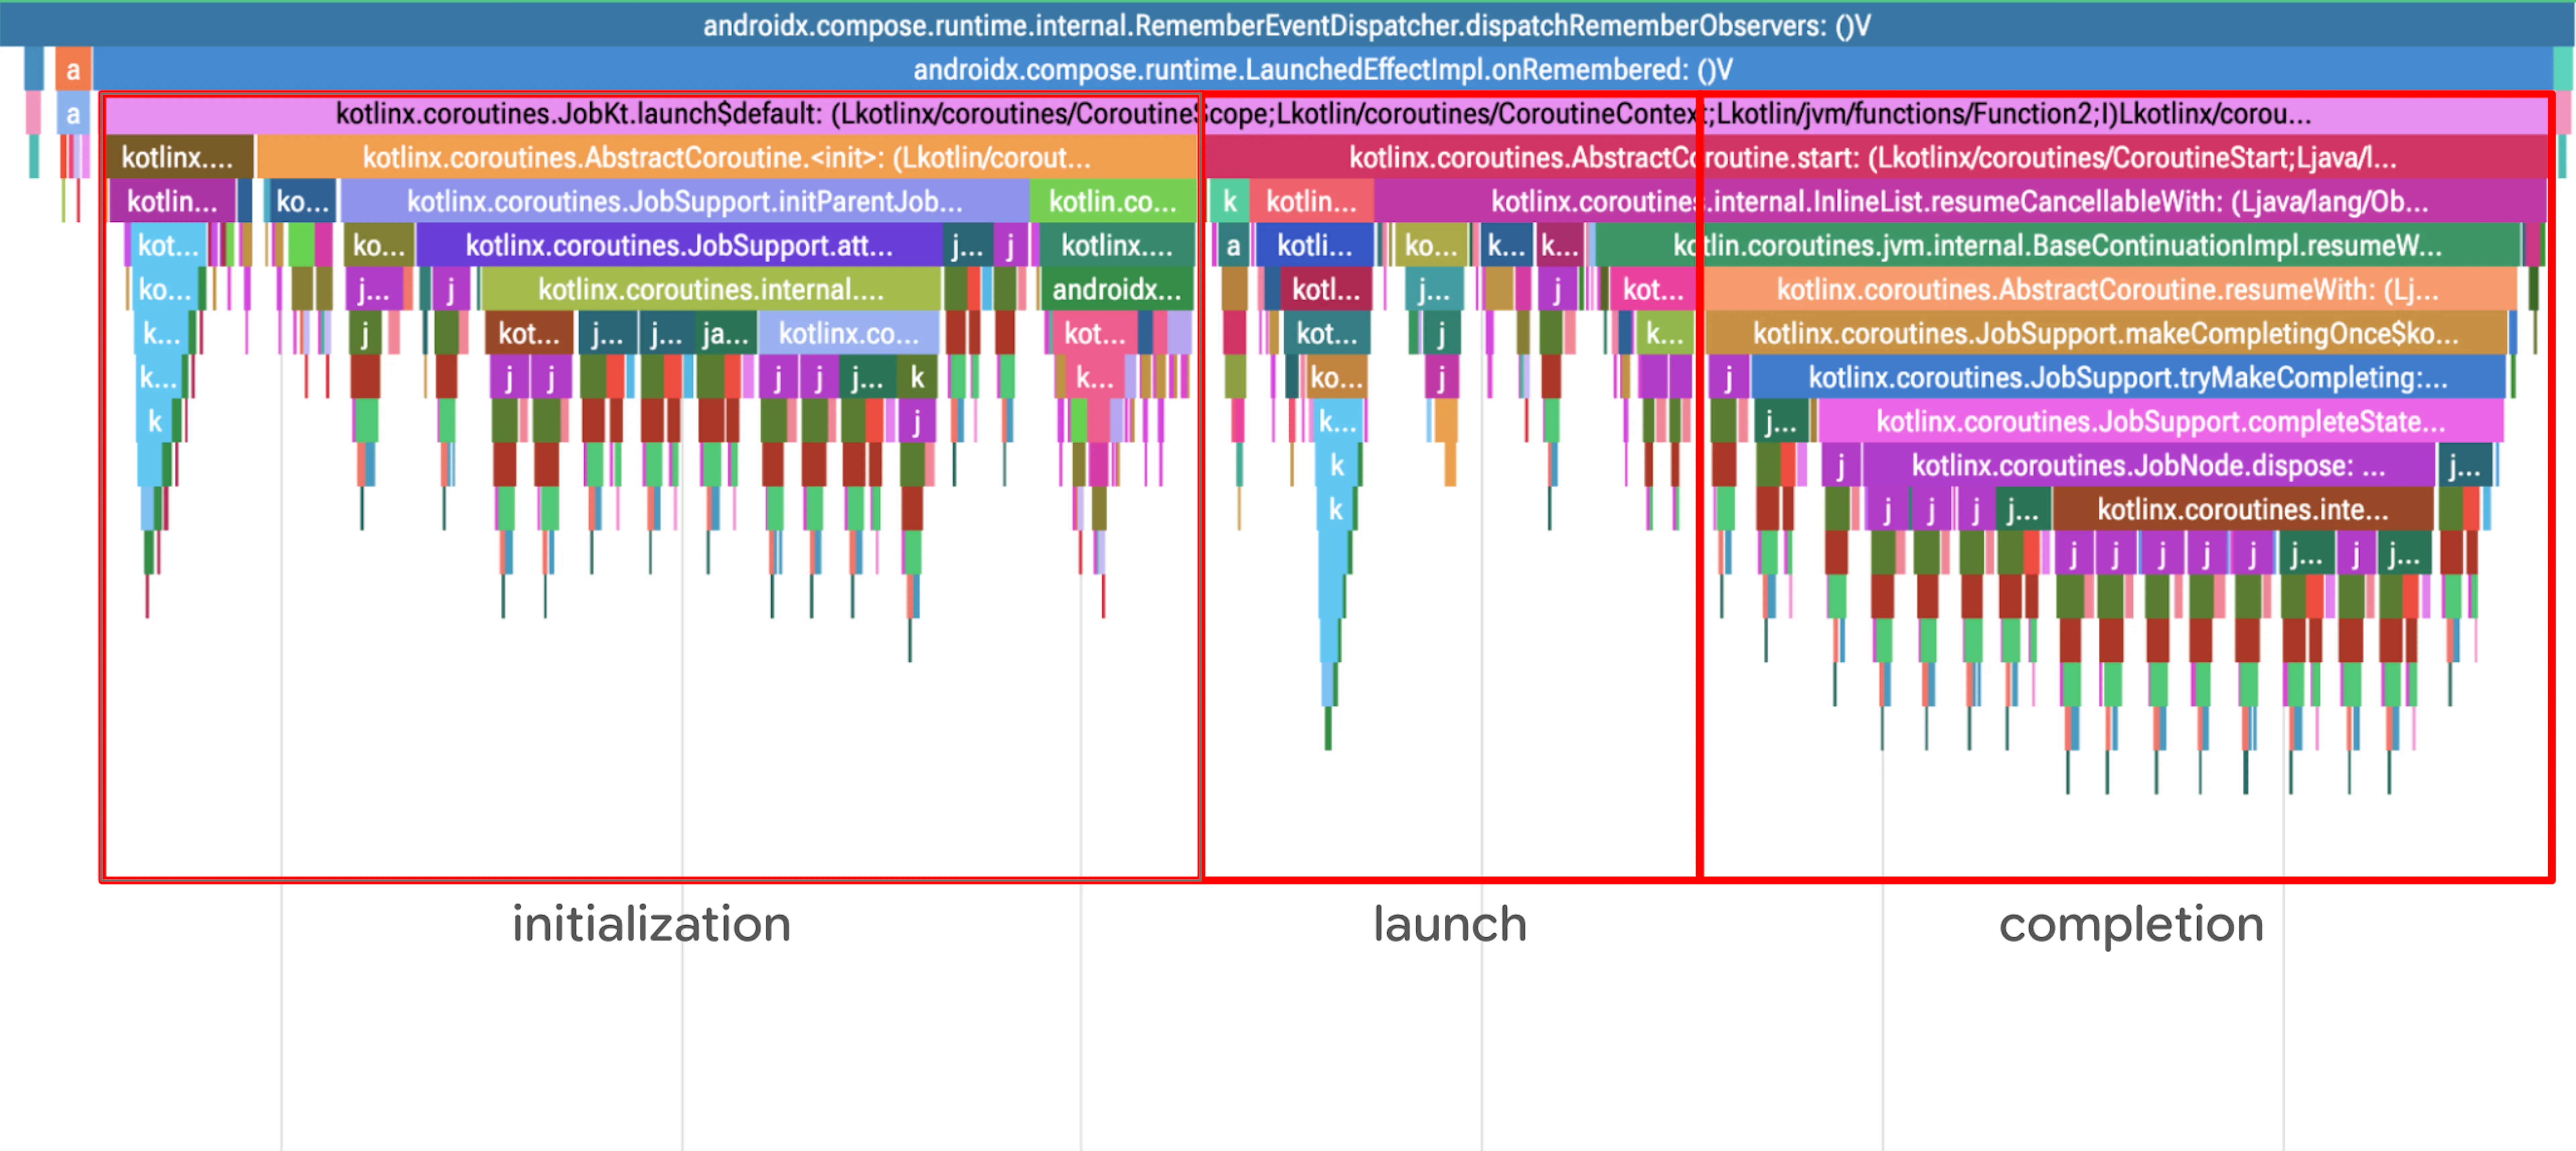
上記のメソッド トレースは、次の 3 つの部分に分けることができます。
- 新しいコルーチンを初期化する
- コルーチンの開始
- コルーチンを完了する(すぐに終了するため)
LaunchedEffect のキャンセルは、CancellationException も作成される点を除いて、通常の完了と似ています。
上記のプロファイルから、すぐに不審な点として挙げられるのは、java.util.concurrent.AtomicReferenceFieldUpdater(j… ラベルが付いた紫または緑のボックス)への頻繁な呼び出しです。各呼び出しは比較的速いものの、頻度が懸念されます。複数の呼び出しに分散された無視できないオーバーヘッドが、顕著な回帰につながる可能性があります。呼び出しを拡大すると、ほとんどの時間がリフレクション チェックに費やされていることがわかります。
コルーチンは、構造化された同時実行を可能にする親子関係のロックフリー ツリー構造を実装します。kotlinx.atomicfu ライブラリは、よく知られた JVM プリミティブである AtomicReferenceFieldUpdater を使用して、ロックフリーのアトミック オペレーションを実装していることがわかりました。アップデータは、クラス参照とフィールド名を使用して実行時にアトミック オペレーションを実行します。また、フィールドが存在し、アクセス可能であることを確認するために、いくつかのリフレクション セーフティ チェックを実行する必要があります。コルーチンの各オペレーション(開始、一時停止、キャンセル、完了)は、少なくとも 1 つのアトミック オペレーションを呼び出すため、処理が遅いと、コルーチンのパフォーマンスが低下します。
AtomicReferenceFieldUpdater の調査
しかし、先を急ぐのはやめましょう。AtomicReferenceFieldUpdater は、実際には JVM で10 年以上にわたって十分に最適化されています。メソッド トレースでは、VM レベルの最適化(ジャストインタイム(JIT)コンパイルまたは事前(AOT)コンパイル)によって完全に削除されるオーバーヘッドがキャプチャされることがあります。パフォーマンスを検証するために、いくつかのベンチマークを作成して、kotlinx.atomicfu と java.util.concurrent.atomic のアトミック参照の違いを測定してみましょう。
@RunWith(AndroidJUnit4::class)
class AtomicReferenceBenchmark {
    @get:Rule
    val benchmarkRule = BenchmarkRule()

    private val atomicReference = java.util.concurrent.atomic.AtomicReference(false)
    private val atomicRef = kotlinx.atomicfu.atomic<Boolean>(false)

    @Test
    fun atomicReference_compareAndSet() {
        benchmarkRule.measureRepeated {
            atomicReference.compareAndSet(true, false)
            atomicReference.compareAndSet(false, true)
        }
    }

     @Test
    fun atomicRef_compareAndSet() {
        benchmarkRule.measureRepeated {
            atomicRef.compareAndSet(true, false)
            atomicRef.compareAndSet(false, true)
        }
    }

    /* measuring other methods from the method traces above */
}
このベンチマークを Google Pixel 5 で実行すると(ウォームアップ中に AtomicReferenceFieldUpdater#compareAndSet が JIT コンパイルされるようにする)、Google Pixel 5(API 33)で次の結果が得られます。
 50.7 ns  atomicReference_compareAndSet
135   ns  atomicRef_compareAndSet
測定結果から、kotlinx.atomicfu バージョンが約 2.7 倍遅いことが確認されました。これは、ART が隠れた最適化を行わず、リフレクション アクセス チェックが実行時に実際のオーバーヘッドを追加することを示しています。
元のメソッド トレースを振り返ると、AtomicReferenceFieldUpdater によって実行される意味のある処理は、基盤となるアトミック オペレーションを実際に実行する Unsafe.getObjectVolatile への内部呼び出しのみです。ほとんどの場合、アップデータ初期化子は静的であり、周囲のクラスの構造に基づいて常に正しいことが証明されます。そのため、AtomicReferenceFieldUpdater の使用状況のほとんどを静的に分析し、コンパイル時に内部の Unsafe バリアントに置き換えることができます。また、Android ビルド ツールチェーンには、まさにそれを実行できる独自の最適化コンパイラがあります。
R8 を使用した最適化
Atomic*FieldUpdater クラスは、微妙な、動的な、リフレクション ベースの使用をサポートしますが、静的に明らかなパターンで使用されることがよくあります。これは、ベースライン パフォーマンスが遅いことと、最適化が必要なことの両方を説明しています。R8 はプログラム全体を最適化するコンパイラであり、よりシンプルなパターンを見抜いて、リフレクションによる安全性チェックのオーバーヘッドを削減するのに適しています。R8 は Java または Kotlin コンパイラの後で JVM バイトコードを受け取りますが、読みやすくするために、これらの例は Java 構文で示されています。そのため、AtomicReferenceFieldUpdater には型引数がありません。
class Example {
    volatile String data = "";
    static final AtomicReferenceFieldUpdater updater =
        AtomicReferenceFieldUpdater.newUpdater(Example.class, String.class, "data");

    void example() {
        // ...
        updater.compareAndSet(this, "", "new");
        // ...
    }
}
基本の例では、静的な final アップデータを作成し、ホルダー、型、フィールド名の単純な定数引数を使用して volatile フィールドにアクセスします。使用されている反射は完全に透明です。このアップデータが有効なフィールドを参照していること、およびアップデータ作成のサイトがフィールドへの有効なアクセス権を持っていることは明らかです。
本質的に、Atomic*FieldUpdater はフィールド オフセットと Unsafe の呼び出しをラップするものです。最適化の最善のシナリオは、アップデータ フィールドをオフセット フィールドに置き換え、アップデータ呼び出しを Unsafe の呼び出しに置き換えることです。
Atomic*FieldUpdater の最適化
最適化は、インストルメンテーション、置換、クリーンアップの 3 つの部分で実装されます。
インストゥルメンテーション
最初のステップは、Unsafe 呼び出しを介した直接アクセスを容易にするために、アップデータ フィールドとともにオフセット フィールドを導入することです。
static final long updater$offset =
    SyntheticUnsafe.UNSAFE.objectFieldOffset(Example.class.getDeclaredField("data"))
このフィールドにはリフレクションを介してアクセスし、Unsafe を使用してクラスのフィールド オフセットを抽出します。このコードは、リフレクション検証を無視した場合の Atomic*FieldUpdater の内部を表しています。代わりに、アップデータのホルダータイプと volatile フィールドのフィールド タイプがコンパイラで静的に追跡されます。
元のフィールドとその初期化はそのまま残ります。最適化プロセスでは、使用を楽観的に促進して最適化し、後でクリーンアップします。これは実装に対するシンプルなアプローチですが、更新フィールドの部分的な最適化も可能であり、一部の用途はそのままにして、他の用途を最適化できます。
交換
コンパイラのこの時点では、適切な同時実行結合ポイントの後に、インストルメント化されたアップデータ フィールドのリストがあります。つまり、いくつかの条件に基づいて、各呼び出しサイトを個別に最適化できます。呼び出しの例を考えてみましょう。
updater.compareAndSet(holder, expectedValue, newValue);
Atomic*FieldUpdater が必要とする条件は次のとおりです。
updaterはインストルメント化されたフィールドから取得されますか?つまり、静的分析でオブジェクトの値を、インストルメント化されたアップデータのフィールド読み取りまで追跡できるかどうかです。holderは、最初に定義されたホルダータイプと同じクラスまたはサブクラスですか?newValueは、最初に定義されたフィールド タイプと同じクラスまたはサブクラスですか?
すべての条件が満たされている場合、呼び出しはリフレクション チェックなしで Unsafe への呼び出しに置き換えられます。
SyntheticUnsafe.UNSAFE.compareAndSwapObject(holder, Example.updater$offset, expectedValue, newValue)
この新しい呼び出しは、より高速でシンプルですが、updater と holder の null 値の処理に関して元の呼び出しとは異なります。静的に除外されていない限り、両方に null チェックが挿入されます。
クリーンアップ
この時点で、保持クラスには元のアップデータ フィールドと新しいオフセット フィールドがあり、どちらか一方を使用する可能性のある呼び出しサイトもあります。呼び出しサイトが最適化されていない場合は、オフセット フィールドを削除する必要があります。すべての呼び出しサイトが最適化されている場合は、アップデータ フィールドを削除する必要があります。どちらの場合も、初期化呼び出しも削除する必要があります。未使用のフィールドの削除とデッドコードの削除は、コンパイラですでに行われていますが、ここで初期化コードを削除するには、さらにいくつかの工夫が必要です。
newUpdater と getDeclaredField の呼び出しは、例外をスローする可能性があるため、副作用が生じる可能性があります(また、API バージョンに依存するため、実装も不明です)。つまり、一般的な最適化では、安全に削除できません。そのため、このクリーンアップでは、インストルメント化されたフィールドを明示的に考慮する必要がありました。これらのフィールドは、例外がないことが静的にわかっているためです。
最終的に、上記のシンプルなアップデータの例は、最適化後に次のようになります。
結果
これらの最適化により、kotlinx.atomicfu と AtomicInt/Long/ReferenceFieldUpdater のほとんどの明示的な使用は、R8 を適用した AtomicReference のパフォーマンスと一致するようになりました。実際、一部のベンチマークではさらに高速です。kotlinx.atomicfu には、atomic インスタンスをフィールドにインライン化できるコンパイラ プラグインがあり、アトミックに更新されるフィールドの作成に必要な割り当てを削減できます。
この取り組みの主な受益者は Jetpack Compose でした。Compose ランタイムには、コルーチンのパフォーマンスを非常に細かく追跡してパフォーマンスの低下を早期に検出するマイクロベンチマークが多数用意されています。ベンチマークを R8 の新しいバージョンに更新したところ、LaunchedEffect でコルーチンを起動してキャンセルする際のパフォーマンスが 2 倍向上していることがわかりました。
これとは別に、ART チームはこれらの最適化を VM レベルでネイティブに実装しています。アプリが API 36 をターゲットとし、最近のバージョンの Android で実行されている場合、デバイスはすでに同様の方法でコルーチンを最適化している可能性があります。上記のコルーチン ベンチマークでは、最近のバージョンの ART で JIT が更新された後、パフォーマンスが約 15% 向上したことが確認されています。
AGP 9.2.0 にアップグレードするか、R8 9.2.0 を直接使用すると、アプリにこの最適化がデフォルトで適用されます。詳しくは、D8 dexer と R8 shrinker をご覧ください。
-
 事例紹介
銀行や SIM 登録用の本人確認アプリでは、なりすましやディープフェイクを検出するために、鮮明で高解像度の顔画像が必要です。ライブネス チェックやなりすまし防止チェックに十分な鮮明さのフレームを、メモリの少ないデバイスをクラッシュさせることなくキャプチャすることは、Android カメラ デベロッパーにとって共通の課題です。
Donovan McMurray • 所要時間: 4 分 -
 事例紹介
Grab は、東南アジアを代表するスーパーアプリです。1 つのアプリで、8 か国の数百万人のユーザーにデリバリー、モビリティ、金融サービスを提供しています。
Ajesh Pai, Nguyen Van Minh, Tracy Agyemang • 所要時間: 5 分 -
 事例紹介
チームは、元の実装よりも 50% 小さい AI ネイティブの UI コードベースを構築し、AI エージェントの実行時間を 35% 短縮、エンジニアとエージェントのやり取りを 32% 削減、トークン費用を 33% 削減しました。
Pavlo Stavytskyi, Rebecca Franks • 所要時間: 11 分
Android 開発に関する最新の分析情報を毎週メールでお届けします。