في الإصدار 17 من نظام التشغيل Android، ستتلقّى التطبيقات التي تستهدف الإصدار 37 من حزمة تطوير البرامج (SDK) أو إصدارًا أحدث عملية تنفيذ جديدة لـ MessageQueue لا تتطلّب قفلًا. يحسّن التنفيذ الجديد الأداء ويقلّل من اللقطات التي لم يتم عرضها، ولكن قد يؤدي إلى تعطُّل العملاء الذين يستخدمون الحقول والأساليب الخاصة في MessageQueue. لمزيد من المعلومات عن تغيير السلوك وكيفية الحدّ من تأثيره، اطّلِع على مستندات تغيير سلوك MessageQueue. تقدّم مشاركة المدونة الفنية هذه نظرة عامة على إعادة تصميم MessageQueue وكيفية تحليل مشاكل تعارض القفل باستخدام Perfetto.
يُشغّل Looper سلسلة واجهة المستخدم لكل تطبيق Android. يستردّ العمل من MessageQueue، ويرسله إلى Handler، ويكرّر العملية. على مدار عقدَين من الزمن، استخدمت MessageQueue قفل شاشة واحدًا (أي مجموعة رموز synchronized) لحماية حالتها.
يقدّم الإصدار Android 17 تحديثًا مهمًا لهذا المكوّن، وهو تنفيذ خالٍ من الأقفال يُسمّى DeliQueue.
توضّح هذه المشاركة كيف تؤثّر عمليات القفل في أداء واجهة المستخدم، وكيفية تحليل هذه المشاكل باستخدام أداة Perfetto، والخوارزميات وعمليات التحسين المحدّدة المستخدَمة لتحسين سلسلة التعليمات الرئيسية في Android.
المشكلة: تعارض القفل وعكس الأولوية
كانت وظيفة MessageQueue تعمل كقائمة انتظار ذات أولوية محمية بقفل واحد. إذا نشرت سلسلة محادثات في الخلفية رسالة أثناء إجراء سلسلة المحادثات الرئيسية لصيانة قائمة الانتظار، ستحظر سلسلة المحادثات في الخلفية سلسلة المحادثات الرئيسية.
عندما تتنافس سلسلتان أو أكثر من سلاسل التعليمات البرمجية على الاستخدام الحصري للقفل نفسه، يُطلق على ذلك التنازع على القفل. يمكن أن يؤدي هذا التنازع إلى انعكاس الأولوية، ما يؤدي إلى حدوث إيقاف مؤقت لعرض واجهة المستخدم ومشاكل أخرى في الأداء.
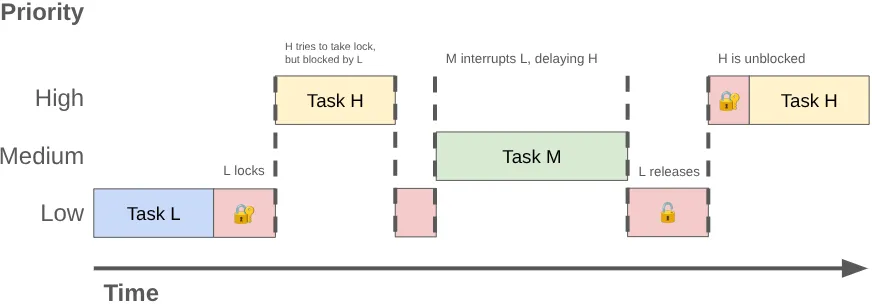
يمكن أن تحدث مشكلة "قلب الأولويات" عندما يتم إجبار سلسلة تعليمات ذات أولوية عالية (مثل سلسلة واجهة المستخدم) على انتظار سلسلة تعليمات ذات أولوية منخفضة. لنفترض التسلسل التالي:
- يحصل مؤشر ترابط الخلفية منخفض الأولوية على قفل
MessageQueueلنشر نتيجة العمل الذي نفّذه. - يصبح سلسلة التعليمات ذات الأولوية المتوسطة قابلة للتنفيذ ويخصّص لها برنامج جدولة النواة وقتًا لوحدة المعالجة المركزية، ما يؤدي إلى إيقاف سلسلة التعليمات ذات الأولوية المنخفضة.
- تُنهي سلسلة تعليمات واجهة المستخدم ذات الأولوية العالية مهمتها الحالية وتحاول القراءة من قائمة الانتظار، ولكن يتم حظرها لأنّ سلسلة التعليمات ذات الأولوية المنخفضة تحتفظ بدالة الاستبعاد المتبادل.
تحظر سلسلة التعليمات ذات الأولوية المنخفضة سلسلة واجهة المستخدم، ويؤدي العمل ذو الأولوية المتوسطة إلى تأخيرها أكثر.
تحليل التنازع باستخدام Perfetto
يمكنك تشخيص هذه المشاكل باستخدام Perfetto. في عملية تتبُّع عادية، ينتقل مؤشر الترابط المحظور على قفل الشاشة إلى حالة السكون، ويعرض Perfetto شريحة تشير إلى مالك القفل.
عند طلب بيانات التتبُّع، ابحث عن شرائح باسم "مراقبة التعارض مع …" متبوعة باسم سلسلة المحادثات التي تملك القفل وموقع الرمز البرمجي الذي تم فيه الحصول على القفل.
دراسة حالة: بطء "مشغّل التطبيقات"
لتوضيح ذلك، لنحلّل تتبُّعًا واجه فيه المستخدم إيقافًا مؤقتًا لعرض واجهة المستخدم أثناء التنقّل إلى الشاشة الرئيسية على هاتف Pixel بعد التقاط صورة مباشرةً في تطبيق الكاميرا. في ما يلي لقطة شاشة من Perfetto تعرض الأحداث التي أدّت إلى عدم عرض الإطار:
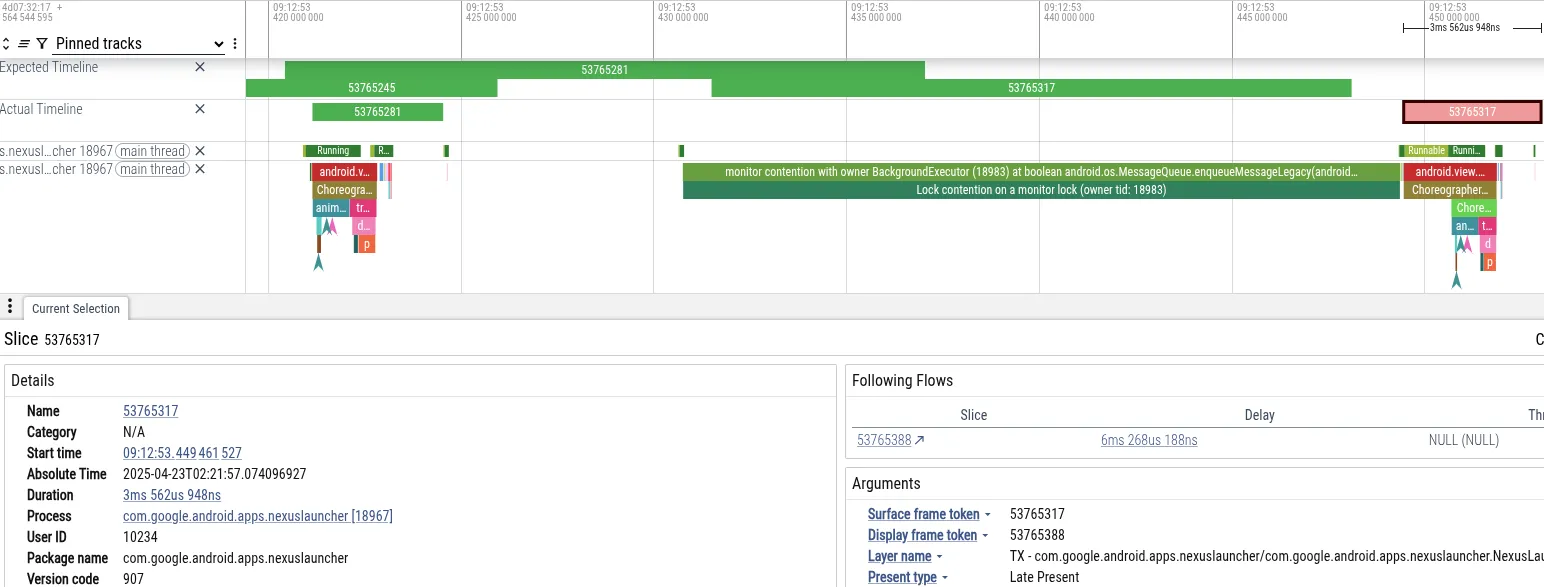
- العَرَض: لم يتمكّن مؤشر ترابط Launcher الرئيسي من الالتزام بالموعد النهائي لعرض اللقطة. تم حظرها لمدة 18 ملي ثانية، وهو ما يتجاوز المهلة البالغة 16 ملي ثانية المطلوبة للعرض بمعدل 60 لقطة في الثانية.
- التشخيص: أظهرت أداة Perfetto أنّ سلسلة التعليمات الرئيسية محظورة على القفل
MessageQueue. كانت سلسلة محادثات BackgroundExecutor تملك القفل. - السبب الأساسي: يتم تشغيل BackgroundExecutor على Process.THREAD_PRIORITY_BACKGROUND (أولوية منخفضة جدًا). نفّذت مهمة غير عاجلة (التحقّق من المدد القصوى لاستخدام التطبيقات). في الوقت نفسه، كانت سلاسل العمل ذات الأولوية المتوسطة تستخدم وقت وحدة المعالجة المركزية لمعالجة البيانات من الكاميرا. أوقف برنامج جدولة نظام التشغيل مؤقتًا سلسلة BackgroundExecutor لتشغيل سلاسل الكاميرا.
تسبّب هذا التسلسل في حظر سلسلة واجهة المستخدم في Launcher (أولوية عالية) بشكل غير مباشر من خلال سلسلة الوحدات العاملة (worker thread) في الكاميرا (أولوية متوسطة)، ما منع سلسلة الخلفية في Launcher (أولوية منخفضة) من تحرير القفل.
الاستعلام عن عمليات التتبُّع باستخدام PerfettoSQL
يمكنك استخدام PerfettoSQL للاستعلام عن بيانات التتبُّع بحثًا عن أنماط معيّنة. يكون هذا الإجراء مفيدًا إذا كان لديك مجموعة كبيرة من عمليات التتبُّع من أجهزة المستخدمين أو الاختبارات، وكنت تبحث عن عمليات تتبُّع معيّنة توضّح مشكلة.
على سبيل المثال، يعثر طلب البحث هذا على MessageQueue التنازع المتزامن مع اللقطات التي تم إسقاطها (التقطّع):
INCLUDE PERFETTO MODULE android.monitor_contention;
INCLUDE PERFETTO MODULE android.frames.jank_type;

SELECT
  process_name,
  -- Convert duration from nanoseconds to milliseconds
  SUM(dur) / 1000000 AS sum_dur_ms,
  COUNT(*) AS count_contention
FROM android_monitor_contention
WHERE is_blocked_thread_main
AND short_blocked_method LIKE "%MessageQueue%"

-- Only look at app processes that had jank
AND upid IN (
  SELECT DISTINCT(upid)
  FROM actual_frame_timeline_slice
  WHERE android_is_app_jank_type(jank_type) = TRUE
)
GROUP BY process_name
ORDER BY SUM(dur) DESC;
في هذا المثال الأكثر تعقيدًا، ادمج بيانات التتبُّع التي تتضمّن جداول متعددة لتحديد تعارض MessageQueue أثناء بدء تشغيل التطبيق:
INCLUDE PERFETTO MODULE android.monitor_contention;
INCLUDE PERFETTO MODULE android.startup.startups;

-- Join package and process information for startups
DROP VIEW IF EXISTS startups;
CREATE VIEW startups AS
SELECT startup_id, ts, dur, upid
FROM android_startups
JOIN android_startup_processes USING(startup_id);

-- Intersect monitor contention with startups in the same process.
DROP TABLE IF EXISTS monitor_contention_during_startup;
CREATE VIRTUAL TABLE monitor_contention_during_startup
USING SPAN_JOIN(android_monitor_contention PARTITIONED upid, startups PARTITIONED upid);

SELECT
  process_name,
  SUM(dur) / 1000000 AS sum_dur_ms,
  COUNT(*) AS count_contention
FROM monitor_contention_during_startup
WHERE is_blocked_thread_main
AND short_blocked_method LIKE "%MessageQueue%"
GROUP BY process_name
ORDER BY SUM(dur) DESC;
يمكنك استخدام "النموذج اللغوي الكبير" المفضّل لديك لكتابة طلبات بحث PerfettoSQL للعثور على أنماط أخرى.
في Google، نستخدم BigTrace لتشغيل طلبات بحث PerfettoSQL على ملايين عمليات التتبُّع. ومن خلال ذلك، تأكّدنا من أنّ ما لاحظناه بشكل غير رسمي كان في الواقع مشكلة منهجية. كشفت البيانات أنّ MessageQueue تأثير تعارض الأقفال يطال المستخدمين في جميع أنحاء المنظومة المتكاملة، ما يؤكّد الحاجة إلى تغيير أساسي في البنية.
الحلّ: التزامن بدون قفل
لقد عالجنا مشكلة MessageQueue التنازع من خلال تنفيذ بنية بيانات غير قابلة للقفل، واستخدام عمليات الذاكرة الذرية بدلاً من الأقفال الحصرية لمزامنة الوصول إلى الحالة المشتركة. تكون بنية البيانات أو الخوارزمية غير قابلة للإغلاق إذا كان بإمكان سلسلة محادثات واحدة على الأقل إحراز تقدّم دائمًا بغض النظر عن سلوك الجدولة لسلاسل المحادثات الأخرى. من الصعب عادةً تحقيق هذه السمة، ولا يُنصح عادةً بمحاولة تحقيقها في معظم الرموز البرمجية.
الأنواع الأساسية الذرية
تعتمد البرامج غير القابلة للقفل غالبًا على عناصر Read-Modify-Write الأساسية التي توفّرها الأجهزة.
في وحدات المعالجة المركزية ARM64 القديمة، كانت العمليات الذرية تستخدم حلقة Load-Link/Store-Conditional (LL/SC). يحمّل وحدة المعالجة المركزية قيمة ويضع علامة على العنوان. إذا كتب مؤشر ترابط آخر إلى هذا العنوان، سيتعذّر الوصول إلى المتجر، وستتم إعادة محاولة تنفيذ الحلقة. وبما أنّ سلاسل التعليمات يمكنها مواصلة المحاولة والنجاح بدون انتظار سلسلة تعليمات أخرى، فإنّ هذه العملية لا تتطلّب قفلًا.
ARM64 LL/SC loop example
retry:
    ldxr    x0, [x1]        // Load exclusive from address x1 to x0
    add     x0, x0, #1      // Increment value by 1
    stxr    w2, x0, [x1]    // Store exclusive.
                            // w2 gets 0 on success, 1 on failure
cbnz w2, retry // If w2 is non-zero (failed), branch to retrتتيح بنى ARM الأحدث (ARMv8.1) إضافات النظام الكبيرة (LSE) التي تتضمّن تعليمات في شكل Compare-And-Swap (CAS) أو Load-And-Add (كما هو موضّح أدناه). في Android 17، أضفنا إمكانية إلى برنامج التحويل البرمجي في "وقت تشغيل Android" (ART) لرصد ما إذا كان LSE متاحًا وإصدار تعليمات محسّنة:
/ ARMv8.1 LSE atomic example
ldadd   x0, x1, [x2]    // Atomic load-add.
                        // Faster, no loop required.
في مقاييس الأداء، تحقّق التعليمات البرمجية التي تتضمّن معدّل تعارض مرتفعًا وتستخدم CAS زيادة في السرعة بمقدار 3 أضعاف تقريبًا مقارنةً بالتعليمات البرمجية التي تستخدم LL/SC.
توفّر لغة البرمجة Java عناصر أولية ذرية من خلال java.util.concurrent.atomic التي تعتمد على هذه التعليمات وغيرها من تعليمات وحدة المعالجة المركزية المتخصصة.
بنية البيانات: DeliQueue
لإزالة تعارضات القفل من MessageQueue، صمّم مهندسونا بنية بيانات جديدة تُعرف باسم DeliQueue. يفصل DeliQueue عملية إدراج Message عن عملية معالجة Message:
- قائمة
Messages(مجموعة Treiber): هي مجموعة لا تتطلّب قفلًا. يمكن لأي سلسلة محادثات إرسالMessagesجديد هنا بدون تعارض. - قائمة الانتظار ذات الأولوية (Min-heap): هي مجموعة من
Messagesيتم التعامل معها، وهي مملوكة حصريًا لسلسلة Looper (وبالتالي لا يلزم إجراء أي مزامنة أو استخدام أي أقفال للوصول إليها).
وضع في قائمة الانتظار: الدفع إلى حزمة Treiber
يتم الاحتفاظ بقائمة Messages في حزمة Treiber [1]، وهي حزمة غير قابلة للقفل تستخدم حلقة CAS لتعديل مؤشر العنوان.
public class TreiberStack <E> {
    AtomicReference<Node<E>> top =
            new AtomicReference<Node<E>>();
    public void push(E item) {
        Node<E> newHead = new Node<E>(item);
        Node<E> oldHead;
        do {
            oldHead = top.get();
            newHead.next = oldHead;
        } while (!top.compareAndSet(oldHead, newHead));
    }

    public E pop() {
        Node<E> oldHead;
        Node<E> newHead;
        do {
            oldHead = top.get();
            if (oldHead == null) return null;
            newHead = oldHead.next;
        } while (!top.compareAndSet(oldHead, newHead));
        return oldHead.item;
    }
}
رمز المصدر مستند إلى كتاب Java Concurrency in Practice [2]، المتاح على الإنترنت وتم إصداره في المجال العام
يمكن لأي منتج إضافة Message جديدة إلى الحزمة في أي وقت. يشبه ذلك الحصول على تذكرة في قسم الأطعمة الجاهزة في متجر بقالة، حيث يتم تحديد رقمك حسب وقت وصولك، ولكن لا يجب أن يتطابق ترتيب حصولك على الطعام مع رقمك. بما أنّها حزمة مرتبطة، فإنّ كل Message هي حزمة فرعية، ويمكنك معرفة شكل قائمة انتظار Message في أي وقت من خلال تتبُّع الرأس والتكرار للأمام، ولن ترى أي Message جديدة يتم إضافتها في الأعلى، حتى إذا تمت إضافتها أثناء عملية الانتقال.
إزالة من قائمة الانتظار: نقل مجمّع إلى كومة الحد الأدنى
للعثور على Message التالي الذي يجب التعامل معه، يعالج Looper Messages جديدة من حزمة Treiber من خلال الانتقال إلى الحزمة بدءًا من الأعلى والتكرار إلى أن يعثر على آخر Message تمت معالجته سابقًا. أثناء اجتياز Looper للمكدّس، يتم إدراج Message في الحد الأدنى من الكومة المرتبة حسب الموعد النهائي. بما أنّ Looper يملك الذاكرة المؤقتة حصريًا، فهو يرتب Message ويعالجه بدون عمليات قفل أو عمليات ذرية.
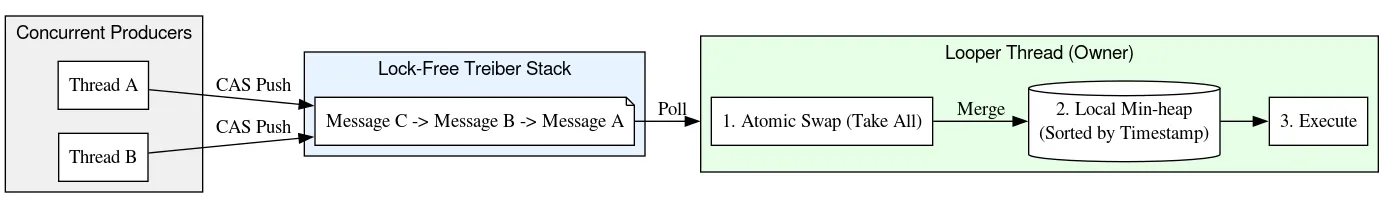
عند النزول إلى أسفل الحزمة، ينشئ Looper أيضًا روابط من Message المكدّسة إلى العناصر السابقة، وبالتالي يشكّل قائمة مرتبطة بشكل مضاعف. إنّ إنشاء القائمة المرتبطة آمن لأنّه تتم إضافة الروابط التي تشير إلى أسفل حزمة البيانات من خلال خوارزمية حزمة بيانات Treiber مع CAS، ولا تتم قراءة الروابط التي تشير إلى أعلى حزمة البيانات أو تعديلها إلا من خلال سلسلة المحادثات Looper. بعد ذلك، يتم استخدام روابط الرجوع هذه لإزالة Message من نقاط عشوائية في الحزمة في وقت O(1).
يتيح هذا التصميم إمكانية إدراج O(1) للمنتجين (سلاسل المحادثات التي تنشر العمل في قائمة الانتظار) ومعالجة O(log N) مستهلكة (Looper).
يؤدي استخدام الحد الأدنى من الكومة لترتيب Messages أيضًا إلى معالجة عيب أساسي في MessageQueue القديم، حيث تم الاحتفاظ Messages في قائمة مرتبطة بشكل فردي (مُحدّدة في الأعلى). في عملية التنفيذ القديمة، كانت الإزالة من المقدّمة O(1)، ولكن كان الإدراج في أسوأ الحالات O(N)، ما يؤدي إلى ضعف الأداء عند زيادة عدد العناصر في قوائم الانتظار. في المقابل، يتم إدراج البيانات في min-heap وإزالتها منها بشكل لوغاريتمي، ما يوفّر أداءً تنافسيًا في المتوسط، ولكنّه يتفوّق حقًا في حالات الكمون الطويل.
الإصدار القديم (مغلق) MessageQueue | DeliQueue | |
| إدراج | O(N) | O(1) لسلسلة محادثات المكالمات O(logN) لسلسلة محادثات |
| إزالة من الرأس | O(1) | O(logN) |
في عملية تنفيذ قائمة الانتظار القديمة، استخدم المنتجون والمستهلك قفلًا لتنسيق الوصول الحصري إلى القائمة المرتبطة بشكل فردي الأساسية. في DeliQueue، تعالج حزمة Treiber عمليات الوصول المتزامن، ويتولّى المستهلك الفردي ترتيب قائمة انتظار العمل.
الإزالة: الاتساق من خلال علامات الحذف
DeliQueue هي بنية بيانات مختلطة تجمع بين حزمة Treiber غير القابلة للتأمين وmin-heap ذات مؤشر ترابط واحد. إنّ الحفاظ على مزامنة هذين البنيتين بدون قفل عام يمثّل تحديًا فريدًا، فقد تكون الرسالة متوفّرة فعليًا في الحزمة ولكن تمت إزالتها منطقيًا من قائمة الانتظار.
لحلّ هذه المشكلة، تستخدم DeliQueue أسلوبًا يُعرف باسم "وضع علامة الحذف". يتتبّع كل Message موضعه في الحزمة من خلال مؤشرات الرجوع والتقدّم، وفهرسه في مصفوفة الكومة، وعلامة منطقية تشير إلى ما إذا تمت إزالته. عندما يكون Message جاهزًا للتنفيذ، سيؤدي مؤشر ترابط Looper إلى مقارنة القيمة وتعيينها (CAS) لعلامة الإزالة، ثم إزالتها من الكومة والمكدس.
عندما يحتاج موضوع آخر إلى إزالة Message، لا يستخرجه على الفور من بنية البيانات. بدلاً من ذلك، سيحدث ما يلي:
- الإزالة المنطقية: يستخدم مؤشر الترابط عملية CAS لضبط علامة الإزالة الخاصة بـ
Messageبشكل ذري من false إلى true. يظلMessageفي بنية البيانات كدليل على إزالته المعلّقة، ويُعرف باسم "حجر القبر". وبمجرد وضع علامة علىMessageلإزالته، يتعامل معه DeliQueue كما لو أنّه لم يعُد موجودًا في صفّ كلما تم العثور عليه. - التنظيف المؤجّل: إنّ عملية الإزالة الفعلية من بنية البيانات هي من مسؤولية سلسلة المحادثات
Looper، ويتم تأجيلها إلى وقت لاحق. بدلاً من تعديل الحزمة أو الكومة، يضيف مؤشر الإزالةMessageإلى حزمة أخرى من قوائم التحرير المجانية غير المقفلة. - الإزالة البنيوية: يمكن
Looperفقط التفاعل مع الكومة أو إزالة العناصر من المكدّس. عندما يستأنف العمل، يمحو قائمة المساحات الحرة ويعالجMessageالتي كانت تحتوي عليها. بعد ذلك، يتم إلغاء ربط كلMessageبالحزمة وإزالته من الذاكرة المؤقتة.
يؤدي هذا النهج إلى إبقاء جميع عمليات إدارة الذاكرة المكدّسة في سلسلة تعليمات واحدة. ويقلّل من عدد العمليات المتزامنة وحواجز الذاكرة المطلوبة، ما يجعل المسار الحرج أسرع وأبسط.
التنقّل: أخطاء بسيطة في نموذج ذاكرة Java
تتضمّن معظم واجهات برمجة التطبيقات المتزامنة، مثل Future في مكتبة Java العادية أو Job وDeferred في Kotlin، آلية لإلغاء العمل قبل اكتماله. يتطابق مثيل أحد هذه الصفوف مع وحدة العمل الأساسية بنسبة 1:1، ويؤدي استدعاء cancel على عنصر إلى إلغاء العمليات المحدّدة المرتبطة به.
تتضمّن أجهزة Android الحالية وحدات معالجة مركزية متعددة النواة وعملية جمع البيانات المُهمَلة حسب الأجيال بشكل متزامن. ولكن عندما تم تطوير Android لأول مرة، كان من المكلف للغاية تخصيص عنصر واحد لكل وحدة عمل. نتيجةً لذلك، تتيح Handler في Android إمكانية الإلغاء من خلال العديد من عمليات التحميل الزائد removeMessages، فبدلاً من إزالة Message محدّد، تتم إزالة جميع Message التي تتطابق مع المعايير المحدّدة. من الناحية العملية، يتطلّب ذلك تكرار جميع Message التي تم إدراجها قبل removeMessages وإزالة تلك التي تتطابق.
عند التكرار للأمام، لا يتطلّب أحد مؤشرات الترابط سوى عملية ذرية واحدة منظَّمة لقراءة رأس المكدّس الحالي. بعد ذلك، يتم استخدام عمليات قراءة الحقول العادية للعثور على Message التالي. إذا عدّل سلسلة Looper الحقول next أثناء إزالة Message، ستكون عملية الكتابة في Looper وعملية القراءة في سلسلة أخرى غير متزامنتَين، وهذا ما يُعرف باسم تضارب البيانات. عادةً ما يكون تعارض البيانات خطأً فادحًا يمكن أن يتسبّب في حدوث مشاكل كبيرة في تطبيقك، مثل تسريب البيانات والحلقات اللانهائية والأعطال والتجميد وغير ذلك. ومع ذلك، في ظل شروط ضيقة معيّنة، يمكن أن تكون تعارضات البيانات غير ضارة ضمن نموذج ذاكرة Java. لنفترض أنّنا نبدأ بمجموعة من:

ننفّذ عملية قراءة ذرية للرأس، ونرى A. يشير المؤشر التالي للعنصر A إلى العنصر B. في الوقت نفسه الذي نعالج فيه B، قد يزيل مشّغل رسائل B وC، وذلك من خلال تعديل A للإشارة إلى C ثم إلى D.
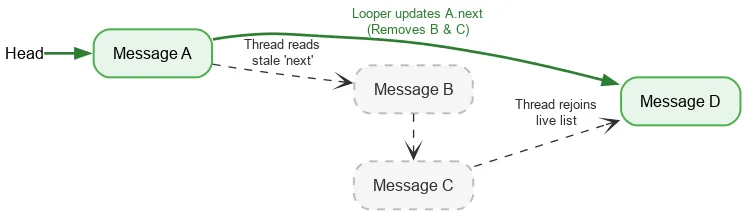
على الرغم من إزالة B وC منطقيًا، يحتفظ B بمؤشر التالي إلى C، وC إلى D. يواصل مؤشر القراءة التنقّل عبر العُقد التي تمت إزالتها بشكل منفصل، ثم يعود في النهاية إلى الحزمة النشطة عند D.
من خلال تصميم DeliQueue للتعامل مع حالات التنافس بين اجتياز العناصر وإزالتها، يمكننا إجراء تكرار آمن بدون قفل.
Quitting: Native refcount
يتم الاحتفاظ بـ Looper من خلال عملية تخصيص أصلية يجب تحريرها يدويًا بعد إغلاق Looper. إذا كان هناك بعض سلاسل التنفيذ الأخرى تضيف Message أثناء إنهاء Looper، يمكن أن تستخدم التخصيص الأصلي بعد تحريره، ما يؤدي إلى انتهاك أمان الذاكرة. نمنع حدوث ذلك باستخدام tagged refcount، حيث يتم استخدام جزء واحد من الذرة للإشارة إلى ما إذا كان Looper سيتم إيقافه.
قبل استخدام التخصيص الأصلي، يقرأ أحد مؤشرات الترابط refcount atomic. إذا تم ضبط بت الإيقاف، سيتم عرض رسالة تفيد بأنّ Looper سيتم إيقافه ويجب عدم استخدام عملية التخصيص الأصلية. إذا لم يكن الأمر كذلك، يحاول تنفيذ عملية CAS لزيادة عدد سلاسل المحادثات النشطة باستخدام التخصيص الأصلي. بعد تنفيذ ما يجب تنفيذه، يتم إنقاص العدد. إذا تم ضبط بت الإيقاف بعد الزيادة ولكن قبل الإنقاص، وأصبح العدد الآن صفرًا، سيتم تنبيه سلسلة المحادثات Looper.
عندما يكون مؤشر ترابط Looper جاهزًا للخروج، يستخدم CAS لضبط بت الخروج في الذرة. إذا كان عدد المراجع 0، يمكنه المتابعة لتحرير التخصيص الأصلي. بخلاف ذلك، يتم إيقافها مؤقتًا، مع العلم أنّه سيتم تنشيطها عندما يخفّض آخر مستخدم للتخصيص الأصلي عدد المراجع. يعني هذا الأسلوب أنّ سلسلة التعليمات Looper تنتظر تقدّم سلاسل التعليمات الأخرى، ولكن فقط عند إيقافها. يحدث ذلك مرة واحدة فقط ولا يتأثر بالأداء، ويحافظ على الرمز الآخر لاستخدام التخصيص الأصلي بدون أي قفل.
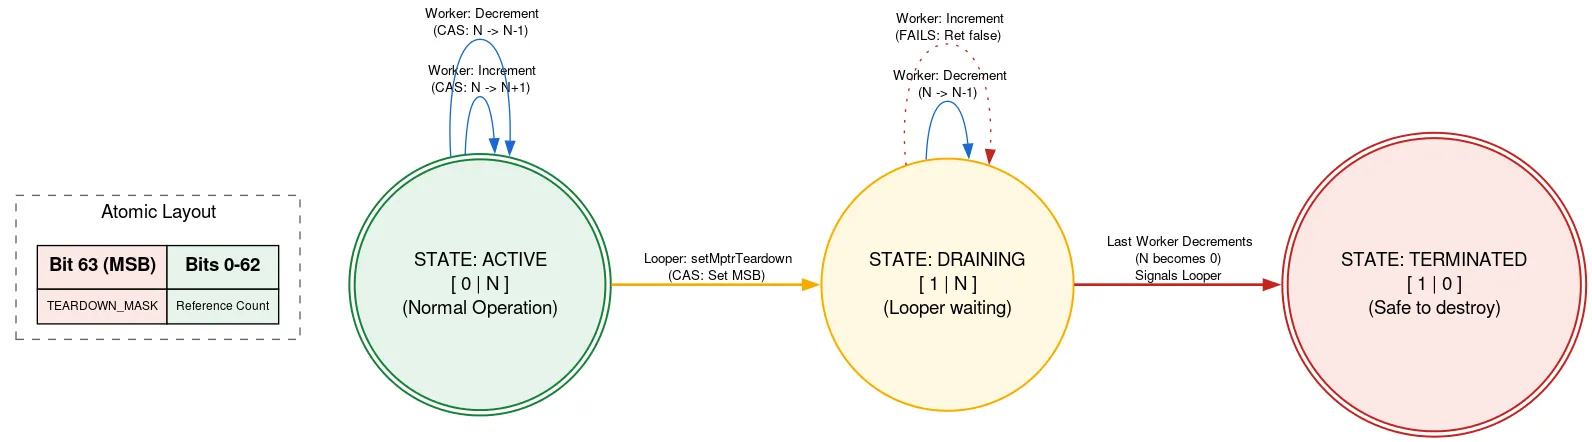
هناك الكثير من الحيل والتعقيدات الأخرى في عملية التنفيذ. يمكنك الاطّلاع على مزيد من المعلومات حول DeliQueue من خلال مراجعة رمز المصدر.
التحسين: البرمجة بدون فروع
أثناء تطوير DeliQueue واختبارها، أجرى الفريق العديد من مقاييس الأداء ووضعوا ملفات تعريف دقيقة للتعليمات البرمجية الجديدة. إحدى المشاكل التي تم تحديدها باستخدام أداة simpleperf هي عمليات إفراغ خطوط الأنابيب الناتجة عن رمز Message المقارنة.
يستخدم عامل المقارنة العادي عمليات الانتقال الشرطية، مع تبسيط الشرط الخاص بتحديد Message الذي يأتي أولاً على النحو التالي:
static int compareMessages(@NonNull Message m1, @NonNull Message m2) {
    if (m1 == m2) {
        return 0;
    }

    // Primary queue order is by when.
    // Messages with an earlier when should come first in the queue.
    final long whenDiff = m1.when - m2.when;
    if (whenDiff > 0) return 1;
    if (whenDiff < 0) return -1;

    // Secondary queue order is by insert sequence.
    // If two messages were inserted with the same `when`, the one inserted
    // first should come first in the queue.
    final long insertSeqDiff = m1.insertSeq - m2.insertSeq;
    if (insertSeqDiff > 0) return 1;
    if (insertSeqDiff < 0) return -1;

    return 0;
}
يتم تجميع هذا الرمز في عمليات انتقال شرطية (التعليمات b.le وcbnz). عندما يواجه وحدة المعالجة المركزية فرعًا شرطيًا، لا يمكنها معرفة ما إذا كان سيتم تنفيذ الفرع إلى أن يتم حساب الشرط، وبالتالي لا تعرف التعليمات التي يجب قراءتها بعد ذلك، وعليها التخمين باستخدام تقنية تُعرف باسم توقّع الفروع. في حالة البحث الثنائي، سيكون اتجاه الفرع مختلفًا بشكل غير متوقّع في كل خطوة، لذا من المحتمل أن تكون نصف التوقعات خاطئة. غالبًا ما تكون عملية توقّع المسار غير فعّالة في خوارزميات البحث والترتيب (مثل تلك المستخدَمة في الحد الأدنى من الكومة)، لأنّ تكلفة التخمين الخاطئ أكبر من التحسين الناتج عن التخمين الصحيح. عندما يخمن برنامج توقّع الفروع بشكل خاطئ، عليه التخلّي عن العمل الذي قام به بعد افتراض القيمة المتوقّعة، والبدء من جديد من المسار الذي تم اتخاذه فعليًا، ويُعرف ذلك باسم إفراغ خط الأنابيب.
للعثور على هذه المشكلة، حلّلنا مقاييس الأداء باستخدام عدّاد الأداء branch-misses، الذي يسجّل عمليات تتبُّع تسلسل استدعاء الدوال البرمجية التي تخمّن فيها أداة توقّع الفروع بشكل خاطئ. بعد ذلك، عرضنا النتائج بشكل مرئي باستخدام Google pprof، كما هو موضّح أدناه:
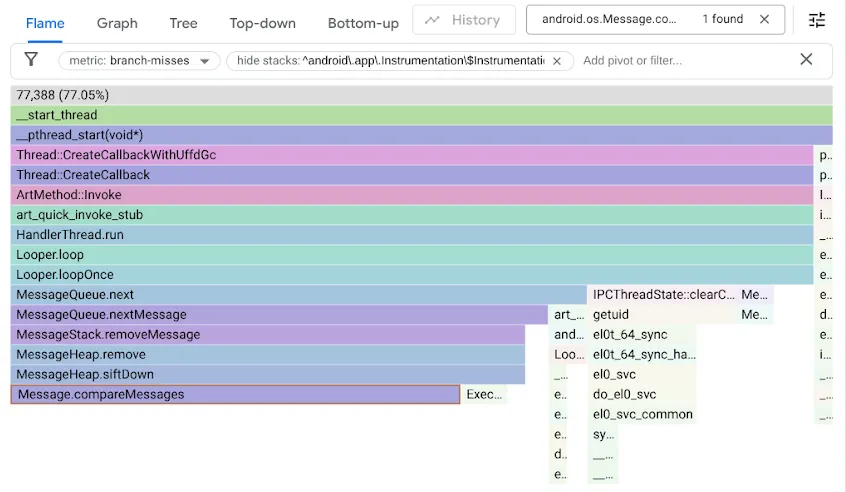
تذكَّر أنّ الرمز الأصلي MessageQueue استخدم قائمة مرتبطة بشكل فردي للانتظار المنظَّم. سيتم إدراج العنصر من خلال الانتقال إلى القائمة بترتيب مرتّب كبحث خطي، والتوقّف عند العنصر الأول الذي يتجاوز نقطة الإدراج وربط العنصر الجديد Message قبله. كانت الإزالة من الرأس تتطلّب ببساطة إلغاء ربط الرأس. في المقابل، تستخدم DeliQueue الحد الأدنى من الكومة، حيث تتطلّب عمليات التغيير إعادة ترتيب بعض العناصر (الغربلة للأعلى أو للأسفل) مع تعقيد لوغاريتمي في بنية بيانات متوازنة، حيث يكون لأي مقارنة فرصة متساوية لتوجيه الاجتياز إلى عنصر فرعي أيسر أو إلى عنصر فرعي أيمن. الخوارزمية الجديدة أسرع بشكل مقارب، ولكنّها تكشف عن عنق زجاجة جديد لأنّ رمز البحث يتوقف عند عدم العثور على تطابق مع الفرع نصف الوقت.
بعد أن لاحظنا أنّ عدم توفّر الفروع يؤدي إلى إبطاء رمز الذاكرة المؤقتة، عملنا على تحسين الرمز باستخدام البرمجة بدون فروع:
// Branchless Logic
static int compareMessages(@NonNull Message m1, @NonNull Message m2) {
    final long when1 = m1.when;
    final long when2 = m2.when;
    final long insertSeq1 = m1.insertSeq;
    final long insertSeq2 = m2.insertSeq;

    // signum returns the sign (-1, 0, 1) of the argument,
    // and is implemented as pure arithmetic:
    // ((num >> 63) | (-num >>> 63))
    final int whenSign = Long.signum(when1 - when2);
    final int insertSeqSign = Long.signum(insertSeq1 - insertSeq2);

    // whenSign takes precedence over insertSeqSign,
    // so the formula below is such that insertSeqSign only matters
    // as a tie-breaker if whenSign is 0.
    return whenSign * 2 + insertSeqSign;
}
لفهم عملية التحسين، فكِّر في المثالَين في Compiler Explorer واستخدِم LLVM-MCA، وهو محاكي لوحدة المعالجة المركزية يمكنه إنشاء مخطط زمني تقديري لدورات وحدة المعالجة المركزية.
The original code:
Index     01234567890123
[0,0]     DeER .    .  .   sub  x0, x2, x3
[0,1]     D=eER.    .  .   cmp  x0, #0
[0,2]     D==eER    .  .   cset w0, ne
[0,3]     .D==eER   .  .   cneg w0, w0, lt
[0,4]     .D===eER  .  .   cmp  w0, #0
[0,5]     .D====eER .  .   b.le #12
[0,6]     . DeE---R .  .   mov  w1, #1
[0,7]     . DeE---R .  .   b    #48
[0,8]     . D==eE-R .  .   tbz  w0, #31, #12
[0,9]     .  DeE--R .  .   mov  w1, #-1
[0,10]    .  DeE--R .  .   b    #36
[0,11]    .  D=eE-R .  .   sub  x0, x4, x5
[0,12]    .   D=eER .  .   cmp  x0, #0
[0,13]    .   D==eER.  .   cset w0, ne
[0,14]    .   D===eER  .   cneg w0, w0, lt
[0,15]    .    D===eER .   cmp  w0, #0
[0,16]    .    D====eER.   csetm        w1, lt
[0,17]    .    D===eE-R.   cmp  w0, #0
[0,18]    .    .D===eER.   csinc        w1, w1, wzr, le
[0,19]    .    .D====eER   mov  x0, x1
[0,20]    .    .DeE----R   ret
لاحظ الفرع الشرطي الوحيد، b.le، الذي يتجنّب مقارنة الحقلَين insertSeq إذا كانت النتيجة معروفة مسبقًا من خلال مقارنة الحقلَين when.
The branchless code:
Index     012345678
[0,0]     DeER .  .   sub       x0, x2, x3
[0,1]     DeER .  .   sub       x1, x4, x5
[0,2]     D=eER.  .   cmp       x0, #0
[0,3]     .D=eER  .   cset      w0, ne
[0,4]     .D==eER .   cneg      w0, w0, lt
[0,5]     .DeE--R .   cmp       x1, #0
[0,6]     . DeE-R .   cset      w1, ne
[0,7]     . D=eER .   cneg      w1, w1, lt
[0,8]     . D==eeER   add       w0, w1, w0, lsl #1
[0,9]     .  DeE--R   ret
في هذه الحالة، يستغرق التنفيذ بدون فروع عددًا أقل من الدورات والتعليمات مقارنةً بأقصر مسار في الرمز البرمجي الذي يتضمّن فروعًا، ما يجعله أفضل في جميع الحالات. وقد أدّى التنفيذ الأسرع بالإضافة إلى إلغاء الفروع التي تم توقّعها بشكل خاطئ إلى تحسين بعض مقاييس الأداء لدينا بمقدار 5 أضعاف.
ومع ذلك، لا يمكن تطبيق هذه التقنية دائمًا. تتطلّب الأساليب غير المتفرّعة بشكل عام تنفيذ أعمال سيتم تجاهلها، وإذا كان الفرع قابلاً للتوقّع في معظم الأوقات، يمكن أن يؤدي هذا العمل الضائع إلى إبطاء الرمز البرمجي. بالإضافة إلى ذلك، يؤدي حذف فرع غالبًا إلى حدوث اعتماد على البيانات. تنفّذ وحدات المعالجة المركزية الحديثة عمليات متعددة في كل دورة، ولكن لا يمكنها تنفيذ تعليمات إلا بعد أن تصبح مدخلاتها من التعليمات السابقة جاهزة. في المقابل، يمكن لوحدة المعالجة المركزية التخمين بشأن البيانات في الفروع، والعمل مسبقًا إذا تم توقّع أحد الفروع بشكل صحيح.
الاختبار والتحقّق من الصحة
من الصعب جدًا التحقّق من صحة الخوارزميات غير المتزامنة.
بالإضافة إلى اختبارات الوحدات القياسية للتحقّق المستمر من الصحة أثناء التطوير، كتبنا أيضًا اختبارات إجهاد صارمة للتحقّق من ثبات قوائم الانتظار ومحاولة إحداث تضارب في البيانات إذا كانت موجودة. في مختبرات الاختبار، يمكننا تشغيل ملايين من حالات الاختبار على الأجهزة المحاكية وعلى الأجهزة الحقيقية.
باستخدام أداة Java ThreadSanitizer (JTSan)، يمكننا استخدام الاختبارات نفسها لرصد بعض حالات تضارب البيانات في الرمز البرمجي أيضًا. لم يعثر JTSan على أيّ تعارضات في البيانات في DeliQueue، ولكنّه رصد بشكل مفاجئ خطأين متزامنين في إطار عمل Robolectric، وقد أصلحناهما على الفور.
لتحسين إمكانات تصحيح الأخطاء، أنشأنا أدوات تحليل جديدة. في ما يلي مثال يوضّح مشكلة في الرمز البرمجي لمنصة Android حيث يؤدي أحد سلاسل التنفيذ إلى إرهاق سلسلة تنفيذ أخرى باستخدام Message، ما يؤدي إلى تراكم كبير في المهام، وهو ما يمكن رصده في Perfetto بفضل ميزة MessageQueue التي أضفناها.
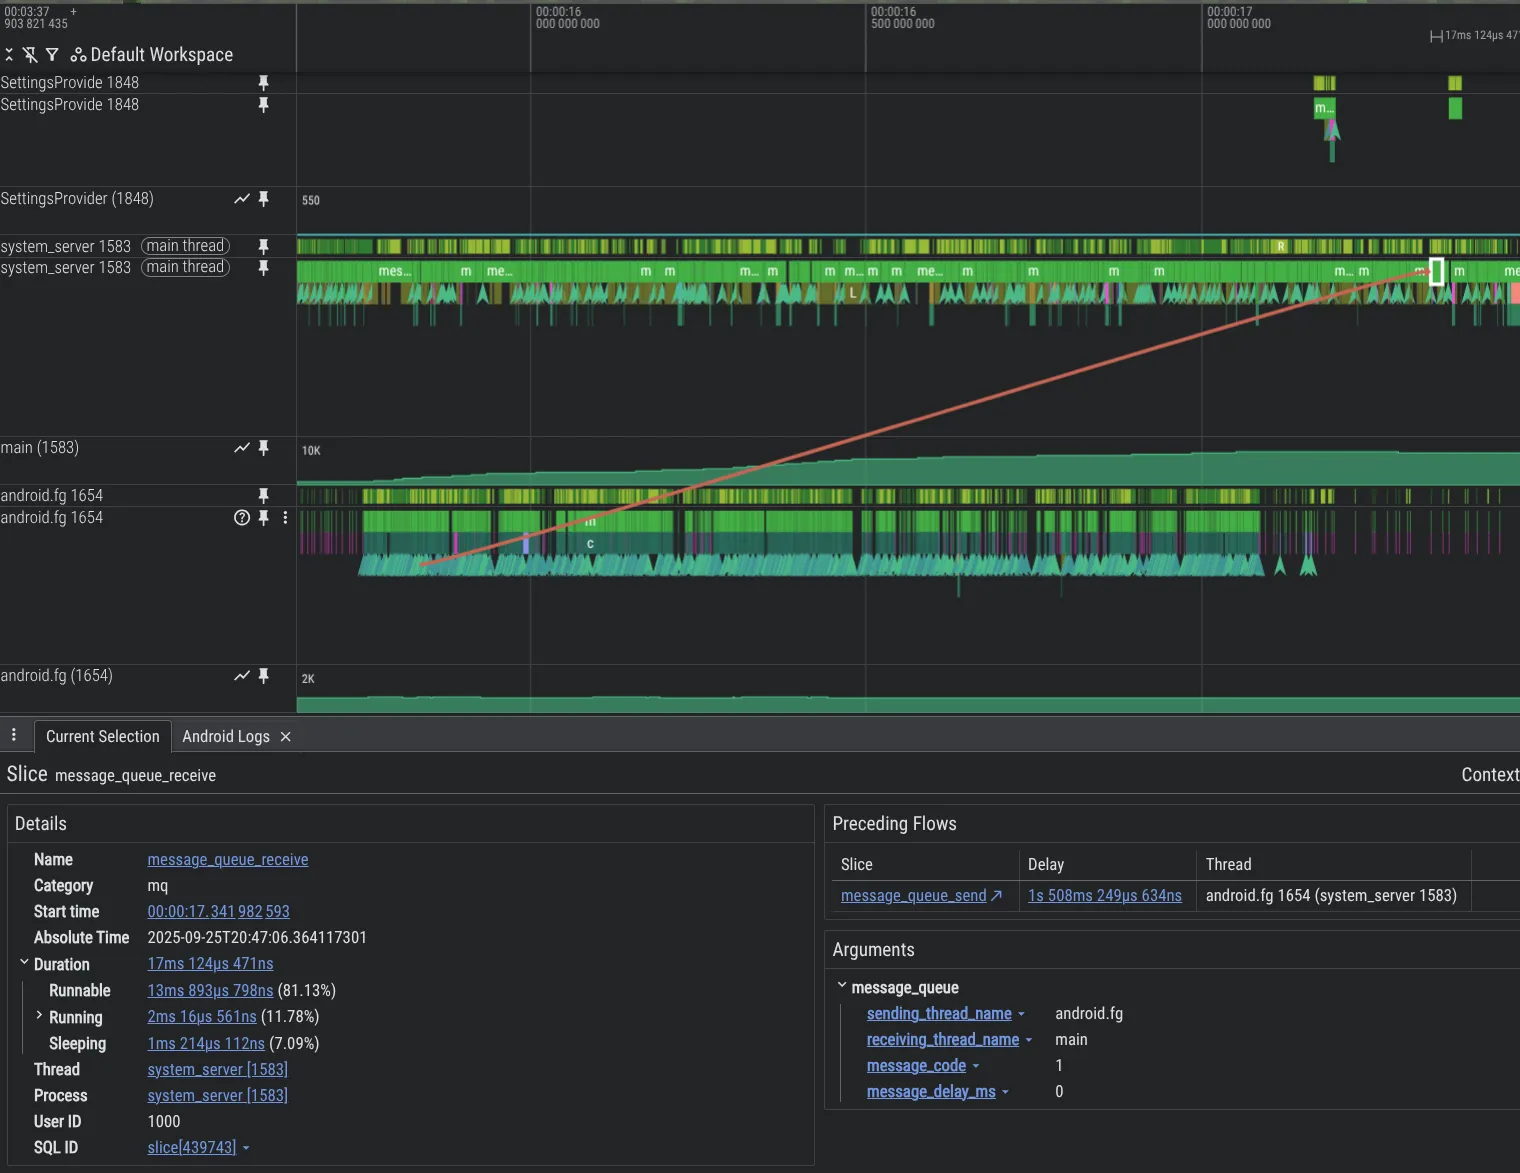
لتفعيل MessageQueue تتبُّع الأخطاء في عملية system_server، أدرِج ما يلي في إعدادات Perfetto:
data_sources {
  config {
    name: "track_event"
    target_buffer: 0  # Change this per your buffers configuration
    track_event_config {
      enabled_categories: "mq"
    }
  }
}
التأثير
يحسّن DeliQueue أداء النظام والتطبيقات من خلال إزالة عمليات القفل من MessageQueue.
- مقاييس الأداء الاصطناعية: عمليات الإدراج المتعددة الخيوط في قوائم الانتظار المشغولة أسرع بما يصل إلى 5,000 مرة من
MessageQueueالقديم، وذلك بفضل التزامن المحسّن (مجموعة Treiber) وعمليات الإدراج الأسرع (min-heap). - في عمليات تتبُّع Perfetto التي تم الحصول عليها من مختبِري الإصدار التجريبي الداخليين، نلاحظ انخفاضًا بنسبة% 15 في الوقت الذي يستغرقه مؤشر ترابط التطبيق الرئيسي في انتظار الحصول على القفل.
- على أجهزة الاختبار نفسها، يؤدي تقليل تعارض القفل إلى تحسينات كبيرة في تجربة المستخدم، مثل:
- -4% من اللقطات الفائتة في التطبيقات
- -7.7% من اللقطات التي لم يتم عرضها في تفاعلات واجهة مستخدِم النظام ومشغّل التطبيقات
- انخفاض بنسبة %9.1 في الوقت المستغرَق منذ بدء تشغيل التطبيق إلى عرض اللقطة الأولى، وذلك عند الشريحة المئوية الخامسة والتسعين.
الخطوات التالية
سيتم طرح DeliQueue في تطبيقات Android 17. على مطوّري التطبيقات مراجعة مقالة "تجهيز تطبيقك لاستخدام MessageQueue الجديد غير المقفل" في مدوّنة "مطوّرو تطبيقات Android" لمعرفة كيفية اختبار تطبيقاتهم.
المراجع
[1] Treiber, R.K., 1986 Systems programming: Coping with parallelism. International Business Machines Incorporated, Thomas J. مركز أبحاث واتسون
[2] Goetz, B., Peierls, T., Bloch, J., Bowbeer, J., Holmes, D., & Lea, D. (2006). Java Concurrency in Practice Addison-Wesley Professional.
-
 أخبار المنتجات
على Google Play، نعمل باستمرار على توسيع منصة الاشتراكات لمساعدتك في تعزيز النمو والتكيّف مع نماذج الأعمال الجديدة وتلبية احتياجات المستخدمين أينما كانوا.
Sheenam Mittal • مدّة القراءة: 4 دقائق -
 أخبار المنتجات
في العام الماضي، أصبح بإمكان "استوديو Android" استخدام أي نموذج للذكاء الاصطناعي. واليوم، نتّخذ الخطوة التالية من خلال توفير إمكانية اختيار وكلاء الترميز.
Matthew Warner • مدّة القراءة: 3 دقائق -
 أخبار المنتجات
تقدّم Googlebook فئة جديدة من أجهزة الكمبيوتر المحمول المستندة إلى أساس Android المشترك. تجمع أجهزة Chromebook Plus بين سهولة استخدام الأجهزة الجوّالة وقوة أجهزة الكمبيوتر المكتبي، وهي مزوّدة بأجهزة عالية الأداء من شركاء مثل HP وDell وLenovo وAcer وAsus.
Fahd Imtiaz, Loryn Hairston • مدّة القراءة: 4 دقائق
يمكنك تلقّي أحدث الإحصاءات حول تطوير تطبيقات Android في بريدك الوارد أسبوعيًا.