ב-Android 17, אפליקציות שמטרגטות את SDK 37 ואילך יקבלו הטמעה חדשה של MessageQueue שבה ההטמעה היא ללא נעילה. ההטמעה החדשה משפרת את הביצועים ומפחיתה את מספר הפריימים שהוחמצו, אבל היא עלולה לשבש לקוחות שמשקפים שדות ושיטות פרטיים של MessageQueue. כדי לקבל מידע נוסף על השינוי בהתנהגות ועל הדרכים לצמצם את ההשפעה, עיינו במסמכי התיעוד בנושא השינוי בהתנהגות של MessageQueue. בפוסט הזה בבלוג הטכני יש סקירה כללית על הארכיטקטורה החדשה של MessageQueue ועל הדרכים לנתח בעיות של תחרות על נעילה באמצעות Perfetto.
Looper מפעיל את שרשור ה-UI של כל אפליקציה ל-Android. הוא שולף עבודה מ-MessageQueue, שולח אותה ל-Handler וחוזר על הפעולה. במשך שני עשורים, MessageQueue השתמש בנעילת צג אחת (כלומר בלוק קוד synchronized) כדי להגן על המצב שלו.
ב-Android 17 יש עדכון משמעותי לרכיב הזה: הטמעה ללא נעילה שנקראת DeliQueue.
בפוסט הזה מוסבר איך נעילות משפיעות על הביצועים של ממשק המשתמש, איך לנתח את הבעיות האלה באמצעות Perfetto, ומהם האלגוריתמים והאופטימיזציות הספציפיים שמשמשים לשיפור ה-main thread של Android.
הבעיה: תחרות על נעילה והיפוך עדיפויות
ה-MessageQueue הישן פעל כתור עדיפות שמוגן על ידי נעילה אחת. אם שרשור ברקע מפרסם הודעה בזמן שהשרשור הראשי מבצע תחזוקה של התור, השרשור ברקע חוסם את השרשור הראשי.
כששני שרשורים או יותר מתחרים על שימוש בלעדי באותו נעילה, זה נקרא תחרות על נעילה. התחרות הזו יכולה לגרום להיפוך עדיפות, שמוביל לבעיות בביצועים כמו קפיצות בממשק המשתמש.
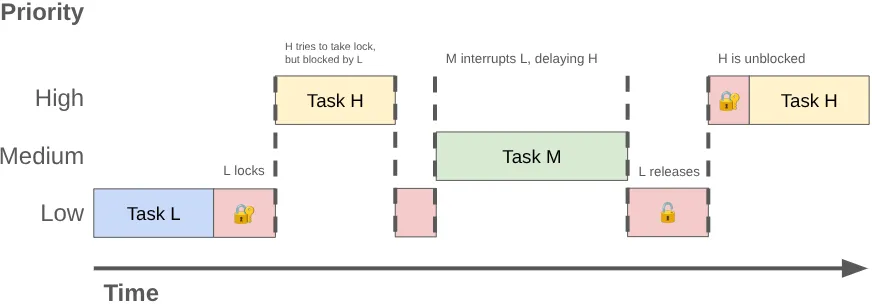
היפוך עדיפויות יכול לקרות כש-thread בעדיפות גבוהה (כמו שרשור UI) ממתין ל-thread בעדיפות נמוכה. לדוגמה, נבחן את הרצף הבא:
- שרשור ברקע עם עדיפות נמוכה מקבל את הנעילה של
MessageQueueכדי לפרסם את התוצאה של הפעולה שהוא ביצע. - שרשור בעדיפות בינונית הופך לניתן להרצה, והמתזמן של הליבה מקצה לו זמן מעבד, תוך הפקעת השרשור בעדיפות נמוכה.
- שרשור ה-UI בעדיפות גבוהה מסיים את המשימה הנוכחית שלו ומנסה לקרוא מהתור, אבל הוא חסום כי השרשור בעדיפות נמוכה מחזיק בנעילה.
השרשור בעדיפות נמוכה חוסם את שרשור ה-UI, והעבודה בעדיפות בינונית מעכבת אותו עוד יותר.
ניתוח התנגשות באמצעות Perfetto
אתם יכולים לאבחן את הבעיות האלה באמצעות Perfetto. במעקב רגיל, שרשור שנחסם בנעילת מוניטור נכנס למצב שינה, וב-Perfetto מוצג קטע שמציין את הבעלים של הנעילה.
כששולחים שאילתה על נתוני מעקב, מחפשים פרוסות בשם "monitor contention with …" ואחריו את שם ה-thread שבבעלותו הנעילה ואת אתר הקוד שבו הנעילה נרכשה.
מקרה לדוגמה: קפיצות במרכז האפליקציות
כדי להמחיש את זה, ננתח מעקב שבו משתמש חווה קפיצות בזמן הניווט לדף הבית בטלפון Pixel מיד אחרי שצילם תמונה באפליקציית המצלמה. בהמשך מוצג צילום מסך של Perfetto שמראה את האירועים שהובילו לפריים שהוחמץ:
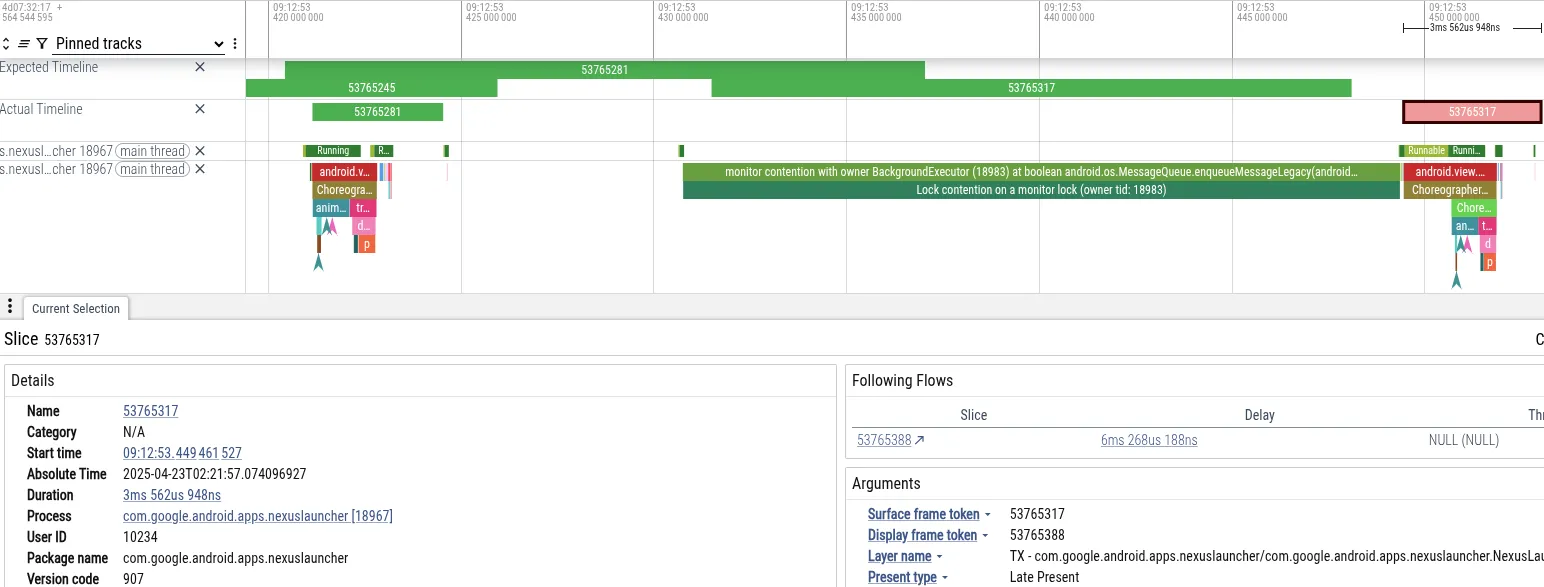
- תסמין: ה-thread הראשי של מרכז האפליקציות החמיץ את המועד האחרון של הפריים. הוא נחסם למשך 18 אלפיות השנייה, וזה חורג מהמועד האחרון של 16 אלפיות השנייה שנדרש לעיבוד של 60Hz.
- אבחון: ב-Perfetto הוצג ה-thread הראשי שנחסם בנעילה של
MessageQueue. השרשור BackgroundExecutor היה הבעלים של הנעילה. - שורש הבעיה: BackgroundExecutor פועל ב-Process.THREAD_PRIORITY_BACKGROUND (עדיפות נמוכה מאוד). היא ביצעה משימה לא דחופה (בדיקת מגבלות השימוש באפליקציה). בו-זמנית, שרשורים בעדיפות בינונית השתמשו בזמן מעבד כדי לעבד נתונים מהמצלמה. מתזמן מערכת ההפעלה הפקיע את השרשור של BackgroundExecutor כדי להריץ את השרשורים של המצלמה.
הרצף הזה גרם לכך ששרשור ה-UI של מרכז האפליקציות (בעדיפות גבוהה) נחסם באופן עקיף על ידי ה-Thread העובד של המצלמה (בעדיפות בינונית), שמנע משרשור הרקע של מרכז האפליקציות (בעדיפות נמוכה) לשחרר את הנעילה.
שאילתות על נתוני מעקב באמצעות PerfettoSQL
אתם יכולים להשתמש ב-PerfettoSQL כדי להריץ שאילתות על נתוני מעקב ולחפש דפוסים ספציפיים. האפשרות הזו שימושית אם יש לכם מאגר גדול של נתוני מעקב ממכשירי משתמשים או מבדיקות, ואתם מחפשים נתוני מעקב ספציפיים שמדגימים בעיה.
לדוגמה, השאילתה הזו מוצאת מחלוקת על MessageQueue שמתרחשת במקביל לפריימים שהושמטו (בעיות בממשק):
INCLUDE PERFETTO MODULE android.monitor_contention;
INCLUDE PERFETTO MODULE android.frames.jank_type;

SELECT
  process_name,
  -- Convert duration from nanoseconds to milliseconds
  SUM(dur) / 1000000 AS sum_dur_ms,
  COUNT(*) AS count_contention
FROM android_monitor_contention
WHERE is_blocked_thread_main
AND short_blocked_method LIKE "%MessageQueue%"

-- Only look at app processes that had jank
AND upid IN (
  SELECT DISTINCT(upid)
  FROM actual_frame_timeline_slice
  WHERE android_is_app_jank_type(jank_type) = TRUE
)
GROUP BY process_name
ORDER BY SUM(dur) DESC;
בדוגמה המורכבת יותר הזו, מאחדים נתוני מעקב שמשתרעים על פני כמה טבלאות כדי לזהות מחלוקת ב-MessageQueue במהלך הפעלת האפליקציה:
INCLUDE PERFETTO MODULE android.monitor_contention;
INCLUDE PERFETTO MODULE android.startup.startups;

-- Join package and process information for startups
DROP VIEW IF EXISTS startups;
CREATE VIEW startups AS
SELECT startup_id, ts, dur, upid
FROM android_startups
JOIN android_startup_processes USING(startup_id);

-- Intersect monitor contention with startups in the same process.
DROP TABLE IF EXISTS monitor_contention_during_startup;
CREATE VIRTUAL TABLE monitor_contention_during_startup
USING SPAN_JOIN(android_monitor_contention PARTITIONED upid, startups PARTITIONED upid);

SELECT
  process_name,
  SUM(dur) / 1000000 AS sum_dur_ms,
  COUNT(*) AS count_contention
FROM monitor_contention_during_startup
WHERE is_blocked_thread_main
AND short_blocked_method LIKE "%MessageQueue%"
GROUP BY process_name
ORDER BY SUM(dur) DESC;
אתם יכולים להשתמש במודל ה-LLM המועדף עליכם כדי לכתוב שאילתות PerfettoSQL ולמצוא דפוסים אחרים.
ב-Google אנחנו משתמשים ב-BigTrace כדי להריץ שאילתות PerfettoSQL על מיליוני נתוני מעקב. במהלך הבדיקה, אישרנו שמה שראינו באופן אנקדוטי היה, למעשה, בעיה מערכתית. הנתונים הראו שתחרות על נעילה ב-MessageQueue משפיעה על המשתמשים בכל המערכת, וזה מוכיח שצריך שינוי מהותי בארכיטקטורה.
הפתרון: בו-זמניות ללא נעילה
כדי לפתור את בעיית התחרות על משאבים ב-MessageQueue, הטמענו מבנה נתונים ללא נעילה, שמשתמש בפעולות זיכרון אטומיות במקום בנעילות בלעדיות כדי לסנכרן את הגישה למצב המשותף. מבנה נתונים או אלגוריתם הוא ללא נעילה אם לפחות שרשור אחד תמיד יכול להתקדם, בלי קשר להתנהגות התזמון של השרשורים האחרים. בדרך כלל קשה להשיג את המאפיין הזה, וברוב המקרים לא כדאי לנסות להשיג אותו עבור רוב הקוד.
הפרימיטיבים האטומיים
תוכנה ללא נעילה מסתמכת לעיתים קרובות על פרימיטיבים אטומיים של קריאה-שינוי-כתיבה שהחומרה מספקת.
במעבדי ARM64 מדור ישן יותר, פעולות אטומיות השתמשו בלולאת Load-Link/Store-Conditional (LL/SC). המעבד טוען ערך ומסמן את הכתובת. אם שרשור אחר כותב לכתובת הזו, השמירה נכשלת והלולאה מנסה שוב. מכיוון שהשרשורים יכולים להמשיך לנסות ולהצליח בלי להמתין לשרשור אחר, הפעולה הזו היא ללא נעילה.
ARM64 LL/SC loop example
retry:
    ldxr    x0, [x1]        // Load exclusive from address x1 to x0
    add     x0, x0, #1      // Increment value by 1
    stxr    w2, x0, [x1]    // Store exclusive.
                            // w2 gets 0 on success, 1 on failure
cbnz w2, retry // If w2 is non-zero (failed), branch to retrארכיטקטורות ARM חדשות יותר (ARMv8.1) תומכות ב-Large System Extensions (LSE), שכוללות הוראות בפורמט Compare-And-Swap (CAS) או Load-And-Add (כפי שמוצג בהמשך). ב-Android 17 הוספנו תמיכה לקומפיילר של סביבת זמן ריצה ל-Android (ART) כדי לזהות מתי יש תמיכה ב-LSE ולהפיק הוראות אופטימליות:
/ ARMv8.1 LSE atomic example
ldadd   x0, x1, [x2]    // Atomic load-add.
                        // Faster, no loop required.
בבדיקות שלנו, קוד עם תחרות גבוהה שמשתמש ב-CAS משיג מהירות גבוהה פי 3 בערך בהשוואה לגרסת LL/SC.
שפת התכנות Java מציעה פרימיטיבים אטומיים דרך java.util.concurrent.atomic שמסתמכים על הוראות המעבד (CPU) האלה והוראות מיוחדות אחרות.
מבנה הנתונים: DeliQueue
כדי להסיר את התחרות על נעילות מ-MessageQueue, המהנדסים שלנו תכננו מבנה נתונים חדש שנקרא DeliQueue. DeliQueue מפריד בין הוספת Message לבין עיבוד Message:
- רשימת
Messages(מחסנית טרייבר): מחסנית ללא נעילה. כל שרשור יכול להוסיףMessagesחדש לכאן בלי התנגשות. - תור העדיפויות (Min-heap): ערימה של
Messagesלטיפול, בבעלות בלעדית של ה-Looper thread (ולכן לא נדרשים סנכרון או נעילות כדי לגשת).
הוספה לתור: דחיפה למחסנית Treiber
רשימת ה-Messages נשמרת במחסנית Treiber [1], מחסנית ללא נעילה שמשתמשת בלולאת CAS כדי לעדכן את המצביע הראשי.
public class TreiberStack <E> {
    AtomicReference<Node<E>> top =
            new AtomicReference<Node<E>>();
    public void push(E item) {
        Node<E> newHead = new Node<E>(item);
        Node<E> oldHead;
        do {
            oldHead = top.get();
            newHead.next = oldHead;
        } while (!top.compareAndSet(oldHead, newHead));
    }

    public E pop() {
        Node<E> oldHead;
        Node<E> newHead;
        do {
            oldHead = top.get();
            if (oldHead == null) return null;
            newHead = oldHead.next;
        } while (!top.compareAndSet(oldHead, newHead));
        return oldHead.item;
    }
}
קוד מקור שמבוסס על Java Concurrency in Practice [2], זמין באינטרנט ופורסם בנחלת הכלל
כל יצרן יכול להוסיף Message חדשים למחסנית בכל שלב. זה כמו לקחת מספר בתור למעדנייה – המספר נקבע לפי הזמן שבו הגעתם, אבל לא בהכרח תקבלו את האוכל לפי הסדר הזה. מכיוון שמדובר במחסנית מקושרת, כל Message הוא מחסנית משנה – אפשר לראות איך נראה התור של Message בכל נקודת זמן על ידי מעקב אחר הראש וחזרה קדימה – לא תראו שום Message חדש שנדחף למעלה, גם אם הם נוספים במהלך המעבר.
הוצאה מהתור: העברה בכמות גדולה לערימת מינימום
כדי למצוא את ה-Message הבא שצריך לטפל בו, ה-Looper מעבד Message חדשים ממחסנית Treiber על ידי מעבר על המחסנית החל מהחלק העליון וחזרה על הפעולה עד שהוא מוצא את ה-Message האחרון שהוא עיבד קודם לכן. כשה-Looper עובר במורד המחסנית, הוא מוסיף Message ל-min-heap שמסודר לפי מועד אחרון. מכיוון שה-Looper הוא הבעלים הבלעדי של ה-heap, הוא מסדר ומעבד את ה-Message ללא נעילות או פעולות אטומיות.
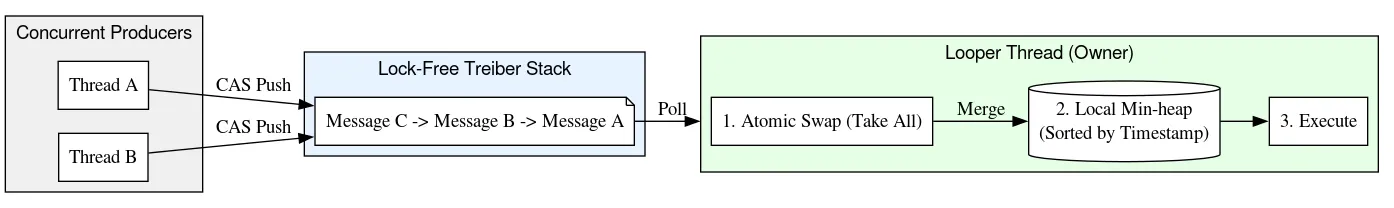
במעבר במורד המחסנית, Looper יוצר גם קישורים מ-Messages במחסנית בחזרה לקודמים שלהם, וכך נוצרת רשימה מקושרת כפולה. יצירת הרשימה המקושרת היא בטוחה כי קישורים שמצביעים למטה במחסנית מתווספים באמצעות אלגוריתם המחסנית של Treiber עם CAS, וקישורים למעלה במחסנית נקראים ומשתנים רק על ידי ה-thread של Looper. הקישורים האלה משמשים להסרת Message מנקודות שרירותיות במחסנית בזמן O(1).
העיצוב הזה מספק הוספה של O(1) ליצרנים (שרשורים שמפרסמים עבודה לתור) ועיבוד מופחת של O(log N) לצרכן (ה-Looper).
שימוש בערימת מינימום כדי לסדר את Messages גם פותר פגם בסיסי ב-MessageQueue הישן, שבו Messages נשמרו ברשימה מקושרת יחידה (עם שורש בחלק העליון). בהטמעה הקודמת, הסרה מהראש הייתה O(1), אבל ההוספה הייתה במקרה הגרוע ביותר O(N) – קנה מידה גרוע לתורים עמוסים! לעומת זאת, הוספה והסרה מהערימה המינימלית מתבצעות בקנה מידה לוגריתמי, מה שמאפשר ביצועים ממוצעים תחרותיים אבל מצטיין במיוחד בזמני אחזור ארוכים.
גרסה קודמת (נעולה) MessageQueue | DeliQueue | |
| הוספה | O(N) | O(1) לשרשור הקריאה O(logN) לשרשור |
| הסרה מהראש | O(1) | O(logN) |
בהטמעה הקודמת של התור, היצרנים והצרכן השתמשו בנעילה כדי לתאם גישה בלעדית לרשימה המקושרת הבסיסית. ב-DeliQueue, מחסנית Treiber מטפלת בגישה בו-זמנית, והצרכן היחיד מטפל בסידור תור העבודה שלו.
הסרה: עקביות באמצעות מצבות
DeliQueue הוא מבנה נתונים היברידי, שמשלב מחסנית Treiber ללא נעילה עם ערימת מינימום (min-heap) עם שרשור יחיד. סנכרון בין שני המבנים האלה בלי נעילה גלובלית מציב אתגר ייחודי: הודעה יכולה להיות נוכחת פיזית במחסנית, אבל להיות מוסרת לוגית מהתור.
כדי לפתור את הבעיה, ב-DeliQueue משתמשים בטכניקה שנקראת "tombstoning". כל Message עוקב אחרי המיקום שלו במחסנית באמצעות המצביעים קדימה ואחורה, האינדקס שלו במערך של הערימה ודגל בוליאני שמציין אם הוא הוסר. כשה-Message מוכן להפעלה, ה-thread של Looper יבצע CAS לדגל ההסרה שלו, ואז יסיר אותו מה-heap ומה-stack.
כששרשור אחר צריך להסיר Message, הוא לא מחלץ אותו מיד ממבנה הנתונים. במקום זאת, הוא מבצע את הפעולות הבאות:
- הסרה לוגית: ה-thread משתמש ב-CAS כדי להגדיר באופן אטומי את דגל ההסרה של
Messageמ-false ל-true. ה-Messageנשאר במבנה הנתונים כהוכחה להסרה בהמתנה, מה שנקרא "מצבה". ברגע ש-Messageמסומן להסרה, DeliQueue מתייחס אליו כאילו הוא כבר לא קיים בתור בכל פעם שהוא נמצא. - ניקוי מושהה: ההסרה בפועל ממבנה הנתונים היא באחריות ה-thread של
Looperוהיא מושהית עד לשלב מאוחר יותר. במקום לשנות את המחסנית או את הערימה, ה-thread שמסיר מוסיף את ה-Messageלמחסנית אחרת של רשימה חופשית ללא נעילה. - הסרה מבנית: רק
Looperיכול לקיים אינטראקציה עם הערימה או להסיר רכיבים מהמחסנית. כשהוא מתעורר, הוא מנקה את רשימת הפריטים הפנויים ומעבד את ה-Messageשהיו בה. לאחר מכן, כלMessageמנותק מהמחסנית ומוסר מהערימה.
הגישה הזו שומרת על כל הניהול של ה-heap ב-thread יחיד. הוא מצמצם את מספר הפעולות בו-זמנית ואת מחסומי הזיכרון הנדרשים, וכך הופך את הנתיב הקריטי למהיר ופשוט יותר.
מעבר: מרוצי נתונים שפירים במודל הזיכרון של Java
רוב ממשקי ה-API בו-זמניים, כמו Future בספרייה הרגילה של Java, או Job ו-Deferred של Kotlin, כוללים מנגנון לביטול העבודה לפני שהיא מסתיימת. מופע של אחת מהמחלקות האלה תואם 1:1 ליחידה של עבודה בסיסית, וקריאה ל-cancel באובייקט מבטלת את הפעולות הספציפיות שמשויכות אליהם.
במכשירי Android של היום יש מעבדים מרובי ליבות ואיסוף זבל בו-זמני בחלוקה לדורות. אבל כש-Android פותחה לראשונה, היה יקר מדי להקצות אובייקט אחד לכל יחידת עבודה. לכן, Handler של Android תומך בביטול באמצעות עומסי יתר רבים של removeMessages – במקום להסיר Message ספציפי, הוא מסיר את כל ה-Message שתואמים לקריטריונים שצוינו. בפועל, צריך לעבור על כל ה-Message שהוכנסו לפני הקריאה ל-removeMessages ולהסיר את אלה שתואמים.
כשמבצעים איטרציה קדימה, שרשור דורש רק פעולה אטומית מסודרת אחת, כדי לקרוא את הראש הנוכחי של המחסנית. אחרי זה, קריאות רגילות של שדות משמשות כדי למצוא את ה-Message הבא. אם ה-thread של Looper משנה את השדות של next בזמן הסרת Message, הכתיבה של Looper והקריאה של thread אחר לא מסונכרנות – זהו מרוץ נתונים. בדרך כלל, מרוץ נתונים הוא באג חמור שיכול לגרום לבעיות גדולות באפליקציה – דליפות, לולאות אינסופיות, קריסות, קפיאות ועוד. עם זאת, בתנאים מסוימים, מרוצי נתונים יכולים להיות שפירים בתוך מודל הזיכרון של Java. נניח שאנחנו מתחילים עם ערימה של:

אנחנו מבצעים קריאה אטומית של הראש, ורואים את A. המצביע הבא של A מצביע על B. בזמן שאנחנו מעבדים את B, יכול להיות שהלולאה תסיר את B ו-C, על ידי עדכון של A כך שיצביע על C ואז על D.
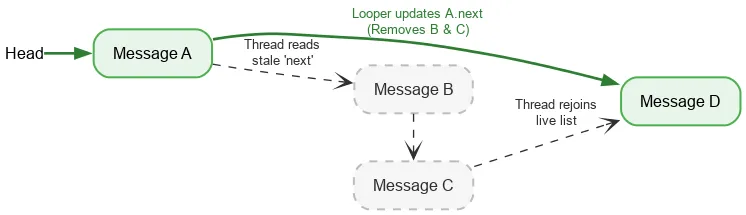
למרות ש-B ו-C הוסרו באופן לוגי, B שומר על המצביע הבא שלו ל-C, ו-C ל-D. השרשור של הקריאה ממשיך לעבור דרך הצמתים שהוסרו ונותקו, ובסופו של דבר מצטרף מחדש למחסנית הפעילה ב-D.
התכנון של DeliQueue מאפשר לטפל במרוצים בין מעבר להסרה, וכך מאפשר איטרציה בטוחה ללא נעילה.
Quitting: Native refcount
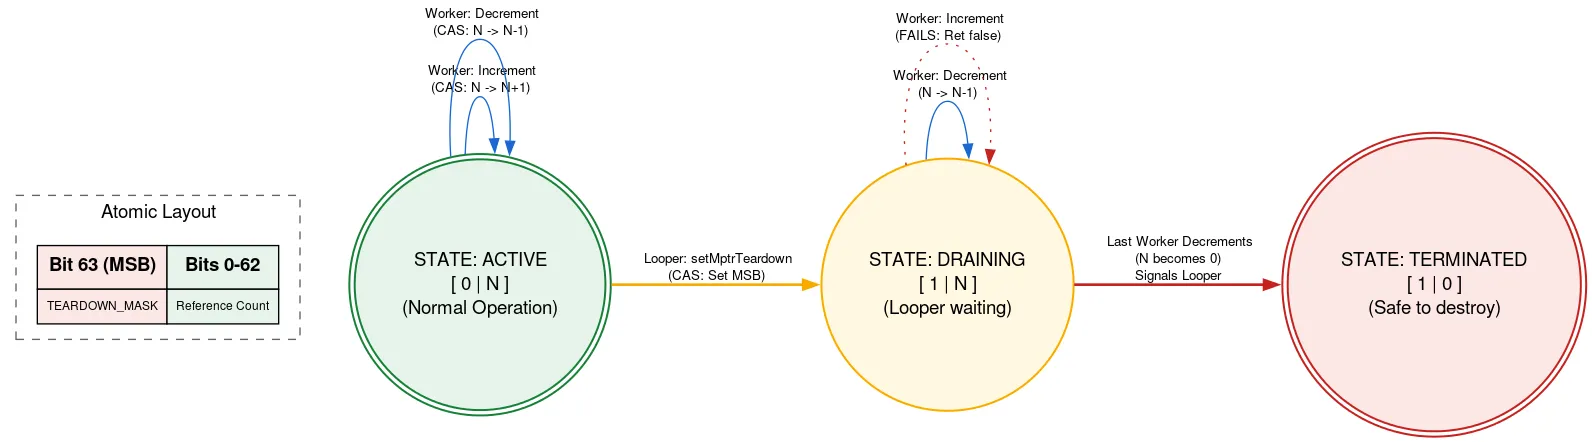
Looper מגובה בהקצאה מקומית שצריך לשחרר באופן ידני אחרי ש-Looper נסגר. אם שרשור אחר מוסיף Message בזמן שה-Looper נסגר, הוא יכול להשתמש בהקצאה המקורית אחרי שהיא מתפנה, וזו הפרה של בטיחות הזיכרון. אנחנו מונעים את זה באמצעות ספירת הפניות מתויגת, שבה ביט אחד של האטום משמש כדי לציין אם ה-Looper נסגר.
לפני השימוש בהקצאה המקורית, שרשור קורא את ה-refcount atomic. אם הביט של היציאה מוגדר, הפונקציה מחזירה שה-Looper יוצא ושאסור להשתמש בהקצאה המקורית. אם לא, הוא מנסה לבצע CAS כדי להגדיל את מספר השרשורים הפעילים באמצעות ההקצאה המקורית. אחרי שהיא מסיימת את הפעולה, היא מפחיתה את הספירה. אם סיבית היציאה הוגדרה אחרי ההגדלה שלה אבל לפני ההפחתה, והספירה היא עכשיו אפס, היא מעירה את השרשור Looper.
כשהשרשור של Looper מוכן ליציאה, הוא משתמש ב-CAS כדי להגדיר את סיבית היציאה ב-atomic. אם מספר ההפניות היה 0, אפשר להמשיך ולשחרר את ההקצאה המקורית. אחרת, הוא נשאר במצב המתנה, בידיעה שהוא יופעל כשהמשתמש האחרון בהקצאה המקורית יקטין את מספר ההפניות. בגישה הזו, ה-thread של Looper ממתין להתקדמות של ה-threads האחרים, אבל רק כשהוא נסגר. זה קורה רק פעם אחת ולא משפיע על הביצועים, והקוד האחר לשימוש בהקצאה המקורית נשאר ללא נעילה.
יש עוד הרבה טריקים ומורכבות בהטמעה. כדי לקבל מידע נוסף על DeliQueue, אפשר לעיין בקוד המקור.
אופטימיזציה: תכנות ללא הסתעפויות
במהלך הפיתוח והבדיקה של DeliQueue, הצוות הריץ הרבה נקודות השוואה וניתח בקפידה את הקוד החדש. בעיה אחת שזוהתה באמצעות הכלי simpleperf הייתה ניקויים של צינור עיבוד הנתונים שנגרמו על ידי קוד ההשוואה Message.
משווה סטנדרטי משתמש בקפיצות מותנות, כשהתנאי להחלטה איזה Message מגיע קודם מפושט בהמשך:
static int compareMessages(@NonNull Message m1, @NonNull Message m2) {
    if (m1 == m2) {
        return 0;
    }

    // Primary queue order is by when.
    // Messages with an earlier when should come first in the queue.
    final long whenDiff = m1.when - m2.when;
    if (whenDiff > 0) return 1;
    if (whenDiff < 0) return -1;

    // Secondary queue order is by insert sequence.
    // If two messages were inserted with the same `when`, the one inserted
    // first should come first in the queue.
    final long insertSeqDiff = m1.insertSeq - m2.insertSeq;
    if (insertSeqDiff > 0) return 1;
    if (insertSeqDiff < 0) return -1;

    return 0;
}
הקוד הזה עובר קומפילציה לקפיצות מותנות (הוראות b.le ו-cbnz). כשהמעבד נתקל בהסתעפות מותנית, הוא לא יכול לדעת אם ההסתעפות תתבצע עד שהתנאי יחושב, ולכן הוא לא יודע איזו הוראה לקרוא בהמשך, וצריך לנחש באמצעות טכניקה שנקראת חיזוי הסתעפות. במקרה כמו חיפוש בינארי, כיוון ההסתעפות יהיה שונה בכל שלב באופן בלתי צפוי, כך שסביר להניח שמחצית מהתחזיות יהיו שגויות. חיזוי הסתעפויות הוא בדרך כלל לא יעיל באלגוריתמים של חיפוש ומיון (כמו זה שמשמש בערימת מינימום), כי העלות של ניחוש שגוי גדולה יותר מהשיפור שנובע מניחוש נכון. כשהחיזוי של המסתעף שגוי, הוא צריך למחוק את העבודה שביצע אחרי שהניח את הערך החזוי, ולהתחיל שוב מהנתיב שנבחר בפועל – זה נקרא ניקוי צינור עיבוד נתונים.
כדי למצוא את הבעיה הזו, יצרנו פרופיל של נקודות ההשוואה שלנו באמצעות מונה הביצועים branch-misses, שמתעד דוחות קריסות שבהם החיזוי של ה-branch predictor שגוי. לאחר מכן הצגנו את התוצאות באמצעות Google pprof, כמו שמוצג כאן:
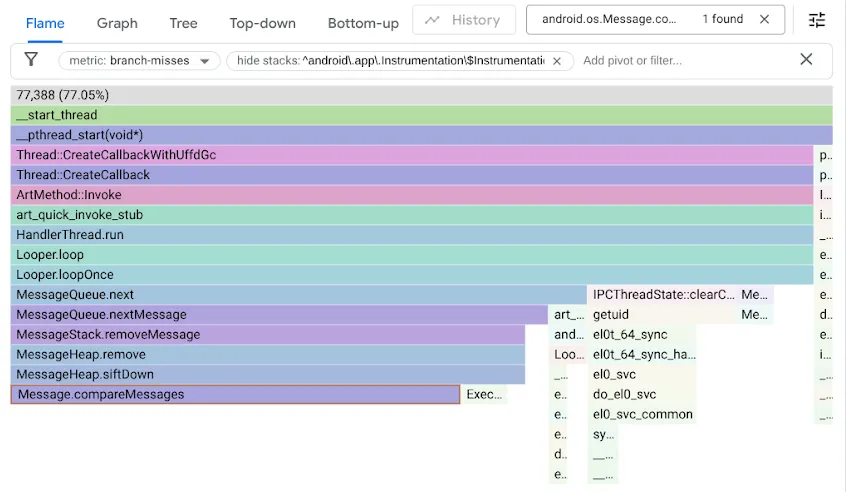
זוכרים שבקוד המקורי של MessageQueue השתמשנו ברשימה מקושרת אחת לתור המסודר? ההוספה תעבור על הרשימה בסדר ממוין כחיפוש לינארי, תעצור ברכיב הראשון שעבר את נקודת ההוספה ותקשר את ה-Message החדש לפניו. כדי להסיר את ה-head, פשוט צריך לבטל את הקישור שלו. לעומת זאת, DeliQueue משתמש בערימת מינימום, שבה שינויים דורשים סידור מחדש של חלק מהרכיבים (סינון למעלה או למטה) עם מורכבות לוגריתמית במבנה נתונים מאוזן, שבו לכל השוואה יש סיכוי שווה להפנות את המעבר לצאצא שמאלי או לצאצא ימני. האלגוריתם החדש מהיר יותר באופן אסימפטוטי, אבל חושף צוואר בקבוק חדש כי קוד החיפוש נתקע בגלל פספוסים בהסתעפויות בחצי מהזמן.
כשהבנו שהחמצות של הסתעפויות מאטות את קוד הערימה, ביצענו אופטימיזציה של הקוד באמצעות תכנות ללא הסתעפויות:
// Branchless Logic
static int compareMessages(@NonNull Message m1, @NonNull Message m2) {
    final long when1 = m1.when;
    final long when2 = m2.when;
    final long insertSeq1 = m1.insertSeq;
    final long insertSeq2 = m2.insertSeq;

    // signum returns the sign (-1, 0, 1) of the argument,
    // and is implemented as pure arithmetic:
    // ((num >> 63) | (-num >>> 63))
    final int whenSign = Long.signum(when1 - when2);
    final int insertSeqSign = Long.signum(insertSeq1 - insertSeq2);

    // whenSign takes precedence over insertSeqSign,
    // so the formula below is such that insertSeqSign only matters
    // as a tie-breaker if whenSign is 0.
    return whenSign * 2 + insertSeqSign;
}
כדי להבין את האופטימיזציה, מפרקים את שתי הדוגמאות ב-Compiler Explorer ומשתמשים ב-LLVM-MCA, סימולטור של מעבד שיכול ליצור ציר זמן משוער של מחזורי מעבד.
The original code:
Index     01234567890123
[0,0]     DeER .    .  .   sub  x0, x2, x3
[0,1]     D=eER.    .  .   cmp  x0, #0
[0,2]     D==eER    .  .   cset w0, ne
[0,3]     .D==eER   .  .   cneg w0, w0, lt
[0,4]     .D===eER  .  .   cmp  w0, #0
[0,5]     .D====eER .  .   b.le #12
[0,6]     . DeE---R .  .   mov  w1, #1
[0,7]     . DeE---R .  .   b    #48
[0,8]     . D==eE-R .  .   tbz  w0, #31, #12
[0,9]     .  DeE--R .  .   mov  w1, #-1
[0,10]    .  DeE--R .  .   b    #36
[0,11]    .  D=eE-R .  .   sub  x0, x4, x5
[0,12]    .   D=eER .  .   cmp  x0, #0
[0,13]    .   D==eER.  .   cset w0, ne
[0,14]    .   D===eER  .   cneg w0, w0, lt
[0,15]    .    D===eER .   cmp  w0, #0
[0,16]    .    D====eER.   csetm        w1, lt
[0,17]    .    D===eE-R.   cmp  w0, #0
[0,18]    .    .D===eER.   csinc        w1, w1, wzr, le
[0,19]    .    .D====eER   mov  x0, x1
[0,20]    .    .DeE----R   ret
שימו לב להסתעפות המותנית האחת, b.le, שמונעת השוואה של השדות insertSeq אם התוצאה כבר ידועה מהשוואת השדות when.
The branchless code:
Index     012345678
[0,0]     DeER .  .   sub       x0, x2, x3
[0,1]     DeER .  .   sub       x1, x4, x5
[0,2]     D=eER.  .   cmp       x0, #0
[0,3]     .D=eER  .   cset      w0, ne
[0,4]     .D==eER .   cneg      w0, w0, lt
[0,5]     .DeE--R .   cmp       x1, #0
[0,6]     . DeE-R .   cset      w1, ne
[0,7]     . D=eER .   cneg      w1, w1, lt
[0,8]     . D==eeER   add       w0, w1, w0, lsl #1
[0,9]     .  DeE--R   ret
כאן, ההטמעה ללא הסתעפות דורשת פחות מחזורים והוראות אפילו מהנתיב הקצר ביותר בקוד עם הסתעפות – היא טובה יותר בכל המקרים. ההטמעה המהירה יותר, בשילוב עם ביטול ההסתעפויות שחזו אותן באופן שגוי, הובילו לשיפור של פי 5 בחלק מהבנצ'מרקים שלנו.
עם זאת, לא תמיד אפשר להשתמש בשיטה הזו. בגישות ללא הסתעפות בדרך כלל צריך לבצע עבודה שתיזרק, ואם אפשר לחזות את ההסתעפות ברוב המקרים, העבודה המיותרת הזו יכולה להאט את הקוד. בנוסף, הסרת הסתעפות גורמת לעיתים קרובות לתלות בנתונים. מעבדים מודרניים מבצעים כמה פעולות בכל מחזור, אבל הם לא יכולים לבצע הוראה עד שהקלטים שלה מהוראה קודמת מוכנים. לעומת זאת, מעבד (CPU) יכול לשער לגבי נתונים בענפים, ולהמשיך לעבוד אם הענף נחזה בצורה נכונה.
בדיקות ואימות
אימות התקינות של אלגוריתמים ללא נעילה הוא קשה מאוד.
בנוסף לבדיקות יחידה סטנדרטיות לאימות רציף במהלך הפיתוח, כתבנו גם בדיקות מאמץ קפדניות כדי לאמת את המשתנים הקבועים של התור ולנסות לגרום למצבי מרוץ אם הם קיימים. במעבדות הבדיקה שלנו, אנחנו יכולים להריץ מיליוני מכונות לבדיקה במכשירים מדומים ובחומרה אמיתית.
בעזרת Java ThreadSanitizer (JTSan), יכולנו להשתמש באותן בדיקות כדי לזהות גם כמה מצבי מרוץ נתונים בקוד שלנו. JTSan לא מצא מצבי מרוץ בעייתיים ב-DeliQueue, אבל באופן מפתיע, הוא זיהה שני באגים של בו-זמניות במסגרת Robolectric, ותיקנו אותם מיד.
כדי לשפר את יכולות ניפוי הבאגים שלנו, פיתחנו כלי ניתוח חדשים. למטה מוצגת דוגמה לבעיה בקוד של פלטפורמת Android, שבה שרשור אחד מעמיס על שרשור אחר עם Message, מה שגורם לצבר גדול של משימות. אפשר לראות את זה ב-Perfetto בזכות תכונת האינסטרומנטציה MessageQueue שהוסיפו.
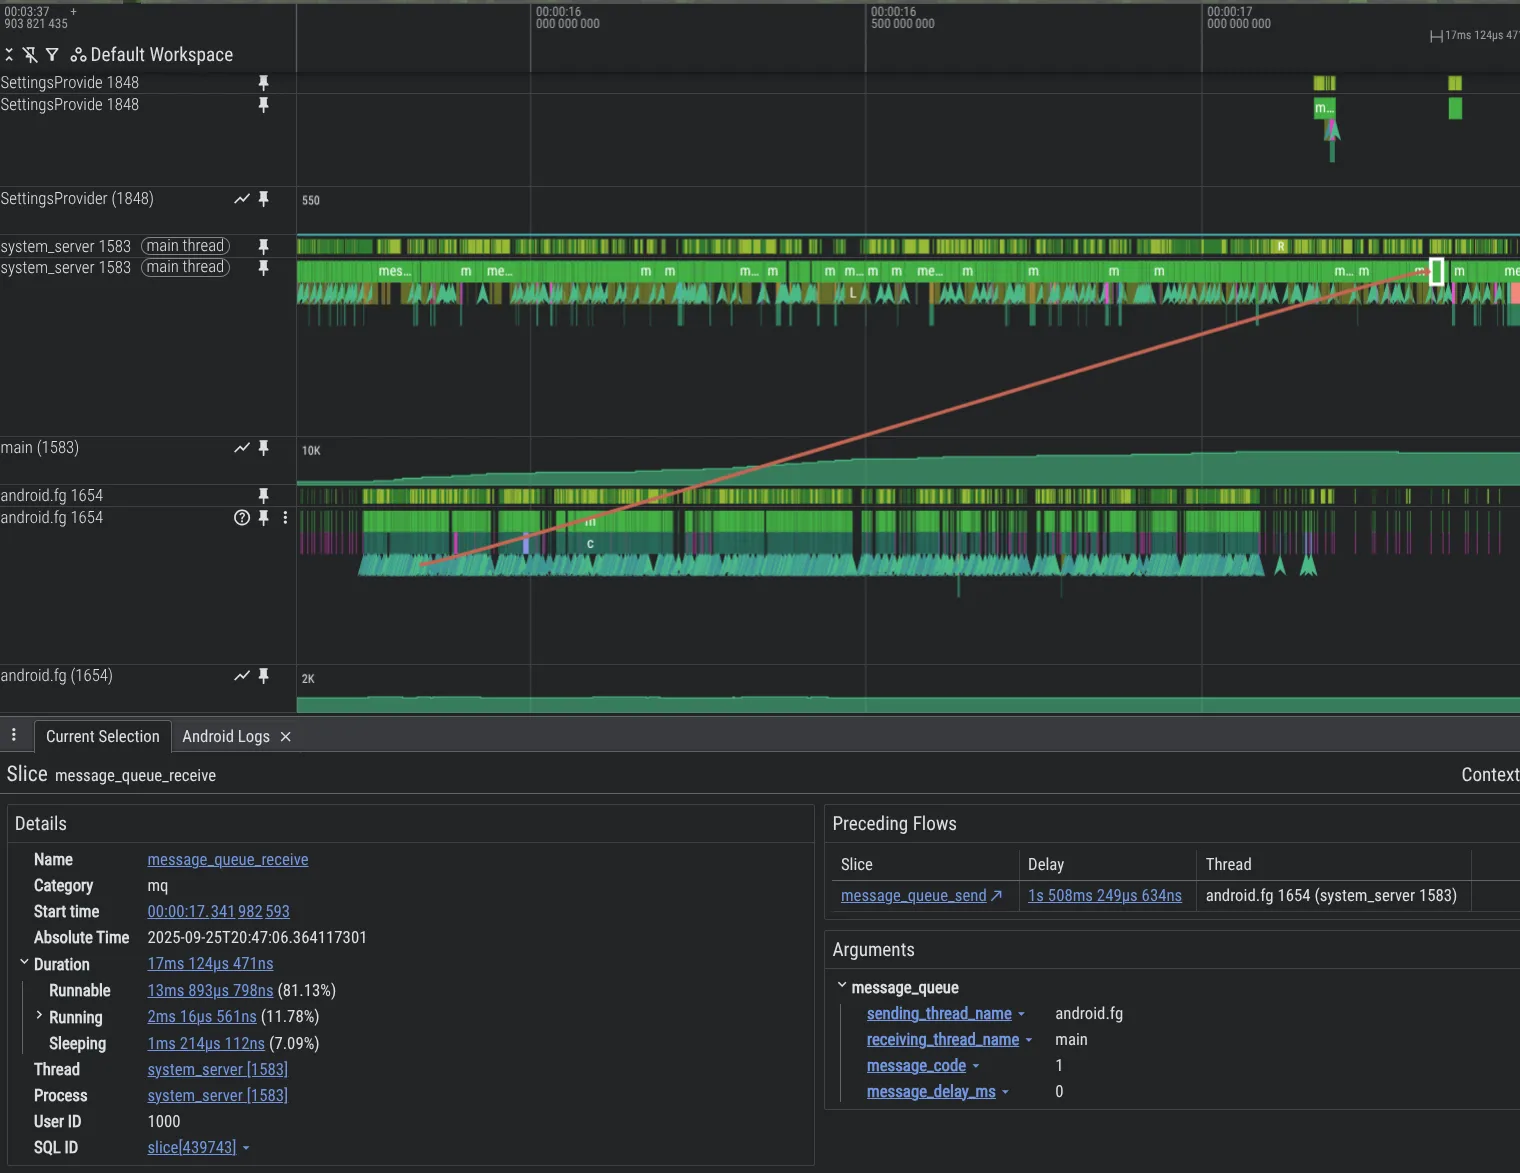
כדי להפעיל מעקב של MessageQueue בתהליך system_server, צריך לכלול את הפרטים הבאים בהגדרות של Perfetto:
data_sources {
  config {
    name: "track_event"
    target_buffer: 0  # Change this per your buffers configuration
    track_event_config {
      enabled_categories: "mq"
    }
  }
}
השפעה
DeliQueue משפר את ביצועי המערכת והאפליקציות על ידי הסרת נעילות מ-MessageQueue.
- בדיקות ביצועים סינתטיות: הוספות מרובות-תהליכים לתורים עמוסים מתבצעות עד פי 5,000 מהר יותר בהשוואה ל-
MessageQueueהקודם, בזכות בו-זמניות משופרת (מחסנית Treiber) והוספות מהירות יותר (ערימת מינימום). - במעקבי Perfetto שנאספו מבודקים פנימיים של גרסת הבטא, אנחנו רואים ירידה של 15% בזמן שהשרשור הראשי של האפליקציה מבלה במצב של תחרות על נעילה.
- באותם מכשירי בדיקה, ההפחתה בתחרות על נעילות מובילה לשיפורים משמעותיים בחוויית המשתמש, כמו:
- 4%- פריימים שהוחמצו באפליקציות.
- 7.7% פחות פריימים שהוחמצו באינטראקציות עם ממשק המשתמש של המערכת ועם מרכז האפליקציות.
- -9.1% בזמן שחולף מהפעלת האפליקציה ועד לציור הפריים הראשון, באחוזון ה-95.
השלבים הבאים
אנחנו משיקים את DeliQueue באפליקציות ב-Android 17. מפתחי אפליקציות צריכים לעיין במאמר "הכנת האפליקציה ל-MessageQueue החדש ללא נעילה" בבלוג של מפתחי Android כדי ללמוד איך לבדוק את האפליקציות שלהם.
מקורות מידע
[1] Treiber, R.K., 1986. תכנות מערכות: התמודדות עם מקביליות. International Business Machines Incorporated, Thomas J. Watson Research Center.
[2] Goetz, B., Peierls, T., Bloch, J., Bowbeer, J., Holmes, D., & Lea, D. (2006). Java Concurrency in Practice. Addison-Wesley Professional.
-
 חדשות על המוצר
אפליקציות שמטרגטות את הגרסה הבאה של Android לא יוכלו יותר לכתוב ישירות לאנשי קשר באמצעות ההרשאה WRITE_CONTACTS.
Roxanna Aliabadi Walker • משך הקריאה: 6 דקות -
 חדשות על המוצר
ככל שהפיתוח של סוכני AI מתקדם, הנדסת Android מגיעה לתחום חדש ומלהיב: מעבר מהשלמת קוד מסייעת לסוכנים שמבצעים משימות מקצה לקצה לפי ההנחיות שלכם. אתם יכולים לבחור את המודלים והסוכנים שאתם רוצים להשתמש בהם, וליהנות מגמישות מלאה.
Jason Buchel • משך הקריאה: 3 דקות -
 חדשות על המוצר
היום שיתפנו אתכם בפרק הבא בחזון שלנו, שבו אנחנו הופכים את Google Play ל"יותר מחנות". החל מהכרטיסייה "הדף שלי", שהיא עכשיו בסיס האם האישי של יותר מ-250 מיליון משתמשים פעילים בחודש, ועד לפלטפורמת הגיימינג המאוחדת שלנו שמחברת בין יותר מ-700 מיליון פרופילים ב-Play Games, Google Play נותנת מענה למשתמשים בכל מקום שבו הם נמצאים.
Paul Feng • משך הקריאה: 3 דקות
רוצים לקבל טיפים עדכניים לפיתוח Android ישירות לאימייל כל שבוע?