Android 17 では、SDK 37 以降をターゲットとするアプリは、ロックフリー実装の MessageQueue の新しい実装を受け取ります。新しい実装では、パフォーマンスが向上し、フレームの欠落が減少しますが、MessageQueue のプライベート フィールドとメソッドを反映するクライアントが破損する可能性があります。この動作変更の詳細と、影響を軽減する方法については、MessageQueue の動作変更に関するドキュメントをご覧ください。この技術ブログ投稿では、MessageQueue の再アーキテクチャの概要と、Perfetto を使用してロック競合の問題を分析する方法について説明します。
Looper は、すべての Android アプリの UI スレッドを駆動します。MessageQueue から作業を pull し、Handler にディスパッチして、繰り返します。20 年間、MessageQueue は単一のモニターロック(synchronized コードブロック)を使用して状態を保護していました。
Android 17 では、このコンポーネントに大幅なアップデートが導入されています。DeliQueue というロックフリーの実装です。
この投稿では、ロックが UI のパフォーマンスに与える影響、Perfetto を使用してこれらの問題を分析する方法、Android のメインスレッドを改善するために使用される特定のアルゴリズムと最適化について説明します。
問題: ロックの競合と優先度の逆転
以前の MessageQueue は、単一のロックで保護された優先度付きキューとして機能していました。メインスレッドがキューのメンテナンスを実行しているときにバックグラウンド スレッドがメッセージを投稿すると、バックグラウンド スレッドがメインスレッドをブロックします。
2 つ以上のスレッドが同じロックの排他的使用を競合している場合、これをロック競合と呼びます。この競合により優先順位の逆転が発生し、UI ジャンクなどのパフォーマンスの問題につながる可能性があります。
優先度逆転は、優先度の高いスレッド(UI スレッドなど)が優先度の低いスレッドを待機させられる場合に発生します。次のシーケンスを考えてみましょう。
- 優先度の低いバックグラウンド スレッドが、
MessageQueueロックを取得して、実行した処理の結果をポストします。 - 中優先度のスレッドが実行可能になり、カーネルのスケジューラが CPU 時間を割り当て、低優先度のスレッドをプリエンプトします。
- 優先度の高い UI スレッドは、現在のタスクを完了してキューからの読み取りを試みますが、優先度の低いスレッドがロックを保持しているため、ブロックされます。
優先度の低いスレッドが UI スレッドをブロックし、優先度が中程度の処理がさらに遅延します。
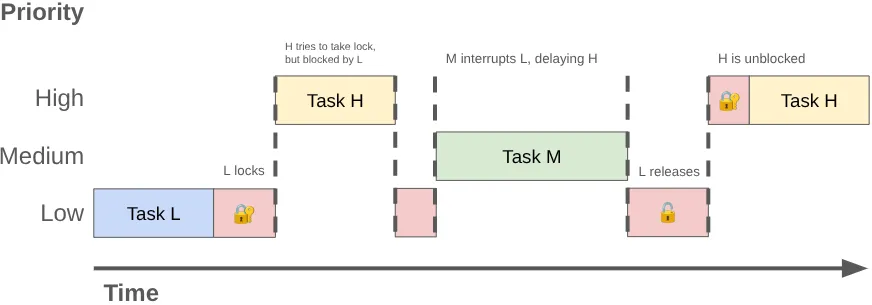
Perfetto を使用して競合を分析する
これらの問題は、Perfetto を使用して診断できます。標準トレースでは、モニターロックでブロックされたスレッドはスリープ状態になり、Perfetto にはロック所有者を示すスライスが表示されます。
トレースデータをクエリするときは、「monitor contention with …」という名前のスライスを探します。この名前の後に、ロックを所有するスレッドの名前と、ロックが取得されたコードサイトが続きます。
ケーススタディ: ランチャーのジャンク
例として、Google Pixel でカメラアプリを使って写真を撮った直後にホーム画面に移動したときに、ユーザーがジャンクを経験したトレースを分析してみましょう。以下は、フレーム落ちに至るまでのイベントを示す Perfetto のスクリーンショットです。
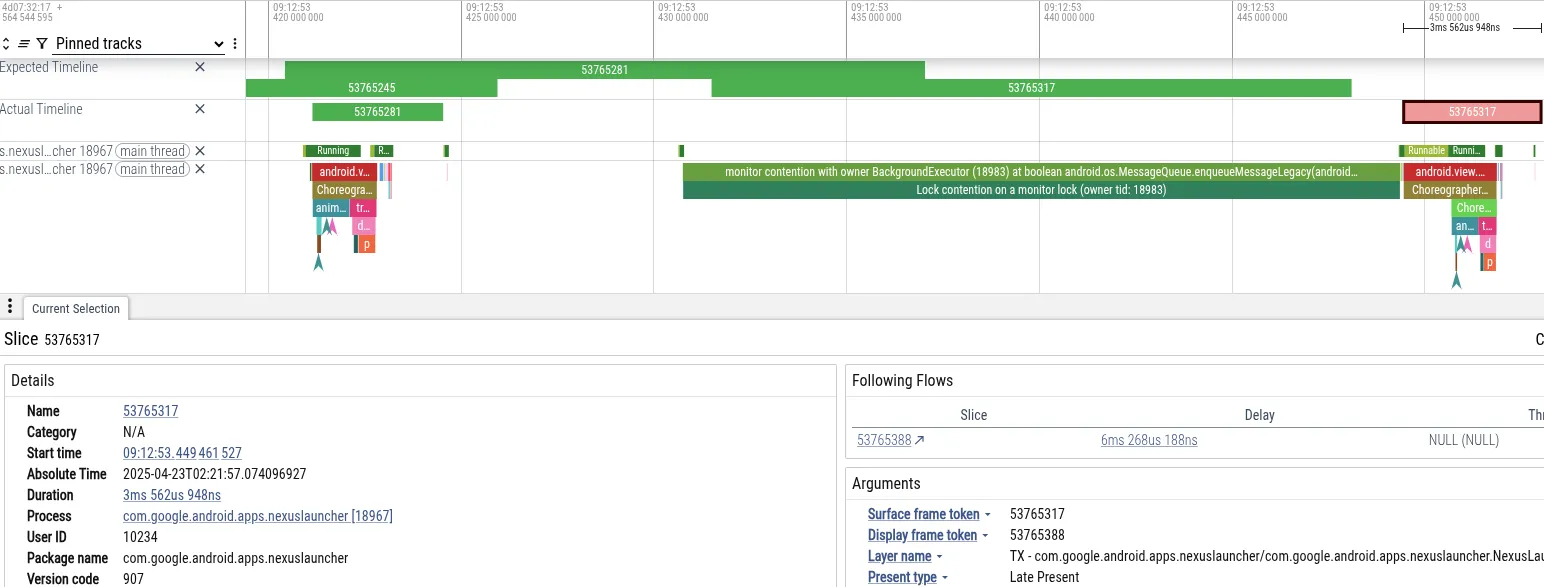
- 症状: ランチャーのメインスレッドがフレームの期限に間に合わなかった。18 ミリ秒間ブロックされました。これは、60 Hz のレンダリングに必要な 16 ミリ秒の期限を超えています。
- 診断: Perfetto で、メインスレッドが
MessageQueueロックでブロックされていることがわかりました。「BackgroundExecutor」スレッドがロックを所有していました。 - 根本原因: BackgroundExecutor は Process.THREAD_PRIORITY_BACKGROUND(非常に低い優先度)で実行されます。緊急でないタスク(アプリの使用量上限の確認)を実行した。同時に、中優先度のスレッドが CPU 時間を使用してカメラからのデータを処理していました。OS スケジューラが BackgroundExecutor スレッドをプリエンプトして、カメラ スレッドを実行しました。
このシーケンスにより、ランチャーの UI スレッド(高優先度)が、カメラのワーカー スレッド(中優先度)によって間接的にブロックされることになりました。カメラのワーカー スレッドは、ランチャーのバックグラウンド スレッド(低優先度)がロックを解放するのを妨げていました。
PerfettoSQL を使用してトレースをクエリする
PerfettoSQL を使用して、特定のパターンについてトレースデータをクエリできます。これは、ユーザー デバイスやテストから大量のトレースがあり、問題を示す特定のトレースを検索する場合に便利です。
たとえば、次のクエリは、フレーム落ち(ジャンク)と同時に発生した MessageQueue の競合を検出します。
INCLUDE PERFETTO MODULE android.monitor_contention;
INCLUDE PERFETTO MODULE android.frames.jank_type;

SELECT
  process_name,
  -- Convert duration from nanoseconds to milliseconds
  SUM(dur) / 1000000 AS sum_dur_ms,
  COUNT(*) AS count_contention
FROM android_monitor_contention
WHERE is_blocked_thread_main
AND short_blocked_method LIKE "%MessageQueue%"

-- Only look at app processes that had jank
AND upid IN (
  SELECT DISTINCT(upid)
  FROM actual_frame_timeline_slice
  WHERE android_is_app_jank_type(jank_type) = TRUE
)
GROUP BY process_name
ORDER BY SUM(dur) DESC;
このより複雑な例では、複数のテーブルにまたがるトレースデータを結合して、アプリの起動中に MessageQueue の競合を特定します。
INCLUDE PERFETTO MODULE android.monitor_contention;
INCLUDE PERFETTO MODULE android.startup.startups;

-- Join package and process information for startups
DROP VIEW IF EXISTS startups;
CREATE VIEW startups AS
SELECT startup_id, ts, dur, upid
FROM android_startups
JOIN android_startup_processes USING(startup_id);

-- Intersect monitor contention with startups in the same process.
DROP TABLE IF EXISTS monitor_contention_during_startup;
CREATE VIRTUAL TABLE monitor_contention_during_startup
USING SPAN_JOIN(android_monitor_contention PARTITIONED upid, startups PARTITIONED upid);

SELECT
  process_name,
  SUM(dur) / 1000000 AS sum_dur_ms,
  COUNT(*) AS count_contention
FROM monitor_contention_during_startup
WHERE is_blocked_thread_main
AND short_blocked_method LIKE "%MessageQueue%"
GROUP BY process_name
ORDER BY SUM(dur) DESC;
お好みの LLM を使用して PerfettoSQL クエリを記述し、他のパターンを見つけることができます。
Google では、BigTrace を使用して、数百万件のトレースに対して PerfettoSQL クエリを実行しています。その結果、私たちが目にしたものは、実際にはシステム上の問題であることが確認されました。このデータから、MessageQueue のロック競合がエコシステム全体のユーザーに影響を与えていることが明らかになり、根本的なアーキテクチャの変更が必要であることが裏付けられました。
解決策: ロックフリーの同時実行
MessageQueue の競合問題に対処するため、ロックフリーのデータ構造を実装し、排他的ロックではなくアトミック メモリ オペレーションを使用して共有状態へのアクセスを同期しました。データ構造またはアルゴリズムがロックフリーであるとは、他のスレッドのスケジューリング動作に関係なく、少なくとも 1 つのスレッドが常に処理を進めることができることを意味します。この特性は一般的に実現が難しく、ほとんどのコードでは追求する価値がありません。
アトミック プリミティブ
ロックフリー ソフトウェアは、ハードウェアが提供するアトミックな読み取り / 変更 / 書き込みプリミティブに依存することがよくあります。
古い世代の ARM64 CPU では、アトミックは Load-Link / Store-Conditional(LL/SC)ループを使用していました。CPU は値を読み込み、アドレスをマークします。別のスレッドがそのアドレスに書き込むと、ストアは失敗し、ループが再試行されます。スレッドは別のスレッドを待たずに試行を続けて成功できるため、このオペレーションはロックフリーです。
ARM64 LL/SC loop example
retry:
    ldxr    x0, [x1]        // Load exclusive from address x1 to x0
    add     x0, x0, #1      // Increment value by 1
    stxr    w2, x0, [x1]    // Store exclusive.
                            // w2 gets 0 on success, 1 on failure
cbnz w2, retry // If w2 is non-zero (failed), branch to retr新しい ARM アーキテクチャ(ARMv8.1)は、Large System Extensions(LSE)をサポートしています。これには、Compare-And-Swap(CAS)または Load-And-Add(以下を参照)の形式の命令が含まれています。Android 17 では、Android ランタイム(ART)コンパイラに、LSE がサポートされていることを検出して最適化された命令を出力するサポートが追加されました。
/ ARMv8.1 LSE atomic example
ldadd   x0, x1, [x2]    // Atomic load-add.
                        // Faster, no loop required.
Google のベンチマークでは、CAS を使用する競合の多いコードは、LL/SC バリアントよりも約 3 倍高速化されています。
Java プログラミング言語は、これらの特殊な CPU 命令に依存する java.util.concurrent.atomic を介してアトミック プリミティブを提供します。
データ構造: DeliQueue
MessageQueue からロック競合を排除するため、Google のエンジニアは DeliQueue と呼ばれる新しいデータ構造を設計しました。DeliQueue は、Message の挿入と Message の処理を分離します。
Messages(Treiber スタック)のリスト: ロックフリー スタック。どのスレッドでも、競合することなく新しいMessagesをここに push できます。- 優先度付きキュー(Min-heap): 処理する
Messagesのヒープ。Looper スレッドによって排他的に所有されます(したがって、アクセスに同期やロックは必要ありません)。
エンキュー: Treiber スタックへの push
Messages のリストは、Treiber スタック [1] に保持されます。これは、CAS ループを使用してヘッドポインタを更新するロックフリー スタックです。
public class TreiberStack <E> {
    AtomicReference<Node<E>> top =
            new AtomicReference<Node<E>>();
    public void push(E item) {
        Node<E> newHead = new Node<E>(item);
        Node<E> oldHead;
        do {
            oldHead = top.get();
            newHead.next = oldHead;
        } while (!top.compareAndSet(oldHead, newHead));
    }

    public E pop() {
        Node<E> oldHead;
        Node<E> newHead;
        do {
            oldHead = top.get();
            if (oldHead == null) return null;
            newHead = oldHead.next;
        } while (!top.compareAndSet(oldHead, newHead));
        return oldHead.item;
    }
}
Java Concurrency in Practice [2] に基づくソースコード。オンラインで入手可能で、パブリック ドメインにリリースされています。
どのプロデューサーも、新しい Message をいつでもスタックに push できます。これは、デリカウンターでチケットを引くようなものです。番号は来店したタイミングで決まりますが、料理を受け取る順番は一致する必要はありません。これはリンクされたスタックであるため、すべての Message はサブスタックです。ヘッドを追跡して前方に反復処理することで、任意の時点での Message キューの状態を確認できます。トラバーサル中に追加された場合でも、新しい Message が上部にプッシュされることはありません。
デキュー: 最小ヒープへの一括転送
処理する次の Message を見つけるために、Looper は Treiber スタックから新しい Message を処理します。この処理は、スタックの先頭から開始して、以前に処理した最後の Message が見つかるまで繰り返されます。Looper はスタックを下に移動しながら、Message を期限順の最小ヒープに挿入します。Looper はヒープを排他的に所有しているため、ロックやアトミックなしで Message を順序付けして処理します。
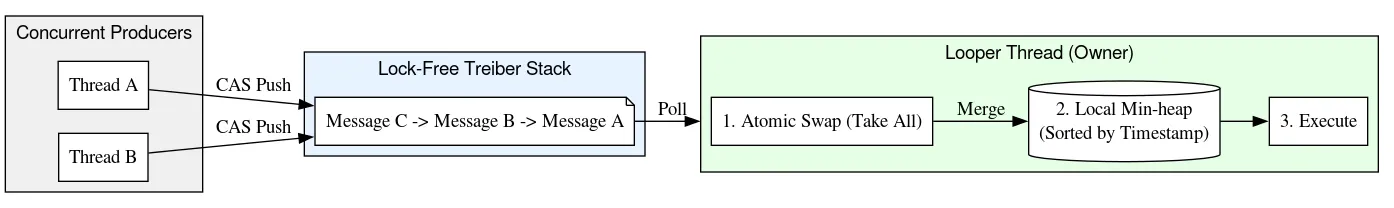
スタックをたどる際、Looper はスタックされた Message から前の へのリンクも作成し、二重リンクされたリストを形成します。リンクされたリストの作成は安全です。スタックの下を指すリンクは CAS を使用した Treiber スタック アルゴリズムを介して追加され、スタックの上を指すリンクは Looper スレッドによってのみ読み取りと変更が行われるためです。これらのバックリンクは、スタック内の任意のポイントから O(1) 時間で Message を削除するために使用されます。
この設計では、プロデューサー(キューに作業を投稿するスレッド)に対して O(1) の挿入、コンシューマー(Looper)に対して償却 O(log N) の処理が提供されます。
min-heap を使用して Message を並べ替えることで、従来の MessageQueue の根本的な欠陥も解決されます。従来の では、Message が単一リンクリスト(最上位をルートとする)に保持されていました。以前の実装では、先頭からの削除は O(1) でしたが、挿入は最悪の場合 O(N) であり、キューが過負荷になるとスケーリングが不十分でした。逆に、最小ヒープへの挿入と削除は対数的にスケーリングされるため、平均的なパフォーマンスは競合しますが、テール レイテンシは非常に優れています。
以前のバージョン(ロック済み)MessageQueue | DeliQueue | |
| 挿入 | O(N) | 呼び出しスレッドの場合は O(1)
|
| 頭から外す | O(1) | O(logN) |
以前のキューの実装では、プロデューサーとコンシューマーはロックを使用して、基盤となる単方向連結リストへの排他的アクセスを調整していました。DeliQueue では、Treiber スタックが同時アクセスを処理し、単一のコンシューマーが作業キューの順序付けを処理します。
削除: 廃棄レコードによる整合性
DeliQueue は、ロックフリーの Treiber スタックとシングルスレッドの min-heap を組み合わせたハイブリッド データ構造です。グローバル ロックを使用せずにこれら 2 つの構造を同期させることは、独自の課題となります。メッセージが物理的にスタックに存在していても、論理的にキューから削除されている可能性があるためです。
この問題を解決するために、DeliQueue は「tombstoning」と呼ばれる手法を使用します。各 Message は、前方ポインタと後方ポインタ、ヒープの配列内のインデックス、削除されたかどうかを示すブール値フラグを介して、スタック内の位置を追跡します。Message の実行準備が整うと、Looper スレッドは削除フラグを CAS し、ヒープとスタックから削除します。
別のスレッドが Message を削除する必要がある場合、データ構造からすぐに抽出されるわけではありません。代わりに、次の手順を行います。
- 論理的な削除: スレッドは CAS を使用して、
Messageの削除フラグを false から true にアトミックに設定します。Messageは、削除保留中の証拠としてデータ構造に残ります。これは、いわゆる「廃棄」です。Messageに削除フラグが設定されると、DeliQueue は、キューに存在しないものとして扱います。 - 遅延クリーンアップ: データ構造からの実際の削除は
Looperスレッドの役割であり、後で行われます。削除スレッドは、スタックまたはヒープを変更するのではなく、Messageを別のロックフリーのフリーリスト スタックに追加します。 - 構造的な削除:
Looperのみがヒープを操作したり、スタックから要素を削除したりできます。起動すると、フリーリストをクリアし、含まれていたMessageを処理します。各Messageはスタックからリンク解除され、ヒープから削除されます。
このアプローチでは、ヒープのすべての管理がシングルスレッドに保たれます。必要な同時実行オペレーションとメモリバリアの数を最小限に抑えることで、クリティカル パスを高速化、簡素化します。
トラバーサル: 害のない Java メモリモデルのデータ競合
Java 標準ライブラリの Future や Kotlin の Job、Deferred など、ほとんどの同時実行 API には、処理が完了する前にキャンセルするメカニズムが含まれています。これらのクラスのインスタンスは、基盤となる作業の単位と 1 対 1 で一致し、オブジェクトで cancel を呼び出すと、それに関連付けられた特定のオペレーションがキャンセルされます。
現在の Android デバイスには、マルチコア CPU と、同時実行の世代別ガベージ コレクションが搭載されています。しかし、Android が最初に開発されたとき、作業単位ごとに 1 つのオブジェクトを割り当てるのはコストがかかりすぎました。そのため、Android の Handler は、removeMessages の多数のオーバーロードを介したキャンセルをサポートしています。特定の Message を削除するのではなく、指定された条件に一致するすべての Message を削除します。実際には、removeMessages が呼び出される前に挿入されたすべての Message を反復処理し、一致するものを削除する必要があります。
前方に反復処理する場合、スレッドは、スタックの現在の先頭を読み取るために、1 つの順序付きアトミック オペレーションのみを必要とします。その後、通常のフィールド読み取りを使用して次の Message を検索します。Message の削除中に Looper スレッドが next フィールドを変更すると、Looper の書き込みと別のスレッドの読み取りが同期されません。これはデータ競合です。通常、データ競合は、アプリに大きな問題(リーク、無限ループ、クラッシュ、フリーズなど)を引き起こす可能性がある重大なバグです。ただし、特定の狭い条件下では、Java メモリモデル内でデータ競合が問題にならない場合があります。次のようなスタックから始めるとします。

ヘッドのアトミック読み取りを実行し、A を確認します。A の next ポインタは B を指しています。B を処理すると同時に、ルーパーは A を更新して C、D を指すようにすることで、B と C を削除する可能性があります。
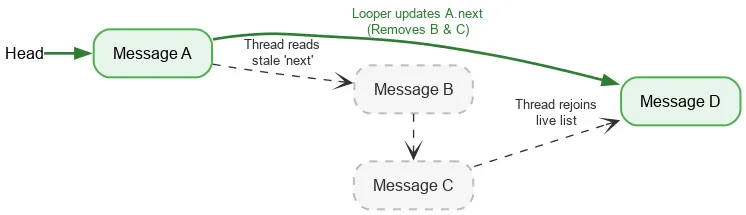
B と C は論理的に削除されていますが、B は C への次のポインタを保持し、C は D への次のポインタを保持しています。読み取りスレッドは、デタッチされた削除済みノードをトラバースし続け、最終的に D でライブスタックに再結合します。
DeliQueue は、トラバーサルと削除の間の競合を処理するように設計されているため、安全でロックフリーなイテレーションが可能です。
終了: ネイティブ参照カウント
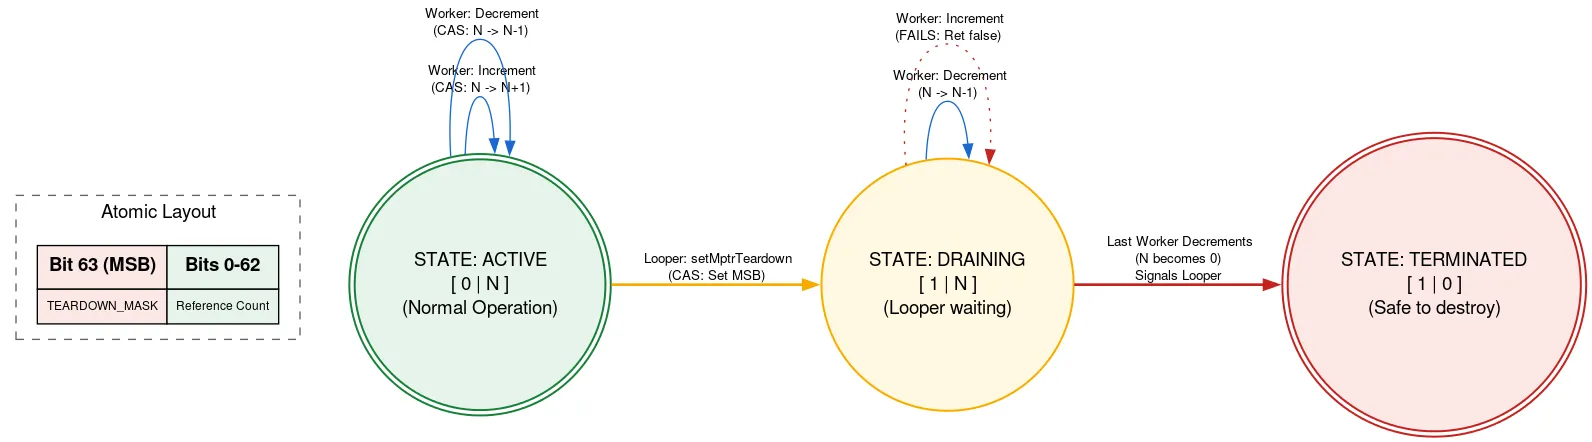
Looper はネイティブ割り当てによってサポートされています。この割り当ては、Looper が終了したら手動で解放する必要があります。Looper が終了する間に他のスレッドが Message を追加している場合、解放後にネイティブ割り当てを使用する可能性があり、メモリの安全性が損なわれます。これを防ぐために、タグ付き参照カウントを使用します。この場合、アトミックの 1 ビットを使用して、Looper が終了しているかどうかを示します。
ネイティブ割り当てを使用する前に、スレッドは refcount アトミックを読み取ります。終了ビットが設定されている場合、Looper が終了し、ネイティブ割り当てを使用できないことを返します。そうでない場合は、CAS を試行して、ネイティブ割り当てを使用するアクティブなスレッドの数を増やします。必要な処理が完了すると、カウントをデクリメントします。quitting ビットがインクリメント後、デクリメント前に設定され、カウントがゼロになった場合、Looper スレッドが起動します。
Looper スレッドが終了する準備が整うと、CAS を使用してアトミックに終了ビットを設定します。refcount が 0 の場合、ネイティブ割り当ての解放に進むことができます。それ以外の場合は、ネイティブ割り当ての最後のユーザーが refcount をデクリメントしたときに起動されることを認識して、自身をパークします。このアプローチでは、Looper スレッドは他のスレッドの進行を待機することになりますが、それは終了時に限られます。これは 1 回しか発生せず、パフォーマンスに影響しません。また、ネイティブ割り当てを使用する他のコードは完全にロックフリーに保たれます。
実装には他にも多くのトリックや複雑な要素があります。DeliQueue の詳細については、ソースコードをご覧ください。
最適化: 分岐のないプログラミング
DeliQueue の開発とテストの際、チームは多くのベンチマークを実行し、新しいコードを慎重にプロファイリングしました。simpleperf ツールを使用して特定された問題の 1 つは、Message コンパレータ コードによって引き起こされたパイプライン フラッシュでした。
標準の比較演算子は条件付きジャンプを使用します。どちらの Message が先に来るかを決定する条件は、以下のように簡略化されます。
static int compareMessages(@NonNull Message m1, @NonNull Message m2) {
    if (m1 == m2) {
        return 0;
    }

    // Primary queue order is by when.
    // Messages with an earlier when should come first in the queue.
    final long whenDiff = m1.when - m2.when;
    if (whenDiff > 0) return 1;
    if (whenDiff < 0) return -1;

    // Secondary queue order is by insert sequence.
    // If two messages were inserted with the same `when`, the one inserted
    // first should come first in the queue.
    final long insertSeqDiff = m1.insertSeq - m2.insertSeq;
    if (insertSeqDiff > 0) return 1;
    if (insertSeqDiff < 0) return -1;

    return 0;
}このコードは、条件付きジャンプ(b.le 命令と cbnz 命令)にコンパイルされます。CPU が条件分岐に遭遇すると、条件が計算されるまで分岐が実行されるかどうかがわからないため、次に読み取る命令がわからず、分岐予測と呼ばれる手法を使用して推測する必要があります。バイナリ検索のようなケースでは、分岐の方向がステップごとに予測不能に変化するため、予測の半分が間違っている可能性があります。分岐予測は、検索アルゴリズムや並べ替えアルゴリズム(min-heap で使用されるアルゴリズムなど)では効果がないことがよくあります。これは、予測が外れた場合のコストが、予測が当たった場合の改善よりも大きいためです。分岐予測が間違っていた場合、予測値を想定して行った作業を破棄し、実際に取られたパスからやり直す必要があります。これはパイプライン フラッシュと呼ばれます。
この問題を見つけるために、branch-misses パフォーマンス カウンタを使用してベンチマークをプロファイリングしました。このカウンタは、ブランチ予測が間違っているスタック トレースを記録します。次に、以下に示すように、Google pprof を使用して結果を可視化しました。
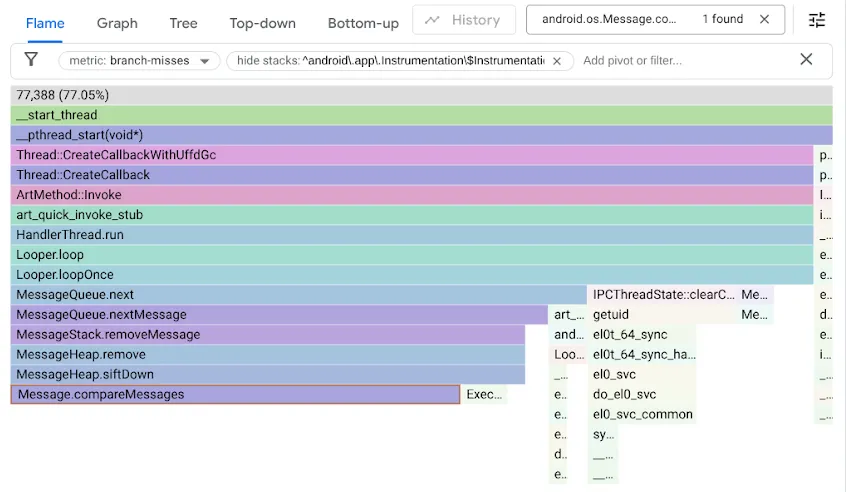
元の MessageQueue コードでは、順序付きキューに単方向連結リストが使用されていました。挿入では、リストを並べ替え順に線形検索として走査し、挿入ポイントを過ぎた最初の要素で停止して、新しい Message をその前にリンクします。ヘッドから取り外すには、ヘッドのリンクを解除するだけでした。一方、DeliQueue は min-heap を使用します。この場合、ミューテーションでは、バランスの取れたデータ構造で対数的な複雑さを持つ一部の要素を並べ替える(sifting up または sifting down)必要があります。この場合、どの比較でも、トラバーサルを左の子または右の子に誘導する可能性は均等です。新しいアルゴリズムは漸近的に高速ですが、検索コードが分岐ミスで半分の時間停止するため、新しいボトルネックが発生します。
ブランチミスがヒープコードの速度を低下させていることに気づいたため、ブランチフリー プログラミングを使用してコードを最適化しました。
// Branchless Logic
static int compareMessages(@NonNull Message m1, @NonNull Message m2) {
    final long when1 = m1.when;
    final long when2 = m2.when;
    final long insertSeq1 = m1.insertSeq;
    final long insertSeq2 = m2.insertSeq;

    // signum returns the sign (-1, 0, 1) of the argument,
    // and is implemented as pure arithmetic:
    // ((num >> 63) | (-num >>> 63))
    final int whenSign = Long.signum(when1 - when2);
    final int insertSeqSign = Long.signum(insertSeq1 - insertSeq2);

    // whenSign takes precedence over insertSeqSign,
    // so the formula below is such that insertSeqSign only matters
    // as a tie-breaker if whenSign is 0.
    return whenSign * 2 + insertSeqSign;
}最適化を理解するには、Compiler Explorer で 2 つの例を逆アセンブルし、LLVM-MCA を使用します。LLVM-MCA は、CPU サイクルの推定タイムラインを生成できる CPU シミュレータです。
The original code:
Index     01234567890123
[0,0]     DeER .    .  .   sub  x0, x2, x3
[0,1]     D=eER.    .  .   cmp  x0, #0
[0,2]     D==eER    .  .   cset w0, ne
[0,3]     .D==eER   .  .   cneg w0, w0, lt
[0,4]     .D===eER  .  .   cmp  w0, #0
[0,5]     .D====eER .  .   b.le #12
[0,6]     . DeE---R .  .   mov  w1, #1
[0,7]     . DeE---R .  .   b    #48
[0,8]     . D==eE-R .  .   tbz  w0, #31, #12
[0,9]     .  DeE--R .  .   mov  w1, #-1
[0,10]    .  DeE--R .  .   b    #36
[0,11]    .  D=eE-R .  .   sub  x0, x4, x5
[0,12]    .   D=eER .  .   cmp  x0, #0
[0,13]    .   D==eER.  .   cset w0, ne
[0,14]    .   D===eER  .   cneg w0, w0, lt
[0,15]    .    D===eER .   cmp  w0, #0
[0,16]    .    D====eER.   csetm        w1, lt
[0,17]    .    D===eE-R.   cmp  w0, #0
[0,18]    .    .D===eER.   csinc        w1, w1, wzr, le
[0,19]    .    .D====eER   mov  x0, x1
[0,20]    .    .DeE----R   ret
1 つの条件分岐 b.le に注目してください。when フィールドの比較から結果がすでにわかっている場合は、insertSeq フィールドの比較を回避します。
The branchless code:
Index     012345678
[0,0]     DeER .  .   sub       x0, x2, x3
[0,1]     DeER .  .   sub       x1, x4, x5
[0,2]     D=eER.  .   cmp       x0, #0
[0,3]     .D=eER  .   cset      w0, ne
[0,4]     .D==eER .   cneg      w0, w0, lt
[0,5]     .DeE--R .   cmp       x1, #0
[0,6]     . DeE-R .   cset      w1, ne
[0,7]     . D=eER .   cneg      w1, w1, lt
[0,8]     . D==eeER   add       w0, w1, w0, lsl #1
[0,9]     .  DeE--R   ret
この場合、分岐のない実装は、分岐のあるコードの最短パスよりもサイクル数と命令数が少なくなります。あらゆるケースで、分岐のない実装の方が優れています。実装の高速化と、誤って予測されたブランチの排除により、一部のベンチマークで 5 倍の改善が実現しました。
ただし、この手法が常に適用できるとは限りません。分岐のないアプローチでは、一般的に、破棄される作業を行う必要があります。分岐がほとんどの場合に予測可能であれば、その無駄な作業によってコードの速度が低下する可能性があります。また、ブランチを削除すると、多くの場合、データの依存関係が発生します。最新の CPU は 1 サイクルあたり複数のオペレーションを実行しますが、前の命令からの入力が準備されるまで命令を実行できません。一方、CPU はブランチ内のデータを推測し、ブランチが正しく予測された場合は、事前に処理を進めることができます。
テストと検証
ロックフリー アルゴリズムの正確性を検証することは、非常に困難なことで知られています。
開発中の継続的な検証のための標準的な単体テストに加えて、キューの不変条件を検証し、データ競合が存在する場合はそれを誘発する厳格なストレステストも作成しました。テストラボでは、エミュレートされたデバイスや実際のハードウェアで、数百万のテスト インスタンスを実行できます。
Java ThreadSanitizer(JTSan)インストルメンテーションを使用すると、同じテストを使用してコード内のデータ競合を検出することもできます。JTSan は DeliQueue で問題のあるデータ競合を検出しませんでしたが、驚くべきことに、Robolectric フレームワークで 2 つの同時実行バグを検出しました。これらはすぐに修正されました。
デバッグ機能を改善するために、新しい分析ツールを構築しました。以下は、Android プラットフォーム コードの問題を示す例です。1 つのスレッドが別のスレッドに Message を過剰に送信し、大量のバックログが発生しています。これは、追加した MessageQueue インストルメンテーション機能により、Perfetto で確認できます。
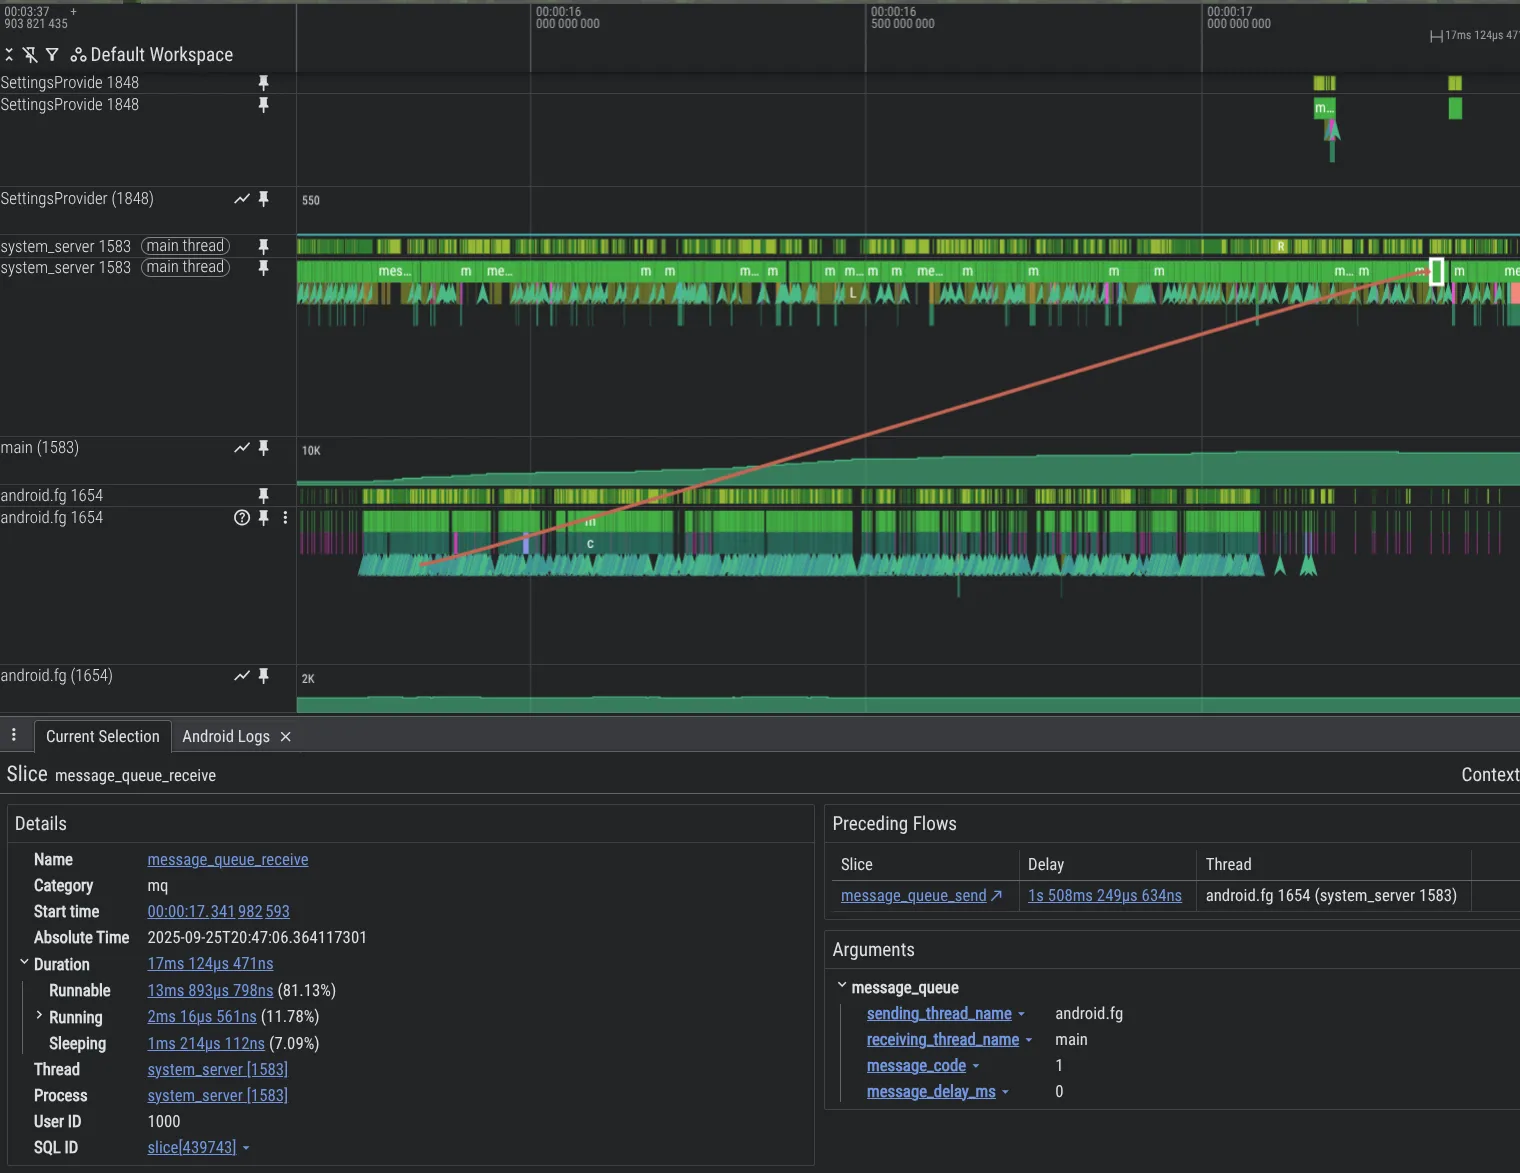
system_server プロセスで MessageQueue トレースを有効にするには、Perfetto 構成に以下を含めます。
data_sources {
  config {
    name: "track_event"
    target_buffer: 0  # Change this per your buffers configuration
    track_event_config {
      enabled_categories: "mq"
    }
  }
}
影響
DeliQueue は、MessageQueue からロックを排除することで、システムとアプリのパフォーマンスを向上させます。
- 合成ベンチマーク: 混雑したキューへのマルチスレッド挿入は、同時実行性の向上(Treiber スタック)と挿入の高速化(min-heap)により、従来の
MessageQueueよりも最大 5,000 倍高速です。 - 内部ベータ版テスターから取得した Perfetto トレースでは、ロック競合に費やされるアプリのメインスレッドの時間が 15% 減少しています。
- 同じテストデバイスで、ロック競合の減少により、ユーザー エクスペリエンスが大幅に向上しました。たとえば、次のような改善が見られました。
- アプリのフレーム落ちが 4% 減少。
- システム UI とランチャーのインタラクションで、フレーム落ちが 7.7% 減少。
- アプリの起動から最初のフレームが描画されるまでの時間が 9.1% 短縮(95 パーセンタイル)。
次のステップ
DeliQueue は、Android 17 のアプリにロールアウトされます。アプリ デベロッパーは、Android デベロッパー ブログの「Preparing your app for the new lock-free MessageQueue」で、アプリのテスト方法を確認してください。
参照
[1] Treiber, R.K., 1986. システム プログラミング: 並列処理への対応。International Business Machines Incorporated、Thomas J. ワトソン研究所。
[2] Goetz, B.、Peierls, T.、Bloch, J.、Bowbeer, J.、Holmes, D.、& Lea, D. (2006 年)Java Concurrency in Practice。Addison-Wesley Professional
-
 サービスに関する最新情報
Unity は世界中のモバイルタイトルの半数以上を支えており、第一印象が重要です。ゲーム デベロッパーにとって、スムーズで信頼性の高いプレーヤー オンボーディング エクスペリエンスは、1 日目の維持率と長期的なエンゲージメントを促進するために不可欠です。
Michelle Martin • 所要時間: 1 分 -
 サービスに関する最新情報
自宅での完全な没入感から、外出先での一目でわかるエクスペリエンスまで、Android XR を基盤に構築することで、空間アプリケーションのあらゆる場面でユーザーにリーチできます。Android Developer Summit で、XREAL AURA のリリースというエキサイティングなマイルストーンを達成しました。
Amy Zeppenfeld, Vinny DaSilva • 所要時間: 3 分 -
 サービスに関する最新情報
インテリジェンスの時代において、ユーザーはアプリをタップするだけでなく、高度な目標を表現し、Gemini のような AI エージェントが、デバイス上の複数のアプリにまたがることもあるマルチステップのワークフローを完了することを期待しています。
Jingyu Shi • 所要時間: 4 分
Android 開発に関する最新の分析情報を毎週メールでお届けします。