Android 17'de, SDK 37 veya sonraki sürümleri hedefleyen uygulamalar, kilitsiz bir MessageQueue uygulaması alır. Yeni uygulama, performansı artırır ve kaçırılan kareleri azaltır ancak MessageQueue özel alanlarını ve yöntemlerini yansıtan istemcileri bozabilir. Davranış değişikliği ve etkisini nasıl azaltabileceğiniz hakkında daha fazla bilgi edinmek için MessageQueue davranış değişikliği belgelerine göz atın. Bu teknik blog yayınında, MessageQueue'nun yeniden mimarisine ve Perfetto'yu kullanarak kilit çekişmesi sorunlarını nasıl analiz edebileceğinize dair genel bir bakış sunulmaktadır.
Looper, her Android uygulamasının kullanıcı arayüzü iş parçacığını çalıştırır. MessageQueue'dan işleri alır, bunları bir Handler'a gönderir ve bu işlemi tekrarlar. MessageQueue, yirmi yıl boyunca durumunu korumak için tek bir monitör kilidi (yani synchronized kod bloğu) kullandı.
Android 17, bu bileşende önemli bir güncelleme sunuyor: DeliQueue adlı kilitsiz bir uygulama.
Bu yayında, kilitlerin kullanıcı arayüzü performansını nasıl etkilediği, bu sorunların Perfetto ile nasıl analiz edileceği ve Android ana iş parçacığını iyileştirmek için kullanılan belirli algoritmalar ve optimizasyonlar açıklanmaktadır.
Sorun: Kilit Çekişmesi ve Öncelik Tersine Çevirme
Eski MessageQueue, tek bir kilitle korunan öncelikli bir sıra olarak çalışıyordu. Ana iş parçacığı sıra bakımı yaparken arka plan iş parçacığı bir mesaj yayınlarsa arka plan iş parçacığı ana iş parçacığını engeller.
İki veya daha fazla iş parçacığı aynı kilidin özel kullanımı için rekabet ettiğinde buna kilit çekişmesi denir. Bu çekişme, öncelik tersine çevirmeye neden olarak kullanıcı arayüzü takılmalarına ve diğer performans sorunlarına yol açabilir.
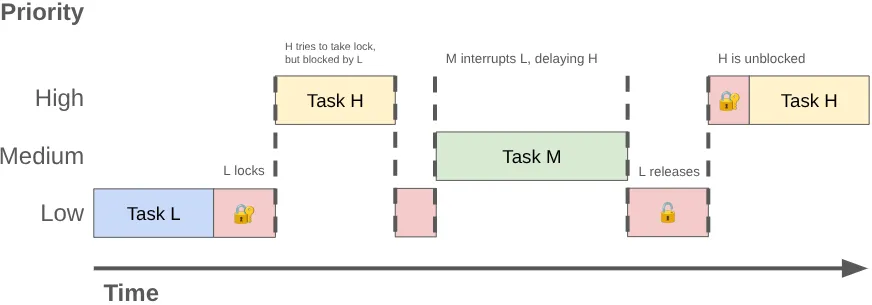
Önceliğin ters dönmesi, yüksek öncelikli bir iş parçacığının (ör. kullanıcı arayüzü iş parçacığı) düşük öncelikli bir iş parçacığını beklemesi gerektiğinde ortaya çıkabilir. Şu sırayı ele alalım:
- Düşük öncelikli bir arka plan iş parçacığı, yaptığı işin sonucunu yayınlamak için
MessageQueuekilidini alır. - Orta öncelikli bir iş parçacığı çalıştırılabilir hale gelir ve çekirdeğin zamanlayıcısı, düşük öncelikli iş parçacığını önceden alarak bu iş parçacığına CPU süresi ayırır.
- Yüksek öncelikli kullanıcı arayüzü iş parçacığı, mevcut görevini tamamlar ve sıradan okuma yapmaya çalışır ancak düşük öncelikli iş parçacığı kilidi tuttuğu için engellenir.
Düşük öncelikli iş parçacığı, kullanıcı arayüzü iş parçacığını engeller ve orta öncelikli iş, bu gecikmeyi daha da artırır.
Perfetto ile çekişmeyi analiz etme
Perfetto'yu kullanarak bu sorunları teşhis edebilirsiniz. Standart bir izlemede, monitör kilidinde engellenen bir iş parçacığı uyku durumuna girer ve Perfetto, kilit sahibini gösteren bir dilim gösterir.
İzleme verilerini sorgularken "monitor contention with …" (… ile çekişmeyi izle) adlı dilimleri arayın. Ardından, kilidin sahibi olan iş parçacığının adını ve kilidin alındığı kod sitesini bulun.
Örnek olay: Başlatıcı takılması
Örnek olarak, kullanıcının kamera uygulamasında fotoğraf çektikten hemen sonra Pixel telefonda ana ekrana giderken takılma yaşadığı bir izi analiz edelim. Aşağıda, kaçırılan kareye yol açan etkinlikleri gösteren Perfetto'nun ekran görüntüsü yer almaktadır:
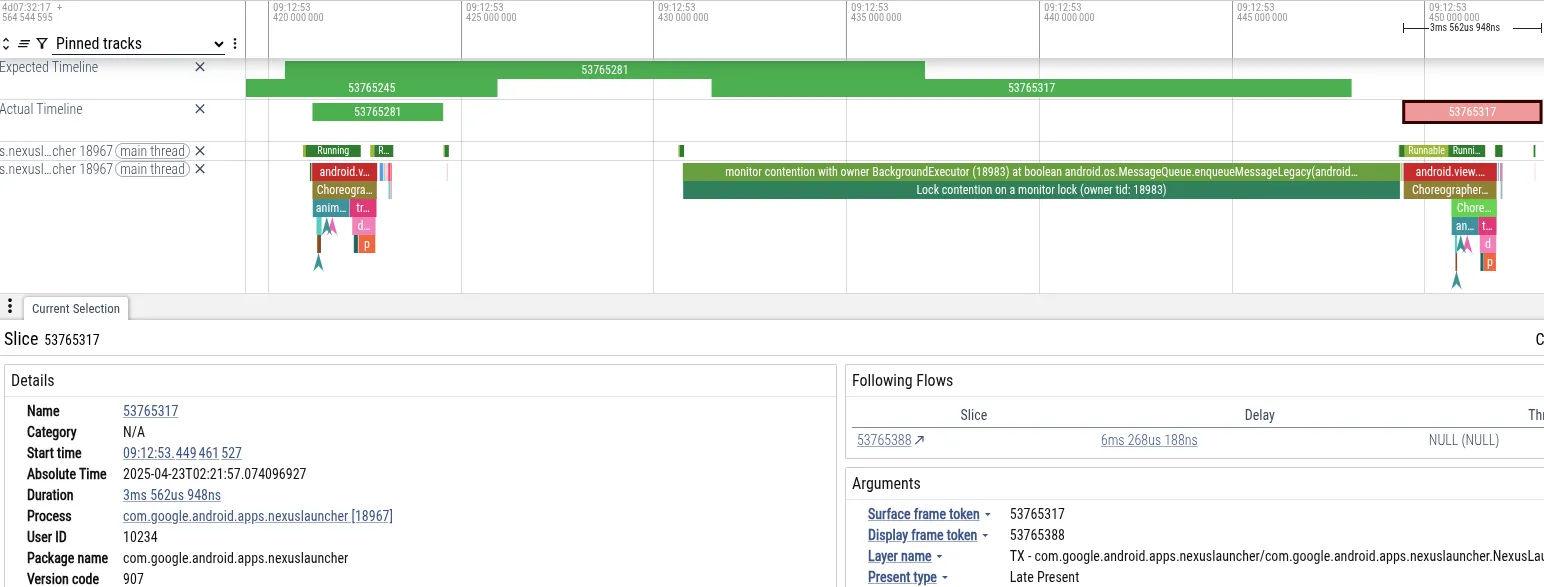
- Belirti: Başlatıcı ana iş parçacığı, kare son tarihini kaçırdı. 18 ms boyunca engellendi. Bu süre, 60 Hz oluşturma için gereken 16 ms'lik süreyi aşıyor.
- Teşhis: Perfetto, ana iş parçacığının
MessageQueuekilidinde engellendiğini gösterdi. "BackgroundExecutor" iş parçacığı kilide sahipti. - Temel Neden: BackgroundExecutor, Process.THREAD_PRIORITY_BACKGROUND (çok düşük öncelik) düzeyinde çalışır. Acil olmayan bir görev (uygulama kullanım sınırlarını kontrol etme) gerçekleştirdi. Aynı zamanda, orta öncelikli iş parçacıkları kameradan gelen verileri işlemek için CPU süresini kullanıyordu. OS planlayıcısı, kamera iş parçacıklarını çalıştırmak için BackgroundExecutor iş parçacığını geçici olarak kesti.
Bu sıra, Başlatıcı'nın kullanıcı arayüzü iş parçacığının (yüksek öncelikli), Başlatıcı'nın arka plan iş parçacığının (düşük öncelikli) kilidi serbest bırakmasını engelleyen kamera çalışan iş parçacığı (orta öncelikli) tarafından dolaylı olarak engellenmesine neden oldu.
PerfettoSQL ile izleri sorgulama
Belirli kalıplar için izleme verilerini sorgulamak üzere PerfettoSQL'i kullanabilirsiniz. Kullanıcı cihazlarından veya testlerden elde edilen büyük bir izleme veritabanınız varsa ve bir sorunu gösteren belirli izleri arıyorsanız bu özellikten yararlanabilirsiniz.
Örneğin, bu sorgu, kare düşmesi (takılma) ile eş zamanlı olarak gerçekleşen MessageQueue çekişmesini bulur:
INCLUDE PERFETTO MODULE android.monitor_contention;
INCLUDE PERFETTO MODULE android.frames.jank_type;

SELECT
  process_name,
  -- Convert duration from nanoseconds to milliseconds
  SUM(dur) / 1000000 AS sum_dur_ms,
  COUNT(*) AS count_contention
FROM android_monitor_contention
WHERE is_blocked_thread_main
AND short_blocked_method LIKE "%MessageQueue%"

-- Only look at app processes that had jank
AND upid IN (
  SELECT DISTINCT(upid)
  FROM actual_frame_timeline_slice
  WHERE android_is_app_jank_type(jank_type) = TRUE
)
GROUP BY process_name
ORDER BY SUM(dur) DESC;
Bu daha karmaşık örnekte, uygulama başlatma sırasında MessageQueue çekişmesini belirlemek için birden fazla tabloya yayılan izleme verilerini birleştirin:
INCLUDE PERFETTO MODULE android.monitor_contention;
INCLUDE PERFETTO MODULE android.startup.startups;

-- Join package and process information for startups
DROP VIEW IF EXISTS startups;
CREATE VIEW startups AS
SELECT startup_id, ts, dur, upid
FROM android_startups
JOIN android_startup_processes USING(startup_id);

-- Intersect monitor contention with startups in the same process.
DROP TABLE IF EXISTS monitor_contention_during_startup;
CREATE VIRTUAL TABLE monitor_contention_during_startup
USING SPAN_JOIN(android_monitor_contention PARTITIONED upid, startups PARTITIONED upid);

SELECT
  process_name,
  SUM(dur) / 1000000 AS sum_dur_ms,
  COUNT(*) AS count_contention
FROM monitor_contention_during_startup
WHERE is_blocked_thread_main
AND short_blocked_method LIKE "%MessageQueue%"
GROUP BY process_name
ORDER BY SUM(dur) DESC;
Diğer kalıpları bulmak için PerfettoSQL sorguları yazmak üzere tercih ettiğiniz LLM'yi kullanabilirsiniz.
Google'da, milyonlarca iz üzerinde PerfettoSQL sorguları çalıştırmak için BigTrace'i kullanırız. Bu süreçte, anekdot olarak gördüğümüz şeyin aslında sistemsel bir sorun olduğunu doğruladık. Veriler, kilit çekişmesinin tüm ekosistemdeki kullanıcıları etkilediğini ortaya koydu. Bu da temel bir mimari değişikliğe ihtiyaç duyulduğunu doğruladı.MessageQueue
Çözüm: Kilitsiz eşzamanlılık
Paylaşılan duruma erişimi senkronize etmek için özel kilitler yerine atomik bellek işlemlerini kullanan kilitsiz bir veri yapısı uygulayarak MessageQueue çekişme sorununu çözdük. Diğer iş parçacıklarının planlama davranışından bağımsız olarak en az bir iş parçacığı her zaman ilerleme kaydedebiliyorsa veri yapısı veya algoritma kilitsizdir. Bu özelliğe ulaşmak genellikle zordur ve çoğu kod için genellikle uğraşmaya değmez.
Atomik temel öğeler
Kilitsiz yazılımlar genellikle donanımın sağladığı atomik okuma-değiştirme-yazma temel öğelerini kullanır.
Eski nesil ARM64 CPU'larda atomikler, Load-Link/Store-Conditional (LL/SC) döngüsü kullanıyordu. CPU bir değer yükler ve adresi işaretler. Başka bir iş parçacığı bu adrese yazarsa depolama işlemi başarısız olur ve döngü yeniden dener. İş parçacıkları başka bir iş parçacığını beklemeden denemeye devam edip başarılı olabildiğinden bu işlem kilitsizdir.
ARM64 LL/SC loop example
retry:
    ldxr    x0, [x1]        // Load exclusive from address x1 to x0
    add     x0, x0, #1      // Increment value by 1
    stxr    w2, x0, [x1]    // Store exclusive.
                            // w2 gets 0 on success, 1 on failure
cbnz w2, retry // If w2 is non-zero (failed), branch to retr(Compiler Explorer'da görüntüleyin)
Daha yeni ARM mimarileri (ARMv8.1), Compare-And-Swap (CAS) veya Load-And-Add biçiminde talimatlar içeren Large System Extensions (LSE)'ı destekler (aşağıda gösterilmiştir). Android 17'de, LSE'nin ne zaman desteklendiğini algılamak ve optimize edilmiş talimatlar yayınlamak için Android Çalışma Zamanı (ART) derleyicisine destek ekledik:
/ ARMv8.1 LSE atomic example
ldadd   x0, x1, [x2]    // Atomic load-add.
                        // Faster, no loop required.
Karşılaştırmalarımızda, CAS kullanan yüksek çekişmeli kod, LL/SC varyantına göre yaklaşık 3 kat daha hızlı çalışır.
Java programlama dili, bu ve diğer özel CPU talimatlarını temel alan java.util.concurrent.atomic aracılığıyla atomik temel öğeler sunar.
Veri Yapısı: DeliQueue
Mühendislerimiz, MessageQueue uygulamasındaki kilit çekişmesini ortadan kaldırmak için DeliQueue adlı yeni bir veri yapısı tasarladı. DeliQueue, Message ekleme işlemini Message işleme sürecinden ayırır:
Messageslistesi (Treiber yığını): Kilitsiz bir yığın. Herhangi bir ileti dizisi, çekişme olmadan buraya yeniMessagesgönderebilir.- Öncelik sırası (Min-heap): İşlenecek
Messagesyığını. Bu yığın, yalnızca Looper iş parçacığına aittir (bu nedenle erişim için senkronizasyon veya kilit gerekmez).
Sıraya alma: Treiber yığınına gönderme
Messages listesi, baş işaretçisini güncellemek için CAS döngüsü kullanan kilitsiz bir yığın olan Treiber yığınında [1] tutulur.
public class TreiberStack <E> {
    AtomicReference<Node<E>> top =
            new AtomicReference<Node<E>>();
    public void push(E item) {
        Node<E> newHead = new Node<E>(item);
        Node<E> oldHead;
        do {
            oldHead = top.get();
            newHead.next = oldHead;
        } while (!top.compareAndSet(oldHead, newHead));
    }

    public E pop() {
        Node<E> oldHead;
        Node<E> newHead;
        do {
            oldHead = top.get();
            if (oldHead == null) return null;
            newHead = oldHead.next;
        } while (!top.compareAndSet(oldHead, newHead));
        return oldHead.item;
    }
}
Java Concurrency in Practice [2] tabanlı kaynak kodu, internette mevcuttur ve kamu alanında yayınlanmıştır.
Herhangi bir üretici, istediği zaman yığına yeni Message ekleyebilir. Bu, şarküteri tezgahında sıra numarası almaya benzer. Numaranız, geldiğiniz zamana göre belirlenir ancak yemeğinizi aldığınız sıranın numaranızla eşleşmesi gerekmez. Bağlı bir yığın olduğu için her Message bir alt yığındır. Başı izleyip ileriye doğru yineleyerek Message sırasının herhangi bir zamanda nasıl olduğunu görebilirsiniz. Gezinmeniz sırasında ekleniyor olsalar bile en üste yeni Message'lerin eklendiğini görmezsiniz.
Sıradan çıkarma: Minimum yığına toplu aktarım
İşlenecek bir sonraki Message öğesini bulmak için Looper, Treiber yığınındaki yeni Message öğelerini işler. Bu işlem, yığının en üstünden başlayıp daha önce işlediği son Message öğesini bulana kadar devam eder. Looper, yığında aşağı doğru ilerlerken teslim tarihine göre sıralanmış minimum yığına Message'leri ekler. Looper, yığının tek sahibi olduğundan Message'leri kilitler veya atomikler olmadan sıralar ve işler.
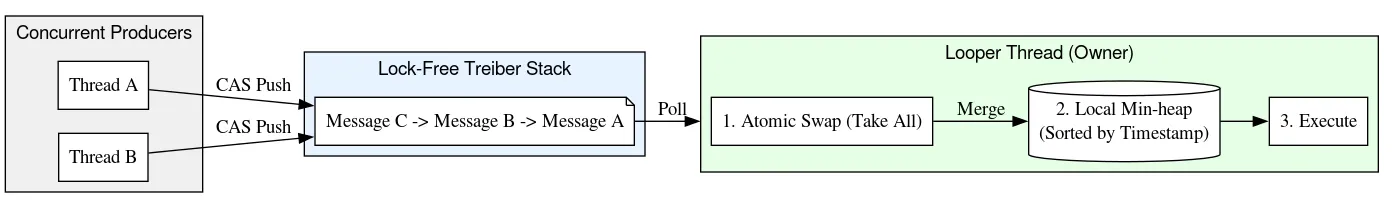
Yığında aşağı doğru ilerlerken Looper, yığılmış Message'lerden öncekilere bağlantılar oluşturarak çift yönlü bağlı bir liste oluşturur. Bağlı listeyi oluşturmak güvenlidir. Bunun nedeni, yığının alt kısmını işaret eden bağlantıların CAS ile Treiber yığın algoritması aracılığıyla eklenmesi ve yığının üst kısmındaki bağlantıların yalnızca Looper iş parçacığı tarafından okunup değiştirilmesidir. Bu geri bağlantılar daha sonra, yığındaki rastgele noktalardan Message öğelerini O(1) sürede kaldırmak için kullanılır.
Bu tasarım, üreticiler(sıraya iş gönderen iş parçacıkları) için O (1) ekleme ve tüketici(Looper) için amorti edilmiş O (log N) işleme sağlar.
Messageleri sıralamak için min-heap kullanmak, eski MessageQueue'deki temel bir kusuru da giderir. Bu kusur, Messagelerin tek yönlü bağlı bir listede (en üstte köklenmiş) tutulmasıdır. Eski uygulamada, baştan kaldırma O(1) iken ekleme en kötü durumda O(N) oluyordu. Bu da aşırı yüklenmiş sıralar için kötü bir ölçeklendirmeydi. Buna karşılık, min-heap'e ekleme ve kaldırma işlemleri logaritmik olarak ölçeklenir. Bu sayede rekabetçi bir ortalama performans sunar ancak özellikle kuyruk gecikmelerinde üstün performans gösterir.
Eski (kilitli) MessageQueue | DeliQueue | |
| Ekle | O(N) | İş parçacığını çağırmak için O(1)
|
| Baştan kaldır | O(1) | O(logN) |
Eski sıra uygulamasında, üreticiler ve tüketici, temel tek bağlantılı listeye özel erişimi koordine etmek için bir kilit kullanıyordu. DeliQueue'da Treiber yığını eşzamanlı erişimi, tek tüketici ise iş sırasını düzenlemeyi yönetir.
Kaldırma: silinen öğe işaretleri aracılığıyla tutarlılık
DeliQueue, kilitsiz bir Treiber yığınını tek iş parçacıklı bir min-heap ile birleştiren karma bir veri yapısıdır. Bu iki yapıyı global bir kilit olmadan senkronize tutmak benzersiz bir zorluk sunar: Bir mesaj, yığında fiziksel olarak mevcut olabilir ancak mantıksal olarak kuyruktan kaldırılmış olabilir.
DeliQueue, bu sorunu çözmek için "tombstoning" adlı bir teknik kullanır. Her Message, yığındaki konumunu geriye ve ileriye doğru işaretçiler, yığının dizisindeki dizini ve kaldırılıp kaldırılmadığını gösteren bir boole işareti aracılığıyla izler. Bir Message çalıştırılmaya hazır olduğunda Looper iş parçacığı, kaldırılan işaretini CAS'ler, ardından yığın ve yığından kaldırır.
Başka bir iş parçacığının bir Message kaldırması gerektiğinde, bunu veri yapısından hemen çıkarmaz. Bunun yerine aşağıdaki adımları uygular:
- Mantıksal kaldırma: İş parçacığı,
Messageöğesinin kaldırma işaretini atomik olarak "false" değerinden "true" değerine ayarlamak için CAS kullanır.Message, veri yapısında kaldırma işleminin beklemede olduğunu gösteren bir kanıt olarak kalır. Buna "mezar taşı" denir. BirMessage, kaldırılmak üzere işaretlendikten sonra DeliQueue, bulunduğu her durumda onu artık sırada yokmuş gibi değerlendirir. - Ertelenen temizleme: Veri yapısından asıl kaldırma işlemi
Looperiş parçacığının sorumluluğundadır ve daha sonraya ertelenir. Kaldırıcı iş parçacığı, yığını veya yığın belleği değiştirmek yerineMessageöğesini başka bir kilitsiz serbest liste yığınına ekler. - Yapısal kaldırma: Yalnızca
Looper, yığınla etkileşim kurabilir veya yığından öğe kaldırabilir. Uyandığında serbest listeyi temizler ve içerdiğiMessages'leri işler. Ardından herMessage, yığından ayrılır ve yığından kaldırılır.
Bu yaklaşım, yığının tüm yönetimini tek iş parçacıklı olarak tutar. Eşzamanlı işlemlerin ve gerekli bellek engellerinin sayısını en aza indirerek kritik yolu daha hızlı ve basit hale getirir.
Geçiş: zararsız Java bellek modeli veri yarışları
Java standart kitaplığındaki Future veya Kotlin'in Job ve Deferred gibi çoğu eşzamanlılık API'si, işi tamamlanmadan önce iptal etme mekanizması içerir. Bu sınıflardan birinin örneği, temel bir çalışma birimiyle 1:1 eşleşir ve bir nesnede cancel çağrısı yapıldığında bunlarla ilişkili belirli işlemler iptal edilir.
Günümüzün Android cihazlarında çok çekirdekli CPU'lar ve eşzamanlı, nesil tabanlı atık toplayıcı özelliği bulunur. Ancak Android ilk geliştirildiğinde her iş birimi için bir nesne ayırmak çok pahalıydı. Bu nedenle Android'in Handler sınıfı, removeMessages yönteminin çeşitli aşırı yüklemeleri aracılığıyla iptali destekler. Belirli bir Message nesnesini kaldırmak yerine, belirtilen ölçütlerle eşleşen tüm Message nesnelerini kaldırır. Uygulamada bu, removeMessages çağrılmadan önce eklenen tüm Message öğelerinin yinelenmesini ve eşleşenlerin kaldırılmasını gerektirir.
İleriye doğru iterasyon yaparken bir iş parçacığı, yığının mevcut başını okumak için yalnızca bir sıralı atomik işlem gerektirir. Ardından, bir sonraki Message değerini bulmak için sıradan alan okumaları kullanılır. Looper iş parçacığı, Message'leri kaldırırken next alanlarını değiştirirse Looper'nin yazma işlemi ile başka bir iş parçacığının okuma işlemi senkronize edilmez. Bu durum, veri yarışına neden olur. Normalde veri yarışı, uygulamanızda büyük sorunlara (sızıntılar, sonsuz döngüler, kilitlenmeler, donmalar ve daha fazlası) neden olabilecek ciddi bir hatadır. Ancak belirli dar koşullar altında, veri yarışları Java Bellek Modeli'nde zararsız olabilir. Şöyle bir yığınla başladığımızı varsayalım:

Başın atomik okumasını yapar ve A'yı görürüz. A'nın sonraki işaretçisi B'yi gösterir. B'yi işlediğimiz sırada döngü, A'yı C'yi ve ardından D'yi işaret edecek şekilde güncelleyerek B ve C'yi kaldırabilir.
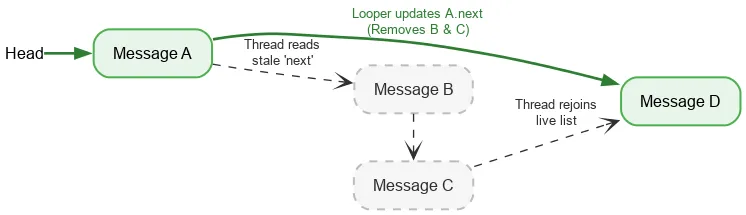
B ve C mantıksal olarak kaldırılmış olsa da B, C'e ve C, D'ye işaret eden sonraki işaretçisini korur. Okuma iş parçacığı, ayrılmış kaldırılan düğümler arasında gezinmeye devam eder ve sonunda D adresindeki canlı yığına yeniden katılır.
DeliQueue'yu, gezinme ve kaldırma arasındaki yarışları işleyecek şekilde tasarlayarak güvenli ve kilitsiz iterasyona olanak tanıyoruz.
Quitting: Native refcount
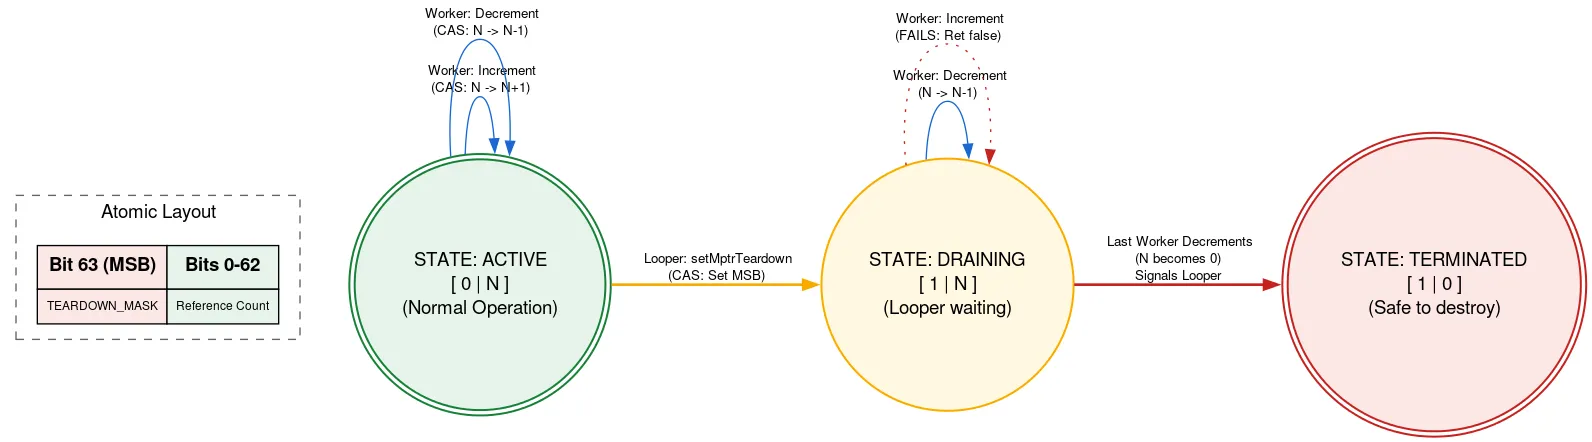
Looper, Looper sonlandırıldıktan sonra manuel olarak serbest bırakılması gereken yerel bir ayırma tarafından desteklenir. Looper kapatılırken başka bir ileti dizisi Message ekliyorsa yerel ayırma serbest bırakıldıktan sonra kullanılabilir. Bu da bellek güvenliği ihlaline neden olur. Bunu, atomun bir bitinin Looper öğesinin çıkıp çıkmadığını belirtmek için kullanıldığı etiketli bir refcount kullanarak önleriz.
Yerel ayırma kullanılmadan önce bir iş parçacığı, refcount atomik değerini okur. Çıkış biti ayarlanırsa Looper uygulamasının çıkış yaptığını ve yerel ayırmanın kullanılmaması gerektiğini döndürür. Aksi takdirde, yerel ayırmayı kullanarak etkin iş parçacıklarının sayısını artırmak için bir CAS dener. Gerekli işlemleri yaptıktan sonra sayıyı azaltır. Çıkış biti, artıştan sonra ancak azalmadan önce ayarlanmışsa ve sayı şu anda sıfırsa Looper iş parçacığını uyandırır.
Looper iş parçacığı çıkmaya hazır olduğunda CAS'ı kullanarak atomik değerdeki çıkış bitini ayarlar. Refcount 0 ise yerel tahsisini serbest bırakmaya devam edebilir. Aksi takdirde, yerel ayırmanın son kullanıcısı refcount'u azalttığında uyandırılacağını bilerek kendini park eder. Bu yaklaşım, Looper iş parçacığının diğer iş parçacıklarının ilerlemesini beklediği anlamına gelir ancak bu yalnızca çıkış yaparken gerçekleşir. Bu işlem yalnızca bir kez gerçekleşir ve performansa duyarlı değildir. Ayrıca, yerel ayırmayı kullanmak için diğer kodu tamamen kilitsiz tutar.
Uygulamada başka birçok püf noktası ve karmaşıklık vardır. Kaynak kodunu inceleyerek DeliQueue hakkında daha fazla bilgi edinebilirsiniz.
Optimizasyon: dallanmasız programlama
Ekip, DeliQueue'yu geliştirip test ederken birçok karşılaştırma yaptı ve yeni kodu dikkatlice profilledi. Simpleperf aracı kullanılarak tespit edilen bir sorun, Message karşılaştırıcı kodunun neden olduğu ardışık düzen temizlemeleriydi.
Standart bir karşılaştırıcı, koşullu atlamalar kullanır. Hangi Message değerinin önce geleceğine karar verme koşulu aşağıda basitleştirilmiştir:
static int compareMessages(@NonNull Message m1, @NonNull Message m2) {
    if (m1 == m2) {
        return 0;
    }

    // Primary queue order is by when.
    // Messages with an earlier when should come first in the queue.
    final long whenDiff = m1.when - m2.when;
    if (whenDiff > 0) return 1;
    if (whenDiff < 0) return -1;

    // Secondary queue order is by insert sequence.
    // If two messages were inserted with the same `when`, the one inserted
    // first should come first in the queue.
    final long insertSeqDiff = m1.insertSeq - m2.insertSeq;
    if (insertSeqDiff > 0) return 1;
    if (insertSeqDiff < 0) return -1;

    return 0;
}
Bu kod, koşullu atlamalara (b.le ve cbnz talimatları) derlenir. CPU, koşullu bir dallanmayla karşılaştığında koşul hesaplanana kadar dallanmanın yapılıp yapılmadığını bilemez. Bu nedenle, bir sonraki adımda hangi talimatı okuyacağını bilemez ve dallanma tahmini adı verilen bir teknik kullanarak tahminde bulunması gerekir. İkili arama gibi bir durumda, dal yönü her adımda tahmin edilemeyecek şekilde farklı olacaktır. Bu nedenle, tahminlerin yarısının yanlış olması muhtemeldir. Dal tahmini, arama ve sıralama algoritmalarında (ör. min-heap'te kullanılan algoritma) genellikle etkili değildir. Bunun nedeni, yanlış tahmin etmenin maliyetinin doğru tahmin etmenin sağladığı iyileştirmeden daha yüksek olmasıdır. Dal tahmincisi yanlış tahmin yaptığında, tahmin edilen değeri varsaydıktan sonra yaptığı işi silmeli ve gerçekte izlenen yoldan tekrar başlamalıdır. Buna ardışık düzen temizleme denir.
Bu sorunu bulmak için, dal tahmincisinin yanlış tahmin ettiği yığın izlemelerini kaydeden branch-misses performans sayacını kullanarak karşılaştırmalarımızın profilini çıkardık. Ardından, sonuçları aşağıda gösterildiği gibi Google pprof ile görselleştirdik:
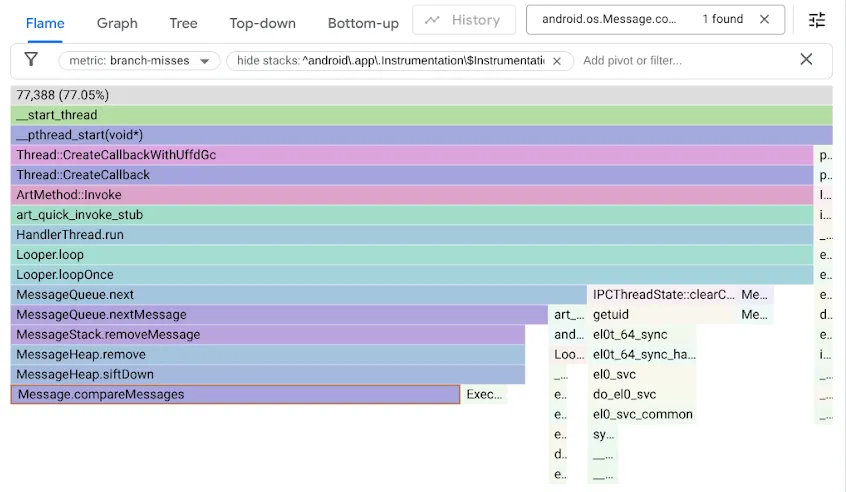
Orijinal MessageQueue kodunun, sıralı sıra için tek bağlantılı bir liste kullandığını hatırlayın. Ekleme işlemi, listeyi sıralama ölçütü olarak doğrusal bir arama şeklinde tarar, ekleme noktasını geçen ilk öğede durur ve yeni Message öğesini bu öğenin önüne bağlar. Kafadan çıkarmak için kafanın bağlantısını kaldırmak yeterliydi. DeliQueue ise min-heap kullanır. Burada mutasyonlar, dengeli bir veri yapısında logaritmik karmaşıklıkla bazı öğelerin yeniden sıralanmasını (yukarı veya aşağı kaydırma) gerektirir. Herhangi bir karşılaştırmanın, geçişi sol alt öğeye veya sağ alt öğeye yönlendirme olasılığı eşittir. Yeni algoritma asimptotik olarak daha hızlıdır ancak arama kodu, zamanın yarısında dal kaçırmaları nedeniyle durduğundan yeni bir darboğaz ortaya çıkarır.
Dal kaçırmaların yığın kodumuzu yavaşlattığını fark ettik ve dalsız programlama kullanarak kodu optimize ettik:
// Branchless Logic
static int compareMessages(@NonNull Message m1, @NonNull Message m2) {
    final long when1 = m1.when;
    final long when2 = m2.when;
    final long insertSeq1 = m1.insertSeq;
    final long insertSeq2 = m2.insertSeq;

    // signum returns the sign (-1, 0, 1) of the argument,
    // and is implemented as pure arithmetic:
    // ((num >> 63) | (-num >>> 63))
    final int whenSign = Long.signum(when1 - when2);
    final int insertSeqSign = Long.signum(insertSeq1 - insertSeq2);

    // whenSign takes precedence over insertSeqSign,
    // so the formula below is such that insertSeqSign only matters
    // as a tie-breaker if whenSign is 0.
    return whenSign * 2 + insertSeqSign;
}
Optimizasyonu anlamak için Compiler Explorer'da iki örneği parçalara ayırın ve CPU döngülerinin tahmini zaman çizelgesini oluşturabilen bir CPU simülatörü olan LLVM-MCA'yı kullanın.
The original code:
Index     01234567890123
[0,0]     DeER .    .  .   sub  x0, x2, x3
[0,1]     D=eER.    .  .   cmp  x0, #0
[0,2]     D==eER    .  .   cset w0, ne
[0,3]     .D==eER   .  .   cneg w0, w0, lt
[0,4]     .D===eER  .  .   cmp  w0, #0
[0,5]     .D====eER .  .   b.le #12
[0,6]     . DeE---R .  .   mov  w1, #1
[0,7]     . DeE---R .  .   b    #48
[0,8]     . D==eE-R .  .   tbz  w0, #31, #12
[0,9]     .  DeE--R .  .   mov  w1, #-1
[0,10]    .  DeE--R .  .   b    #36
[0,11]    .  D=eE-R .  .   sub  x0, x4, x5
[0,12]    .   D=eER .  .   cmp  x0, #0
[0,13]    .   D==eER.  .   cset w0, ne
[0,14]    .   D===eER  .   cneg w0, w0, lt
[0,15]    .    D===eER .   cmp  w0, #0
[0,16]    .    D====eER.   csetm        w1, lt
[0,17]    .    D===eE-R.   cmp  w0, #0
[0,18]    .    .D===eER.   csinc        w1, w1, wzr, le
[0,19]    .    .D====eER   mov  x0, x1
[0,20]    .    .DeE----R   ret
when alanları karşılaştırılarak sonuç zaten biliniyorsa insertSeq alanlarının karşılaştırılmasını önleyen koşullu dalı (b.le) inceleyin.
The branchless code:
Index     012345678
[0,0]     DeER .  .   sub       x0, x2, x3
[0,1]     DeER .  .   sub       x1, x4, x5
[0,2]     D=eER.  .   cmp       x0, #0
[0,3]     .D=eER  .   cset      w0, ne
[0,4]     .D==eER .   cneg      w0, w0, lt
[0,5]     .DeE--R .   cmp       x1, #0
[0,6]     . DeE-R .   cset      w1, ne
[0,7]     . D=eER .   cneg      w1, w1, lt
[0,8]     . D==eeER   add       w0, w1, w0, lsl #1
[0,9]     .  DeE--R   ret
Burada, dallanmasız uygulama, dallı kodun en kısa yolundan bile daha az döngü ve talimat alır. Bu, her durumda daha iyidir. Daha hızlı uygulama ve yanlış tahmin edilen dalların ortadan kaldırılması, bazı karşılaştırmalarımızda 5 kat iyileşme sağladı.
Ancak bu teknik her zaman geçerli değildir. Dalsız yaklaşımlar genellikle atılacak işlerin yapılmasını gerektirir. Dal çoğu zaman tahmin edilebilirse bu boşa harcanan iş, kodunuzu yavaşlatabilir. Ayrıca bir dalı kaldırmak genellikle veri bağımlılığına neden olur. Modern CPU'lar her döngüde birden fazla işlem yürütür ancak önceki bir talimattan gelen girişler hazır olana kadar bir talimatı yürütemezler. Buna karşılık CPU, dallardaki veriler hakkında tahmin yürütebilir ve bir dal doğru tahmin edilirse önceden çalışabilir.
Test ve doğrulama
Kilitsiz algoritmaların doğruluğunu onaylamak çok zordur.
Geliştirme sırasında sürekli doğrulama için standart birim testlerine ek olarak, sıra sabitlerini doğrulamak ve varsa veri yarışlarını tetiklemeye çalışmak için titiz stres testleri de yazdık. Test laboratuvarlarımızda, emülasyonu yapılan cihazlarda ve gerçek donanımlarda milyonlarca test örneği çalıştırabiliriz.
Java ThreadSanitizer (JTSan) araçlarıyla, kodumuzdaki bazı veri yarışlarını tespit etmek için aynı testleri kullanabiliriz. JTSan, DeliQueue'da sorunlu veri yarışları bulmadı ancak şaşırtıcı bir şekilde Robolectric çerçevesinde iki eşzamanlılık hatası tespit etti ve bunları hemen düzelttik.
Hata ayıklama özelliklerimizi iyileştirmek için yeni analiz araçları geliştirdik. Aşağıda, Android platform kodunda bir iş parçacığının başka bir iş parçacığını Message ile aşırı yükleyerek büyük bir birikmeye neden olduğu ve eklediğimiz MessageQueue ölçüm özelliği sayesinde Perfetto'da görülebilen bir sorunu gösteren örnek verilmiştir.
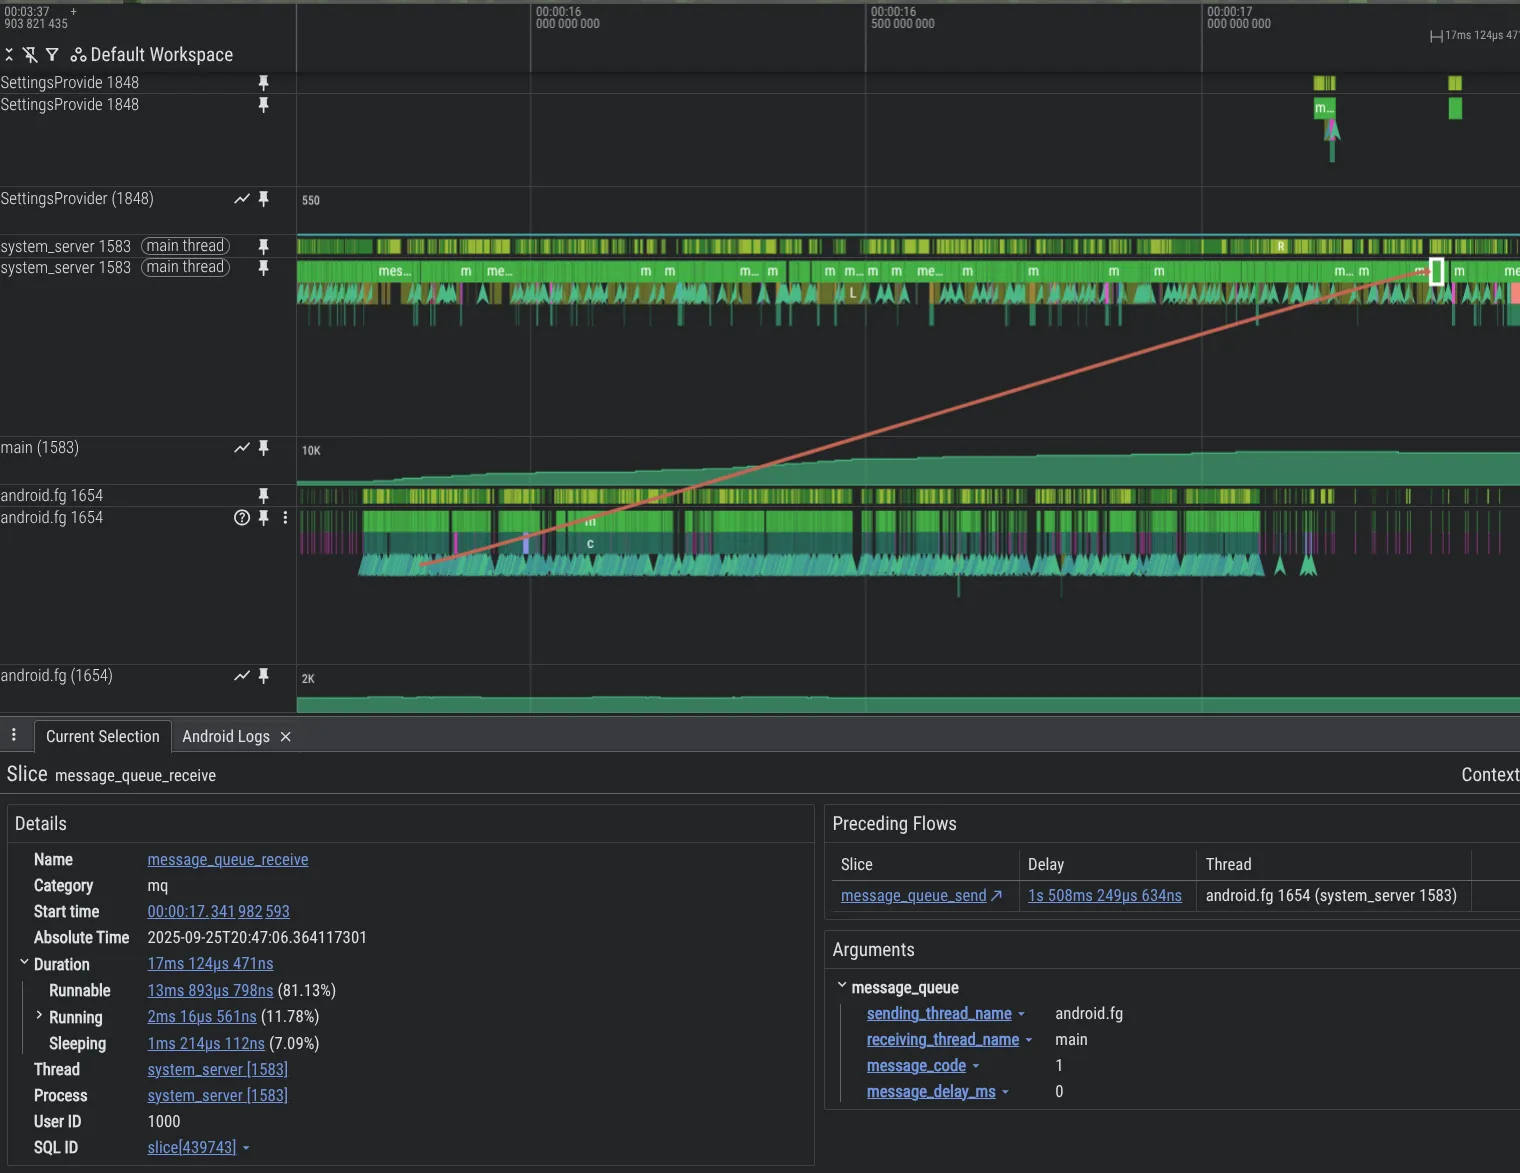
system_server işleminde MessageQueue izlemeyi etkinleştirmek için Perfetto yapılandırmanıza aşağıdakileri ekleyin:
data_sources {
  config {
    name: "track_event"
    target_buffer: 0  # Change this per your buffers configuration
    track_event_config {
      enabled_categories: "mq"
    }
  }
}
Etki
DeliQueue, MessageQueue uygulamasındaki kilitleri kaldırarak sistem ve uygulama performansını iyileştirir.
- Sentetik karşılaştırmalar: Geliştirilmiş eşzamanlılık (Treiber yığını) ve daha hızlı eklemeler (min-heap) sayesinde, meşgul kuyruklara çok iş parçacıklı eklemeler eski
MessageQueue'e göre 5.000 kata kadar daha hızlıdır. - Dahili beta test kullanıcılarından alınan Perfetto izlerinde, uygulama ana iş parçacığının kilit çekişmesinde harcadığı sürede% 15 azalma görüyoruz.
- Aynı test cihazlarında, kilit çekişmesinin azalması kullanıcı deneyiminde önemli iyileştirmeler sağlar. Örneğin:
- Uygulamalarda% 4 daha az kaçırılan kare.
- Sistem arayüzü ve başlatıcı etkileşimlerinde% 7,7 daha az kare atlama
- Uygulamanın başlatılmasından ilk karenin çizilmesine kadar geçen sürede% 95'lik dilimde%9, 1 azalma.
Sonraki adımlar
DeliQueue, Android 17'deki uygulamalarda kullanıma sunuluyor. Uygulama geliştiriciler, uygulamalarını nasıl test edeceklerini öğrenmek için Android Geliştiricileri blogundaki "Uygulamanızı yeni kilitsiz MessageQueue için hazırlama" başlıklı makaleyi incelemelidir.
Referanslar
[1] Treiber, R.K., 1986. Sistem programlama: Paralellik ile başa çıkma. International Business Machines Incorporated, Thomas J. Watson Araştırma Merkezi'nde çalışmaktadır.
[2] Goetz, B., Peierls, T., Bloch, J., Bowbeer, J., Holmes, D., & Lea, D. (2006). Java Concurrency in Practice. Addison-Wesley Professional.
-
 Ürün Haberleri
Yakında çıkacak Android sürümünü hedefleyen uygulamalar artık WRITE_CONTACTS izniyle kişilere doğrudan yazamayacak.
Roxanna Aliabadi Walker • Okuma süresi: 6 dk. -
 Ürün Haberleri
Temsilci tabanlı geliştirme hızlandıkça Android mühendisliği heyecan verici yeni bir aşamaya geçiyor: yardımcı kod tamamlamadan, sizin yönlendirmenizle uçtan uca yürütülen temsilcilere geçiş. Kullandığınız modeller ve temsilciler konusunda tam bir seçim özgürlüğüne ve esnekliğe sahipsiniz.
Jason Buchel • Okuma süresi: 3 dk. -
 Ürün Haberleri
Bugün, "bir mağazadan daha fazlası" vizyonumuzu bir sonraki aşamaya nasıl taşıdığımızı paylaştık. Google Play, aylık 250 milyondan fazla etkin kullanıcının kişisel ana sayfası olan Siz sekmesinden 700 milyondan fazla oyuncu profilini birbirine bağlayan birleşik oyun platformumuza kadar her yerde kullanıcılarla buluşuyor.
Paul Feng • Okuma süresi: 3 dk.
Android geliştiriciliğiyle ilgili en son analizleri her hafta gelen kutunuza alın.