איך משפרים את פיתוח האפליקציות ל-Android בעזרת AI ואת מודלי ה-LLM באמצעות Android Bench
משך הקריאה: 2 דקות
אנחנו רוצים לעזור לכם לפתח אפליקציות איכותיות ל-Android בצורה מהירה וקלה יותר, ואחת הדרכים שבהן אנחנו עוזרים לכם לשפר את הפרודוקטיביות היא באמצעות AI. אנחנו יודעים שאתם רוצים AI שבאמת מבין את הניואנסים של פלטפורמת Android, ולכן אנחנו מודדים את הביצועים של מודלי LLM במשימות פיתוח ל-Android. היום השקנו את הגרסה הראשונה של Android Bench, טבלת המובילים הרשמית שלנו של מודלי LLM לפיתוח ב-Android.
המטרה שלנו היא לספק למפתחי מודלים נקודת השוואה להערכת היכולות של מודלי LLM לפיתוח ב-Android. אנחנו יוצרים נקודת השוואה ברורה ואמינה לאיכות של פיתוח ל-Android, וכך עוזרים ליוצרי המודלים לזהות פערים ולשפר את המודלים מהר יותר. זה מאפשר למפתחים לעבוד בצורה יעילה יותר עם מגוון רחב יותר של מודלים מועילים לבחירה כעוזרים אישיים מבוססי-AI, ובסופו של דבר יוביל לאפליקציות באיכות גבוהה יותר בסביבה העסקית של Android.
משימות פיתוח ל-Android מהעולם האמיתי
יצרנו את נקודת ההשוואה על ידי בחירת קבוצת משימות במגוון תחומים נפוצים של פיתוח ל-Android. הוא מורכב מאתגרים אמיתיים ברמות קושי שונות, שנלקחו ממאגרי Android ציבוריים ב-GitHub. התרחישים כוללים פתרון של שינויי תוכנה שעלולים לגרום לכשל בגרסאות Android, משימות ספציפיות לדומיין כמו חיבור לרשת במכשירים לבישים, ומעבר לגרסה העדכנית של Jetpack Compose, ועוד.
בכל הערכה, מודל ה-LLM מנסה לתקן את הבעיה שדווחה במשימה, ואז אנחנו מאמתים את התיקון באמצעות בדיקות יחידה או בדיקות אינסטרומנטציה. הגישה הזו, שמתאימה לכל המודלים, מאפשרת לנו למדוד את היכולת של המודל לנווט בבסיסי קוד מורכבים, להבין תלויות ולפתור את סוגי הבעיות שאתם נתקלים בהן כל יום.
אימתנו את המתודולוגיה הזו עם כמה יוצרים של מודלי LLM, כולל JetBrains.
"מדידת ההשפעה של AI על Android היא אתגר עצום, ולכן נהדר לראות מסגרת כל כך מבוססת ומציאותית. אנחנו משתמשים באופן פעיל בבנצ'מרקים, ו-Android Bench הוא תוספת ייחודית ומועילה. המתודולוגיה הזו היא בדיוק סוג ההערכה הקפדנית שמפתחי Android צריכים כרגע".
– קיריל סמלוב, ראש תחום שילובי AI ב-JetBrains.
התוצאות הראשונות של Android Bench
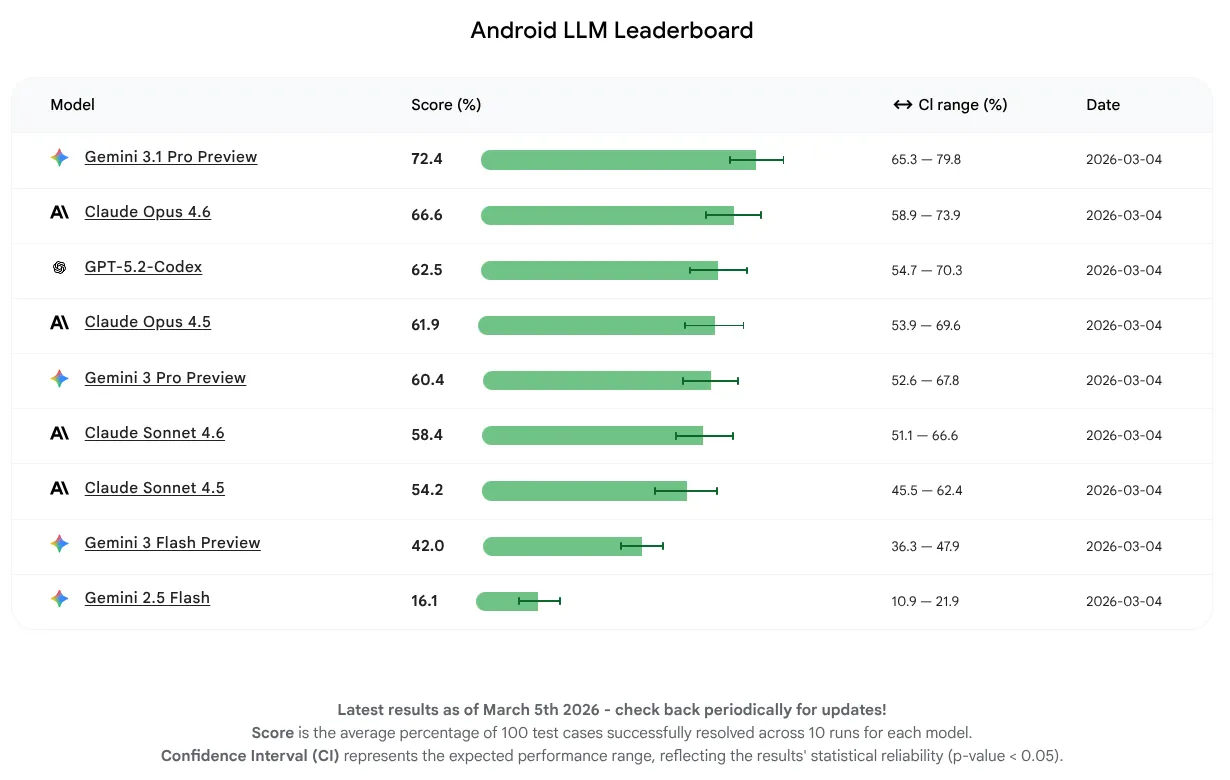
בגרסה הראשונית הזו, רצינו למדוד רק את ביצועי המודל ולא להתמקד בשימוש בכלים או בסוכנים. המודלים הצליחו להשלים 16%-72% מהמשימות. זהו טווח רחב שמראה שלחלק ממודלי ה-LLM כבר יש בסיס חזק של ידע ב-Android, בעוד שאחרים יכולים להשתפר. בלי קשר למצב המודלים כרגע, אנחנו צופים שיפור מתמשך, כי אנחנו מעודדים את יוצרי ה-LLM לשפר את המודלים שלהם לפיתוח ב-Android.
ה-LLM שקיבל את הציון הממוצע הגבוה ביותר בגרסה הראשונה הזו הוא Gemini 3.1 Pro, ואחריו Claude Opus 4.6. אתם יכולים לנסות את כל המודלים שבדקנו לעזרה מבוססת-AI בפרויקטים שלכם ב-Android באמצעות מפתחות API בגרסה היציבה האחרונה של Android Studio.
שקיפות למפתחים וליוצרים של מודלים גדולים של שפה (LLM)
אנחנו מעריכים גישה פתוחה ושקופה, ולכן המתודולוגיה, קבוצת הנתונים ומסגרת הבדיקה שלנו זמינים באופן ציבורי ב-GitHub.
אחד האתגרים בכל מבחן השוואה ציבורי הוא הסיכון של זיהום נתונים, שבו המודלים עשויים להיחשף למשימות הערכה במהלך תהליך האימון שלהם. נקטנו אמצעים כדי לוודא שהתוצאות שלנו משקפות חשיבה אמיתית ולא שינון או ניחוש, כולל בדיקה ידנית יסודית של מסלולי הסוכנים, או שילוב של מחרוזת Canary כדי למנוע אימון.
בעתיד נמשיך לפתח את המתודולוגיה שלנו כדי לשמור על תקינות מערך הנתונים, וגם נשפר את הגרסאות הבאות של מבחן ההשוואה – למשל, נגדיל את הכמות והמורכבות של המשימות.
אנחנו מצפים לראות איך Android Bench ישפר את העזרה של AI בטווח הארוך. החזון שלנו הוא לצמצם את הפער בין הרעיון לבין קוד איכותי. אנחנו מניחים את היסודות לעתיד שבו תוכלו לפתח ב-Android כל מה שאתם יכולים לדמיין.
-
 חדשות על המוצר
היום, במפגש של מפתחי Android, אנחנו מכריזים על הזמינות הרחבה של הרבה כלים וממשקי API שנועדו להסיר את החיכוך היומיומי ולתת לכם יותר גמישות ליצור אפליקציות Android נהדרות.
Matthew McCullough • משך הקריאה: 4 דקות -
 חדשות על המוצר
היום אנחנו משיקים את הקבוצה הראשונה של משימות ארוכות-טווח (LHT) – משימות מורכבות מאוד שלמהנדס לוקח כמה ימים או אפילו שבוע להשלים. אנחנו גם משיקים הערכת תפקוד של סוכנים, החל מסוכנים של ספקי מודלים תואמים.
Matthew McCullough • משך הקריאה: 3 דקות -
 חדשות על המוצר
היום אנחנו משיקים את Android 17, והיא זמינה ברוב מכשירי Pixel הנתמכים. בחודשים הקרובים יושקו מכשירים חדשים עם Android 17.
Matthew McCullough • משך הקריאה: 13 דקות
רוצים לקבל טיפים עדכניים לפיתוח Android ישירות לאימייל כל שבוע?