

على الرغم من أنّ الذاكرة تُعدّ غالبًا مجموعة واحدة وموحّدة من مساحة التخزين، فإنّ تنظيمها المادي وطريقة وصول وحدة المعالجة المركزية إليها يؤثران بشكل كبير في أداء التطبيقات. إنّ فهم موقع البيانات في الذاكرة هو المفتاح لكتابة رمز برمجي عالي الأداء يستفيد بشكل فعّال من التسلسل الهرمي لذاكرة التخزين المؤقت لوحدة المعالجة المركزية.
التسلسل الهرمي لذاكرة التخزين المؤقت لوحدة المعالجة المركزية
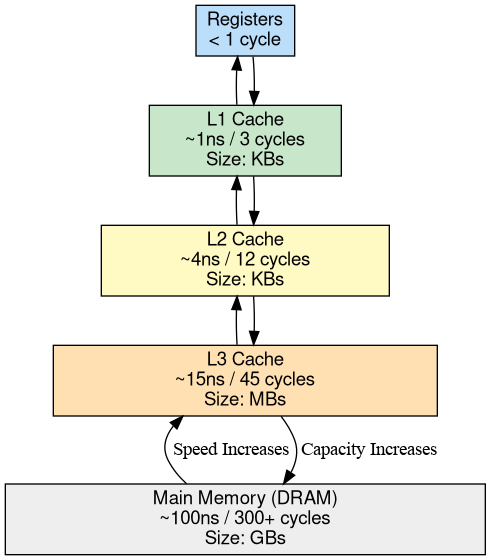
إنّ وحدة المعالجة المركزية الحديثة للأجهزة الجوّالة أسرع بكثير من ذاكرة الوصول العشوائي الرئيسية (DRAM) في النظام. ولسدّ فجوة الأداء هذه، تستخدم وحدات المعالجة المركزية عدة مستويات من الذاكرة الصغيرة والسريعة للغاية، وتُعرف باسم ذاكرات التخزين المؤقت.
- ذاكرة التخزين المؤقت من المستوى 1: هي الأصغر والأسرع (حوالي 1 نانو ثانية). على وحدة معالجة مركزية (CPU) بسرعة 3 غيغاهرتز، يبلغ هذا العدد حوالي 3 دورات ساعة.
- ذاكرة التخزين المؤقت من المستوى الثاني (L2): أكبر وأبطأ قليلاً (من 3 إلى 5 نانو ثانية أو من 10 إلى 15 دورة تقريبًا).
- ذاكرة التخزين المؤقت من المستوى الثالث (L3): هي أكبر ذاكرة تخزين مؤقت (تستغرق حوالي 10 إلى 20 نانو ثانية أو حوالي 30 إلى 60 دورة).
- الذاكرة الرئيسية (DRAM): هي الأكبر والأبطأ (أكثر من 100 نانو ثانية أو أكثر من 300 دورة تقريبًا).
تحديد سياق وقت الاستجابة: تكلفة التوقف
لفهم تأثير هذه الأرقام، ضع في اعتبارك وحدة معالجة مركزية حديثة فائقة العددية يمكنها إيقاف 4 إلى 8 تعليمات لكل دورة ساعة.
إذا لم يعثر المعالج المركزي على البيانات في أي من الذاكرات المؤقتة واضطر إلى الانتظار لمدة 100 نانو ثانية (300 دورة) لقراءة البيانات من ذاكرة الوصول العشوائي الديناميكية:
- الدورات المفقودة: 300 دورة تقريبًا
- التعليمات "المهدرة": بين 1,200 و2,400 تعليمة كان من الممكن تنفيذها إذا كانت البيانات مخزّنة في سجلّ محلي أو في ذاكرة التخزين المؤقت من المستوى الأول.
عندما يكون رمزك البرمجي ذا موضع ذاكرة ضعيف، لا يكون وحدة المعالجة المركزية مشغولة بالضرورة بإجراء عمليات حسابية معقّدة، بل غالبًا ما تكون "متوقفة"، أي في وضع الخمول لآلاف العمليات المكافئة أثناء انتظار نظام الذاكرة الفرعي.
التعليمات في كل دورة (IPC)
أحد المقاييس الرئيسية لقياس هذه الكفاءة هو التعليمات لكل دورة (IPC). يمثّل مقياس IPC عدد التعليمات التي "تتوقف" (تكتمل) وحدة المعالجة المركزية (CPU) عن تنفيذها في المتوسط خلال كل دورة ساعة.
- عدد التعليمات المنفَّذة في الدورة الواحدة (IPC) مرتفع (مثلاً، من 3.0 إلى 5.0): تعمل وحدة المعالجة المركزية بكفاءة عالية، ومن المحتمل أن تجد معظم بياناتها في ذاكرات التخزين المؤقت أو السجلات من المستوى 1 أو 2.
- انخفاض عدد التعليمات في الدورة الواحدة (IPC) (مثل أقل من 0.5): وحدة المعالجة المركزية (CPU) تعاني من اختناق شديد. حتى إذا كان "استخدام" وحدة المعالجة المركزية (CPU) يبلغ %100 في أدوات مراقبة النظام، فإنّها في الواقع تقضي معظم الوقت في انتظار الذاكرة، وهي حالة تُعرف باسم توقّف الذاكرة.
تُعدّ موضع البيانات في الذاكرة العامل الأساسي الذي يحدّد ما إذا كانت حلقة تتطلّب معالجة كمية كبيرة من البيانات ستعمل بمعدّل مرتفع من الاتصال بين العمليات أو ستتوقف بشكل متكرّر.
أسطر ذاكرة التخزين المؤقت
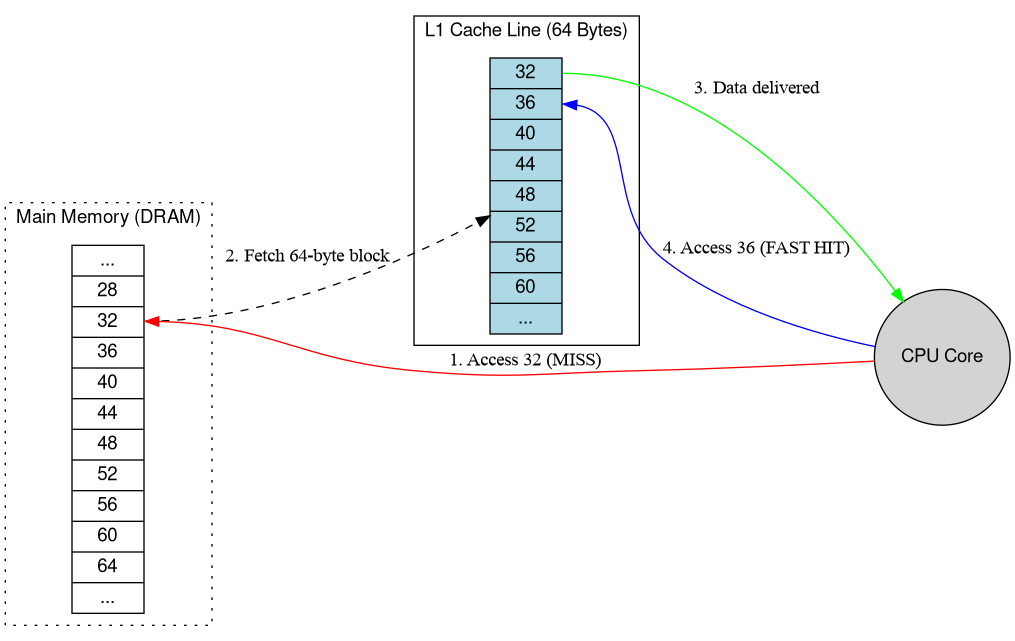
لا تحمّل وحدات المعالجة المركزية وحدات بايت فردية من الذاكرة. بدلاً من ذلك، يتم تحميل كتل ثابتة الحجم تُعرف باسم أسطر ذاكرة التخزين المؤقت، والتي تبلغ عادةً 64 بايت. عند الوصول إلى متغيّر واحد، تجلب وحدة المعالجة المركزية جزءًا كاملاً من الذاكرة المؤقتة بحجم 64 بايت يحتوي على هذا المتغيّر.
جدول بحث الترجمة (TLB)
يستخدم نظام التشغيل Android الذاكرة الافتراضية. يتطلّب الوصول إلى كل ذاكرة ترجمة عنوان افتراضي إلى عنوان فعلي. جدول ترجمة العناوين هو ذاكرة تخزين مؤقت متخصصة تخزّن عمليات الترجمة الحديثة. يتطلّب عدم العثور على عنوان في جدول TLB أن يبحث نظام التشغيل عن العنوان في جداول الصفحات في الذاكرة الرئيسية، وهو إجراء مكلف نسبيًا مقارنةً بالعثور على العنوان في جدول TLB.
ملف الأجهزة: Pixel 10 Pro Fold
بالنسبة إلى التمارين التالية، استخدمنا جهاز Pixel 10 Pro Fold. يحتوي هذا الجهاز على معالج Google Tensor G5.
الاستعلام عن الأجهزة
لفهم نظام الذاكرة الفرعي، علينا أولاً فحص إعدادات وحدة المعالجة المركزية ومعلمات ذاكرة التخزين المؤقت.
# Check CPU architecture and core parts
adb shell cat /proc/cpuinfo | grep 'CPU part' | sort -u
# Output:
# CPU part  : 0xd8b
# CPU part  : 0xd8c
# CPU part  : 0xd90

# Check cache line size
adb shell getconf -a | grep CACHE_LINESIZE
# Output:
# LEVEL1_ICACHE_LINESIZE             64
# LEVEL1_DCACHE_LINESIZE             64
فك ترميز أجزاء وحدة المعالجة المركزية (CPU)
قيم CPU part في /proc/cpuinfo هي معرّفات سداسية عشرية لنوى وحدة المعالجة المركزية ARM. بالنسبة إلى نظام Laguna على الشريحة (SoC) المتوفّر في هاتف Pixel 10 Pro Fold، يتم ربط هذه القيم بما يلي:
0xd8b: ARM Cortex-A520 (النوى الفعّالة)0xd90: ARM Cortex-A720 (النوى عالية الأداء)0xd8c: ARM Cortex-X4 (النواة الأساسية)
يُعدّ هذا الإعداد 4+3+1 شائعًا في أنظمة SoC الحديثة للأجهزة الجوّالة، حيث قد تختلف أحجام ذاكرة التخزين المؤقت وأوقات الاستجابة في المجموعات المختلفة.
أنواع المناطق المحلية
يعتمد تصميم البرامج الفعّال على نوعَين رئيسيَّين من الموضع:
- الموقع المكاني: إذا تم الوصول إلى موقع ذاكرة، من المحتمل أن يتم الوصول إلى مواقع ذاكرة قريبة قريبًا. يُعدّ التنقّل التسلسلي في الصفيف المثال الكلاسيكي. وبما أنّ وحدة المعالجة المركزية تحمّل سطر تخزين مؤقت بالكامل، فإنّ الوصول إلى العنصر التالي في مصفوفة يكون شبه "مجاني" إذا كان موجودًا في سطر التخزين المؤقت.
- الموقع الجغرافي المؤقت: إذا تم الوصول إلى موقع جغرافي في الذاكرة، من المرجّح أن يتم الوصول إلى الموقع نفسه مرة أخرى قريبًا. تعيد الخوارزميات الجيدة استخدام البيانات طالما أنّها لا تزال "نشطة" في ذاكرة التخزين المؤقت.
تمرين عملي: قياس الموضع النسبي باستخدام simpleperf
في هذا التمرين، سنستخدم simpleperf لمراقبة عدّادات أداء الأجهزة أثناء تنفيذ عمليتَي اجتياز مختلفتَين لمصفوفة بحجم 256 ميغابايت.
- الاجتياز حسب الصف: يتم الوصول إلى عناصر المصفوفة بالترتيب الذي يتم تخزينها به في الذاكرة. وهذا الإجراء متوافق مع ذاكرة التخزين المؤقت ويستفيد من الموقع المكاني.
- التنقّل حسب الأعمدة: الانتقال بين أجزاء الذاكرة للوصول إلى العناصر حسب العمود ويؤدي ذلك غالبًا إلى عدم العثور على البيانات في ذاكرة التخزين المؤقت وذاكرة TLB، ما يجبر وحدة المعالجة المركزية على التوقف.
1. التشغيل باستخدام Simpleperf
ادفع الثنائي، وتأكّد من أنّه قابل للتنفيذ، واستخدِم simpleperf stat لقياس أحداث ذاكرة التخزين المؤقت وTLB. نستخدم اللاحقة :u لقياس الأحداث في مساحة المستخدم.
تتطلّب هذه الأوامر إذن adb root للوصول إلى عدّادات وحدة إدارة الطاقة (PMU) للأجهزة على معظم الأجهزة.
adb root
adb shell "chmod +x /data/local/tmp/LocalityLab"
الملف الشخصي الرئيسي:
adb shell "simpleperf stat -e cpu-cycles:u,instructions:u,cache-misses:u,L1-dcache-load-misses:u,dTLB-load-misses:u /data/local/tmp/LocalityLab row"
تنسيق الملف الشخصي الرئيسي للعمود:
adb shell "simpleperf stat -e cpu-cycles:u,instructions:u,cache-misses:u,L1-dcache-load-misses:u,dTLB-load-misses:u /data/local/tmp/LocalityLab col"
2. أمثلة على القياسات (هاتف Pixel 10 Pro Fold)
تم قياس النتائج التالية على جهاز Pixel 10 Pro Fold:
| المقياس | الترتيب حسب الصفوف (الترتيب السهل) | الترتيب حسب الأعمدة (غير مناسب) | الفرق |
|---|---|---|---|
| وقت التنفيذ | 0.83 ثانية | 68.3 ثانية | أبطأ بمقدار 82 مرة تقريبًا |
| التعليمات | 5.27 مليار | 10.20 مليار | 1.9 مرّة أكثر تقريبًا |
| دورات وحدة المعالجة المركزية | 1.20 مليار | 62.18 مليار | أكثر بمقدار 52 مرة تقريبًا |
| التعليمات في كل دورة (IPC) | 4.40 | 0.16 | كفاءة أقل بمقدار 27 مرّة |
| عمليات عدم العثور في ذاكرة التخزين المؤقت من المستوى 1 | 210 مليون | 3,369 مليون | 16 ضعف عدد الأخطاء |
| dTLB Load Misses | 0.13 مليون | 2,888 مليون | 22,000 مرة أكثر من الأخطاء |
3- تحليل النتائج
- تعطُّل IPC: في اختبار ترتيب الصفوف، حققت وحدة المعالجة المركزية معدل IPC يبلغ 4.40، ما يشير إلى أنّها تنفّذ تعليمات متعددة لكل دورة بكفاءة. في اختبار ترتيب الأعمدة، ينخفض معدّل IPC إلى 0.16. وهذا يعني أنّ وحدة المعالجة المركزية تتوقف عن العمل بنسبة% 96 من الوقت، منتظرةً وصول البيانات من ذاكرة الوصول العشوائي الديناميكية.
- اختناق TLB: يظهر الاختلاف الأكبر في dTLB-load-misses. يبقى الوصول التسلسلي (الصفوف الرئيسية) ضمن صفحات الذاكرة نفسها، ما يؤدي إلى عدد قليل جدًا من أخطاء TLB. يؤدي الانتقال بين الأعمدة (الترتيب حسب الأعمدة) إلى أن يشير وحدة المعالجة المركزية باستمرار إلى صفحات جديدة، ما يؤدي إلى إرهاق جدول ترجمة العناوين (TLB) وإجبارها على إجراء عمليات بحث مكلفة في جدول الصفحات.
- كفاءة ذاكرة التخزين المؤقت: يؤدي اجتياز البيانات بترتيب الأعمدة إلى حدوث أخطاء في ذاكرة التخزين المؤقت من المستوى الأول بمعدل 16 مرة أكثر، ما يجبر وحدة المعالجة المركزية على استرداد البيانات من ذاكرة التخزين المؤقت من المستوى الثالث أو ذاكرة الوصول العشوائي الديناميكية (DRAM) الأبطأ بكثير بشكل مستمر.
ملاحظة: على الرغم من أنّ كلتا عمليتَي الاجتياز نفّذتا العملية المنطقية نفسها على البيانات نفسها، كانت عملية الاجتياز الرئيسية للأعمدة أبطأ بأكثر من 80 مرة. ويرجع هذا الاختلاف الكبير تمامًا إلى طريقة تفاعل نمط الوصول مع الواقع المادي لنظام الذاكرة الفرعي في وحدة المعالجة المركزية.
تتبُّع المؤشرات في هياكل البيانات في Java وKotlin
في حين أنّ مقياس أداء المصفوفة الثنائية الأبعاد يوضّح الموضع المكاني في مصفوفات أصلية متجاورة، فإنّ معظم رموز التطبيقات والأُطر البرمجية على Android مكتوبة بلغة Java وKotlin. في اللغات المُدارة، لا تخزِّن متغيرات العناصر وعناصر المجموعة العناصر المضمّنة، بل تخزِّن مراجع (مؤشرات) إلى العناصر المخصّصة في الذاكرة المؤقتة والموزّعة على الذاكرة المؤقتة في ART.
تكلفة الرسومات البيانية للإشارات المتداخلة
لنفترض نمطًا شائعًا في تطبيقات Android وخدمات النظام: اجتياز مجموعات متداخلة، مثل ArrayList من عناصر الحالة، يحتوي كل منها على ArrayMap أو ArraySet من أدوات المعالجة أو عمليات الربط، يشير كل منها إلى سجل حالة آخر.
على الرغم من أنّ ArrayList وArrayMap وArraySet تخزّن مصفوفات Object[] الداخلية بشكل متجاور، يظل كل عنصر في Object[] مرجعًا إلى الذاكرة المكدّسة. يتطلّب إلغاء الإشارة إلى سلسلة مثل process.services.valueAt(i).connections.valueAt(j).client خمس عمليات تحميل متسلسلة للذاكرة التابعة:
- حمِّل
Object[]النسخة الاحتياطيةservices. - حمِّل عنوان الحقل
ServiceRecordوحقوله. - حمِّل
Object[]النسخة الاحتياطيةconnections. - حمِّل العنصر
ConnectionRecord. - حمِّل حقل
ProcessRecordالهدف.
وبما أنّ عنوان الذاكرة لكل عملية تحميل يعتمد على القيمة التي تعرضها عملية التحميل السابقة، لا يمكن لمحرك التنفيذ غير المنظَّم ووحدة الجلب المسبق للأجهزة في وحدة المعالجة المركزية أن يتداخلا. إذا تم تخصيص هذه العناصر في أوقات مختلفة أو نقلها إلى مناطق مختلفة أثناء عملية جمع البيانات المُهمَلة، فإنّ كل خطوة تنطوي على خطر البيانات غير متوفرة في ذاكرة التخزين المؤقت من المستوى الأول أو الثاني.
تزيد العناصر الأساسية المحوَّلة إلى كائنات (ArrayList<Integer> وHashMap<Long, Boolean>) ورموز lambda العامة من هذا الحمل الزائد: يتطلّب كل بحث عن عنصر إلغاء إشارة مؤشر إضافي لإلغاء تحويل القيمة، وتُدرج عمليات معاودة الاتصال العامة Consumer<T> عمليات التحقّق من النوع في وقت التشغيل (CheckCast) التي تضيف ضغطًا على ذاكرة التخزين المؤقت للتعليمات (L1-icache).
تشخيص مشاكل تتبُّع المؤشرات باستخدام simpleperf
في مهام العمل الفعلية بلغتَي Java وKotlin (مثل system_serverOomAdjuster التي تتضمّن عملية اجتياز الرسوم البيانية المرجعية للعمليات والخدمات وموفّري المحتوى)، نادرًا ما ينخفض التواصل البيني للعمليات (IPC) إلى 0.16 كما هو الحال في عملية المسح الاصطناعية التي تبلغ سعتها 256 ميغابايت والمصمّمة على شكل أعمدة، لأنّ جزءًا من مجموعة العمل يتناسب مع ذاكرة التخزين المؤقت من المستوى الثاني أو الثالث.
بدلاً من ذلك، ابحث عن هذه السمة المميزة في simpleperf:
- معدّل تعليمات منخفضة لكل دورة (يتراوح بين 0.6 و0.9): أقل بكثير من عرض الإيقاف الفائق للوحدة المركزية.
- توقّف كبير في الذاكرة الخلفية (
raw-stall-backend-mem): غالبًا ما يتم استهلاك% 35 إلى %45 من جميع دورات وحدة المعالجة المركزية في انتظار عمليات تعبئة ذاكرة التخزين المؤقت للبيانات. L1-dcache-load-missesوL1-icache-load-misses: ارتفاع معدّلات البيانات غير المتوفرة في ذاكرة التخزين المؤقت مع البيانات غير المتوفرة في ذاكرة التخزين المؤقت للتعليمات عندما تنتقل حلقات الاجتياز السريع بين الطرق الافتراضية ورموز lambda العامة.
يمكنك قياس هذه العدادات في عملية قيد التشغيل باستخدام simpleperf stat:
adb shell simpleperf stat \
  -e cpu-cycles:u,instructions:u,raw-stall-backend-mem:u,L1-dcache-load-misses:u,L1-icache-load-misses:u \
  -p $(pidof system_server) --duration 10
تحسين الموضع النسبي في الرمز المُدار
- استبدِل المجموعات المعبّأة بمصفوفات أولية أو مجموعات AndroidX:
استخدِم الأنواع الأولية
IntArrayأوLongArrayأوSparseIntArrayأوandroidx.collection(IntListأوLongLongMapأوScatterMap) لإزالة العناصر المغلّفة والحفاظ على القيم متجاورة داخل عملية تخصيص مصفوفة واحدة. - تسوية مسارات التنقّل السريع: إذا كان هناك مسار سريع يتنقّل بشكل متكرّر بين ثلاث أو أربع خطوات في الرسم البياني للعناصر من أجل قراءة علامة منطقية أو عدد صحيح واحد، يمكنك نقل هذه الحالة أو تخزينها مؤقتًا في مصفوفة مسطّحة أو قناع بتات مفهرس برقم تعريف كثيف.
- تجنَّب التقاط أو استخدام تعبيرات lambda عامة في الحلقات الداخلية الضيقة: استخدِم حلقات
forالقياسية المستندة إلى الفهرس على قوائمRandomAccessبدلاً منforEachأو سلاسل المكرّرات لتجنُّب عمليات تخصيص المكرّرات وعمليات الإرسال الضخمة وعمليات التحقّق من النوع في وقت التشغيل.
← سلاسل المحادثات | ↑ للأعلى | عمليات ربط الخدمات →