

Bellek genellikle tek ve homojen bir depolama alanı olarak düşünülse de fiziksel düzeni ve CPU'nun belleğe erişme şekli, uygulama performansı üzerinde büyük bir etkiye sahiptir. Bellek yerelliğini anlamak, CPU'nun önbellek hiyerarşisini verimli bir şekilde kullanan yüksek performanslı kod yazmak için çok önemlidir.
CPU önbellek hiyerarşisi
Modern bir mobil CPU, sistemin ana RAM'inden (DRAM) çok daha hızlıdır. CPU'lar, bu performans açığını kapatmak için önbellek adı verilen birkaç seviyede küçük ve son derece hızlı bellek kullanır.
- L1 önbelleği (1. düzey): En küçük ve en hızlıdır (~1 ns). 3 GHz CPU'da bu işlem yaklaşık 3 saat döngüsü sürer.
- L2 önbelleği (2. düzey): Daha büyük ve biraz daha yavaş (~3-5 ns veya ~10-15 döngü).
- L3 önbelleği (3. düzey): En büyük önbellektir (~10-20 ns veya ~30-60 döngü).
- Ana Bellek (DRAM): En büyük ve en yavaş olanıdır (~100 ns veya ~300+ döngü).
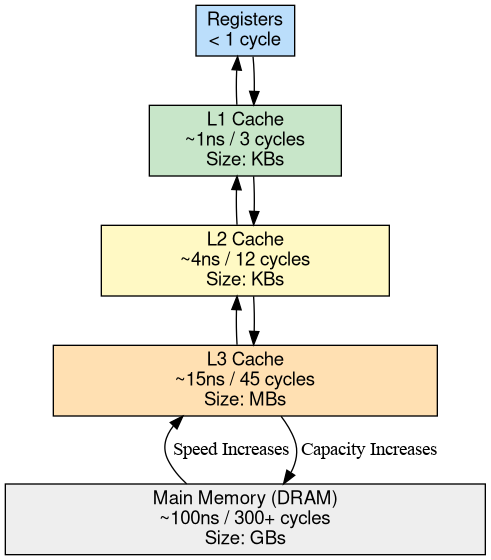
Gecikmeyi bağlama yerleştirme: duraklamanın maliyeti
Bu sayıların etkisini anlamak için saat döngüsü başına 4 ila 8 talimatı kullanımdan kaldırabilen modern bir süperskalar CPU'yu düşünün.
CPU tüm önbellekleri kaçırırsa ve bir DRAM okuması için 100 ns (300 döngü) beklemesi gerekirse:
- Kayıp Döngüler: ~300 döngü.
- "Boşa Harcanan" Talimatlar: Veriler zaten yerel bir kayıtta veya L1 önbelleğinde olsaydı yürütülebilecek 1.200 ila 2.400 talimat.
Kodunuzda bellek yerelliği zayıf olduğunda CPU, karmaşık matematik işlemleriyle meşgul olmayabilir. Genellikle "duraklatılır" ve bellek alt sistemini beklerken binlerce talimat eşdeğeri boyunca boşta kalır.
Çevrim başına talimat sayısı (IPC)
Bu verimliliği ölçmek için kullanılan temel metriklerden biri Döngü Başına Talimat (IPC)'dir. IPC, CPU'nun her saat döngüsü sırasında ortalama olarak kaç talimatı başarıyla "tamamladığını" (bitirdiğini) gösterir.
- Yüksek IPC (ör. 3,0 - 5,0): CPU yüksek verimlilikle çalışıyor ve verilerinin çoğunu L1/L2 önbelleklerinde veya kayıtlarda buluyor olabilir.
- Düşük IPC (ör. < 0,5): CPU ciddi şekilde darboğaz yaşıyor. CPU, sistem monitörlerinde %100 "kullanım" durumunda olsa bile aslında çoğunlukla belleği bekler. Bu duruma bellek durması denir.
Bellek yerelliği, veri yoğun bir döngünün yüksek IPC'de çalışıp çalışmayacağını veya bir dizi duraklamaya dönüşüp dönüşmeyeceğini belirleyen birincil faktördür.
Önbellek satırları
CPU'lar, bellekten tek bayt yüklemez. Bunun yerine, genellikle 64 bayt olan önbellek satırları adı verilen sabit boyutlu bloklar yüklenir. Tek bir değişkene eriştiğinizde CPU, onu içeren 64 baytlık parçanın tamamını önbelleğe getirir.
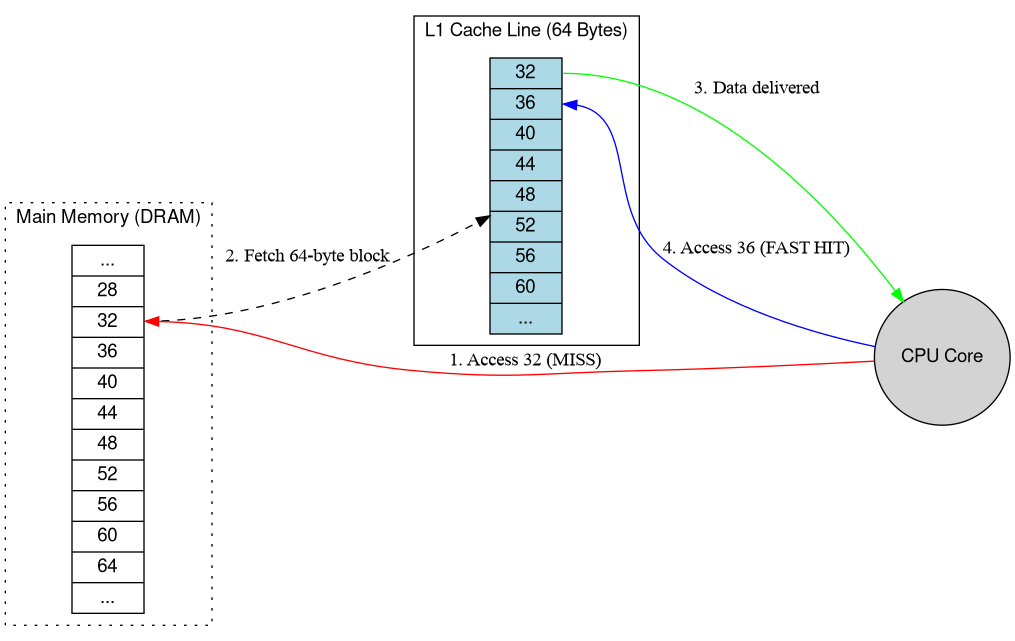
TLB (translation lookaside buffer)
Android, sanal bellek kullanır. Her bellek erişimi, sanal adresin fiziksel adrese çevrilmesini gerektirir. TLB, son çevirileri depolayan özel bir önbellektir. Bir TLB isabeti olmaması, çekirdeğin ana bellekteki sayfa tablolarını incelemesini gerektirir. Bu, TLB isabetine kıyasla nispeten maliyetli bir işlemdir.
Donanım profili: Pixel 10 Pro Fold
Aşağıdaki alıştırmalarda Pixel 10 Pro Fold donanım cihazı kullandık. Bu cihazda Google Tensor G5 SoC bulunur.
Donanımı sorgulama
Bellek alt sistemini anlamak için önce CPU yapılandırmasını ve önbellek parametrelerini inceleriz.
# Check CPU architecture and core parts
adb shell cat /proc/cpuinfo | grep 'CPU part' | sort -u
# Output:
# CPU part  : 0xd8b
# CPU part  : 0xd8c
# CPU part  : 0xd90

# Check cache line size
adb shell getconf -a | grep CACHE_LINESIZE
# Output:
# LEVEL1_ICACHE_LINESIZE             64
# LEVEL1_DCACHE_LINESIZE             64
CPU parçalarını çözme
/proc/cpuinfo içindeki CPU part değerleri, ARM CPU çekirdekleri için onaltılık tanımlayıcılardır. Pixel 10 Pro Fold'da bulunan Laguna SoC için bunlar şu şekilde eşlenir:
0xd8b: ARM Cortex-A520 (Verimlilik çekirdekleri)0xd90: ARM Cortex-A720 (Performans çekirdekleri)0xd8c: ARM Cortex-X4 (Prime çekirdek)
Bu 4+3+1 yapılandırması, farklı kümelerin farklı önbellek boyutlarına ve gecikme sürelerine sahip olabileceği modern mobil SoC'lerde yaygındır.
Yerleşim birimi türleri
Verimli yazılım tasarımı, iki ana yerellik türüne dayanır:
- Konumsal Yerellik: Bir anı konumuna erişilirse yakındaki anı konumlarına da kısa süre içinde erişilmesi muhtemeldir. Sıralı dizi geçişi klasik bir örnektir. CPU, bir önbellek satırının tamamını yüklediği için bir dizideki sonraki öğeye erişmek, önbellek satırında zaten varsa neredeyse "ücretsizdir".
- Zamansal Yerellik (Temporal Locality): Bir bellek konumuna erişilirse aynı konuma kısa süre içinde tekrar erişilmesi olasıdır. İyi algoritmalar, veriler önbellekte hâlâ "etkin" durumdayken yeniden kullanır.
Uygulamalı alıştırma: simpleperf ile yerelliği ölçme
Bu alıştırmada, 256 MB'lık bir matrisin iki farklı geçişini çalıştırırken donanım performansı sayaçlarını izlemek için simpleperf kullanacağız.
- Satır öncelikli geçiş: Matris öğelerine bellekte depolandıkları sırayla erişir. Bu, önbellek dostudur ve uzamsal yerelliği kullanır.
- Sütun öncelikli geçiş: Öğelere sütun sütun erişmek için bellekte atlar. Bu durum, sık sık önbelleği ve TLB'yi kaçırarak CPU'nun durmasına neden olur.
1. Simpleperf ile çalıştırma
İkili programı aktarın, yürütülebilir olduğundan emin olun ve simpleperf stat kullanarak önbellek ve TLB etkinliklerini ölçün. Kullanıcı alanındaki etkinlikleri ölçmek için :u sonekini kullanırız.
Bu komutlar, çoğu cihazda donanım PMU sayaçlarına erişmek için adb root gerektirir.
adb root
adb shell "chmod +x /data/local/tmp/LocalityLab"
Profile Row-major:
adb shell "simpleperf stat -e cpu-cycles:u,instructions:u,cache-misses:u,L1-dcache-load-misses:u,dTLB-load-misses:u /data/local/tmp/LocalityLab row"
Profil sütun öncelikli:
adb shell "simpleperf stat -e cpu-cycles:u,instructions:u,cache-misses:u,L1-dcache-load-misses:u,dTLB-load-misses:u /data/local/tmp/LocalityLab col"
2. Örnek ölçümler (Pixel 10 Pro Fold)
Aşağıdaki sonuçlar Pixel 10 Pro Fold donanım cihazında ölçülmüştür:
| Metrik | Satır öncelikli (Kolay) | Sütun öncelikli (Kullanıcı dostu değil) | Fark |
|---|---|---|---|
| Yürütme Süresi | 0,83 saniye | 68,3 saniye | ~82 kat daha yavaş |
| Talimatlar | 5,27 milyar | 10,20 Milyar | ~1,9 kat daha fazla |
| CPU Döngüleri | 1,20 milyar | 62,18 milyar | Yaklaşık 52 kat daha fazla |
| Döngü Başına Talimat Sayısı (IPC) | 4.40 | 0,16 | 27 kat daha düşük verimlilik |
| L1 Veri Önbelleği Eksikleri | 210 milyon | 3,369 milyon | 16 kat daha fazla kaçırma |
| dTLB Load Misses | 0,13 milyon | 2.888 milyon | 22.000 kat daha fazla kaçırılan fırsat |
3. Sonuçların analizi
- IPC Çökmesi: Satır öncelikli testte CPU, 4,40 IPC elde ederek döngü başına birden fazla talimatı verimli bir şekilde yürüttüğünü gösteriyor. Sütun öncelikli testte IPC 0, 16'ya düşer. Bu, CPU'nun % 96 oranında duraklatıldığı ve DRAM'den verilerin gelmesini beklediği anlamına gelir.
- TLB darboğazı: En büyük fark, dTLB-load-misses metriklerinde görülür. Sıralı erişim (satır öncelikli), aynı bellek sayfalarında kalır ve bu da çok az sayıda TLB kaçırmasıyla sonuçlanır. Sütunlar arasında atlama (sütun öncelikli) CPU'nun sürekli olarak yeni sayfalara başvurmasına neden olur. Bu durum, TLB'yi aşırı yükleyerek pahalı sayfa tablosu yürüyüşlerini zorlar.
- Önbellek Verimliliği: Sütun ağırlıklı geçiş, 16 kat daha fazla L1 önbellek hatası oluşturarak CPU'nun verileri çok daha yavaş olan L3 veya DRAM'den sürekli olarak getirmesine neden olur.
Gözlem: Her iki geçiş de aynı veriler üzerinde aynı mantıksal işlemi gerçekleştirse de sütun ağırlıklı geçiş 80 kat daha yavaştı. Bu büyük fark tamamen erişim kalıbının, CPU'nun bellek alt sisteminin fiziksel gerçekliğiyle etkileşiminden kaynaklanmaktadır.
Java ve Kotlin veri yapılarında işaretçi takibi
2D matris karşılaştırması, bitişik yerel dizilerde uzamsal yerelliği gösterse de çoğu Android uygulaması ve çerçeve kodu Java ve Kotlin ile yazılır. Yönetilen dillerde, nesne değişkenleri ve koleksiyon öğeleri nesneleri satır içi olarak depolamaz. Bunun yerine, ART yığınına dağıtılmış yığın tarafından ayrılmış nesnelere yönelik referansları (işaretçiler) depolar.
İç içe yerleştirilmiş referans grafiklerin maliyeti
Android uygulamalarındaki ve sistem hizmetlerindeki yaygın bir kalıbı ele alalım: Her biri başka bir durum kaydını işaret eden bir ArrayList durum nesnesi, her biri bir ArrayMap veya ArraySet dinleyici ya da bağlantı içeren iç içe yerleştirilmiş koleksiyonlarda gezinme.
ArrayList, ArrayMap ve ArraySet, dahili Object[] dizilerini bitişik olarak depolasa da bu Object[] içindeki her öğe yığın referansıdır. process.services.valueAt(i).connections.valueAt(j).client gibi bir zincirin referansının kaldırılması için beş sıralı bağımlı bellek yüklemesi gerekir:
Object[]Yedeklemeservices'yi yükleyin.ServiceRecordnesne başlığını ve alanlarını yükleyin.Object[]Yedeklemeconnections'yi yükleyin.ConnectionRecordnesnesini yükleyin.- Hedef
ProcessRecordalanını yükleyin.
Her yükün bellek adresi, önceki yükün döndürdüğü değere bağlı olduğundan CPU'nun sırasız yürütme motoru ve donanım önceden getirme özelliği bunları çakıştıramaz. Bu nesneler farklı zamanlarda ayrılmışsa veya atık toplama sırasında farklı bölgelere taşınmışsa her atlama, L1 veya L2 önbellekte yok riski taşır.
Kutulanmış temel türler (ArrayList<Integer>, HashMap<Long, Boolean>) ve genel lambda'lar bu ek yükü artırır: Her öğe araması, değeri kutudan çıkarmak için ek bir işaretçi referansının kaldırılmasını gerektirir ve genel Consumer<T> geri çağırma işlevleri, talimat önbelleği (L1-icache) baskısı ekleyen çalışma zamanı türü kontrolü (CheckCast) saplamaları yerleştirir.
simpleperf ile işaretçi izleme sorununu teşhis etme
Gerçek dünyadaki Java ve Kotlin iş yüklerinde (ör.system_server'nın
OomAdjuster geçiş süreci, hizmet ve sağlayıcı referans grafikleri), çalışma kümesinin bir kısmı L2 veya L3 önbelleğine sığdığı için işaretçi takibi, IPC'yi sentetik 256 MB'lık bir sütun öncelikli tarama gibi nadiren 0, 16'ya kadar düşürür.
Bunun yerine, simpleperf içinde bu karakteristik imzayı arayın:
- Düşük IPC (yaklaşık 0,6 ila 0,9): CPU'nun süperskalar emeklilik genişliğinin çok altında.
- Yüksek arka uç bellek duraklamaları (
raw-stall-backend-mem): Genellikle tüm CPU döngülerinin% 35 ila %45'i veri önbelleği dolumlarının beklenmesiyle geçer. - Yüksek
L1-dcache-load-missesveL1-icache-load-misses: Sıcak geçiş döngüleri sanal yöntemler ve genel lambda kaba kodları arasında atladığında yüksek veri önbellekte yok oranları, talimat önbellekte yoklarıyla birlikte görülür.
simpleperf stat kullanarak çalışan bir süreçteki bu sayaçları ölçebilirsiniz:
adb shell simpleperf stat \
  -e cpu-cycles:u,instructions:u,raw-stall-backend-mem:u,L1-dcache-load-misses:u,L1-icache-load-misses:u \
  -p $(pidof system_server) --duration 10
Yönetilen kodda yerelliği iyileştirme
- Sarmalanmış koleksiyonları temel diziler veya AndroidX koleksiyonlarıyla değiştirme:
Sarmalayıcı nesneleri ortadan kaldırmak ve değerleri tek bir dizi ayırması içinde bitişik tutmak için
IntArray,LongArray,SparseIntArrayveyaandroidx.collectiontemel öğelerini (IntList,LongLongMap,ScatterMap) kullanın. - Sık kullanılan geçiş yollarını düzleştirin: Sık kullanılan bir döngü, tek bir boole veya tam sayı işaretini okumak için bir nesne grafiğinde üç ya da dört atlama gerçekleştiriyorsa bu durumu yoğun bir kimlikle dizine eklenmiş düz bir diziye veya bit maskesine taşıyın ya da önbelleğe alın.
- Sıkı iç döngülerde yakalama veya genel lambda'lardan kaçının: Yineleyici ayırmalarını, megamorfik göndermeyi ve çalışma zamanı türü kontrolü ek yükünü önlemek için
forEachveya yineleyici zincirleri yerineRandomAccesslisteleri üzerinde standart dizine alınmışfordöngüleri kullanın.
← Threads | ↑ Yukarı | Hizmet bağlamaları →