

記憶體通常被視為單一的統一儲存空間,但記憶體的實體組織和 CPU 存取方式,對應用程式效能有深遠影響。瞭解記憶體區域性是編寫高效能程式碼的關鍵,可有效運用 CPU 的快取階層。
CPU 快取階層
現代行動 CPU 的速度遠比系統的主要 RAM (DRAM) 快。為彌補這項效能差距,CPU 會使用多個層級的小型極速記憶體,也就是快取。
- L1 快取 (第 1 級):最小且最快 (~1 奈秒)。在 3 GHz 的 CPU 上,這大約是 3 個時脈週期。
- L2 快取 (第 2 級):較大且稍慢 (~3-5 奈秒,或 ~10-15 個週期)。
- L3 快取 (第 3 級):最大的快取 (~10-20 奈秒,或 ~30-60 個週期)。
- 主記憶體 (DRAM):最大且最慢 (約 100 奈秒以上,或約 300 個週期以上)。
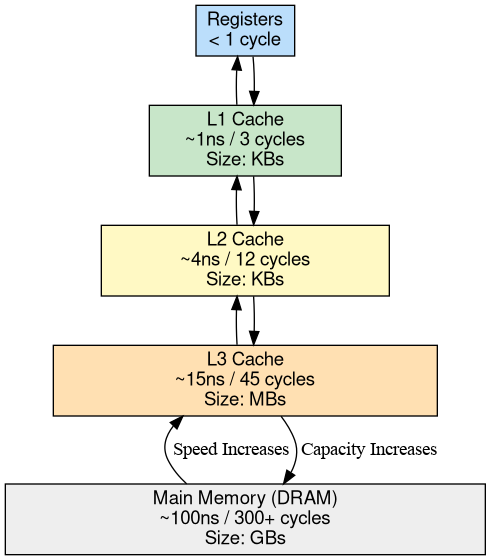
延遲的脈絡:停滯的成本
如要瞭解這些數字的影響,請考量現代超純量 CPU,每個時脈週期可淘汰 4 到 8 個指令。
如果 CPU 錯過所有快取,且必須等待 100 奈秒 (300 個週期) 才能讀取 DRAM:
- 損失的週期:約 300 個週期。
- 「浪費」的指令:1,200 到 2,400 個指令,如果資料已位於本機暫存器或 L1 快取中,這些指令可能已執行。
如果程式碼的記憶體區域性不佳,CPU 不一定會忙於複雜的數學運算,而是經常「停滯」,在等待記憶體子系統時,會閒置數千個指令等效項目。
每個週期 (IPC) 的指令
衡量這項效率的主要指標是每個週期執行的指令數 (IPC)。 IPC 代表 CPU 在每個時脈週期內平均「退役」(完成) 的指令數。
- 高 IPC (例如 3.0 - 5.0):CPU 運作效率高,很可能在 L1/L2 快取或暫存器中找到大部分資料。
- 低 IPC (例如 < 0.5):CPU 嚴重受限。即使系統監控器顯示 CPU「使用率」為 100%,實際上大部分時間都處於等待記憶體的狀態,也就是所謂的記憶體停滯。
記憶體區域性是決定資料密集迴圈是否以高 IPC 執行,或崩潰成一連串停滯的主要因素。
快取行
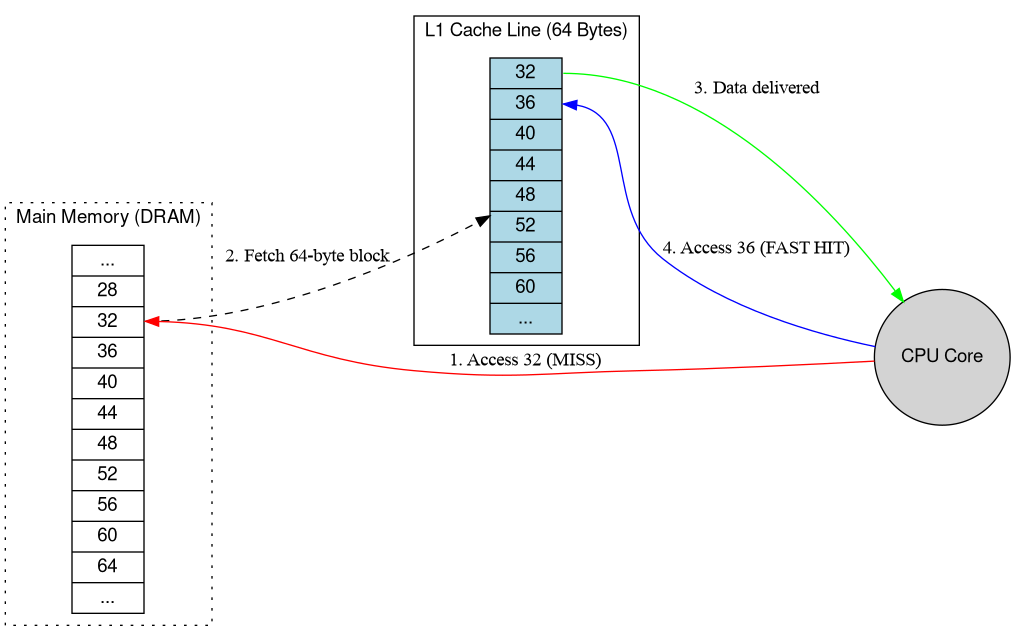
CPU 不會從記憶體載入單一位元組。而是載入固定大小的區塊,稱為「快取行」,通常為 64 位元組。存取單一變數時,CPU 會將包含該變數的整個 64 位元組區塊擷取到快取中。
TLB (位址轉譯後備緩衝區)
Android 使用虛擬記憶體。每次存取記憶體時,都必須將虛擬位址轉換為實體位址。TLB 是專門儲存近期翻譯內容的快取。TLB 錯失會要求核心在主記憶體中走訪頁面表格,相較於 TLB 命中,這項作業相對昂貴。
硬體設定檔:Pixel 10 Pro Fold
在下列練習中,我們使用 Pixel 10 Pro Fold 硬體裝置。 這部裝置搭載 Google Tensor G5 SoC。
查詢硬體
如要瞭解記憶體子系統,請先檢查 CPU 設定和快取參數。
# Check CPU architecture and core parts
adb shell cat /proc/cpuinfo | grep 'CPU part' | sort -u
# Output:
# CPU part  : 0xd8b
# CPU part  : 0xd8c
# CPU part  : 0xd90

# Check cache line size
adb shell getconf -a | grep CACHE_LINESIZE
# Output:
# LEVEL1_ICACHE_LINESIZE             64
# LEVEL1_DCACHE_LINESIZE             64
解讀 CPU 零件
/proc/cpuinfo 中的 CPU part 值是 ARM CPU 核心的十六進位 ID。如果是 Pixel 10 Pro Fold 搭載的 Laguna SoC,則對應至:
0xd8b:ARM Cortex-A520 (效率核心)0xd90:ARM Cortex-A720 (效能核心)0xd8c:ARM Cortex-X4 (主要核心)
這種 4+3+1 設定在現代行動 SoC 中很常見,因為不同叢集可能會有不同的快取大小和延遲。
地區類型
有效率的軟體設計取決於兩大類型的區域性:
- 空間局部性:如果存取某個記憶體位置,系統很可能很快就會存取附近的記憶體位置。循序陣列遍歷就是經典範例。由於 CPU 會載入整個快取行,因此如果陣列中的下一個元素已在快取行中,存取該元素幾乎「免費」。
- 時間局部性:如果存取某個記憶體位置,系統很可能很快就會再次存取該位置。好的演算法會在資料仍處於快取「熱」狀態時重複使用。
實機練習:使用 simpleperf 評估區域性
在本練習中,我們將使用 simpleperf 監控硬體效能計數器,同時執行 256 MB 矩陣的兩種不同遍歷。
- 以資料列為主的遍歷:按照矩陣元素在記憶體中的儲存順序存取元素。這項做法有助於快取,並可利用空間區域性。
- 以資料欄為主軸的遍歷:跨記憶體跳轉,依資料欄存取元素。這通常會錯過快取和 TLB,導致 CPU 強制停止。
1. 使用 Simpleperf 執行
推送二進位檔,確保可執行,並使用 simpleperf stat 評估快取和 TLB 事件。我們使用 :u 後置字元來評估使用者空間中的事件。在大多數裝置上,這些指令需要 adb root 才能存取硬體 PMU 計數器。
adb root
adb shell "chmod +x /data/local/tmp/LocalityLab"
設定檔列優先:
adb shell "simpleperf stat -e cpu-cycles:u,instructions:u,cache-misses:u,L1-dcache-load-misses:u,dTLB-load-misses:u /data/local/tmp/LocalityLab row"
設定檔欄優先:
adb shell "simpleperf stat -e cpu-cycles:u,instructions:u,cache-misses:u,L1-dcache-load-misses:u,dTLB-load-misses:u /data/local/tmp/LocalityLab col"
2. 測量範例 (Pixel 10 Pro Fold)
以下結果是在 Pixel 10 Pro Fold 硬體裝置上測得:
| 指標 | 以資料列為主 (友善) | 以資料欄為主 (不友善) | 差異 |
|---|---|---|---|
| 執行時間 | 0.83 秒 | 68.3 秒 | 慢約 82 倍 |
| 操作說明 | 52.7 億 | 102 億 | 約 1.9 倍 |
| CPU 週期 | 12 億 | 621.8 億 | 約 52 倍 |
| 每個週期的指令數 (IPC) | 4.40 | 0.16 | 效率降低 27 倍 |
| L1 資料快取未中斷 | 2.1 億 | 3,369 Million | 錯失的商機多出 16 倍 |
| dTLB Load Misses | 0.13 Million | 2,888 Million | 錯失商機的次數增加 22,000 倍 |
3. 結果分析
- IPC 崩潰:在以列為主的測試中,CPU 的 IPC 達到 4.40,表示 CPU 每個週期可有效執行多項指令。在以資料欄為主的大型測試中,IPC 會降至 0.16。這表示 CPU 有 96% 的時間處於停滯狀態,等待 DRAM 傳送資料。
- TLB 瓶頸:最顯著的差異在於 dTLB 負載遺失。循序存取 (以列為主) 會留在相同的記憶體頁面中,因此 TLB 失敗次數極少。跨欄跳轉 (以欄為主) 會導致 CPU 不斷參照新頁面,造成 TLB 負載過重,並強制執行耗費資源的頁面資料表走訪。
- 快取效率:以資料欄為主軸的遍歷會產生 16 倍的 L1 快取遺失,導致 CPU 不斷從速度較慢的 L3 或 DRAM 擷取資料。
觀察結果:雖然兩次遍歷對相同資料執行相同的邏輯運算,但以資料欄為主的遍歷速度慢了 80 倍以上。造成如此巨大差異的原因,完全在於存取模式與 CPU 記憶體子系統實體現實的互動方式。
Java 和 Kotlin 資料結構中的指標追蹤
雖然 2D 矩陣基準測試會展示連續原生陣列中的空間區域性,但大部分 Android 應用程式和架構程式碼都是以 Java 和 Kotlin 編寫。在受管理語言中,物件變數和集合元素不會內嵌儲存物件,而是儲存散布在 ART 堆積中的堆積分配物件的參照 (指標)。
巢狀參照圖的費用
請考慮 Android 應用程式和系統服務的常見模式:遍歷巢狀集合,例如狀態物件的 ArrayList,每個物件都包含 ArrayMap 或 ArraySet 的監聽器或連線,每個監聽器或連線都指向另一個狀態記錄。
即使 ArrayList、ArrayMap 和 ArraySet 會連續儲存內部 Object[] 陣列,該 Object[] 中的每個元素仍是堆積參照。對 process.services.valueAt(i).connections.valueAt(j).client 等鏈結取消參照時,需要五個連續的依附記憶體負載:
- 載入
Object[]支援services。 - 載入
ServiceRecord物件標頭和欄位。 - 載入
Object[]支援connections。 - 載入
ConnectionRecord物件。 - 載入目標
ProcessRecord欄位。
由於每個載入的記憶體位址都取決於前一個載入作業傳回的值,因此 CPU 的亂序執行引擎和硬體預先擷取器無法重疊這些作業。如果這些物件是在不同時間分配,或在垃圾回收期間移至不同區域,則每次躍點都有可能發生 L1 或 L2 快取失敗。
裝箱基本型別 (ArrayList<Integer>、HashMap<Long, Boolean>) 和泛型 Lambda 會加劇這項負擔:每次查閱元素都需要額外指標取消參照,才能取消裝箱值,而泛型 Consumer<T> 回呼會插入執行階段型別檢查 (CheckCast) 存根,進而增加指令快取 (L1-icache) 壓力。
使用 simpleperf 診斷指標追蹤
在實際的 Java 和 Kotlin 工作負載 (例如 system_server's
OomAdjuster 遍歷程序、服務和供應商參照圖),指標追蹤很少會像合成的 256 MB 欄主要掃描一樣,將 IPC 降至 0.16,因為部分工作集會納入 L2 或 L3 快取。請改為在 simpleperf 中尋找這項特徵簽章:
- IPC 偏低 (約 0.6 至 0.9):遠低於 CPU 的超純量退役寬度。
- 後端記憶體停滯時間過長 (
raw-stall-backend-mem):通常有 35% 至 45% 的 CPU 週期都用於等待資料快取填滿。 L1-dcache-load-misses和L1-icache-load-misses偏高:當熱遍歷迴圈跨越虛擬方法和泛型 Lambda 虛設常式時,資料快取失敗率偏高,且指令快取失敗。
您可以使用 simpleperf stat 評估執行中程序的這些計數器:
adb shell simpleperf stat \
  -e cpu-cycles:u,instructions:u,raw-stall-backend-mem:u,L1-dcache-load-misses:u,L1-icache-load-misses:u \
  -p $(pidof system_server) --duration 10
改善受管理程式碼中的區域性
- 以原始陣列或 AndroidX 集合取代裝箱集合:
使用
IntArray、LongArray、SparseIntArray或androidx.collection原始型別 (IntList、LongLongMap、ScatterMap) 消除包裝函式物件,並將值保留在單一陣列分配空間內。 - 扁平化熱遍歷路徑:如果熱迴圈在物件圖中重複走過三或四個躍點,以讀取單一布林值或整數旗標,請將該狀態提升或快取至以密集 ID 建立索引的扁平陣列或位元遮罩。
- 避免在緊密的內部迴圈中擷取或通用 lambda:請使用標準的索引
for迴圈,透過RandomAccess清單進行疊代,而非forEach或疊代器鏈結,以免發生疊代器分配、巨型多態調度,以及執行階段型別檢查的負擔。