

แม้ว่าโดยทั่วไปแล้วหน่วยความจำจะถือเป็นพื้นที่เก็บข้อมูลแบบรวมที่เหมือนกัน แต่การจัดระเบียบทางกายภาพและวิธีที่ CPU เข้าถึงหน่วยความจำนั้นส่งผลอย่างมากต่อประสิทธิภาพของแอปพลิเคชัน การทำความเข้าใจตำแหน่งหน่วยความจำเป็นกุญแจสำคัญในการเขียน โค้ดที่มีประสิทธิภาพสูงซึ่งใช้ลำดับชั้นของแคชของ CPU ได้อย่างมีประสิทธิภาพ
ลำดับชั้นของแคช CPU
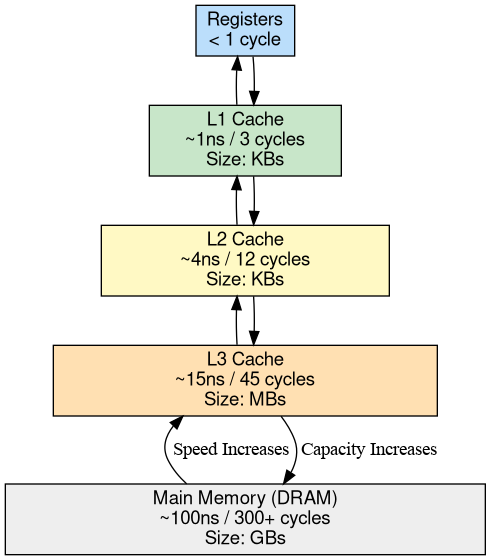
CPU ของอุปกรณ์เคลื่อนที่สมัยใหม่เร็วกว่า RAM หลัก (DRAM) ของระบบมาก CPU ใช้หน่วยความจำขนาดเล็กที่รวดเร็วมากหลายระดับที่เรียกว่าแคชเพื่อลดช่องว่างด้านประสิทธิภาพนี้
- แคช L1 (ระดับ 1): แคชที่เล็กที่สุดและเร็วที่สุด (~1ns) ใน CPU 3GHz ค่านี้ จะเท่ากับรอบสัญญาณนาฬิกาประมาณ 3 รอบ
- แคช L2 (ระดับ 2): ใหญ่ขึ้นและช้าลงเล็กน้อย (~3-5 นาโนวินาที หรือ ~10-15 รอบ)
- แคช L3 (ระดับ 3): แคชที่ใหญ่ที่สุด (~10-20 นาโนวินาที หรือ ~30-60 รอบ)
- หน่วยความจำหลัก (DRAM): ใหญ่ที่สุดและช้าที่สุด (~100 นาโนวินาทีขึ้นไป หรือ ~300 รอบขึ้นไป)
การพิจารณาเวลาในการตอบสนอง: ต้นทุนของการหยุดชะงัก
หากต้องการทำความเข้าใจผลกระทบของตัวเลขเหล่านี้ ให้พิจารณา CPU แบบซูเปอร์สเกลาร์ที่ทันสมัย ซึ่งสามารถดำเนินการคำสั่งได้ 4-8 รายการต่อรอบสัญญาณนาฬิกา
หาก CPU ไม่พบแคชทั้งหมดและต้องรอ 100 นาโนวินาที (300 รอบ) สำหรับการอ่าน DRAM
- รอบที่สูญเสีย: ประมาณ 300 รอบ
- คำสั่งที่ "สูญเปล่า": ระหว่าง1,200 ถึง 2,400 คำสั่งที่ อาจดำเนินการได้หากข้อมูลอยู่ในรีจิสเตอร์ในเครื่องหรือ แคช L1 อยู่แล้ว
เมื่อโค้ดมีตำแหน่งหน่วยความจำที่ไม่ดี CPU อาจไม่ได้ยุ่งอยู่กับ การคำนวณที่ซับซ้อน แต่จะ "หยุดทำงาน" บ่อยครั้ง โดยจะไม่ได้ทำอะไรเป็นเวลาหลายพัน คำสั่งเทียบเท่าขณะรอระบบย่อยของหน่วยความจำ
คำสั่งต่อรอบ (IPC)
เมตริกสำคัญในการวัดประสิทธิภาพนี้คือคำสั่งต่อรอบ (IPC) IPC แสดงจํานวนคําสั่งที่ CPU "เลิกใช้" (ทําให้เสร็จสมบูรณ์) ได้สําเร็จ โดยเฉลี่ยในแต่ละรอบสัญญาณนาฬิกา
- IPC สูง (เช่น 3.0 - 5.0): CPU ทำงานอย่างมีประสิทธิภาพสูง โดยมักจะค้นหาข้อมูลส่วนใหญ่ในแคช L1/L2 หรือรีจิสเตอร์
- IPC ต่ำ (เช่น < 0.5): CPU มีคอขวดอย่างรุนแรง แม้ว่า CPU จะมี "การใช้งาน" 100% ในเครื่องมือตรวจสอบระบบ แต่จริงๆ แล้วส่วนใหญ่จะใช้ไปกับการรอ หน่วยความจำ ซึ่งเป็นสถานะที่เรียกว่าการหยุดทำงานของหน่วยความจำ
การอ้างอิงหน่วยความจำคือปัจจัยหลักที่กำหนดว่าลูปที่ใช้ข้อมูลจำนวนมากจะทำงานที่ IPC สูงหรือจะหยุดทำงานเป็นชุด
บรรทัดแคช
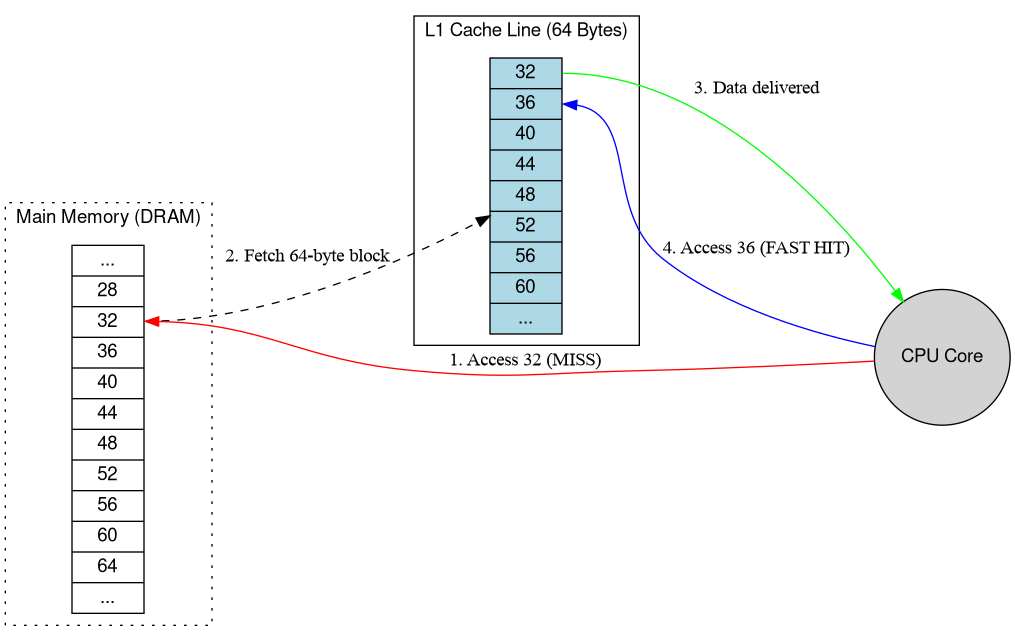
CPU จะไม่โหลดไบต์เดียวจากหน่วยความจำ แต่จะโหลดบล็อกขนาดคงที่ ที่เรียกว่าแคชไลน์ ซึ่งโดยทั่วไปจะมีขนาด 64 ไบต์ เมื่อเข้าถึงตัวแปรเดียว CPU จะดึงข้อมูลทั้งก้อนขนาด 64 ไบต์ที่มีตัวแปรนั้นไปยังแคช
TLB (Translation Lookaside Buffer)
Android ใช้หน่วยความจำเสมือน การเข้าถึงหน่วยความจำทุกครั้งต้องมีการแปลที่อยู่เสมือน เป็นที่อยู่จริง TLB เป็นแคชเฉพาะที่จัดเก็บคำแปลล่าสุด TLB miss ทำให้เคอร์เนลต้องเดินตารางหน้าใน หน่วยความจำหลัก ซึ่งเป็นปฏิบัติการที่ค่อนข้างแพงเมื่อเทียบกับ TLB hit
โปรไฟล์ฮาร์ดแวร์: Pixel 10 Pro Fold
สำหรับการออกกำลังกายต่อไปนี้ เราใช้อุปกรณ์ฮาร์ดแวร์ Pixel 10 Pro Fold อุปกรณ์นี้มี SoC Google Tensor G5
การตรวจสอบฮาร์ดแวร์
หากต้องการทําความเข้าใจระบบย่อยของหน่วยความจํา เราจะตรวจสอบการกําหนดค่า CPU และ พารามิเตอร์แคชก่อน
# Check CPU architecture and core parts
adb shell cat /proc/cpuinfo | grep 'CPU part' | sort -u
# Output:
# CPU part  : 0xd8b
# CPU part  : 0xd8c
# CPU part  : 0xd90

# Check cache line size
adb shell getconf -a | grep CACHE_LINESIZE
# Output:
# LEVEL1_ICACHE_LINESIZE             64
# LEVEL1_DCACHE_LINESIZE             64
การถอดรหัสชิ้นส่วน CPU
CPU part ใน /proc/cpuinfo คือตัวระบุเลขฐานสิบหกสำหรับคอร์ CPU ของ ARM
สำหรับ SoC ของ Laguna ที่พบใน Pixel 10 Pro Fold จะมีค่าดังนี้
0xd8b: ARM Cortex-A520 (คอร์ประสิทธิภาพ)0xd90: ARM Cortex-A720 (คอร์ประสิทธิภาพ)0xd8c: ARM Cortex-X4 (คอร์หลัก)
การกำหนดค่า 4+3+1 นี้พบได้ทั่วไปใน SoC ของอุปกรณ์เคลื่อนที่สมัยใหม่ ซึ่งคลัสเตอร์ต่างๆ อาจมีขนาดแคชและความหน่วงที่แตกต่างกัน
ประเภทของสถานที่
การออกแบบซอฟต์แวร์ที่มีประสิทธิภาพขึ้นอยู่กับประเภทหลัก 2 ประเภทของโลแคลลิตี ได้แก่
- ความใกล้เคียงเชิงพื้นที่: หากมีการเข้าถึงตำแหน่งของหน่วยความจำ ระบบมีแนวโน้มที่จะเข้าถึงตำแหน่งของหน่วยความจำที่อยู่ใกล้เคียงในเร็วๆ นี้ การข้ามอาร์เรย์ตามลำดับเป็นตัวอย่างที่พบได้บ่อย เนื่องจาก CPU โหลดทั้งบรรทัดแคช การเข้าถึง องค์ประกอบถัดไปในอาร์เรย์จึงแทบจะ "ฟรี" หากองค์ประกอบนั้นอยู่ในบรรทัดแคชอยู่แล้ว
- ความเป็นพื้นที่ชั่วคราว: หากมีการเข้าถึงตำแหน่งหน่วยความจำ ตำแหน่งเดียวกัน มีแนวโน้มที่จะได้รับการเข้าถึงอีกครั้งในเร็วๆ นี้ อัลกอริทึมที่ดีจะนำข้อมูลกลับมาใช้ใหม่ในขณะที่ข้อมูลยัง "ใหม่" อยู่ในแคช
แบบฝึกหัดภาคปฏิบัติ: การวัดความเฉพาะเจาะจงด้วย simpleperf
ในแบบฝึกหัดนี้ เราจะใช้ simpleperf เพื่อตรวจสอบประสิทธิภาพของฮาร์ดแวร์
ขณะเรียกใช้การสำรวจเมทริกซ์ขนาด 256 MB ที่แตกต่างกัน 2 รายการ
- การข้ามแถวหลัก: เข้าถึงองค์ประกอบของเมทริกซ์ตามลำดับที่จัดเก็บไว้ในหน่วยความจำ ซึ่งแคชเป็นมิตรและใช้ประโยชน์จากความใกล้เคียงเชิงพื้นที่
- การข้ามตามคอลัมน์: ข้ามหน่วยความจำเพื่อเข้าถึงองค์ประกอบตามคอลัมน์ ซึ่งมักจะพลาดแคชและ TLB ทำให้ CPU ต้อง หยุดทำงาน
1. เรียกใช้ด้วย Simpleperf
พุชไบนารี ตรวจสอบว่าเรียกใช้งานได้ และใช้ simpleperf stat เพื่อวัด
เหตุการณ์แคชและ TLB เราใช้คำต่อท้าย :u เพื่อวัดเหตุการณ์ในพื้นที่ผู้ใช้
คำสั่งเหล่านี้กำหนดให้ adb root ต้องเข้าถึงตัวนับ PMU ของฮาร์ดแวร์ในอุปกรณ์ส่วนใหญ่
adb root
adb shell "chmod +x /data/local/tmp/LocalityLab"
แถวหลักของโปรไฟล์:
adb shell "simpleperf stat -e cpu-cycles:u,instructions:u,cache-misses:u,L1-dcache-load-misses:u,dTLB-load-misses:u /data/local/tmp/LocalityLab row"
คอลัมน์โปรไฟล์หลัก:
adb shell "simpleperf stat -e cpu-cycles:u,instructions:u,cache-misses:u,L1-dcache-load-misses:u,dTLB-load-misses:u /data/local/tmp/LocalityLab col"
2. การวัดตัวอย่าง (Pixel 10 Pro Fold)
ผลลัพธ์ต่อไปนี้วัดจากอุปกรณ์ฮาร์ดแวร์ Pixel 10 Pro Fold
| เมตริก | แถวหลัก (ใช้งานง่าย) | คอลัมน์หลัก (ไม่เป็นมิตร) | ความแตกต่าง |
|---|---|---|---|
| เวลาดำเนินการ | 0.83 วินาที | 68.3 วินาที | ช้าลงประมาณ 82 เท่า |
| วิธีการ | 5.27 พันล้าน | 10.20 พันล้าน | ~1.9 เท่า |
| รอบ CPU | 1.20 พันล้าน | 62.18 พันล้าน | มากกว่าประมาณ 52 เท่า |
| คำสั่งต่อรอบ (IPC) | 4.40 | 0.16 | ประสิทธิภาพต่ำกว่า 27 เท่า |
| แคชข้อมูล L1 ไม่พบ | 210 ล้าน | 3,369 ล้าน | พลาดมากกว่า 16 เท่า |
| การโหลด dTLB ไม่สำเร็จ | 0.13 ล้าน | 2,888 ล้าน | พลาดการตรวจจับมากขึ้น 22,000 เท่า |
3. การวิเคราะห์ผลลัพธ์
- การขัดข้องของ IPC: ในการทดสอบแบบแถวหลัก CPU มี IPC เท่ากับ 4.40 ซึ่งบ่งชี้ว่า CPU ดำเนินการตามคำสั่งหลายรายการต่อรอบได้อย่างมีประสิทธิภาพ ในการทดสอบแบบ Column-Major IPC จะลดลงเหลือ 0.16 ซึ่งหมายความว่า CPU หยุดทำงาน 96% ของเวลา เพื่อรอให้ข้อมูลมาถึงจาก DRAM
- จุดคอขวดของ TLB: ความแตกต่างที่เห็นได้ชัดที่สุดคือ dTLB-load-misses การเข้าถึงแบบลำดับ (แถวหลัก) จะอยู่ในหน้าหน่วยความจำเดียวกัน จึงทำให้เกิด TLB Miss น้อยมาก การข้ามไปมาระหว่างคอลัมน์ (แบบคอลัมน์หลัก) ทำให้ CPU ต้องอ้างอิงหน้าใหม่ๆ อยู่ตลอดเวลา ซึ่งทำให้ TLB ทำงานหนักเกินไปและบังคับให้ต้องใช้การเดินตารางหน้าเว็บที่มีค่าใช้จ่ายสูง
- ประสิทธิภาพของแคช: การข้ามแบบคอลัมน์หลักจะทำให้เกิดการพลาดแคช L1 มากขึ้น 16 เท่า ซึ่งบังคับให้ CPU ดึงข้อมูลจาก L3 หรือ DRAM ที่ช้ากว่ามาก อยู่ตลอดเวลา
ข้อสังเกต: แม้ว่าการข้ามทั้ง 2 แบบจะดำเนินการเชิงตรรกะเดียวกันกับข้อมูลเดียวกัน แต่การข้ามแบบเรียงตามคอลัมน์ช้ากว่าถึง 80 เท่า ความแตกต่างอย่างมากนี้เกิดจากวิธีที่รูปแบบการเข้าถึง โต้ตอบกับความเป็นจริงทางกายภาพของระบบย่อยหน่วยความจำของ CPU
การติดตามพอยน์เตอร์ในโครงสร้างข้อมูล Java และ Kotlin
แม้ว่าการเปรียบเทียบเมทริกซ์ 2 มิติจะแสดงให้เห็นถึงการอ้างอิงตำแหน่งเชิงพื้นที่ในอาร์เรย์ดั้งเดิมที่อยู่ติดกัน แต่โค้ดแอปพลิเคชัน Android และเฟรมเวิร์กส่วนใหญ่เขียนด้วย Java และ Kotlin ในภาษาที่มีการจัดการ ตัวแปรออบเจ็กต์และองค์ประกอบคอลเล็กชัน จะไม่จัดเก็บออบเจ็กต์แบบอินไลน์ แต่จะจัดเก็บการอ้างอิง (พอยน์เตอร์) ไปยังออบเจ็กต์ที่จัดสรรฮีป ซึ่งกระจายอยู่ทั่วฮีปของ ART
ค่าใช้จ่ายของกราฟการอ้างอิงที่ซ้อนกัน
ลองพิจารณารูปแบบทั่วไปในแอป Android และบริการของระบบ ซึ่งก็คือการข้ามผ่านคอลเล็กชันที่ซ้อนกัน เช่น ArrayListของออบเจ็กต์สถานะ ซึ่งแต่ละรายการมีArrayMapหรือArraySetของ Listener หรือการเชื่อมต่อ ซึ่งแต่ละรายการชี้ไปยังบันทึกสถานะอื่น
แม้ว่า ArrayList, ArrayMap และ ArraySet จะจัดเก็บอาร์เรย์ภายใน Object[] อย่างต่อเนื่อง แต่แต่ละองค์ประกอบใน Object[] นั้นก็ยังคงเป็นข้อมูลอ้างอิงฮีป การอ้างอิงเชน เช่น
process.services.valueAt(i).connections.valueAt(j).client ต้องมีการโหลดหน่วยความจำที่ขึ้นต่อกัน 5 รายการ
ตามลำดับ
- โหลด
Object[]การสำรองข้อมูลservices - โหลด
ServiceRecordส่วนหัวและฟิลด์ของออบเจ็กต์ - โหลด
Object[]การสำรองข้อมูลconnections - โหลดออบเจ็กต์
ConnectionRecord - โหลด
ProcessRecordฟิลด์เป้าหมาย
เนื่องจากที่อยู่หน่วยความจำของการโหลดแต่ละครั้งขึ้นอยู่กับค่าที่แสดงโดยการโหลดก่อนหน้า เครื่องมือการดำเนินการแบบไม่อยู่ในลำดับและตัวดึงข้อมูลล่วงหน้าของฮาร์ดแวร์ของ CPU จึงไม่สามารถทับซ้อนกันได้ หากมีการจัดสรรออบเจ็กต์เหล่านั้นในเวลาที่ต่างกันหรือย้ายไปยังภูมิภาคอื่นในระหว่างระบบจัดการหน่วยความจำที่ไม่ใช้แล้ว การฮ็อปแต่ละครั้งจะมีความเสี่ยงที่จะทำให้ไม่พบแคช L1 หรือ L2
Primitive แบบ Box (ArrayList<Integer>, HashMap<Long, Boolean>) และแลมบ์ดาแบบทั่วไป
จะเพิ่มค่าใช้จ่ายนี้ การค้นหาองค์ประกอบทุกครั้งต้องมีการอ้างอิงตัวชี้เพิ่มเติม
เพื่อยกเลิกการ Box ค่า และการเรียกกลับ Consumer<T> แบบทั่วไปจะแทรก
การตรวจสอบประเภทรันไทม์ (CheckCast) ที่เพิ่มแคชคำสั่ง (L1-icache)
การวินิจฉัยการติดตามพอยน์เตอร์ด้วย simpleperf
ในภาระงาน Java และ Kotlin ในโลกจริง (เช่น กระบวนการของ system_server
OomAdjuster การข้ามกราฟอ้างอิงของบริการและผู้ให้บริการ) การติดตามพอยน์เตอร์แทบจะไม่ทำให้ IPC ลดลงเหลือ 0.16 เหมือนการสแกนแบบคอลัมน์หลักสังเคราะห์ขนาด 256 MB เนื่องจากส่วนหนึ่งของชุดการทำงานพอดีกับแคช L2 หรือ L3
แต่ให้มองหาลายเซ็นลักษณะนี้ใน simpleperf แทน
- IPC ต่ำ (ประมาณ 0.6 ถึง 0.9): ต่ำกว่าความกว้างของการเลิกใช้แบบซูเปอร์สเกลาร์ของ CPU มาก
- การหยุดทำงานของหน่วยความจำแบ็กเอนด์สูง (
raw-stall-backend-mem): โดยปกติแล้ว 35% ถึง 45% ของรอบ CPU ทั้งหมดจะใช้ไปกับการรอการเติมแคชข้อมูล - สูงขึ้น
L1-dcache-load-missesและL1-icache-load-misses: อัตราไม่พบแคชข้อมูลสูง จับคู่กับไม่พบแคชคำสั่งเมื่อลูปการข้ามที่ใช้งานบ่อย ข้ามไปยังเมธอดเสมือนและสแต็บแลมบ์ดาแบบทั่วไป
คุณวัดเคาน์เตอร์เหล่านี้ในกระบวนการที่กำลังทำงานได้โดยใช้ simpleperf stat
adb shell simpleperf stat \
  -e cpu-cycles:u,instructions:u,raw-stall-backend-mem:u,L1-dcache-load-misses:u,L1-icache-load-misses:u \
  -p $(pidof system_server) --duration 10
การปรับปรุงการอ้างอิงในโค้ดที่มีการจัดการ
- แทนที่คอลเล็กชันแบบกล่องด้วยอาร์เรย์ดั้งเดิมหรือคอลเล็กชัน AndroidX
ใช้ไพรมิทีฟ
IntArray,LongArray,SparseIntArrayหรือandroidx.collection(IntList,LongLongMap,ScatterMap) เพื่อกำจัดออบเจ็กต์ Wrapper และเก็บค่า ที่อยู่ติดกันไว้ในการจัดสรรอาร์เรย์เดียว - ทำให้เส้นทางการข้ามที่ใช้งานบ่อยแบนราบ: หากลูปที่ใช้งานบ่อยข้ามกราฟออบเจ็กต์ 3 หรือ 4 ฮ็อปซ้ำๆ เพื่ออ่านบูลีนหรือแฟล็กจำนวนเต็มรายการเดียว ให้ยกหรือแคชสถานะนั้นลงในอาร์เรย์แบบแบนหรือบิตมาสก์ที่จัดทำดัชนีตามรหัสแบบหนาแน่น
- หลีกเลี่ยงการจับภาพหรือแลมบ์ดาทั่วไปในลูปด้านในที่เข้มงวด: ใช้ลูป
forที่จัดทำดัชนีมาตรฐานกับลิสต์RandomAccessแทนforEachหรือ เชนของตัววนซ้ำเพื่อหลีกเลี่ยงการจัดสรรตัววนซ้ำ การเรียกใช้เมกะมอร์ฟิก และ ค่าใช้จ่ายในการตรวจสอบประเภทรันไทม์
← เธรด | ↑ ขึ้น | การเชื่อมโยงบริการ →