

Mặc dù bộ nhớ thường được coi là một nhóm lưu trữ duy nhất và đồng nhất, nhưng cấu trúc vật lý của bộ nhớ và cách CPU truy cập vào bộ nhớ này có ảnh hưởng sâu sắc đến hiệu suất ứng dụng. Việc hiểu rõ tính cục bộ của bộ nhớ là yếu tố then chốt để viết mã có hiệu suất cao, giúp sử dụng hiệu quả hệ thống phân cấp bộ nhớ đệm của CPU.
Hệ phân cấp bộ nhớ đệm của CPU
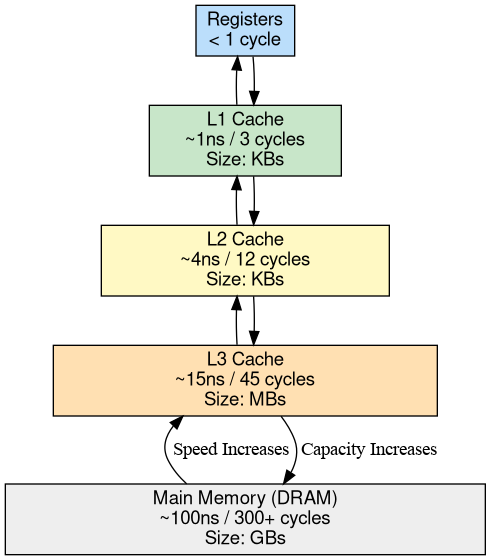
CPU di động hiện đại nhanh hơn nhiều so với RAM chính (DRAM) của hệ thống. Để thu hẹp khoảng cách hiệu suất này, CPU sử dụng một số cấp bộ nhớ nhỏ, cực nhanh, được gọi là bộ nhớ đệm.
- Bộ nhớ đệm L1 (Cấp 1): Nhỏ nhất và nhanh nhất (~1 ns). Trên CPU 3 GHz, thời gian này là khoảng 3 chu kỳ xung nhịp.
- Bộ nhớ đệm L2 (Cấp 2): Lớn hơn và chậm hơn một chút (~3-5 ns hoặc ~10-15 chu kỳ).
- Bộ nhớ đệm L3 (Cấp 3): Bộ nhớ đệm lớn nhất (~10-20 ns hoặc ~30-60 chu kỳ).
- Bộ nhớ chính (DRAM): Lớn nhất và chậm nhất (~100 ns trở lên hoặc ~300 chu kỳ trở lên).
Định hướng độ trễ: chi phí của một lần ngừng hoạt động
Để hiểu được tác động của những con số này, hãy xem xét một CPU siêu vô hướng hiện đại có thể loại bỏ từ 4 đến 8 chỉ thị cho mỗi chu kỳ xung nhịp.
Nếu CPU bỏ lỡ tất cả các bộ nhớ đệm và phải đợi 100 ns (300 chu kỳ) để đọc DRAM:
- Số chu kỳ bị mất: Khoảng 300 chu kỳ.
- Hướng dẫn "Lãng phí": Từ 1.200 đến 2.400 hướng dẫn có thể đã được thực thi nếu dữ liệu đã có trong một thanh ghi cục bộ hoặc bộ nhớ đệm L1.
Khi mã của bạn có vị trí bộ nhớ kém, CPU không nhất thiết phải bận với các phép toán phức tạp; CPU thường "bị tắc nghẽn", ở trạng thái không hoạt động trong hàng nghìn lệnh tương đương trong khi chờ hệ thống con bộ nhớ.
Số lệnh trên mỗi chu kỳ (IPC)
Một chỉ số chính để đo lường hiệu suất này là Số lượng chỉ thị trên mỗi chu kỳ (IPC). IPC biểu thị số lượng chỉ thị mà CPU "loại bỏ" (hoàn thành) thành công trung bình trong mỗi chu kỳ xung nhịp.
- IPC cao (ví dụ: 3.0 – 5.0): CPU đang chạy ở hiệu suất cao, có khả năng tìm thấy hầu hết dữ liệu trong bộ nhớ đệm L1/L2 hoặc các thanh ghi.
- IPC thấp (ví dụ: < 0,5): CPU bị nghẽn nghiêm trọng. Ngay cả khi CPU ở mức "sử dụng" 100% trong các trình giám sát hệ thống, thì trên thực tế, CPU chủ yếu dành thời gian chờ bộ nhớ – một trạng thái được gọi là tắc nghẽn bộ nhớ.
Tính cục bộ của bộ nhớ là yếu tố chính quyết định xem một vòng lặp sử dụng nhiều dữ liệu có chạy ở IPC cao hay không, hoặc có bị sụt giảm thành một loạt các lần tạm dừng hay không.
Dòng bộ nhớ đệm
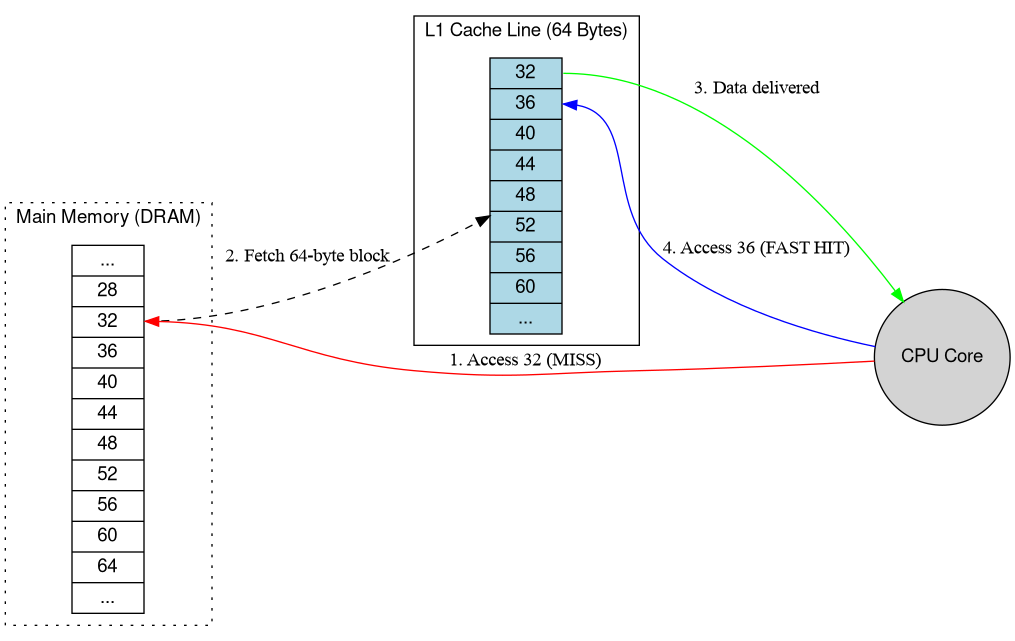
CPU không tải các byte đơn lẻ từ bộ nhớ. Thay vào đó, chúng tải các khối có kích thước cố định gọi là dòng trong bộ nhớ đệm, thường là 64 byte. Khi bạn truy cập vào một biến duy nhất, CPU sẽ tìm nạp toàn bộ khối 64 byte chứa biến đó vào bộ nhớ đệm.
TLB (translation lookaside buffer)
Android sử dụng bộ nhớ ảo. Mỗi lần truy cập bộ nhớ đều yêu cầu dịch một địa chỉ ảo sang địa chỉ thực. TLB là một bộ nhớ đệm chuyên biệt lưu trữ các bản dịch gần đây. TLB miss yêu cầu hạt nhân đi qua các bảng trang trong bộ nhớ chính, đây là một thao tác tương đối tốn kém so với TLB hit.
Hồ sơ phần cứng: Pixel 10 Pro Fold
Đối với các bài tập sau, chúng tôi đã sử dụng thiết bị phần cứng Pixel 10 Pro Fold. Thiết bị này có SoC Google Tensor G5.
Truy vấn phần cứng
Để tìm hiểu về hệ thống con bộ nhớ, trước tiên, chúng ta sẽ xem xét cấu hình CPU và các tham số bộ nhớ đệm.
# Check CPU architecture and core parts
adb shell cat /proc/cpuinfo | grep 'CPU part' | sort -u
# Output:
# CPU part  : 0xd8b
# CPU part  : 0xd8c
# CPU part  : 0xd90

# Check cache line size
adb shell getconf -a | grep CACHE_LINESIZE
# Output:
# LEVEL1_ICACHE_LINESIZE             64
# LEVEL1_DCACHE_LINESIZE             64
Giải mã các bộ phận của CPU
Các giá trị CPU part trong /proc/cpuinfo là giá trị nhận dạng thập lục phân cho các lõi CPU ARM. Đối với SoC Laguna có trong Pixel 10 Pro Fold, các giá trị này tương ứng với:
0xd8b: ARM Cortex-A520 (Lõi hiệu suất)0xd90: ARM Cortex-A720 (Lõi hiệu suất)0xd8c: ARM Cortex-X4 (Lõi chính)
Cấu hình 4+3+1 này thường thấy trong SoC di động hiện đại, trong đó các cụm khác nhau có thể có kích thước bộ nhớ đệm và độ trễ khác nhau.
Các loại địa phương
Thiết kế phần mềm hiệu quả dựa trên 2 loại tính cục bộ chính:
- Tính cục bộ về không gian: Nếu một vị trí bộ nhớ được truy cập, thì các vị trí bộ nhớ lân cận có khả năng sẽ sớm được truy cập. Ví dụ kinh điển là việc duyệt mảng tuần tự. Vì CPU tải toàn bộ dòng lệnh vào bộ nhớ đệm, nên việc truy cập vào phần tử tiếp theo trong một mảng gần như "miễn phí" nếu phần tử đó đã có trong dòng lệnh.
- Tính cục bộ tạm thời: Nếu một vị trí bộ nhớ được truy cập, thì có khả năng vị trí đó sẽ sớm được truy cập lại. Các thuật toán tốt sẽ sử dụng lại dữ liệu trong khi dữ liệu đó vẫn còn "nóng" trong bộ nhớ đệm.
Bài tập thực hành: đo lường tính cục bộ bằng simpleperf
Trong bài tập này, chúng ta sẽ sử dụng simpleperf để theo dõi các bộ đếm hiệu suất phần cứng trong khi chạy hai lần duyệt qua ma trận 256 MB.
- Row-major Traversal (Duyệt theo hàng): Truy cập vào các phần tử ma trận theo thứ tự chúng được lưu trữ trong bộ nhớ. Điều này thân thiện với bộ nhớ đệm và khai thác tính cục bộ về không gian.
- Column-major Traversal (Truy cập theo cột): Nhảy qua bộ nhớ để truy cập các phần tử theo cột. Điều này thường bỏ lỡ bộ nhớ đệm và TLB, buộc CPU phải dừng.
1. Chạy bằng Simpleperf
Đẩy tệp nhị phân, đảm bảo tệp đó có thể thực thi và sử dụng simpleperf stat để đo lường các sự kiện bộ nhớ đệm và TLB. Chúng tôi sử dụng hậu tố :u để đo lường các sự kiện trong không gian người dùng.
Các lệnh này yêu cầu adb root truy cập vào các bộ đếm PMU phần cứng trên hầu hết các thiết bị.
adb root
adb shell "chmod +x /data/local/tmp/LocalityLab"
Hồ sơ hàng chính:
adb shell "simpleperf stat -e cpu-cycles:u,instructions:u,cache-misses:u,L1-dcache-load-misses:u,dTLB-load-misses:u /data/local/tmp/LocalityLab row"
Cột hồ sơ-chính:
adb shell "simpleperf stat -e cpu-cycles:u,instructions:u,cache-misses:u,L1-dcache-load-misses:u,dTLB-load-misses:u /data/local/tmp/LocalityLab col"
2. Số đo mẫu (Pixel 10 Pro Fold)
Các kết quả sau đây được đo trên thiết bị phần cứng Pixel 10 Pro Fold:
| Chỉ số | Hàng chính (Thân thiện) | Column-major (Không thân thiện) | Chênh lệch |
|---|---|---|---|
| Thời gian thực thi | 0,83 giây | 68,3 giây | Chậm hơn khoảng 82 lần |
| Instructions | 5,27 tỷ | 10,2 tỷ | Gần gấp 2 lần |
| Chu kỳ CPU | 1,2 tỷ | 62,18 tỷ | Gấp khoảng 52 lần |
| Số lệnh trên mỗi chu kỳ (IPC) | 4,40 | 0,16 | Hiệu suất thấp hơn 27 lần |
| Lỗi bộ nhớ đệm L1 | 210 triệu | 3.369 triệu | Bỏ lỡ nhiều hơn 16 lần |
| dTLB Load Misses | 0,13 triệu | 2.888 triệu | Số lần bỏ lỡ nhiều hơn 22.000 lần |
3. Phân tích kết quả
- Sự cố IPC: Trong thử nghiệm hàng chính, CPU đạt được IPC là 4,40, cho thấy CPU đang thực thi hiệu quả nhiều chỉ thị trên mỗi chu kỳ. Trong kiểm thử theo cột chính, IPC giảm xuống còn 0,16. Điều này có nghĩa là CPU bị tắc nghẽn 96% thời gian, chờ dữ liệu đến từ DRAM.
- Điểm tắc nghẽn TLB: Sự khác biệt đáng kể nhất nằm ở dTLB-load-misses. Quyền truy cập tuần tự (hàng chính) nằm trong cùng các trang bộ nhớ, dẫn đến rất ít lỗi TLB. Việc nhảy qua các cột (theo cột chính) khiến CPU liên tục tham chiếu các trang mới, làm tràn TLB và buộc các bảng trang phải thực hiện các thao tác tốn kém.
- Hiệu suất bộ nhớ đệm: Quá trình duyệt theo cột tạo ra số lần bỏ lỡ bộ nhớ đệm L1 nhiều hơn 16 lần, buộc CPU phải liên tục tìm nạp dữ liệu từ L3 hoặc DRAM chậm hơn nhiều.
Nhận xét: Mặc dù cả hai lần duyệt đều thực hiện cùng một thao tác logic trên cùng một dữ liệu, nhưng lần duyệt theo cột lại chậm hơn 80 lần. Sự khác biệt lớn này hoàn toàn là do cách mẫu truy cập tương tác với thực tế vật lý của hệ thống con bộ nhớ của CPU.
Theo dõi con trỏ trong cấu trúc dữ liệu Java và Kotlin
Mặc dù phép đo điểm chuẩn ma trận 2D minh hoạ tính cục bộ không gian trong các mảng gốc liền kề, nhưng hầu hết mã ứng dụng Android và khung Android đều được viết bằng Java và Kotlin. Trong các ngôn ngữ được quản lý, các biến đối tượng và phần tử tập hợp không lưu trữ các đối tượng nội tuyến; chúng lưu trữ các tham chiếu (con trỏ) đến các đối tượng được phân bổ theo khối xếp nằm rải rác trên khối xếp ART.
Chi phí của biểu đồ tham chiếu lồng nhau
Hãy xem xét một mẫu phổ biến trong các ứng dụng Android và dịch vụ hệ thống: duyệt qua các tập hợp lồng nhau, chẳng hạn như ArrayList của các đối tượng trạng thái, mỗi đối tượng chứa một ArrayMap hoặc ArraySet của các trình nghe hoặc kết nối, mỗi đối tượng trỏ đến một bản ghi trạng thái khác.
Mặc dù ArrayList, ArrayMap và ArraySet lưu trữ các mảng Object[] nội bộ của chúng một cách liên tục, nhưng mỗi phần tử trong Object[] đó vẫn là một tham chiếu heap. Việc huỷ tham chiếu một chuỗi như process.services.valueAt(i).connections.valueAt(j).client yêu cầu 5 lần tải bộ nhớ phụ thuộc tuần tự:
- Tải
Object[]lớp nềnservices. - Tải tiêu đề và các trường đối tượng
ServiceRecord. - Tải
Object[]lớp nềnconnections. - Tải đối tượng
ConnectionRecord. - Tải trường
ProcessRecordđích.
Vì địa chỉ bộ nhớ của mỗi lần tải phụ thuộc vào giá trị do lần tải trước đó trả về, nên công cụ thực thi ngoài thứ tự và bộ tìm nạp trước phần cứng của CPU không thể chồng chéo các địa chỉ này. Nếu các đối tượng đó được phân bổ vào những thời điểm khác nhau hoặc được di chuyển đến các vùng khác nhau trong quá trình thu gom rác, thì mỗi bước nhảy đều có nguy cơ bị thiếu bộ nhớ đệm L1 hoặc L2.
Các kiểu dữ liệu nguyên thuỷ đóng hộp (ArrayList<Integer>, HashMap<Long, Boolean>) và các lambda chung kết hợp chi phí này: mỗi lần tra cứu phần tử đều cần thêm một con trỏ huỷ tham chiếu để huỷ đóng hộp giá trị và các lệnh gọi lại Consumer<T> chung sẽ chèn các phần giữ chỗ kiểm tra loại thời gian chạy (CheckCast) để tăng áp lực lên bộ nhớ đệm lệnh (L1-icache).
Chẩn đoán hiện tượng con trỏ nhấp nháy bằng simpleperf
Trong các khối lượng công việc thực tế của Java và Kotlin (chẳng hạn như quy trình duyệt qua system_serverOomAdjuster, dịch vụ và biểu đồ tham chiếu của nhà cung cấp), việc theo dõi con trỏ hiếm khi giảm IPC xuống 0,16 như một lần quét chính theo cột 256 MB tổng hợp, vì một phần của tập hợp đang hoạt động phù hợp với bộ nhớ đệm L2 hoặc L3.
Thay vào đó, hãy tìm chữ ký đặc điểm này trong simpleperf:
- IPC giảm (khoảng 0,6 đến 0,9): Thấp hơn nhiều so với độ rộng rút lui siêu vô hướng của CPU.
- Tình trạng tắc nghẽn bộ nhớ phụ trợ cao (
raw-stall-backend-mem): Thường thì 35% đến 45% số chu kỳ CPU được dùng để chờ điền vào bộ nhớ đệm dữ liệu. L1-dcache-load-missesvàL1-icache-load-missesđược nâng cao: Tỷ lệ thiếu bộ nhớ đệm dữ liệu cao kết hợp với thiếu bộ nhớ đệm lệnh khi các vòng lặp truyền tải nóng nhảy qua các phương thức ảo và các mã giả lập lambda chung.
Bạn có thể đo lường các bộ đếm này trên một quy trình đang chạy bằng cách sử dụng simpleperf stat:
adb shell simpleperf stat \
  -e cpu-cycles:u,instructions:u,raw-stall-backend-mem:u,L1-dcache-load-misses:u,L1-icache-load-misses:u \
  -p $(pidof system_server) --duration 10
Cải thiện tính cục bộ trong mã được quản lý
- Thay thế các tập hợp đóng hộp bằng mảng gốc hoặc tập hợp AndroidX: Sử dụng các gốc
IntArray,LongArray,SparseIntArrayhoặcandroidx.collection(IntList,LongLongMap,ScatterMap) để loại bỏ các đối tượng bao bọc và giữ các giá trị liên tục trong một lần phân bổ mảng duy nhất. - Làm phẳng các đường dẫn truyền tải nóng: Nếu một vòng lặp nóng liên tục đi qua 3 hoặc 4 bước nhảy trên một biểu đồ đối tượng để đọc một cờ boolean hoặc cờ số nguyên duy nhất, hãy nâng hoặc lưu trạng thái đó vào một mảng phẳng hoặc mặt nạ bit được lập chỉ mục theo một mã nhận dạng dày đặc.
- Tránh ghi lại hoặc sử dụng lambda chung trong các vòng lặp bên trong chặt chẽ: Sử dụng các vòng lặp
forđược lập chỉ mục tiêu chuẩn trên các danh sáchRandomAccessthay vìforEachhoặc chuỗi trình lặp để tránh việc phân bổ trình lặp, điều phối megamorphic và chi phí kiểm tra loại thời gian chạy.
← Threads | ↑ Up | Service bindings →